Agentic RAG có thực sự tìm được bằng chứng tốt hơn? Thử nghiệm trên 298 câu hỏi
Một thử nghiệm thực tế so sánh bốn cách truy xuất thông tin trong hệ thống RAG: tìm kiếm cơ bản, dùng reranker, viết lại câu hỏi và tác tử AI tự tìm kiếm lại. Kết quả cho thấy Agentic RAG không cải thiện rõ rệt, trong khi reranker lại là thay đổi duy nhất đem lại lợi ích đáng tin cậy.
Agentic RAG — phương pháp đưa một tác tử AI (AI agent) vào hệ thống truy xuất thông tin — đang được xem là bước tiến lớn của các hệ thống RAG. Nhưng liệu nó có thực sự tìm được bằng chứng tốt hơn để trả lời câu hỏi? Một thử nghiệm có kiểm soát trên 298 câu hỏi đã cho câu trả lời khá bất ngờ: không hẳn.
 Minh họa thử nghiệm Agentic RAG
Agentic RAG là gì và vì sao đáng quan tâm?
RAG (Retrieval-Augmented Generation) là cách để mô hình ngôn ngữ lớn trả lời dựa trên văn bản được truy xuất từ một kho tài liệu. RAG truyền thống chỉ tra cứu một lần theo đúng câu hỏi người dùng nhập vào.
Agentic RAG thêm vào một tác tử: một mô hình ngôn ngữ đọc kết quả đầu tiên, tự quyết định nên dừng hay viết truy vấn mới để tìm lại. Ở đây lại có vấn đề: mỗi lần tìm thêm đều tốn thêm một lần gọi mô hình (tức tốn chi phí), khiến người dùng chờ lâu hơn và mở ra khả năng tác tử viết ra truy vấn tệ hơn truy vấn ban đầu.
Thuật ngữ này được định nghĩa trong một khảo sát năm 2025 của Aditi Singh và cộng sự (bản sửa đổi 2026), trong đó chính nhóm tác giả cũng liệt kê đánh giá và hiệu quả là những thách thức còn bỏ ngỏ.
Bốn cách truy xuất được đem ra so sánh
Thử nghiệm dùng cùng 298 câu hỏi trên cùng 2.000 bài báo arXiv gần đây, so sánh bốn thiết kế:
- Dense (tìm kiếm cơ bản): tra cứu một lần bằng vector embedding, không gọi mô hình ngôn ngữ. Đây là mốc so sánh.
- Rerank (dùng reranker): vẫn tìm như trên, sau đó dùng một mô hình chấm điểm nhỏ đọc lại câu hỏi cùng 50 kết quả đầu để sắp xếp lại thứ tự.
- Multiquery (viết lại câu hỏi): nhờ mô hình ngôn ngữ viết lại câu hỏi thành ba biến thể, tìm với cả bốn phiên bản rồi gộp kết quả.
- Agent (tác tử): tìm kiếm rồi để mô hình ngôn ngữ đọc tiêu đề 5 kết quả đầu, tự quyết định dừng hay tìm lại, tối đa ba lần.
Chỉ có thiết kế thứ tư là thực sự "agentic". Thử nghiệm dừng lại ở nửa đầu của RAG là phần truy xuất, nên không thiết kế nào viết ra câu trả lời cuối cùng. Mỗi câu hỏi có đúng một bài báo chứa câu trả lời trong phần tóm tắt; thiết kế được coi là thành công nếu bài báo đó nằm trong top 5 kết quả.
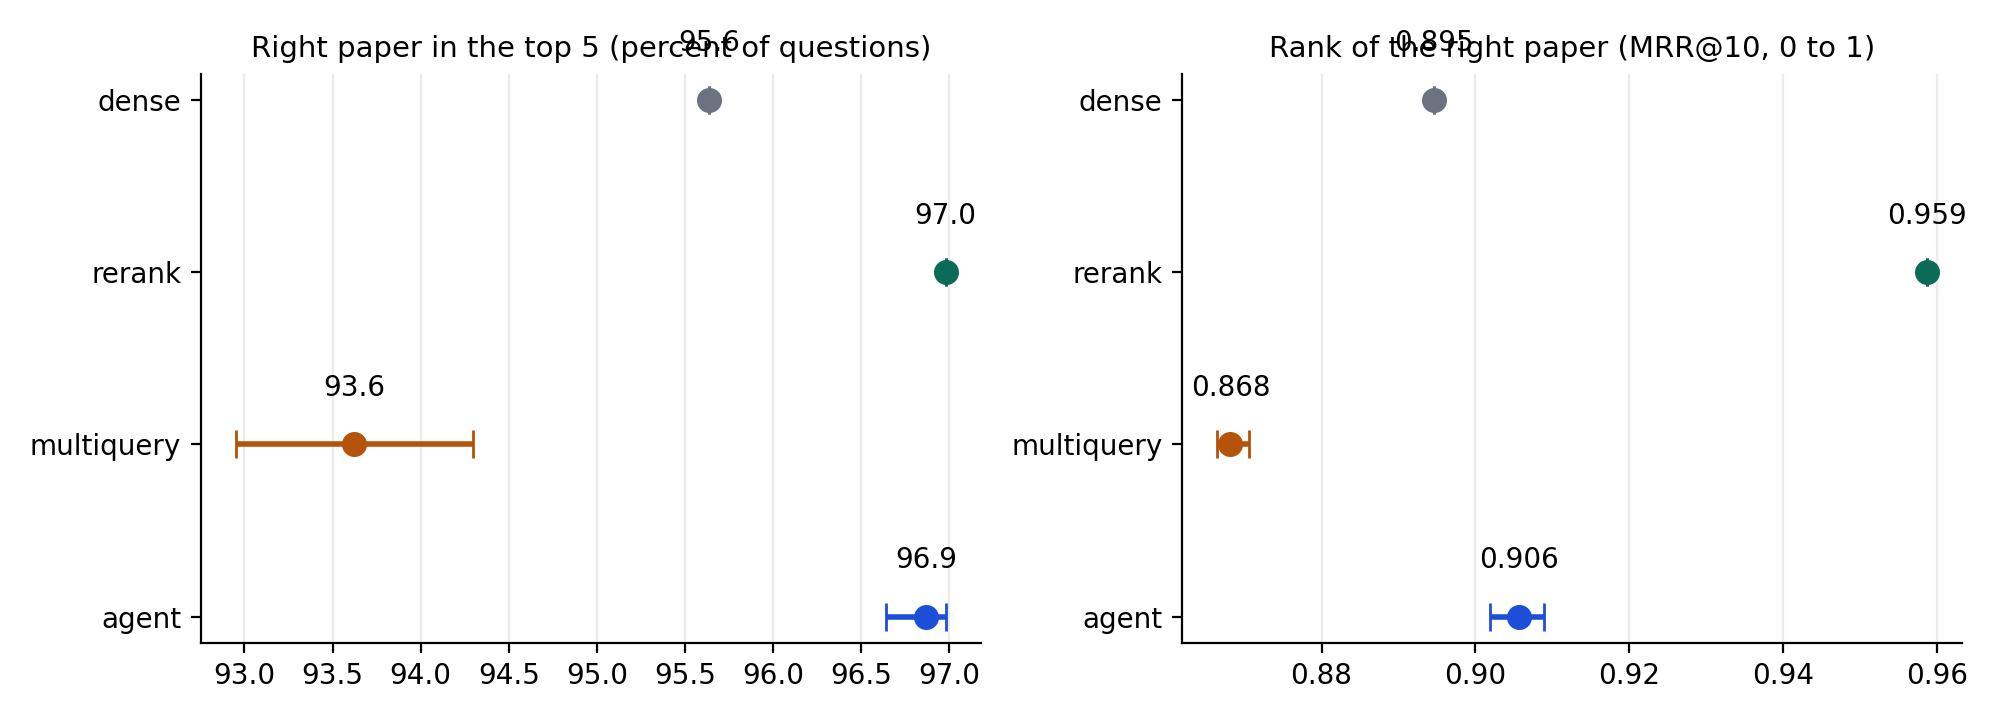
Thước đo chính gồm recall@5 (tỷ lệ bài báo đúng lọt top 5) và MRR@10 (điểm thưởng cho việc xếp bài đúng lên vị trí cao).
Kết quả: lợi ích quá nhỏ để phân biệt với ngẫu nhiên
| Thiết kế | Đúng trong top 5 (%) | MRR@10 | Số lần tìm/câu hỏi | Chi phí/1.000 truy vấn |
|---|---|---|---|---|
| Dense | 95,6 | 0,895 | 1,0 | 0 USD |
| Rerank | 97,0 | 0,959 | 1,0 | 0 USD |
| Multiquery | 93,6 | 0,868 | 4,0 | 0,06 USD |
| Agent | 96,9 | 0,906 | 1,7 | 0,09 USD |
Điểm mấu chốt nằm ở khoảng tin cậy (bootstrap) của từng mức chênh lệch so với tìm kiếm cơ bản:
- Agent tăng +1,2 điểm phần trăm recall, nhưng khoảng tin cậy là -0,8 đến +3,5 — bao gồm số 0, nghĩa là thử nghiệm không thể phân biệt nó với tìm kiếm thường.
- Multiquery lại kém hơn (-2,0 điểm), dù khoảng tin cậy cũng chứa số 0.
- Reranker là thay đổi duy nhất có mức tăng rõ ràng trên MRR@10 (+0,064, khoảng +0,037 đến +0,093, không chứa số 0), và không tốn phí gọi mô hình, chỉ thêm khoảng 1,5 giây độ trễ.
Đáng chú ý, tìm kiếm cơ bản vốn đã đúng tới 95,6% câu hỏi, chỉ trượt 13 câu. Điều này có nghĩa dư địa để cải thiện trên recall chỉ còn tối đa 4,4 điểm — một trần rất thấp.
Khi nào tác tử giúp, khi nào tác tử hại?
Phân tích từng truy vấn mà tác tử viết ra cho thấy hai kiểu hành vi trái ngược:
Giúp ích khi tác tử dịch cách diễn đạt thông thường sang thuật ngữ chuyên ngành. Ví dụ, câu hỏi về định tuyến yêu cầu đến các máy chủ sinh văn bản được viết lại thành "SLO-aware request routing across decode replicas with KV cache capacity constraints optimization", đưa bài báo đúng từ ngoài top 10 lên hạng 1.
Gây hại khi tác tử tự thêm từ khóa "đoán" từ ký ức về lĩnh vực mà câu hỏi không hề nhắc tới, ví dụ thêm "continuous thought", "Coconut" hay "LSTM". Kết quả là các bài báo khác bị gộp lên trên bài báo đúng, khiến nó rơi khỏi top 5.
Bài học rút ra: những lần viết lại mượn từ ngữ từ chính lĩnh vực của câu hỏi thì có lợi; những lần đoán mò từ ký ức của mô hình thường dẫn tới nhầm lẫn.
Tác tử dừng sau một lần tìm ở khoảng 59% câu hỏi và dùng hết ba lần ở khoảng 26%.
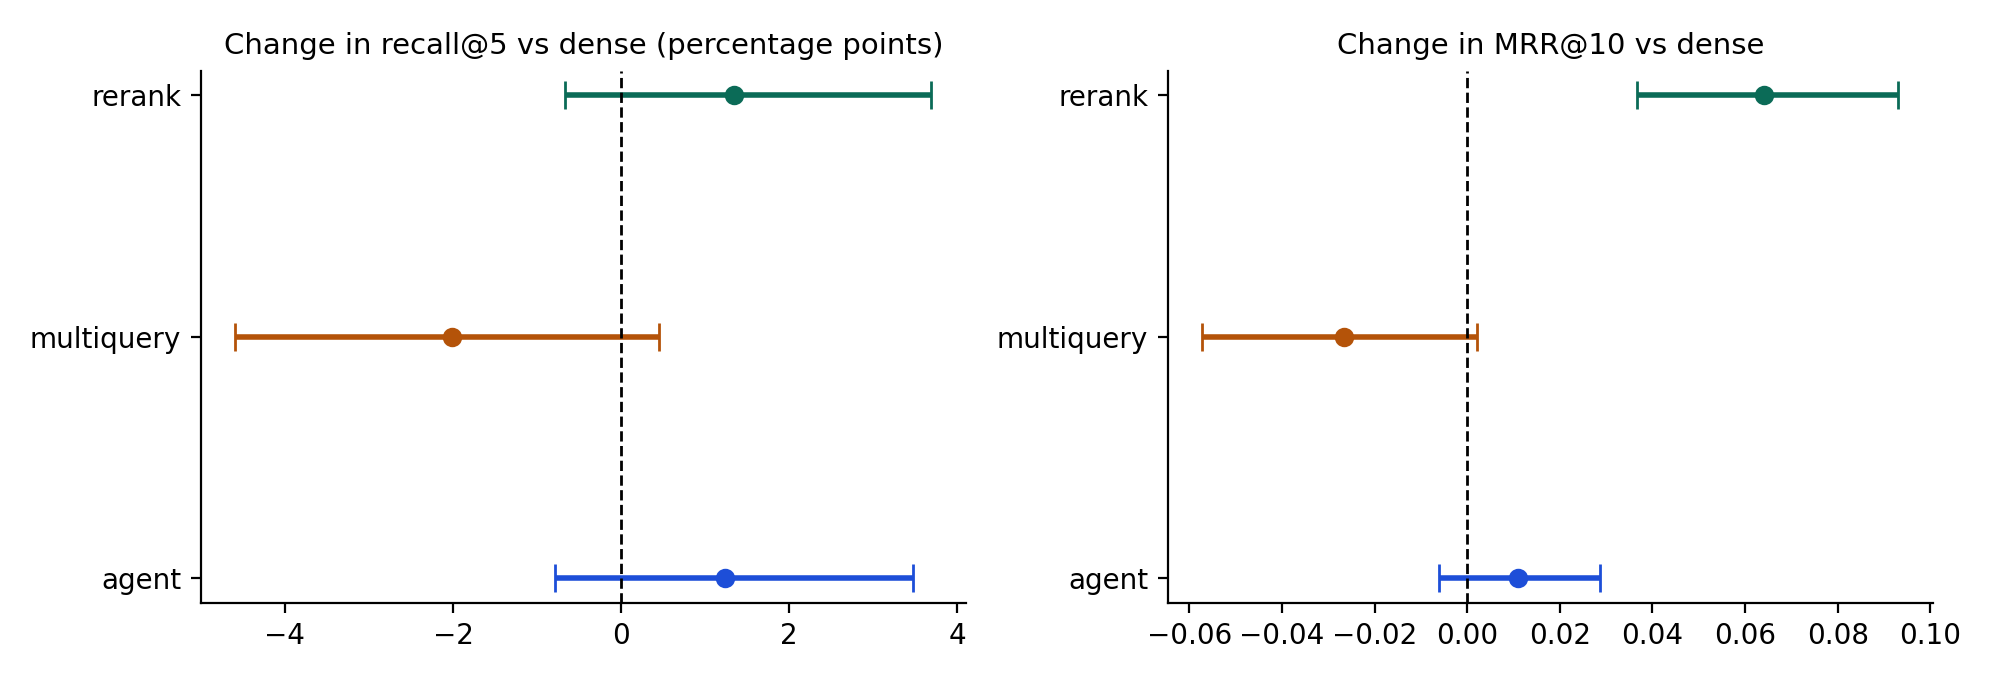 Biểu đồ so sánh mức thay đổi so với tìm kiếm cơ bản
Những giới hạn cần lưu ý
Tác giả thử nghiệm thẳng thắn liệt kê các điểm yếu của bài kiểm tra:
- Dư địa quá nhỏ: chỉ 13 câu có thể cải thiện, trong khi khoảng tin cậy rộng 2-3 điểm mỗi phía.
- Dữ liệu hẹp: chỉ gồm bài báo AI mới trong một quý, câu hỏi do mô hình viết từ chính phần tóm tắt nên dễ trùng từ ngữ.
- Cấu hình tác tử chưa tinh chỉnh: lời nhắc (prompt) chỉ viết một lần, chưa thử nghiệm các biến thể.
- Kiểm duyệt câu hỏi chưa đầy đủ: chỉ 30/300 câu được kiểm tra thủ công.
Người dùng hệ thống RAG nên làm gì?
Kết luận thực dụng của thử nghiệm khá rõ ràng: hãy đếm trước khi thêm tác tử.
- Chạy tìm kiếm cơ bản trên vài trăm câu hỏi thực tế và xem nó trượt bao nhiêu. Nếu trượt rất ít, tác tử chẳng có gì để sửa.
- Thêm reranker trước khi thêm tác tử — đây là thay đổi duy nhất có lợi ích rõ ràng mà không tốn phí gọi mô hình.
- Nếu vẫn muốn thêm tác tử: giới hạn số lần tìm, gộp kết quả theo thứ hạng chứ không theo điểm thô (dùng Reciprocal Rank Fusion), và cảnh giác với các từ khóa mới không có trong câu hỏi gốc.
Với các đội ngũ phát triển sản phẩm AI tại Việt Nam đang cân nhắc nâng cấp pipeline RAG, đây là lời nhắc hữu ích: những kỹ thuật hào nhoáng chưa chắc đem lại giá trị tương xứng với chi phí và độ trễ mà nó thêm vào.
Toàn bộ mã nguồn, bộ 298 câu hỏi và kết quả lưu sẵn đều có trong kho GitHub kèm theo bài viết gốc trên Towards Data Science. Tổng chi phí cho cả dự án dưới 0,80 USD.