Bài báo khoa học do AI viết trích dẫn một bài của TorrentFreak không hề tồn tại
Một bài báo khoa học bình duyệt trên tạp chí New Review of Academic Librarianship về Z-Library chứa ít nhất 10 trích dẫn không thể tìm thấy trong danh mục 44 tài liệu tham khảo. Các tác giả thừa nhận đã dùng Consensus AI và ChatGPT hỗ trợ, còn công cụ phát hiện AI kết luận toàn bộ phần tóm tắt và kết luận đều do AI tạo ra. Nhà xuất bản Taylor & Francis đã mở cuộc điều tra.
Một bài báo khoa học được bình duyệt (peer review) vừa công bố trên tạp chí New Review of Academic Librarianship đang gây chú ý vì lý do không ai mong muốn: nó trích dẫn một bài viết của TorrentFreak chưa từng tồn tại, cùng hàng loạt tài liệu tham khảo khác không thể xác minh.
 Minh họa robot và AI
Bài báo có tựa đề "Z-Library and Full-Text Access: Democratizing Knowledge or Undermining Copyright Ethics?", do hai thủ thư tại các trường đại học Nigeria thực hiện. Nội dung xoay quanh Z-Library — thư viện sách điện tử lậu lớn nhất Internet với hàng triệu đầu sách và bài báo miễn phí — cùng cuộc giằng co kéo dài nhiều năm giữa nền tảng này và các nhà xuất bản học thuật.
Trích dẫn "ảo" nhưng trông rất thật
Trong phần nói về các biện pháp chế tài nhắm vào Z-Library, nhóm tác giả viết rằng những nhà xuất bản lớn như Elsevier và Springer Nature cũng đã thực hiện các hành động pháp lý tương tự. Tài liệu được dẫn cho nhận định này là một bài báo của TorrentFreak từ năm 2021.
Vấn đề nằm ở chỗ: TorrentFreak chưa bao giờ đăng bài viết với tiêu đề "Publishers continue crackdown on shadow libraries" như trong danh mục tham khảo. Đường link được gắn kèm thậm chí chỉ trỏ về trang chủ của trang tin này.
TorrentFreak cho biết họ từng đưa tin về việc Elsevier và Springer Nature giành được lệnh chặn Sci-Hub tại Anh, hay việc một số tên miền của Z-Library bị đình chỉ tạm thời vì cáo buộc vi phạm bản quyền. Nhưng hành động pháp lý cụ thể mà bài báo kia nhắc tới thì hoàn toàn xa lạ với họ.
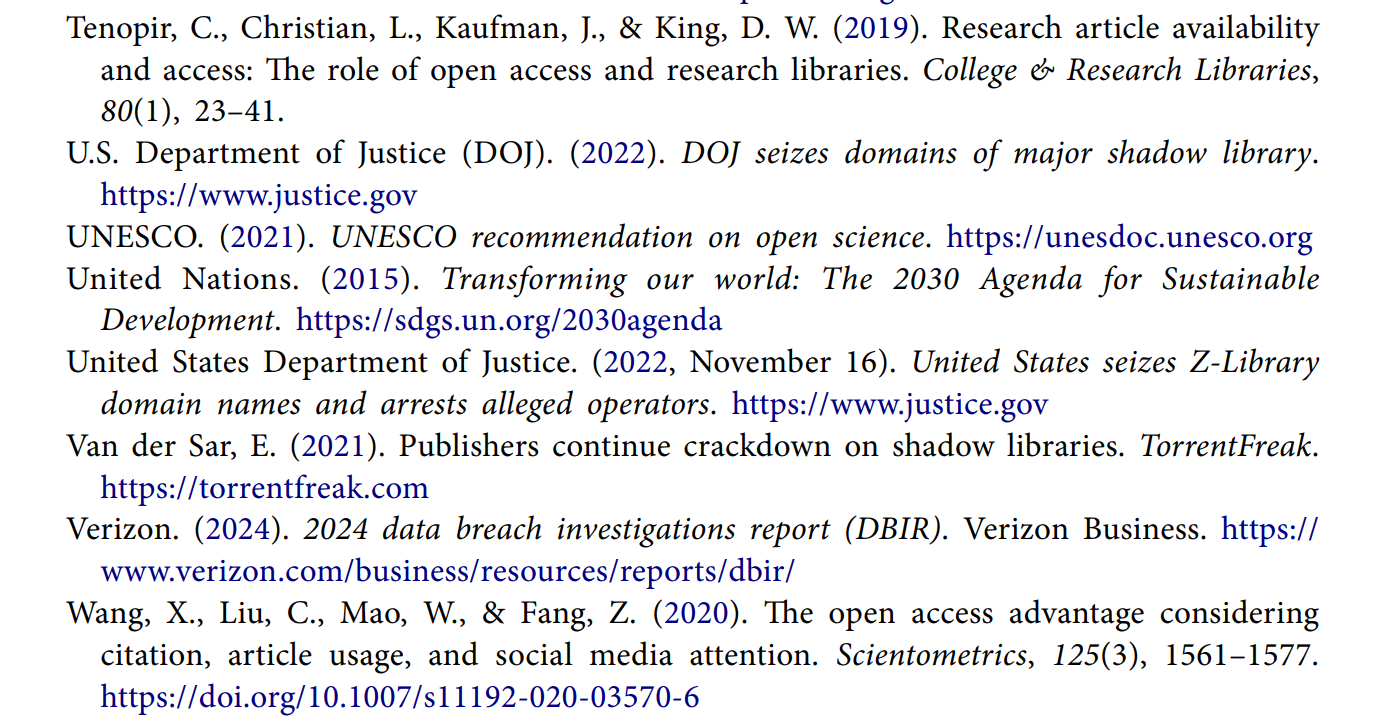 Các trích dẫn trong bài báo
Không chỉ dừng ở đó. Bài báo mô tả Bộ Tư pháp Mỹ "bắt giữ các cá nhân" vào năm 2022, trong khi thông cáo chính thức của cơ quan này nói rõ hai người bị cáo buộc điều hành Z-Library bị bắt tại Argentina "theo yêu cầu của phía Mỹ". Ngay cả tiêu đề mà bài báo gán cho thông cáo đó cũng không tồn tại.
Ít nhất 10 trong 44 tài liệu tham khảo không thể tìm thấy
Khi rà soát toàn bộ danh mục tham khảo, TorrentFreak phát hiện tình trạng này không phải cá biệt. Bài báo dẫn một nghiên cứu năm 2019 của giáo sư luật sở hữu trí tuệ Daniel Gervais trên Harvard Journal of Law & Technology — nhưng mục lục số báo đó không hề có bài này, còn các trang được trích dẫn lại thuộc về hai bài viết khác.
Tương tự, một bài của Carol Tenopir và cộng sự trên College & Research Libraries (2019) cũng không tồn tại đúng như mô tả; bà có đồng tác giả một bài cùng chủ đề năm đó, nhưng ở tạp chí khác, tiêu đề khác.
Danh sách các tài liệu "mất tích" còn có bài của Björn Brembs (2019), các bài của những tác giả mang tên Smith, Piper, Okike, Aronson, và cả một báo cáo của Kaspersky về "những hiểm họa ẩn giấu của thư viện bóng". Tổng cộng, ít nhất 10 trong số 44 tài liệu tham khảo không thể xác minh, chưa kể nhiều nguồn khác không thực sự chống đỡ cho luận điểm được nêu.
Dấu vết của AI
Câu hỏi hiển nhiên là những trích dẫn bí ẩn này đến từ đâu. Phần lời cảm ơn của bài báo có thể là gợi ý: nhóm tác giả xác nhận đã dùng Consensus AI để sàng lọc khối lượng lớn tài liệu và trích xuất thông tin liên quan, đồng thời dùng ChatGPT để trau chuốt ngôn ngữ cho một số phần.
Đây là dấu hiệu quen thuộc: các chatbot AI nổi tiếng với việc "bịa" tài liệu tham khảo, thường là tiêu đề nghe rất hợp lý gắn với tên những chuyên gia thật trong lĩnh vực. Điều này chưa đủ để kết luận AI đã tạo ra các trích dẫn đó, nhưng khi TorrentFreak chạy phần tóm tắt và kết luận của bài qua công cụ phát hiện AI Pangram, kết quả cho cả hai phần đều là "100% văn bản có khả năng do AI tạo ra".
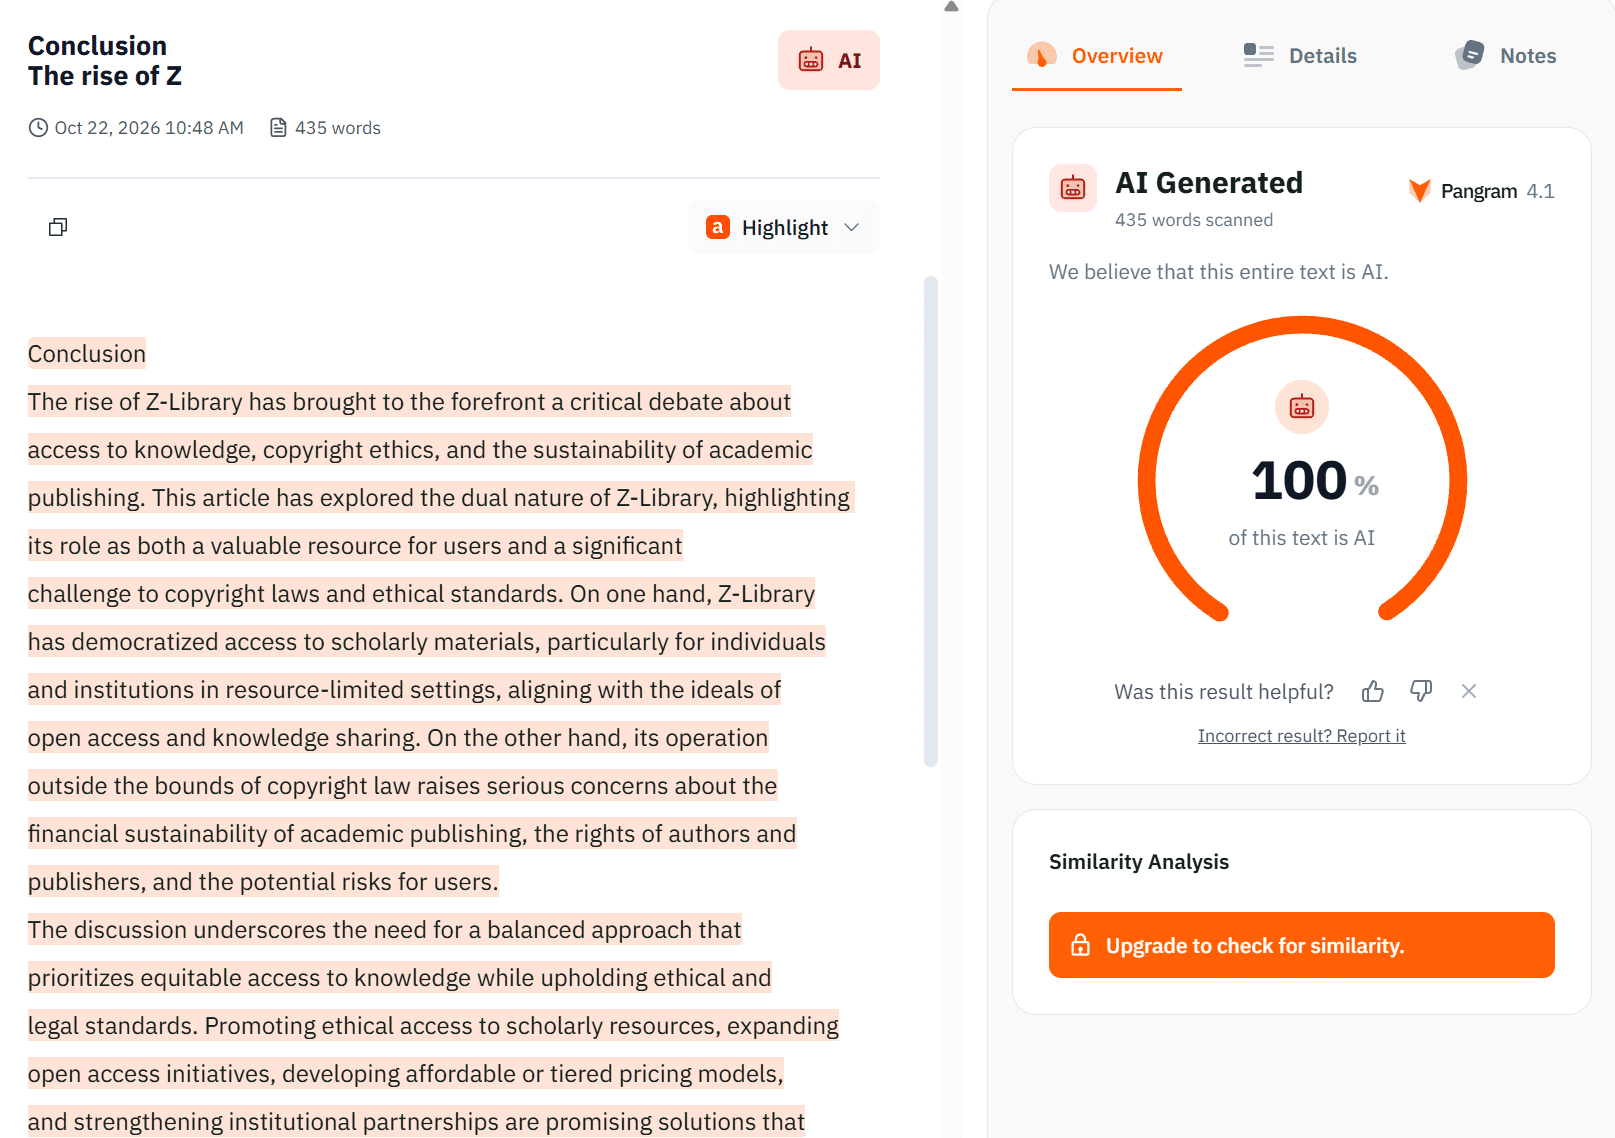 Kết luận của công cụ Pangram
Cần lưu ý rằng các công cụ kiểu này không hoàn hảo và có thể cho kết quả sai, nhưng tổng thể bức tranh khá rõ ràng. Trớ trêu thay, nếu AI chính là nguồn gốc sai sót, thì đây là một bài báo trên tạp chí thương mại có bình duyệt, do Taylor & Francis phát hành, lại dựa vào AI để viết về Z-Library — trong khi nhiều chủ bản quyền đang kiện các công ty AI vì dùng thư viện bóng để huấn luyện mô hình.
Nhà xuất bản vào cuộc
Bài báo còn đáng chú ý ở chỗ nó cảnh báo rằng những trang như Z-Library gây thiệt hại doanh thu cho nhà xuất bản, nguồn tiền được cho là để tài trợ cho bình duyệt và biên tập. Tuy nhiên, bài viết không đề cập rằng người bình duyệt thường không được trả thù lao — một vấn đề trọng tâm trong vụ kiện gần đây nhắm vào các nhà xuất bản học thuật lớn, trong đó có chính Taylor & Francis.
Tác giả chính đã chia sẻ bản thảo với TorrentFreak nhưng không trả lời các câu hỏi tiếp theo về những trích dẫn bí ẩn. Gervais, Brembs và Tenopir cũng không phản hồi khi được hỏi liệu họ có viết những bài báo đang bị gán tên mình hay không.
Ngược lại, Taylor & Francis lên tiếng xác nhận đã chuyển vụ việc cho bộ phận Biên tập và Đạo đức Xuất bản để điều tra, và từ chối bình luận thêm trong thời gian tiến hành. Việc bài báo sẽ bị đính chính hay rút lại vẫn còn bỏ ngỏ.
Sự việc là lời cảnh tỉnh cho giới học thuật: AI có thể giúp tăng tốc nghiên cứu, nhưng trích dẫn vẫn phải được con người kiểm chứng từng nguồn — đặc biệt khi quy trình bình duyệt đang ngày càng chịu áp lực về số lượng.