
Drop7 và bài toán tìm chiến lược tối ưu cho game có yếu tố may mắn
Một lập trình viên quay lại nghiên cứu Drop7 sau 16 năm, tìm cách xây dựng chiến lược tự động đạt trung bình trên một triệu điểm mỗi ván như người chơi giỏi. Dù các phương pháp học máy và tìm kiếm hiện đại đã đạt hơn 500.000 điểm, mục tiêu vẫn còn rất xa.
Drop7 và bài toán tìm chiến lược tối ưu cho game có yếu tố may mắn
Cách đây 16 năm, một lập trình viên từng viết chương trình Java để chọn nước đi tối ưu trong Drop7 — tựa game giải đố được đánh giá là hay nhất mọi thời đại. Giờ đây anh quay lại với câu hỏi lớn hơn: liệu có thể tạo ra một chiến lược tự động đạt trung bình trên một triệu điểm mỗi ván?
Dự án mới nhất đã đạt mức trung bình 516.155 điểm trên 512 ván chưa từng gặp — một con số ấn tượng nhưng vẫn chỉ bằng một nửa mục tiêu.
Vì sao Drop7 lại khó đến vậy?
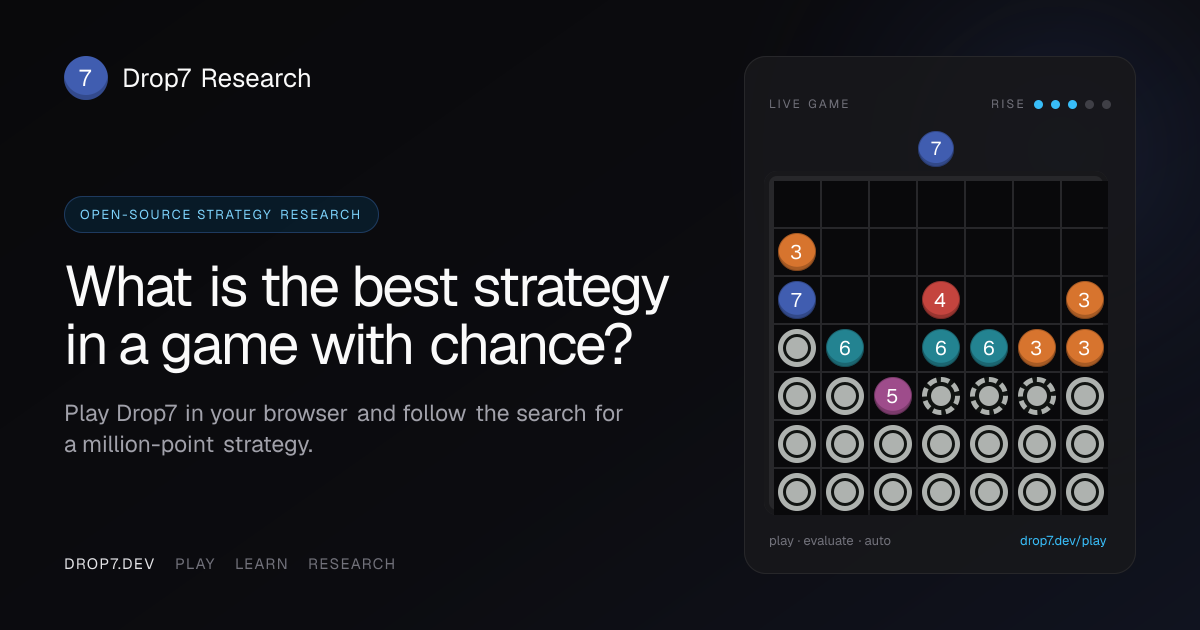
Thoạt nhìn, Drop7 có vẻ đơn giản: mỗi lượt người chơi chỉ có 7 lựa chọn là thả một viên đĩa xuống một trong bảy cột. Nhưng chính yếu tố may mắn đã biến trò chơi này thành một bài toán phức tạp với:
- Tìm kiếm trong không gian trạng thái lớn — mỗi nước đi mở ra vô số tình huống tiếp theo
- Thông tin ẩn — giá trị thực của các viên đĩa chỉ lộ ra khi chúng được kích hoạt
- Lập kế hoạch dài hạn — người chơi giỏi phải tính trước nhiều chu kỳ "dâng bàn" (rise)
- Yếu tố ngẫu nhiên — không thể biết chắc viên đĩa tiếp theo là gì
Một người chơi có kinh nghiệm, với tư duy chiến lược đúng đắn, có thể chạm mốc một triệu điểm. Trong khi đó, chiến lược tự động tốt nhất hiện tại chỉ đạt khoảng 300.000–400.000 điểm.
Mười bốn hướng tiếp cận đã được thử
Dự án đã hệ thống hóa thành 14 nhóm phương pháp, mỗi nhóm đều được giải thích từ nền tảng trước khi áp dụng vào game:
- Tìm kiếm Expectimax — nhìn trước vài nước, lấy trung bình trên các viên đĩa có thể xuất hiện
- Đánh giá heuristic — chấm điểm bàn chơi bằng tổng các đặc trưng quan sát được
- Q-learning và học giá trị — học từ các ván đã chơi để ước lượng giá trị từng cột
- Mạng n-tuple — học giá trị bàn chơi từ các mẫu ô nhỏ, huấn luyện qua hàng triệu nước tự chơi
- Mạng nơ-ron nhỏ (NNUE) — đủ nhẹ để chạy ở mọi nút lá của cây tìm kiếm
- Policy gradient — huấn luyện mạng chọn cột trực tiếp
- Tối ưu tiến hóa — tinh chỉnh trọng số qua các ván hoàn chỉnh
- Monte Carlo tree search — mở rộng cây tìm kiếm ở nơi có triển vọng
- Rollout và policy iteration — đánh giá cột bằng nhiều nước đi mô phỏng
- Oracle, teacher và distillation — dùng bộ lập kế hoạch "nhìn thấy tương lai" để dạy người chơi không nhìn thấy
- Mục tiêu rủi ro và sinh tồn — đánh giá nước đi theo kết cục xấu nhất
- Afterstate — chấm điểm trạng thái sau nước đi thay vì chính nước đi
- Lập kế hoạch kiến tạo — quy hoạch cả chu kỳ dâng bàn hướng tới hình dạng mục tiêu
- Lập kế hoạch xác định hóa — hình dung nhiều tương lai rồi lấy trung bình
Kết quả mới nhất: học máy đã vượt qua hàm đánh giá viết tay
Tháng 9/2026 đánh dấu bước ngoặt quan trọng. Lần đầu tiên, một bộ đánh giá học được đã vượt qua hàm lá viết tay trong cùng một cấu trúc tìm kiếm.
Cụ thể, các bảng tra cứu (lookup table) cho mọi hàng đầy và cột đầy của bàn chơi — 10 triệu mẫu mỗi dòng — được huấn luyện bằng temporal-difference trên engine Rust với 4 tỷ nước đi. Kết quả trên 512 ván kiểm tra:
Bảng học đạt 484.577 điểm và 140 nước, so với 314.438 điểm và 93 nước của hàm lá viết tay trong cùng tìm kiếm. Chênh lệch ghép cặp: +170.139 điểm, với giới hạn tin cậy 95% dưới là +130.499.
Kết quả này sau đó được tái lập trên một tập dữ liệu hoàn toàn khác, với mức chênh lệch +160.349 điểm. Đến cuối ngày, khi chạy ở độ sâu 4, bảng học đạt 516.155 điểm — mức cao nhất từng ghi nhận cho một chiến lược tự động.
Những gì vẫn còn bỏ ngỏ
Dù đạt thành tích ấn tượng, nhóm nghiên cứu vẫn rất thận trọng trong kết luận:
- Chưa có ứng viên nào đạt chuẩn cho giao thức kiểm định bảo vệ (protected validation protocol)
- Mức trung bình vẫn dưới một nửa mục tiêu một triệu điểm
- Một số kết quả thử nghiệm (như mở rộng gấp 6 lần bộ đánh giá, hay phân vùng theo độ lấp đầy bàn) đều không kết luận được do chênh lệch nằm trong biên độ sai số
- Bài toán vẫn hoàn toàn mở
Một phát hiện thú vị: với 64 ván ghép cặp, thiết kế thực nghiệm này không thể phát hiện hiệu ứng dưới khoảng 50.000 điểm. Mọi kết quả "không có ý nghĩa" đều thực chất là "chưa đo được" chứ không phải bằng chứng về việc không có hiệu ứng.
Một thí nghiệm về AI như trợ lý nghiên cứu
Bên cạnh khía cạnh game, dự án còn là một thử nghiệm đáng chú ý về việc dùng tác tử AI như cộng sự nghiên cứu và thu thập bằng chứng. Tác giả ghi nhận đây là một trải nghiệm khai sáng về cách các agent có thể hỗ trợ quy trình khoa học.
Toàn bộ dữ liệu — bảng huấn luyện đã đóng băng, kết quả từng ván, và phân tích thống kê — đều được công bố công khai trong kho lưu trữ nghiên cứu, cho phép máy khác tái lập hoặc tiếp tục huấn luyện.
Người chơi Việt Nam có thể tham gia
Điều hấp dẫn là bất kỳ ai cũng có thể đóng góp vào nghiên cứu này. Bạn có thể chơi Drop7 trực tiếp trên trình duyệt, gửi lựa chọn cột của mình, và điểm số đã xác minh sẽ được đưa lên cùng một bảng xếp hạng với các chiến lược tự động.
Hiện tại, kỷ lục của con người là 373.319 điểm, trong khi chiến lược máy dẫn đầu đạt 1.113.829 điểm trên cùng bộ dữ liệu. Nếu bạn có tư duy chiến lược tốt và am hiểu game giải đố, đây là cơ hội để đóng góp trực tiếp vào một bài toán nghiên cứu AI thú vị.
Tác giả đặc biệt mong nhận phản hồi từ những người am hiểu lý thuyết trò chơi, quy hoạch ngẫu nhiên, hàm giá trị học được, hoặc đánh giá phân phối đuôi nặng — đặc biệt về cách xếp hạng hành động trong tầm nhìn dài hạn.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Không có mã nguồn? Không thành vấn đề: bài học từ ACM Queue về kỹ thuật đảo ngược phần mềm
23 tháng 10, 2026