
Giải mã khả năng suy luận không gian của AI: Vì sao mô hình vẫn thua con người ở các bài toán khó?
Con người giải được 98% các câu đố không gian trong nghiên cứu, trong khi mô hình tốt nhất chỉ đạt 83,6% tổng thể và chỉ 49,4% ở mức khó nhất. Bằng cách tách nhỏ bài toán thành bốn kỹ năng riêng biệt, các nhà nghiên cứu chỉ ra chính xác mô hình AI yếu ở đâu: đọc bàn cờ từ ảnh, theo dõi đường đi của mình, tuân thủ quy tắc, và điều chỉnh nỗ lực theo độ khó.
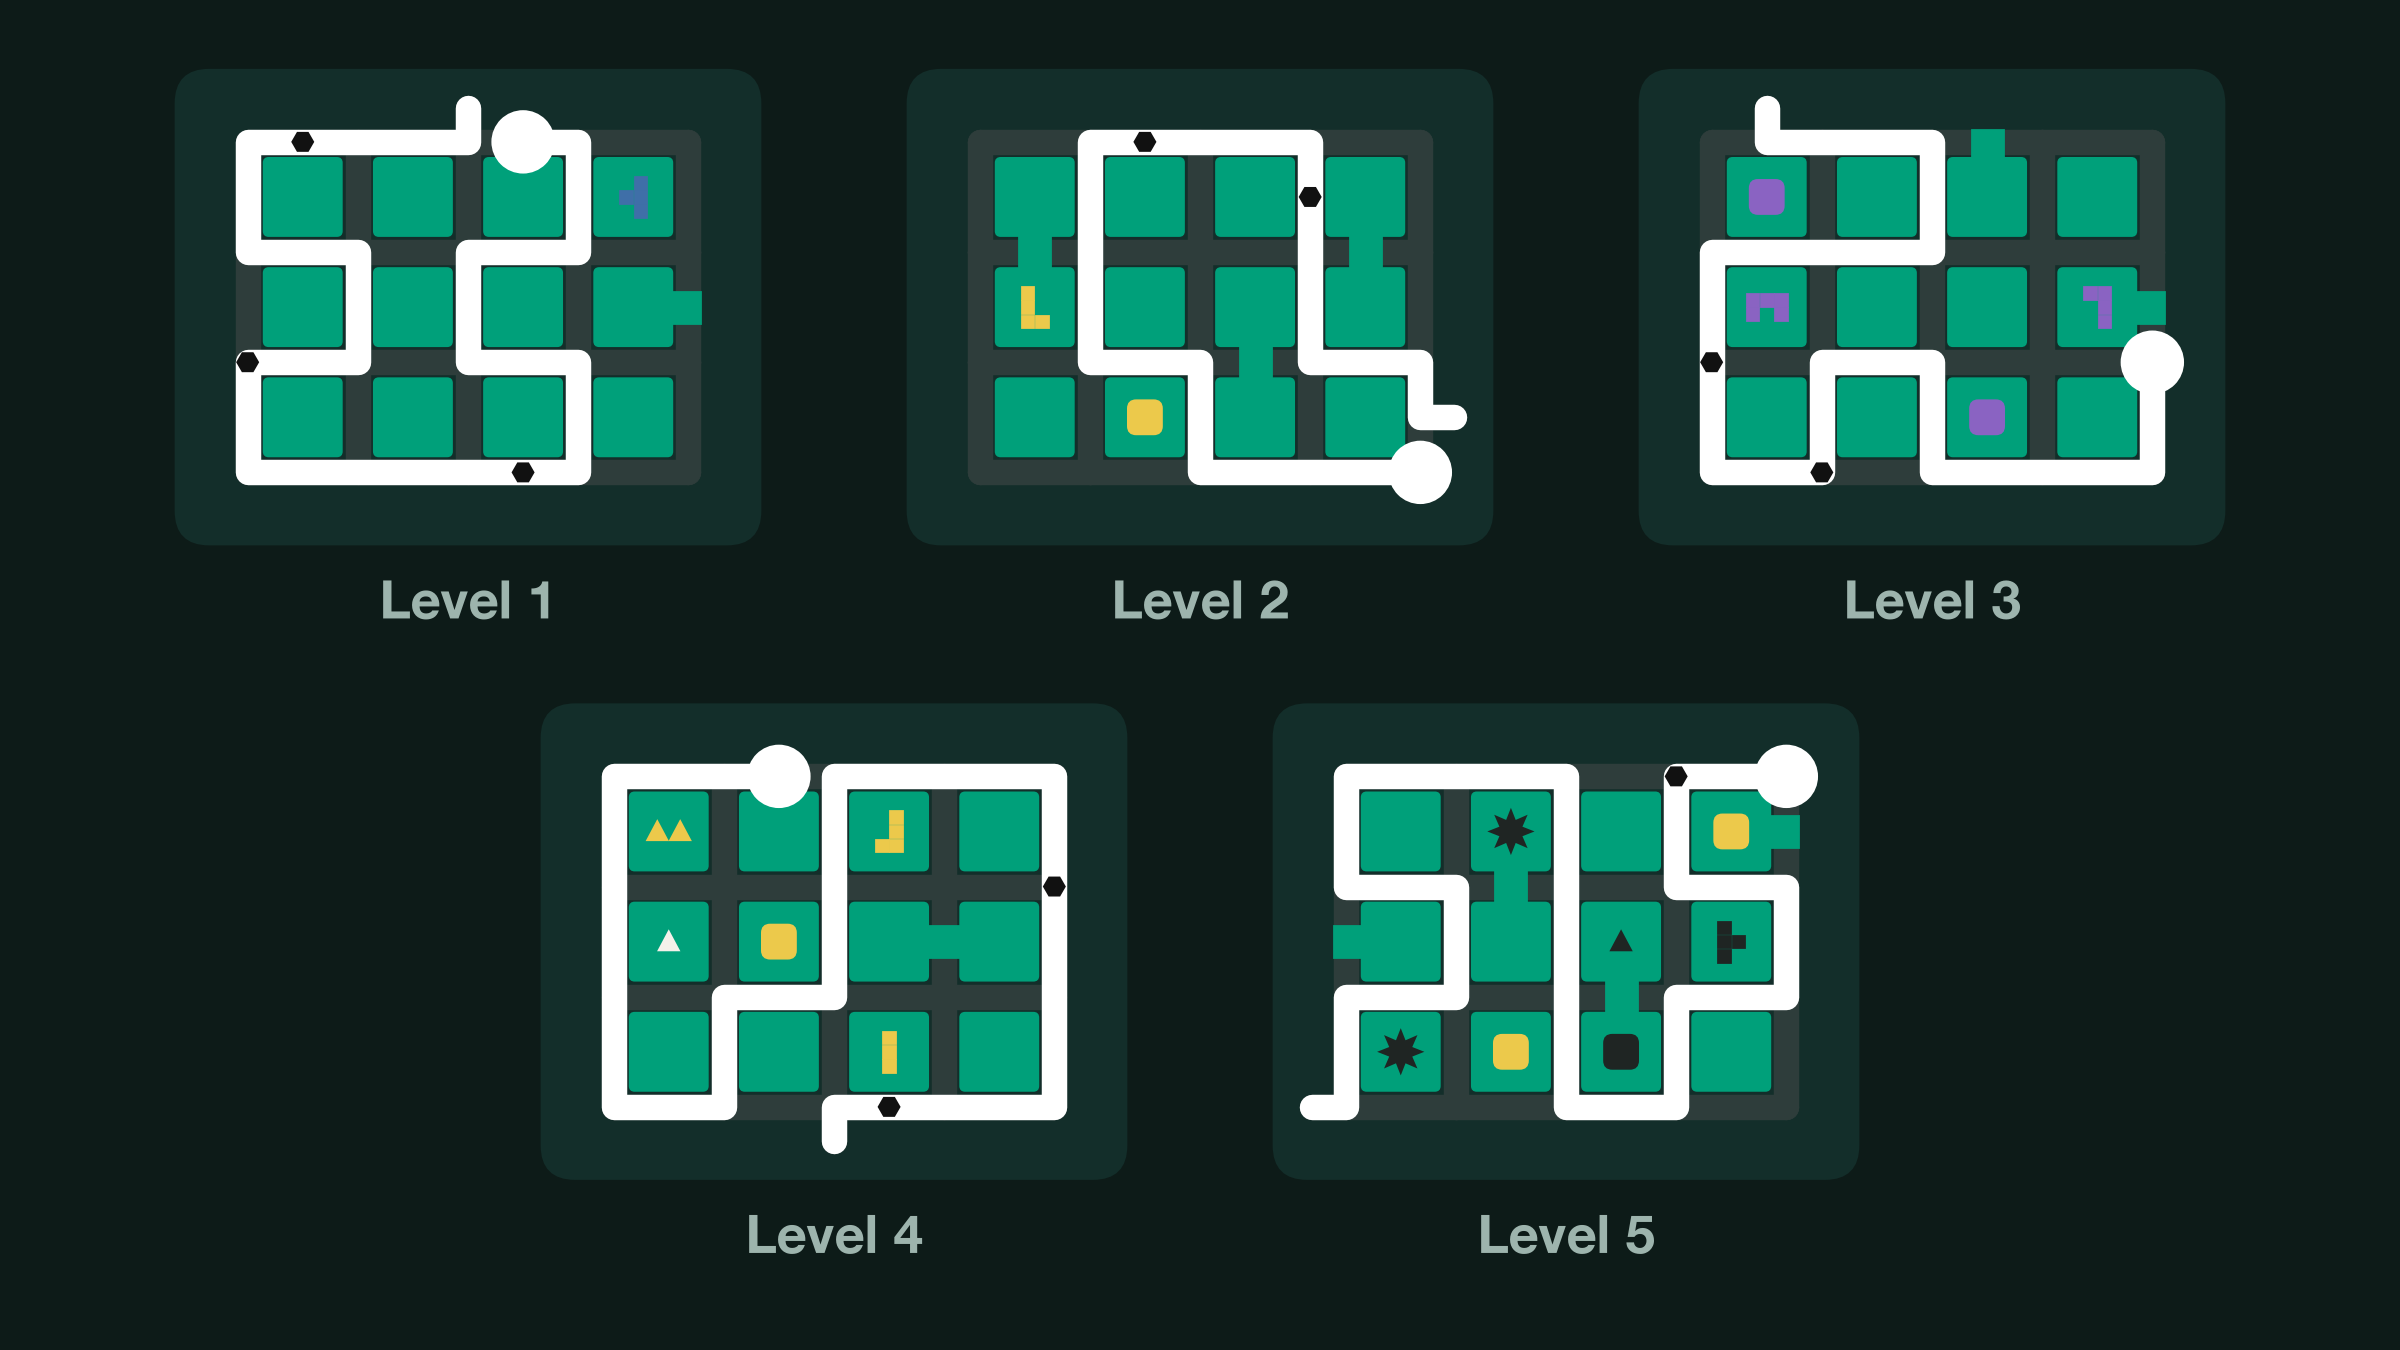
Giải mã khả năng suy luận không gian của AI: Vì sao mô hình vẫn thua con người ở các bài toán khó?
Con người giải được 98,0% các câu đố không gian trong nghiên cứu, trong khi mô hình tốt nhất hiện nay chỉ đạt 83,6% tổng thể và vỏn vẹn 49,4% ở mức khó nhất. Bằng cách tách nhỏ bài toán thành bốn kỹ năng riêng biệt, các nhà nghiên cứu chỉ ra chính xác mô hình AI yếu ở đâu — và mỗi điểm yếu lại đòi hỏi một cách khắc phục khác nhau.
 Minh họa bài toán suy luận không gian dạng lưới
Bài toán hoạt động như thế nào?
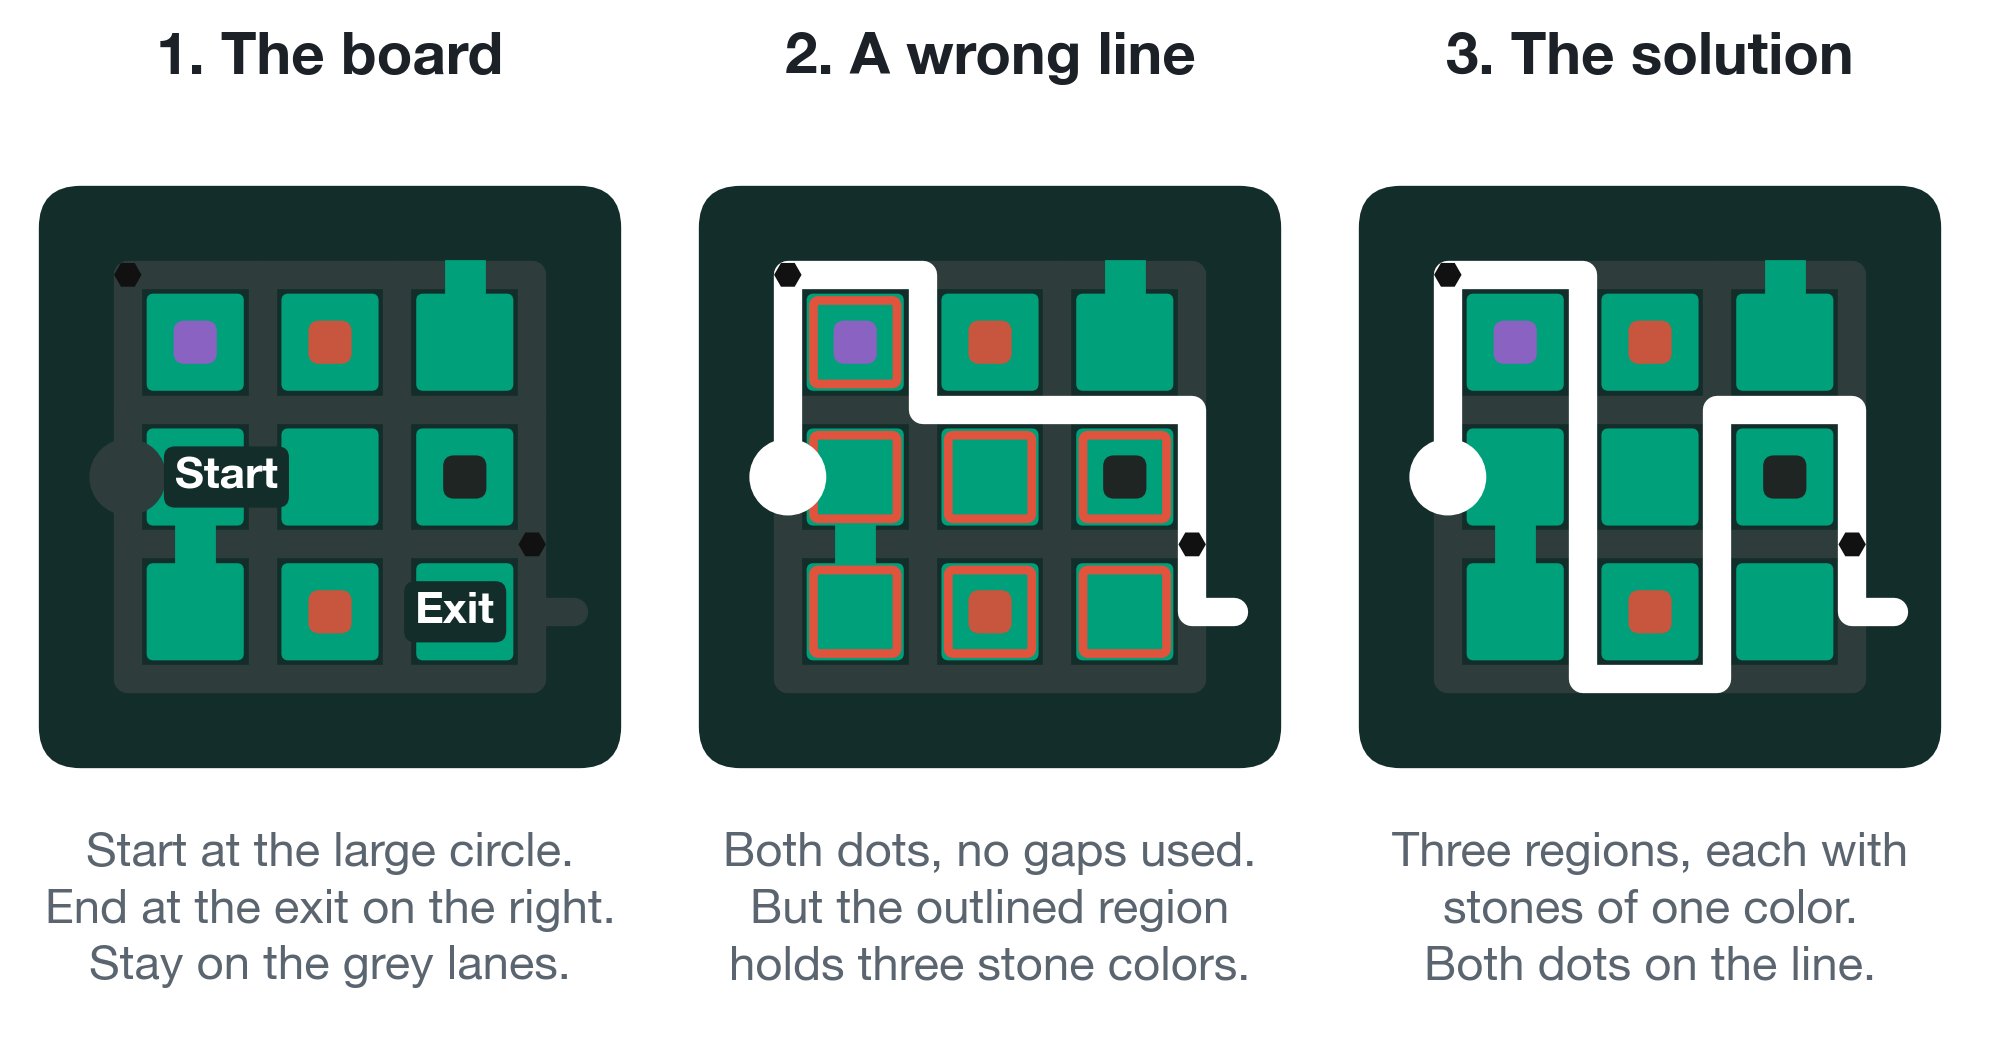
Mỗi câu đố là một bàn cờ nhỏ gồm các ô vuông xanh với những làn đường màu xám chạy giữa chúng. Người giải phải vẽ một đường duy nhất dọc theo các làn đường, bắt đầu từ vòng tròn lớn ở mép bàn cờ và kết thúc tại lối ra. Đường đi có thể rẽ ở bất kỳ góc nào nhưng không được tự cắt, không được rời khỏi làn đường và không được xuyên qua ô vuông.
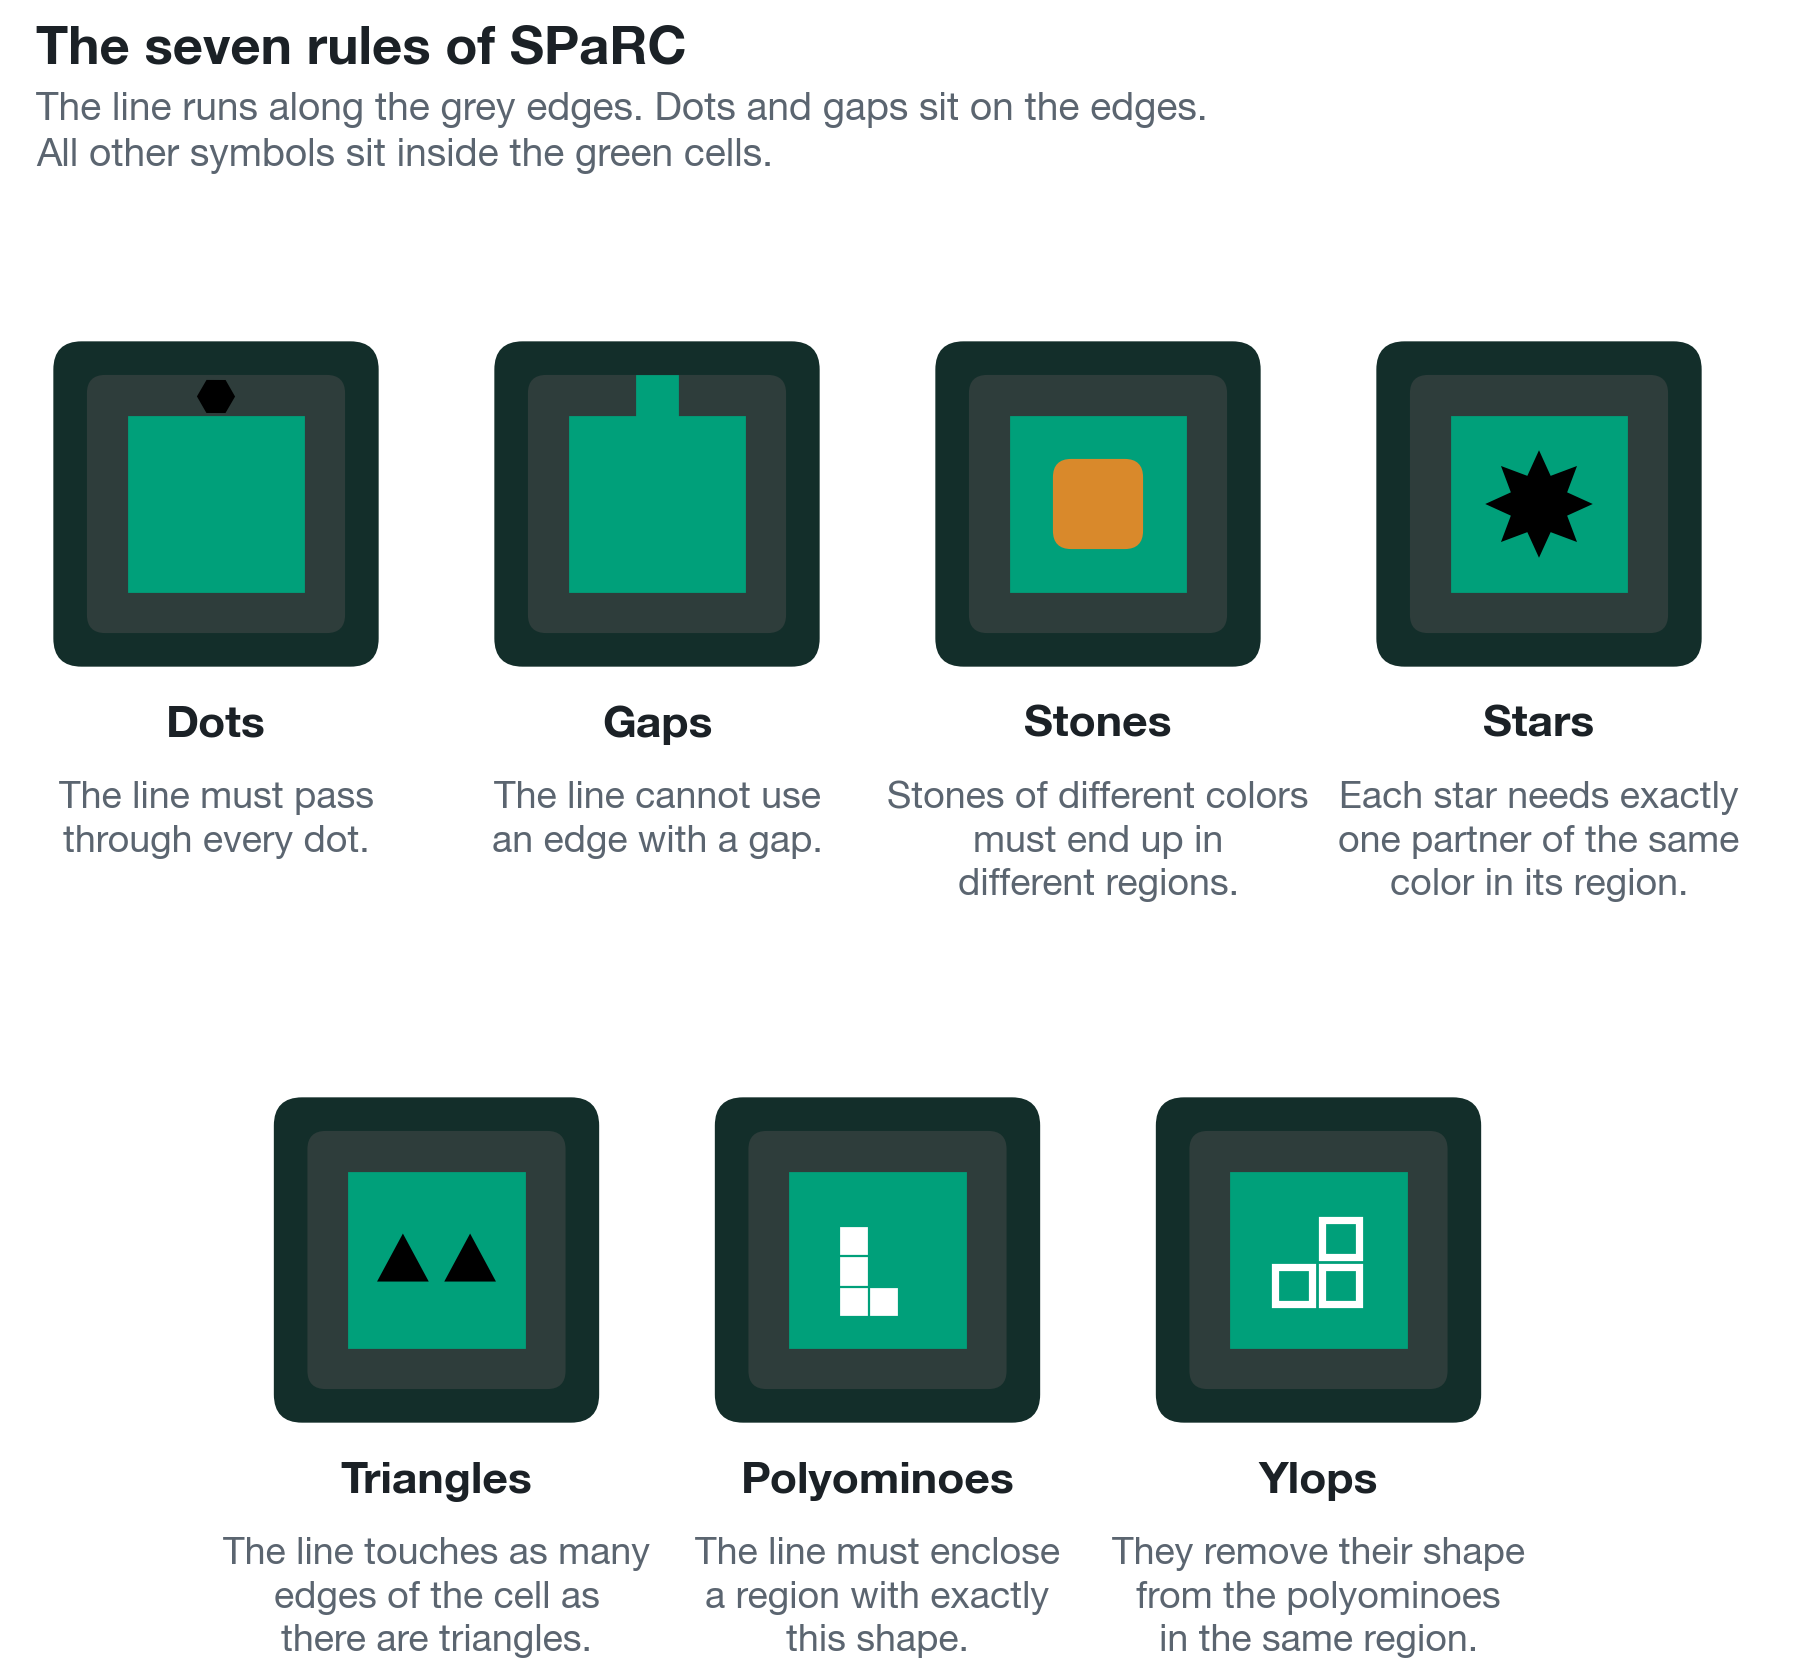
Các ký hiệu trên bàn cờ quyết định đường nào hợp lệ. Một chấm (dot) phải nằm trên đường. Một khe (gap) — cây cầu xanh bắc ngang làn đường — chặn đoạn đó lại. Còn các viên đá màu (stone) khác màu nhau phải nằm ở các vùng khác nhau, trong đó "vùng" được hiểu là nhóm ô mà đường đi bao kín lại, tách biệt khỏi phần còn lại của bàn cờ.
Phiên bản đầy đủ của bộ đánh giá SPaRC có bảy loại quy tắc khác nhau, lấy cảm hứng từ tựa game giải đố nổi tiếng The Witness. Con người thường giải bằng cách vẽ trực tiếp trong ứng dụng, còn các mô hình AI nhận bàn cờ dưới dạng văn bản — một lưới các chuỗi ký tự.
Bộ dữ liệu gồm 1.000 câu đố (500 dùng để huấn luyện, 500 để kiểm thử), chia thành năm mức độ khó. Nghiên cứu người thật được thực hiện trên 100 câu đố, mỗi câu do ba người giải.
Mọi mô hình đều "rơi vực" ở một điểm nào đó
Độ chính xác ở các mức dễ không nói lên nhiều điều. Điều đáng quan tâm là chuyện gì xảy ra khi bài toán khó dần lên.
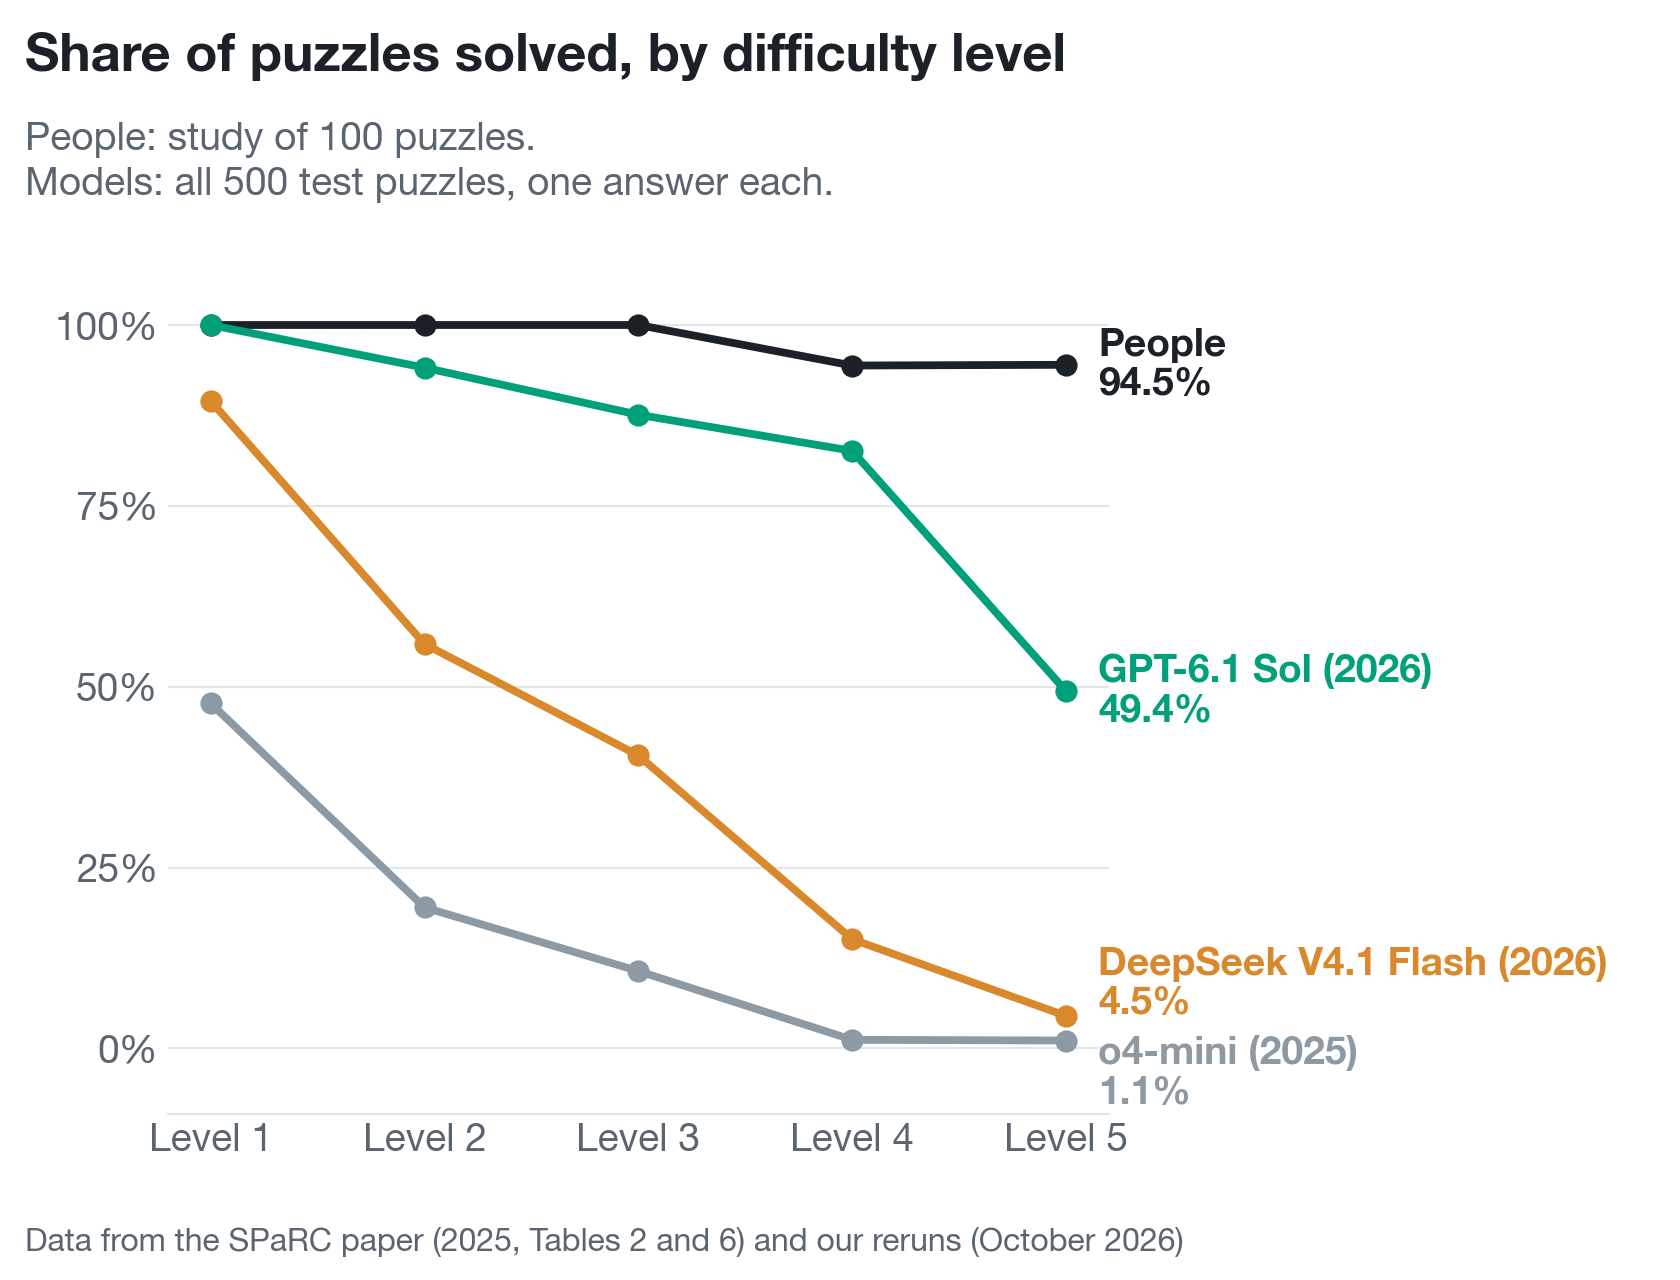
Con người gần như luôn ở đỉnh cao ở mọi mức độ. Mọi mô hình đều có điểm rơi. Khi công bố SPaRC năm 2025, mô hình tốt nhất được thử nghiệm là o4-mini chỉ giải được 15,8% tổng thể và 1,1% ở các câu khó nhất. Đến nay, GPT-6.1 Sol giải được toàn bộ câu mức 1 và 82,6% câu mức 4, nhưng tụt xuống còn 49,4% ở mức 5 — trong khi con người đạt 94,5% ở chính mức này.
Câu hỏi 1: Mô hình có "đọc" được bàn cờ không?
Đây là kỹ năng dễ sai nhất mà không hề hay biết. Trong SPaRC, khi cho o4-mini xem ảnh của câu đố thay vì lưới văn bản, độ chính xác của nó giảm từ 12,6% xuống 5,6%. Trong môi trường Spatial-Gym, mô hình thị giác Qwen3-VL-32B giải được 10,2% câu đố từ văn bản nhưng chỉ 2,8% từ ảnh — trong khi phiên bản chỉ dùng văn bản Qwen3-32B đạt 10,6%. Nghĩa là vấn đề không nằm ở phần thị giác của mô hình, mà nằm ở chính hình ảnh.
 So sánh các cách vẽ cùng một câu đố ảnh hưởng đến độ chính xác
Nghiên cứu về "giàn giáo thị giác" (visual scaffolds) giữ nguyên câu đố và chỉ thay đổi cách vẽ. Với Qwen 3.5 397B — mô hình mạnh nhất được thử — chỉ riêng cách vẽ đã làm thay đổi độ chính xác tới 34,0 điểm phần trăm: từ 14,4% với ảnh gốc lên 48,4% với phiên bản thay ký hiệu bằng chữ. Qwen 3.5 27B tăng từ 8,2% lên 40,0% nhờ tọa độ ô, còn Gemma 4 31B tăng từ 2,2% lên 26,2%. Hai mô hình yếu nhất thì dù vẽ kiểu gì vẫn dưới 1%.
Khi yêu cầu mô hình "đọc lại" bàn cờ từng ô một mà không giải, Qwen 3.5 397B nhận diện sai tới 65% số khe thành làn đường bình thường trên ảnh gốc, và chỉ xác định đúng 48% số lối ra. Tỷ lệ đọc bàn cờ không sai một ô nào tương quan rất chặt với độ chính xác giải bài, hệ số r = 0,96.
Đọc bàn cờ từ hình ảnh là một bài toán lớn riêng biệt. Hình vẽ rõ ràng giúp các mô hình mạnh rất nhiều, nhưng chẳng giúp gì cho các mô hình yếu.
Câu hỏi 2: Mô hình có theo dõi được đường đi của chính mình không?
Ngay cả khi đọc từ văn bản, nhiều câu trả lời đã sai trước khi xét đến bất kỳ quy tắc nào. Mô hình viết đường đi thành danh sách tọa độ, và danh sách đó phải mô tả một đường liền mạch từ điểm xuất phát đến lối ra. Có bốn kiểu sai cơ bản: sai điểm đầu/cuối, đường bị đứt đoạn, đường tự cắt, hoặc đường chạy xuyên qua ô.
Trong SPaRC, 59,2% câu trả lời của o4-mini và 93,6% của GPT-4.1 mắc ít nhất một lỗi trong số này. Lỗi phổ biến nhất ở sáu trong bảy mô hình được thử là chạy xuyên qua ô.
Khi phân tích thủ công 48 chuỗi suy luận của DeepSeek R1 Distill Llama 70B, nhóm nghiên cứu thấy 26 trường hợp mô hình đọc sai lưới hoặc tọa độ, và 23 trường hợp bỏ qua vài bước cùng lúc. Việc viết một danh sách tọa độ dài mà không mất dấu vị trí là thử thách lớn với mô hình ngôn ngữ.
Môi trường Spatial-Gym loại bỏ gánh nặng ghi chép này: mỗi câu đố trở thành một môi trường Gymnasium, và mô hình chỉ chọn từng nước đi một. Điều này giúp các mô hình yếu hơn (Qwen 3 32B tăng từ 5,2% lên 10,6%) nhưng lại làm hại mô hình mạnh nhất (GPT-OSS 120B giảm từ 21,6% xuống 16,0%). Các mô hình mạnh hiếm khi viết đường gãy ngay từ đầu, nên việc buộc phải quyết định từng bước một cản trở khả năng hoạch định toàn bộ đường đi.
Câu hỏi 3: Mô hình có tuân thủ quy tắc không?
Khi đường đi đã hợp lệ và bàn cờ đã được đọc đúng, các quy tắc vẫn còn đó. Hai mốc so sánh đơn giản trong Spatial-Gym cho thấy rõ điều này: thuật toán tìm kiếm A* luôn tìm được đường ngắn nhất và luôn đến được lối ra, nhưng chỉ giải được 6,4% câu đố vì bỏ qua quy tắc. Một bước đi ngẫu nhiên giải được 2,4%.
 Tỷ lệ đến được lối ra so với tỷ lệ giải đúng thực sự
Tính năng hoàn tác (undo) cho thấy khoảng cách tương tự từ góc độ khác: GPT-OSS 120B đến được lối ra thường xuyên hơn (94% so với 85%) nhưng lại giải được ít câu hơn (10,2% so với 16,0%). Phần khó không phải là đến đích, mà là đến đích với mọi quy tắc được thỏa mãn.
Các quy tắc cũng có độ khó rất khác nhau. Trên bộ 50 câu chỉ có quy tắc khe, o4-mini giải được 84,0%; trên bộ có quy tắc đa giác (polyomino) và ylop, con số này chỉ còn 4,0%. Lý do: một khe cho biết ngay làn đường bị chặn, còn một chấm bị bỏ sót chỉ lộ ra khi đường đi hoàn tất, và quy tắc hình dạng phụ thuộc vào toàn bộ vùng mà đường đi bao kín.
Câu hỏi 4: Mô hình có "cố gắng hơn" khi bài toán khó hơn không?
Con người trong nghiên cứu chậm lại rõ rệt khi câu đố khó dần: thời gian trung bình mỗi câu tăng từ 10,7 giây ở mức 1 lên 131,5 giây ở mức 5, tức hơn 12 lần. Hai mô hình suy luận mở mà nhóm nghiên cứu đo được thì gần như không thay đổi: QwQ 32B viết khoảng 14.400 token cho câu mức 1 và khoảng 13.100 token cho câu mức 5.
Cùng một mô-típ xuất hiện trong chính các đường đi: lời giải đúng dài dần khi bài toán khó lên, nhưng đường mà mô hình vẽ ra thì gần như không dài thêm. Các mô hình mạnh cũng hiếm khi dùng nước hoàn tác. Đáng chú ý, trong 25/48 chuỗi suy luận đọc thủ công, mô hình nhận ra mình đã mắc lỗi hoặc đi vào ngõ cụt trước khi trả lời — và vẫn trả lời như cũ.
Nỗ lực có ý nghĩa khi được dùng đúng chỗ. Qwen 3 32B giải được 10,6% khi bật chế độ suy luận và chỉ 2,2% khi tắt. Thử nhiều lần cũng giúp, nhưng chủ yếu ở nơi mô hình vốn đã khá: với tám lần thử mỗi câu, o4-mini tăng từ 47,7% lên 80,2% ở mức 1, nhưng ở mức 5 chỉ tăng từ 1,1% lên 3,4%.
Ý nghĩa đối với việc xây dựng và đánh giá mô hình
Một con số độ chính xác duy nhất trộn lẫn cả bốn kỹ năng. Khi tách riêng, mỗi kỹ năng thất bại theo một cách khác nhau — và mỗi thất bại trỏ đến một cách khắc phục khác nhau.
- Với người xây dựng bộ đánh giá thị giác: cách vẽ quan trọng ngang với bản thân bài toán. Nếu chỉ dùng một định dạng ảnh duy nhất, bộ đánh giá có thể đang đo khả năng nhận thức thay vì đo khả năng suy luận. Công bố song song cả phiên bản văn bản lẫn hình ảnh sẽ giúp thấy rõ khác biệt.
- Với người so sánh các mô hình: hãy nhìn vào mức khó nhất. Điểm tổng thể 83,6% và điểm mức khó nhất 49,4% mô tả cùng một mô hình — khoảng cách giữa hai con số này chính là nơi các bài toán mở còn tồn tại.
- Với việc tinh chỉnh mô hình: hình vẽ rõ ràng chỉ giúp mô hình mạnh; đi từng bước chỉ giúp mô hình mất dấu đường đi; thử nhiều lần chỉ giúp ở câu dễ. Không có giải pháp nào "một cỡ vừa tất cả".
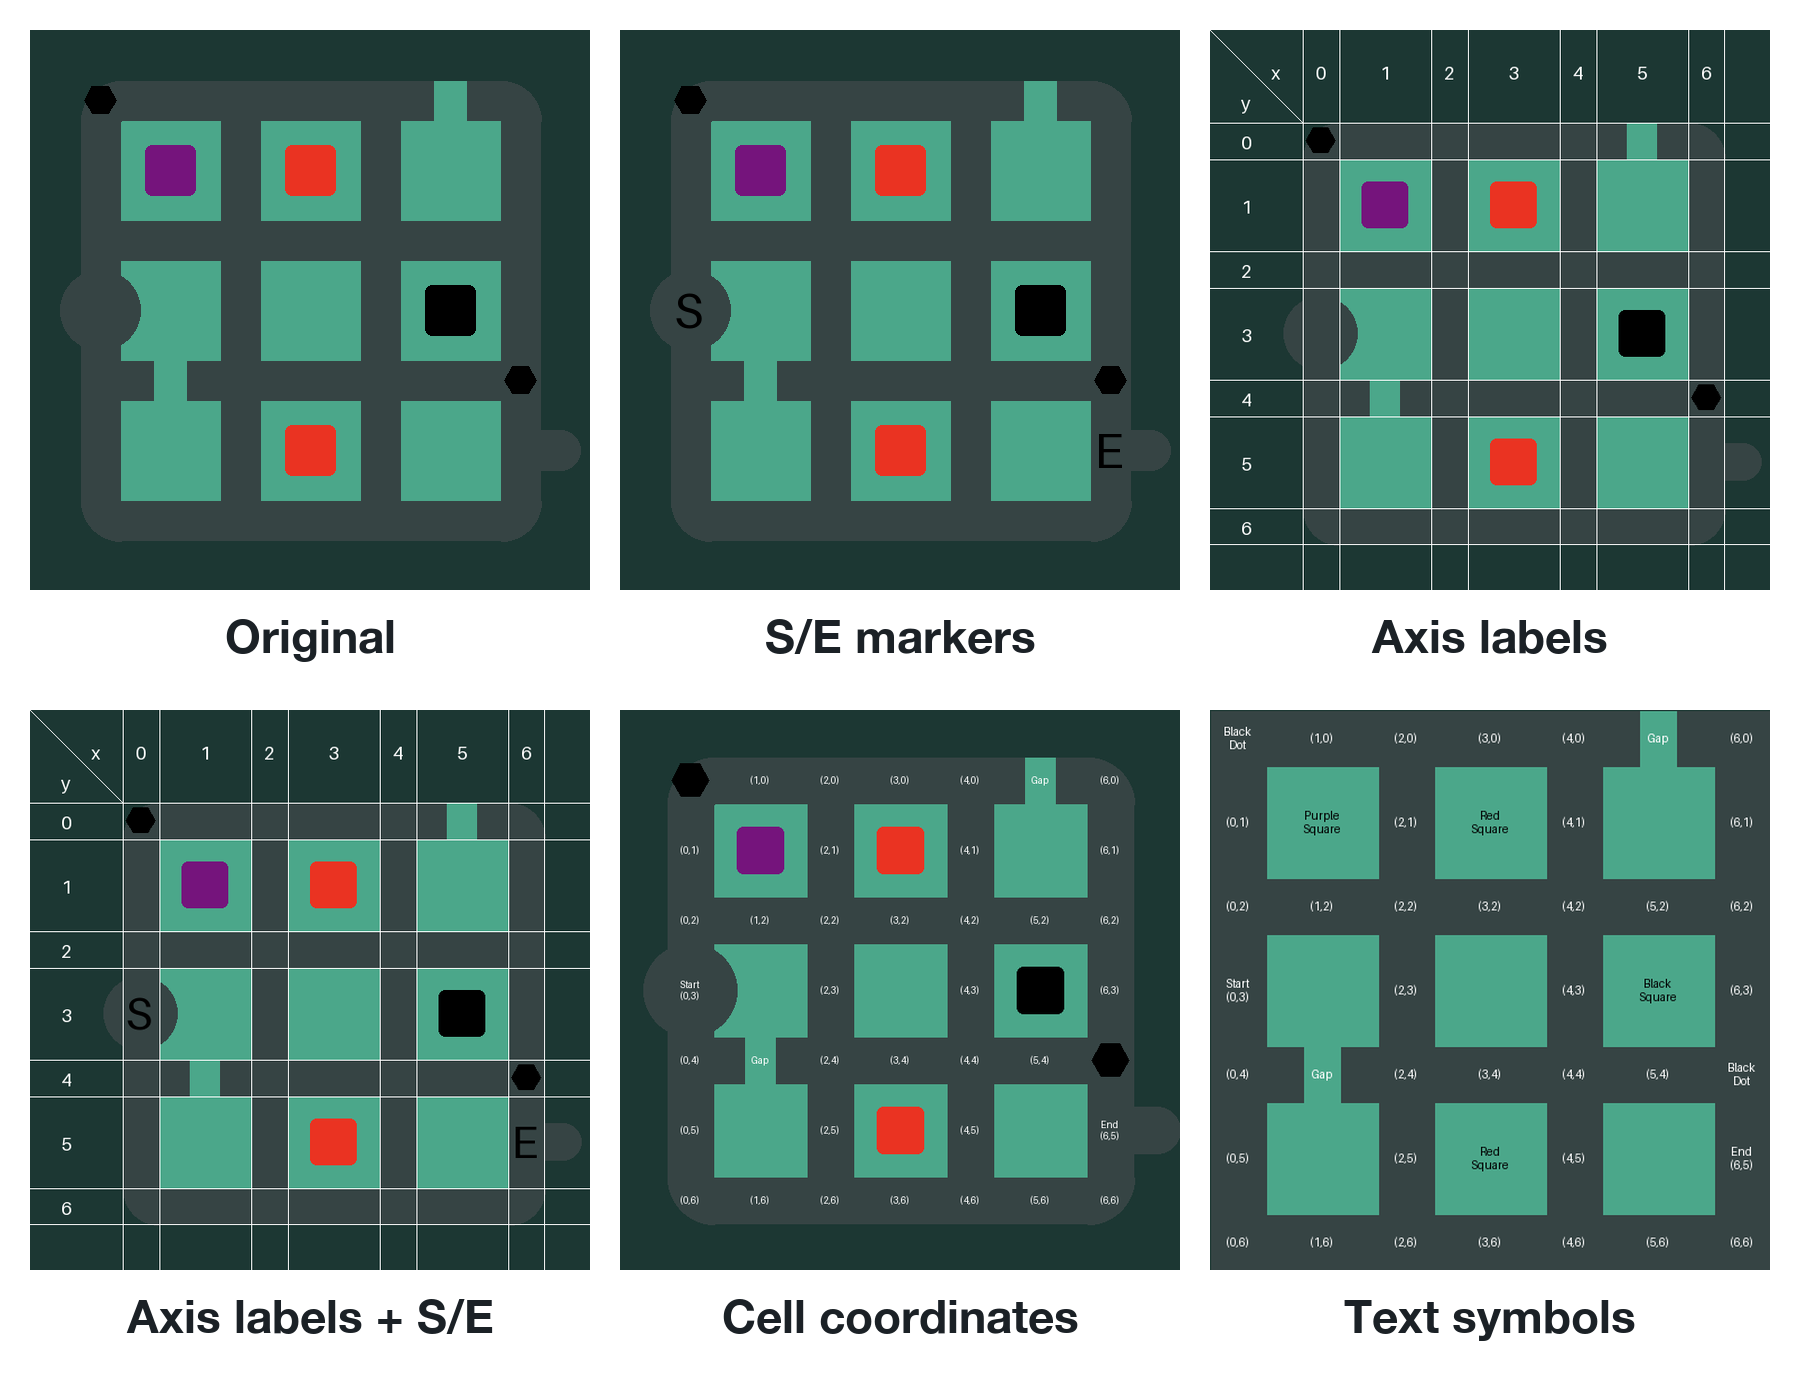 Các mức độ hỗ trợ thị giác khác nhau ảnh hưởng không đồng đều tới từng mô hình
Tự mình thử nghiệm
Độc giả quan tâm có thể chơi các câu đố trực tiếp trên trình duyệt tại sparc.gipplab.org, nơi cũng có bảng xếp hạng. Để đánh giá một mô hình bằng Inspect AI, chỉ cần chạy:
pip install "sparc-puzzle[inspect]"
inspect eval sparc/sparc --model openai/gpt-4.1-mini --limit 50
Các câu đố được xếp xen kẽ theo mức độ, nên --limit 50 sẽ cho 10 câu mỗi mức. Để thử chế độ đi từng bước, cài đặt Spatial-Gym bằng pip install Spatial-Gym và chạy đoạn mã Python đi kèm trong bài viết gốc. Bộ dữ liệu có sẵn trên Hugging Face, mã nguồn trên GitHub cho cả SPaRC và Spatial-Gym.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Nvidia phát hành driver mới giúp tăng tốc khởi động game PC nhờ công nghệ shader đám mây
21 tháng 10, 2026