
Hộp giới hạn: Cách phân biệt trace agent chấp nhận được và không chấp nhận được
Bài viết trình bày phương pháp gộp nhiều chỉ số đánh giá (chi phí, độ trễ, chất lượng) thành một điểm số duy nhất để đánh giá cấu hình agent AI. Tác giả xây dựng hàm tính điểm khoảng 40 dòng NumPy, giúp biến các yêu cầu rời rạc từ nhiều phòng ban thành một quy tắc quyết định rõ ràng khi triển khai agent lên môi trường production.
Hộp giới hạn: Cách phân biệt trace agent chấp nhận được và không chấp nhận được
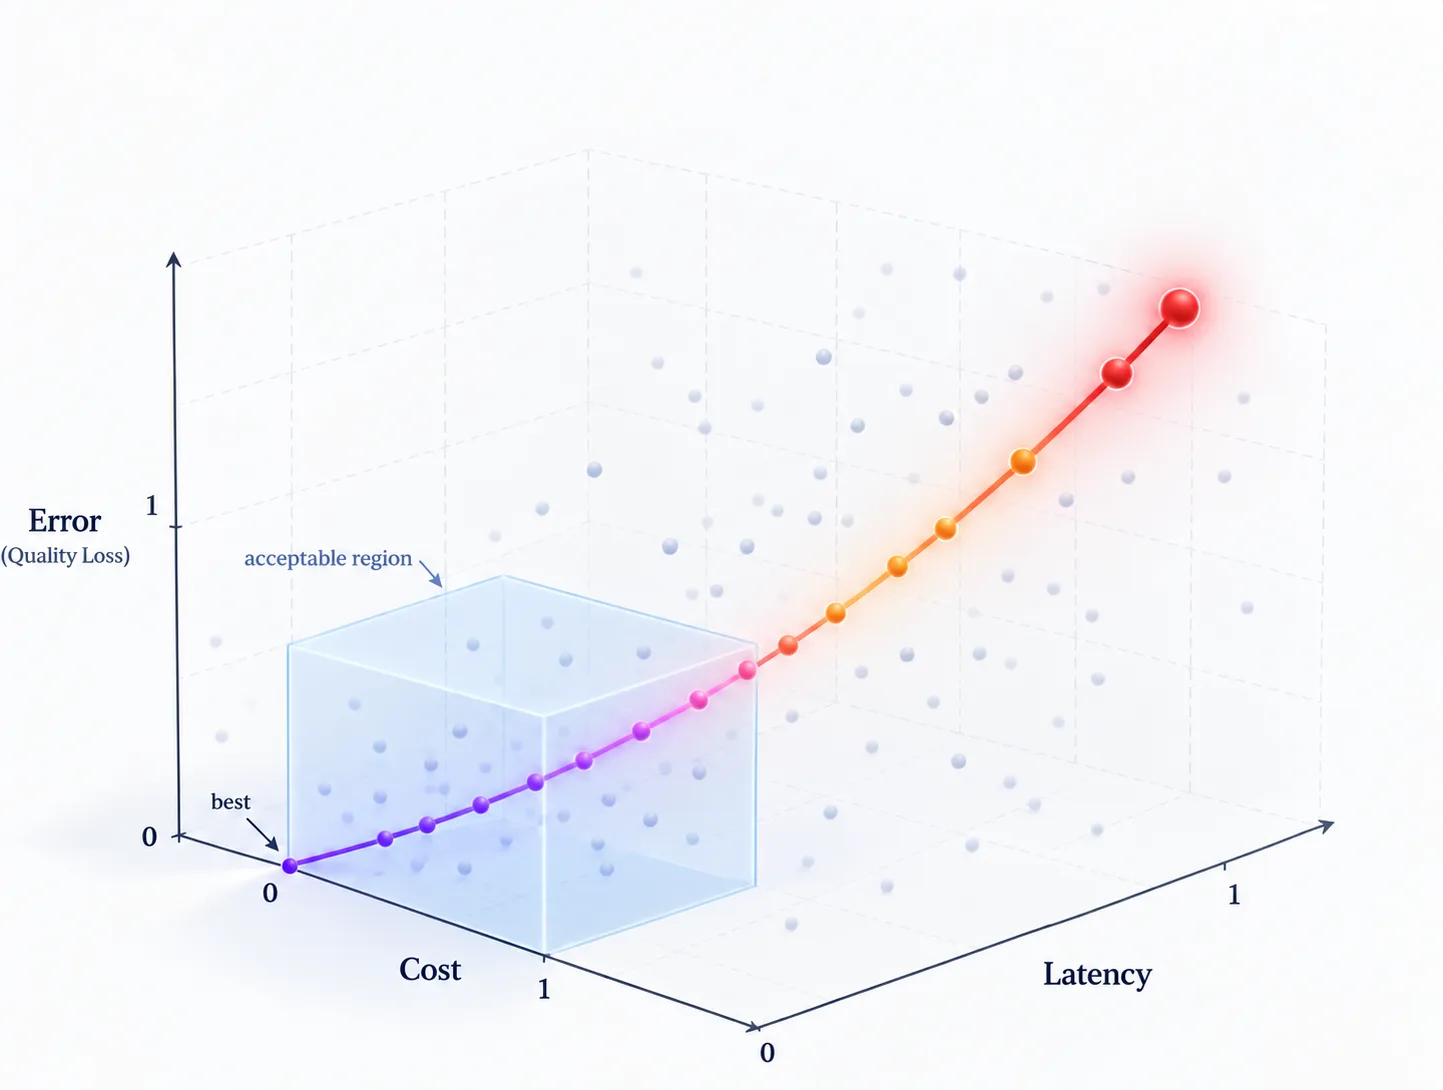
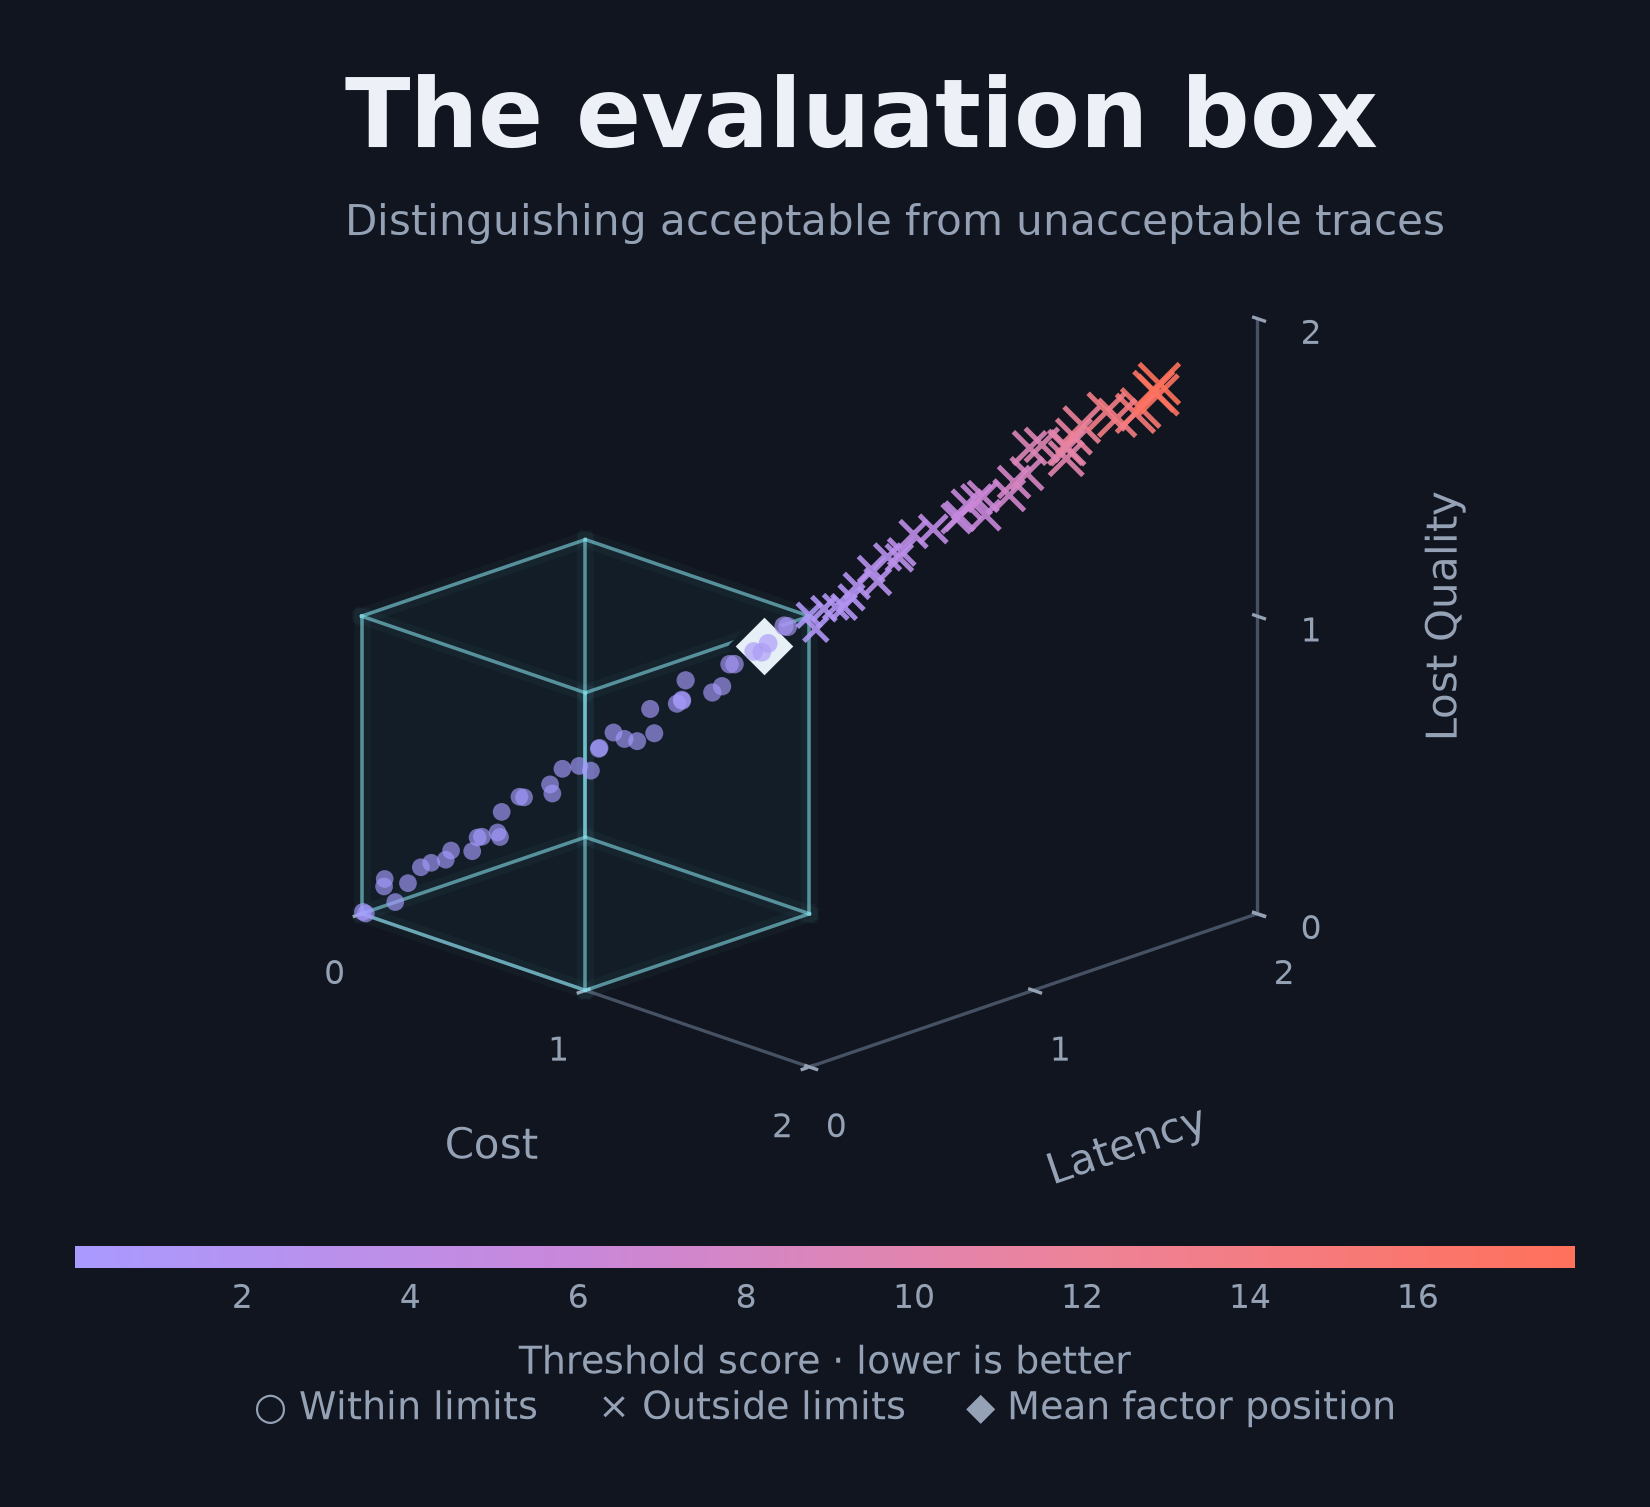
Khi đưa agent AI vào vận hành thực tế, đội ngũ thường có rất nhiều chỉ số đánh giá nhưng lại thiếu một thước đo chung để quyết định "cấu hình nào là đủ tốt". Bài viết này trình bày cách gộp các chỉ số chi phí, độ trễ và chất lượng thành một điểm số duy nhất dựa trên khái niệm "hộp giới hạn" — vùng giá trị mà doanh nghiệp chấp nhận được.
Cách tiếp cận không nhằm thay thế các công cụ đánh giá hiện có, mà tạo ra một lớp chấm điểm nằm bên trong chúng, giúp biến các yêu cầu rời rạc thành quyết định kỹ thuật có thể tối ưu hóa.
 Minh họa hộp giới hạn và mức tổn thất của trace
Vì sao các chỉ số đánh giá riêng lẻ là chưa đủ
Các chỉ số thành phần vẫn cần thiết vì chúng cho biết agent thất bại ở đâu. Nhưng nếu một mô hình mới cải thiện chất lượng lại đẩy độ trễ vượt ngưỡng kiên nhẫn của khách hàng, điều đó phải được phản ánh ngay trong điểm số thay vì trở thành một cuộc tranh luận mới mỗi lần.
Thực tế đặt ra nhiều câu hỏi mang tính kinh doanh:
- Ngân sách chi phí cho mỗi trace là bao nhiêu?
- Khách hàng sẽ chờ bao nhiêu giây trước khi bỏ đi hoặc khởi động lại?
- Độ chính xác trích xuất dưới mức nào thì tự động hóa không còn giá trị?
Đây là những câu hỏi gắn chặt với phát triển agent dù đội ngũ có muốn đối mặt hay không. Mức độ nghiêm trọng của từng vi phạm cần được xác định rõ: vượt nhẹ mục tiêu chi phí có thể chấp nhận, nhưng trả về câu trả lời thiếu chính xác cho bàn giao dịch có thể là lỗi nghiêm trọng.
Nghiên cứu của khung CLEAR cho thấy các agent có độ chính xác tương đương có thể chênh lệch chi phí tới 50 lần, và agent tối ưu cho độ chính xác tốn kém gấp 4,4 đến 10,8 lần so với các phương án tiết kiệm mà hiệu năng tương đương. Tỷ lệ thành công của agent cũng giảm từ 60% ở một lần chạy xuống còn 25% khi đo tính nhất quán qua 8 lần chạy.
Xây dựng hộp giới hạn: ngưỡng, hình phạt và trọng số
Ba thành phần cốt lõi tạo nên "chiếc hộp":
- Ngưỡng (τ): ranh giới không được vượt qua, ban đầu đặt ở mức tối thiểu chấp nhận được.
- Hình phạt (k): độ dốc của hình phạt sau khi vượt ngưỡng, cao với các ràng buộc pháp lý hoặc quyền riêng tư.
- Trọng số (λ): mức ưu tiên tương đối giữa các yếu tố, do bộ phận sản phẩm và kinh doanh quyết định.
Điểm quan trọng là mỗi ngưỡng phải gắn với một dữ kiện kinh doanh cụ thể. Ví dụ, trần chi phí 0,10 USD mỗi trace có thể xuất phát từ ngân sách tài chính chia cho khối lượng dự kiến; giới hạn 5 giây đến từ phân tích hành vi người dùng; ngưỡng chất lượng 0,80 đến từ mức độ chính xác mà dưới đó con người phải làm lại công việc.
Với agent, không nên áp dụng các giới hạn tuyệt đối một cách máy móc. Bản chất phi xác định của bài toán khiến một số trace có lý do chính đáng để nằm ngoài hộp — chẳng hạn hội thoại kéo dài hoặc câu hỏi phức tạp cần mô hình mạnh hơn. Cách làm hợp lý là cho agent "chạy tự do" trong vùng an toàn và siết chặt ngay khi bước ra ngoài.
Chuyển mọi chỉ số thành "độ xấu" chuẩn hóa
Chi phí, độ trễ và tỷ lệ lỗi vốn đã cùng hướng: thấp hơn là tốt hơn. Các chỉ số chất lượng thì ngược lại, nên cần chuyển đổi bằng công thức 1 − độ chính xác. Sau khi chuẩn hóa, mọi chỉ số đều mang cùng ý nghĩa: dưới 1 là trong hộp, bằng 1 là đúng ngưỡng, trên 1 là ngoài hộp.
def normalized_badness(series, tau, direction):
    if direction == "lower_is_better":
        return series / tau
    if direction == "higher_is_better":
        return (1 - series) / (1 - tau)
    raise ValueError(f"Unknown direction: {direction}")
Hàm hình phạt sử dụng softplus để tạo đường cong mượt, gần bằng 0 khi còn trong hộp và gần tuyến tính khi vượt ngưỡng, đồng thời vẫn khả vi để thuận lợi cho các công cụ tối ưu hóa.
def softplus(z):
    return np.logaddexp(0, z)

def threshold_loss(x, k=2):
    return softplus(k * (x - 1)) ** 2
 So sánh mức độ xấu chuẩn hóa và tổn thất có trọng số giữa hai cấu hình
Tổng hợp thành mục tiêu cấp cấu hình
Một điểm số cho từng trace là hữu ích, nhưng cấu hình được chọn dựa trên nhiều trace. Phương pháp RMSLoss biến tập hợp tổn thất thành một mục tiêu vừa ưu tiên tổn thất trung bình thấp vừa ưu tiên phương sai thấp. Điều này quan trọng vì vấn đề trong production thường xuất hiện ở phần đuôi phân phối, không chỉ ở giá trị trung bình.
Điểm số của trace thường lệch phải, gần với phân phối loga chuẩn. RMSLoss lấy log(1 + điểm), chuyển về gần phân phối chuẩn, rồi áp dụng đẳng thức RMS² = trung bình² + phương sai. Hai cấu hình có điểm trung vị giống nhau sẽ được phân định bởi mức độ phân tán — cấu hình có nhiều ngoại lệ nghiêm trọng hơn sẽ thua.
Đọc kết quả: ví dụ với hai cấu hình mẫu
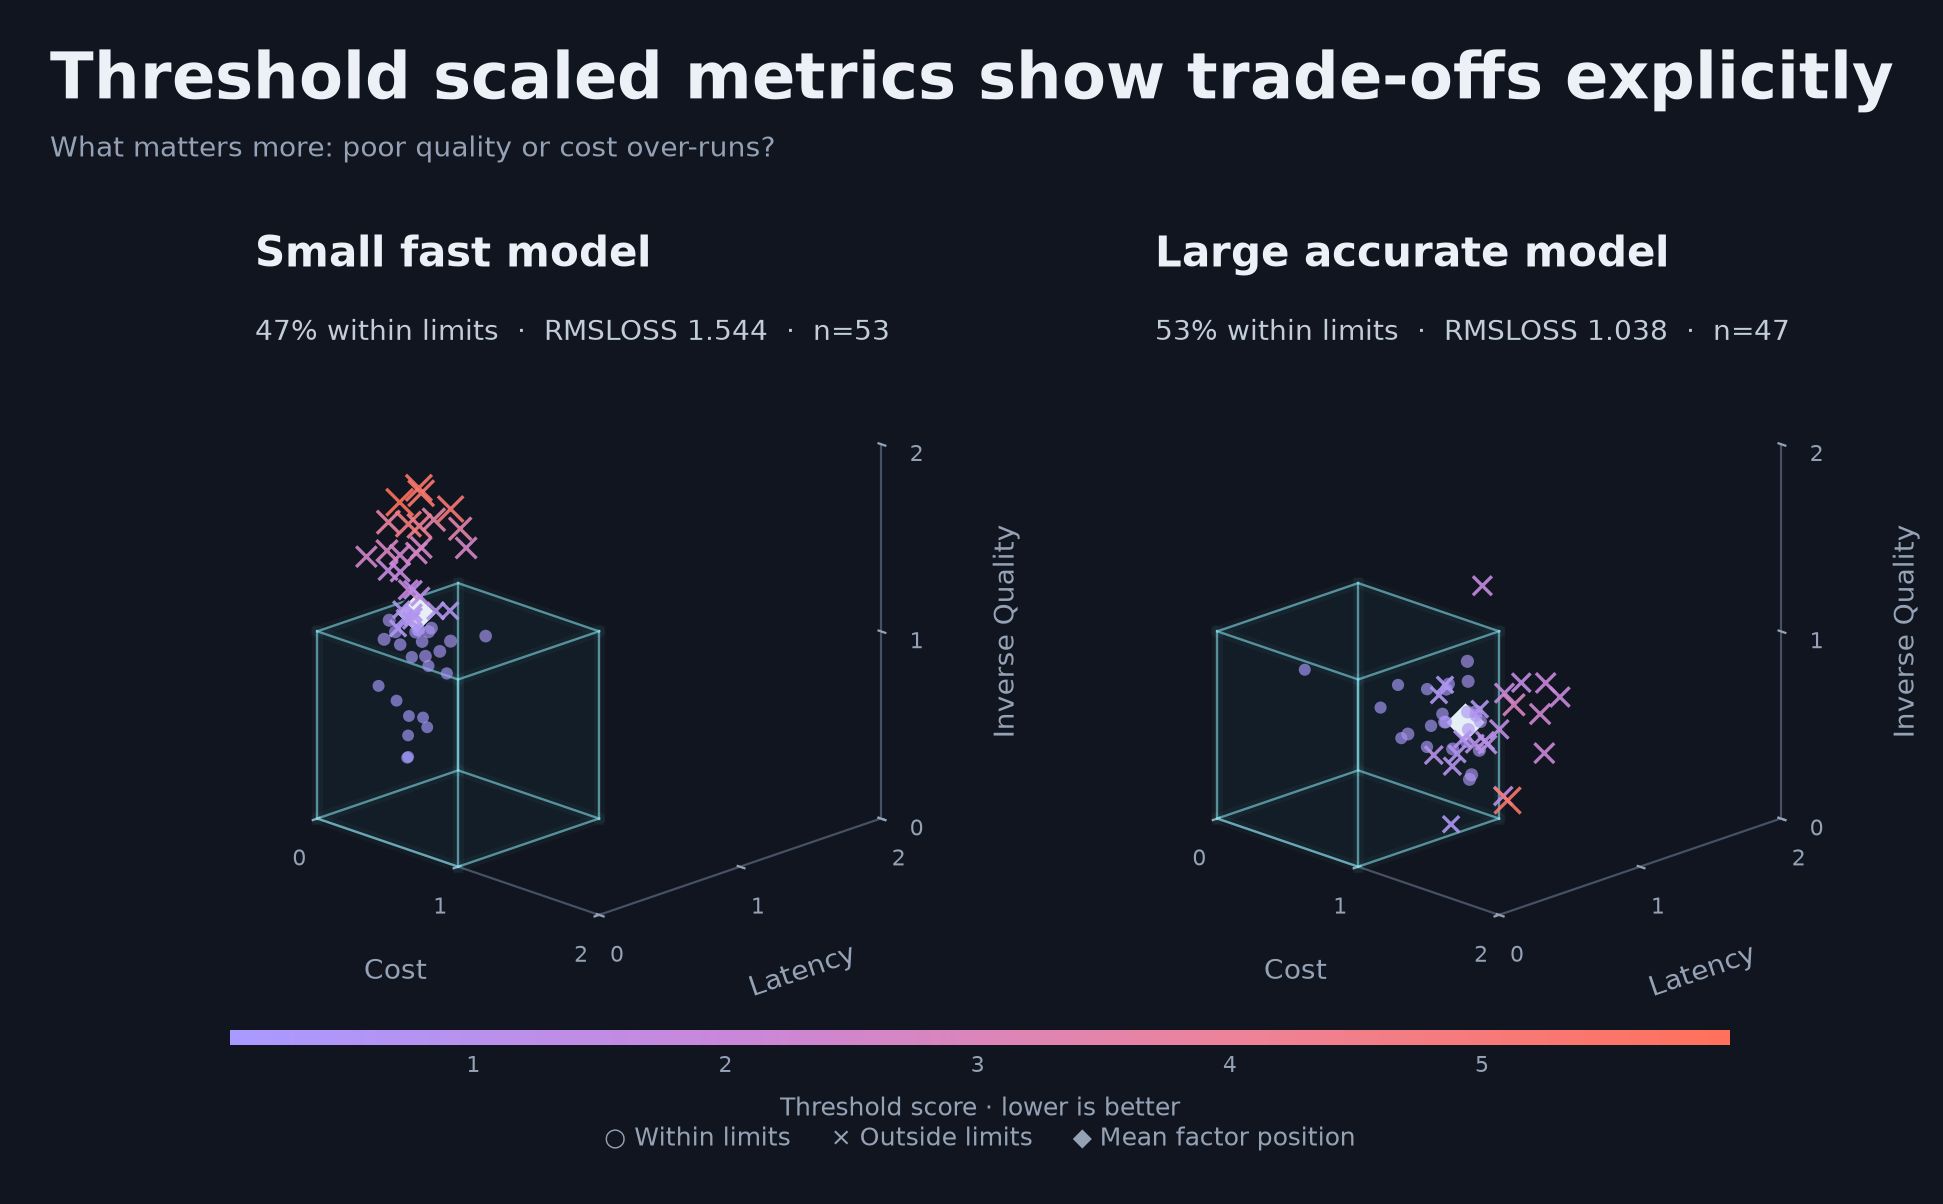
Xét hai cấu hình: một mô hình lớn chính xác và một mô hình nhỏ nhanh. Kết quả cho thấy:
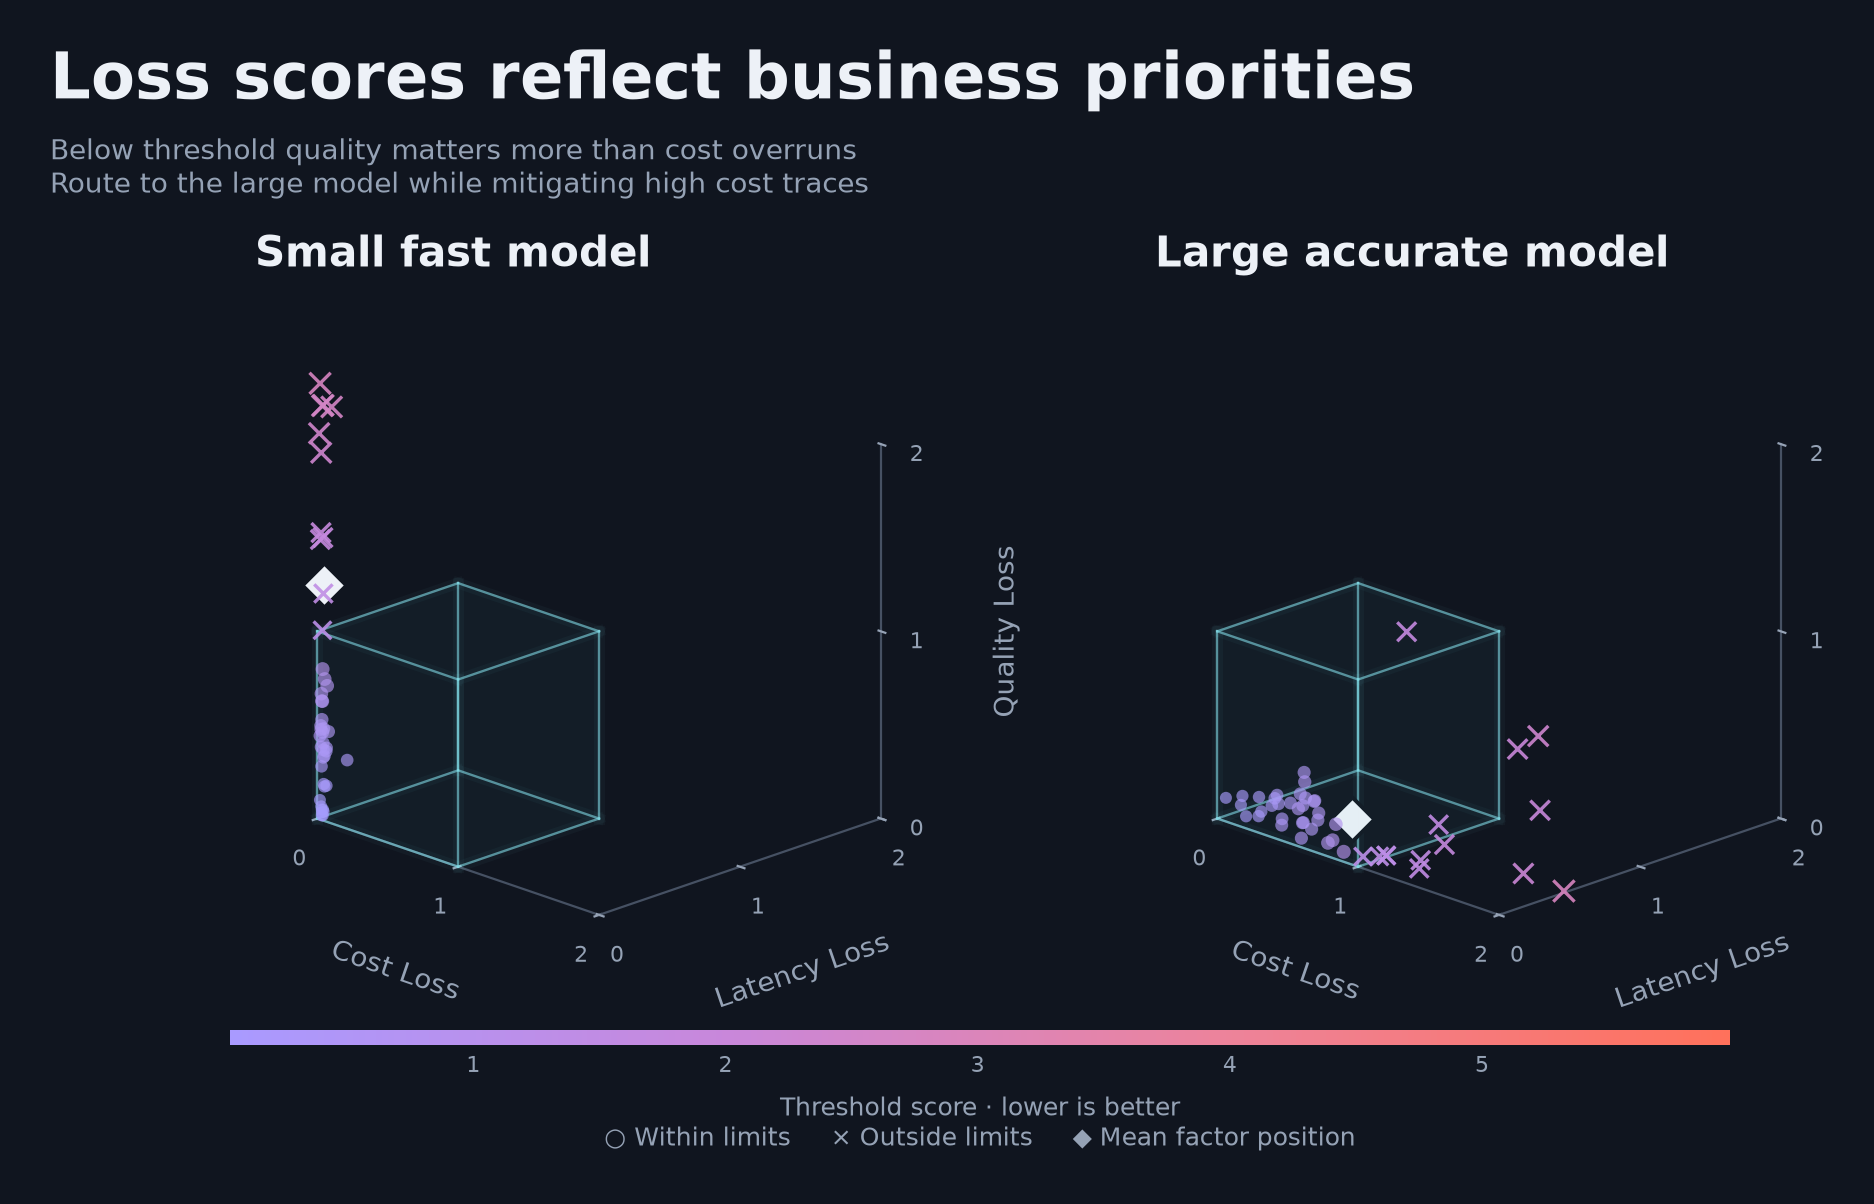
- Mô hình nhỏ nhanh: rẻ, phản hồi nhanh nhưng nhiều trace vượt ngưỡng chất lượng, khiến RMSLoss lên tới 1,54.
- Mô hình lớn chính xác: chịu áp lực chi phí và độ trễ nhưng ít lỗi chất lượng nghiêm trọng, RMSLoss đạt 1,04.
Điều đáng chú ý là điểm trung vị của hai cấu hình gần như bằng nhau (0,62 so với 0,63). Khác biệt nằm ở phần đuôi phân phối. Khi chất lượng được đặt trọng số gấp đôi chi phí và độ trễ, những lần trượt ở đuôi quyết định kết quả so sánh. Nếu siết trần chi phí hoặc tăng trọng số chi phí, câu trả lời có thể đảo ngược — và đó là cuộc thảo luận dành cho những người đặt ra chiếc hộp, không phải phán đoán tùy ý của người đang xem bảng điều khiển.
 Tổn thất có trọng số của từng trace theo cấu hình
Vị trí của điểm số trong hệ sinh thái đánh giá agent
Điểm số có ngưỡng đóng vai trò quy tắc quyết định, không thay thế các chỉ số thành phần hay phân tích Pareto. Nó có thể được ghi log như một evaluator tùy chỉnh, tối ưu hóa trong các framework như DSPy hay Afnio, hoặc so sánh giữa các trace trên LangSmith, Phoenix, Braintrust, DeepEval, Weave hay MLflow.
Các nghiên cứu định tuyến mô hình cho thấy đây không phải sở thích triết học: RouteLLM báo cáo giảm chi phí hơn 2 lần mà không mất chất lượng; BEST-Route giảm tới 60% chi phí với mức giảm hiệu năng dưới 1%; AgentRouter giảm 72% chi phí trong khi giữ 97,3% chất lượng của phương án chỉ dùng mô hình mạnh nhất. Với doanh nghiệp cỡ vừa, đây có thể là khoản tiết kiệm hàng trăm nghìn USD.
Cách áp dụng cùng đội ngũ
Quy trình triển khai gợi ý gồm các bước:
- Bắt đầu với ba chỉ số.
- Đặt ngưỡng trong một cuộc họp có sự tham gia của sản phẩm, tài chính, kỹ thuật và quản trị rủi ro.
- Chấm điểm các trace gần đây.
- Kiểm tra các trường hợp thất bại.
- Tạo cấu hình mới và tối ưu hóa prompt, luồng xử lý, bộ nhớ hoặc mô hình.
- Chỉ điều chỉnh ngưỡng khi ý nghĩa kinh doanh thay đổi.
- Dùng điểm tổng hợp để lựa chọn và các chỉ số thành phần để chẩn đoán.
Nên quản lý phiên bản cho toàn bộ hồ sơ chấm điểm (mỗi giá trị τ, k, λ) trong metadata đi kèm cấu hình agent, để mọi thay đổi điểm số đều truy vết được về thay đổi của agent hoặc thay đổi chính sách.
"Nằm trong hộp" không phải là rút gọn phát triển agent thành một con số ma thuật, mà là trao cho các đội ngũ một ngôn ngữ vận hành chung.
Kết luận
Định nghĩa rõ thế nào là "đủ tốt", hình phạt các trace vượt ranh giới, tối ưu hóa rồi triển khai — đó là chu trình mà phương pháp này hướng tới. Với các đội ngũ phát triển agent tại Việt Nam, nơi bài toán tối ưu chi phí API mô hình lớn đang ngày càng cấp thiết, việc thiết lập một "hộp giới hạn" rõ ràng ngay từ đầu có thể giúp tránh cả tình trạng đốt ngân sách lẫn tình trạng tranh luận không hồi kết về việc cấu hình nào tốt hơn.

