Python 3.15 có profiler mới: Tachyon và những gì cProfile bỏ lỡ
Python 3.15 giới thiệu module profiling.sampling (tên mã Tachyon), cho phép gắn vào tiến trình đang chạy mà không cần khởi động lại hay sửa mã nguồn. Công cụ này profile được mọi luồng, tách thời gian CPU khỏi thời gian chờ, chỉ ra đoạn mã đang giữ GIL và xuất flame graph hoặc heatmap trực quan.
Lập trình viên Python từ lâu đã có sẵn công cụ phân tích hiệu năng cProfile. Nó ghi lại mọi lời gọi hàm và cho biết chính xác mỗi hàm được gọi bao nhiêu lần. Cách này rất hiệu quả với các script và job chạy hàng loạt mà bạn kiểm soát được việc thực thi.
Nhưng cProfile lại kém tiện dụng trong những tình huống bạn không kiểm soát được — chẳng hạn khi một web service đang chạy và bỗng nhiên chậm bất thường. Bạn không thể gắn cProfile vào tiến trình đang sống đó. Khởi động lại service dưới profiler có thể khiến lỗi biến mất, và bản thân chi phí tracing cũng làm thay đổi hành vi mà bạn đang muốn đo.
 Minh họa Python 3.15 với profiler mới
Python 3.15 mang đến một lựa chọn khác. Module profiling.sampling mới, có tên mã Tachyon, có thể tự khởi chạy chương trình hoặc gắn vào một tiến trình đang chạy. Nó đọc tiến trình từ bên ngoài, nên ứng dụng không cần import thư viện profiling hay khởi động lại.
Tachyon còn có thể kiểm tra mọi luồng, phân biệt công việc CPU với thời gian chờ, chỉ ra đoạn mã nào đang giữ GIL và đánh dấu việc thực thi bên trong các extension native. Nếu một tiến trình có vẻ bị treo, nó có thể in ra stack hiện tại của từng luồng mà không cần chạy một profile đầy đủ.
Python giờ có hai profiler tích hợp
Python 3.15 đặt các công cụ profiling vào một package mới, gồm profiling.sampling và profiling.tracing. Trong đó, profiling.tracing chính là profiler tất định trước đây vẫn được biết đến với tên cProfile. Nó ghi lại mọi lời gọi hàm, lệnh return và exception, cho ra số lần gọi chính xác đến từng micro giây.
Ngược lại, profiling.sampling lấy mẫu call stack của chương trình theo những khoảng thời gian đều đặn. Một hàm xuất hiện trong nhiều mẫu thường là nguyên nhân chiếm phần lớn thời gian thực thi.
Hai cách tiếp cận này trả lời những câu hỏi khác nhau:
- profiling.sampling: không cho số lần gọi chính xác, nhưng gắn được vào tiến trình đang chạy, profile mọi luồng, chỉ đo CPU, đo GIL, hiển thị khung native và garbage collection, xuất flame graph/heatmap, chi phí runtime rất thấp.
- profiling.tracing (cProfile): số lần gọi chính xác tuyệt đối, nhưng không gắn được vào tiến trình đang chạy, không tự động profile mọi luồng, không có chế độ CPU-only hay GIL, không có flame graph, và chi phí runtime cao hơn.
Do lấy mẫu chứ không ghi lại mọi sự kiện, thời gian mà sampling báo cáo chỉ là ước lượng. Nếu một hàm chiếm 10% số mẫu, nhiều khả năng nó chiếm khoảng 10% thời gian được lấy mẫu. Kết quả có thể dao động đôi chút giữa các lần chạy.
Tài liệu chính thức của Python khuyến nghị dùng lấy mẫu thống kê cho hầu hết trường hợp điều tra hiệu năng, và dùng tracing tất định khi cần số lần gọi chính xác. Module cProfile cũ vẫn tồn tại như một alias của profiling.tracing. Riêng module profile thuần Python đã bị đánh dấu deprecated và dự kiến bị loại bỏ ở Python 3.17.
Tachyon hoạt động thế nào trên thực tế?
Để thử nghiệm, có thể dựng một HTTP server nhỏ chỉ dùng thư viện chuẩn, với hai endpoint tạo ra hai kiểu vấn đề hiệu năng khác nhau:
/report: trộn lẫn thời gian chờ với đoạn mã Python tính toán nặng./native: thực hiện một phép tính dài bên trong mã biên dịch.
Với server đang chạy và một chương trình tạo tải song song, bạn chỉ cần gắn Tachyon vào tiến trình bằng PID:
python -m profiling.sampling attach -a -d 20 --flamegraph -o report-wall.html 53432
Cờ -a bao gồm mọi luồng, -d 20 ghi mẫu trong 20 giây, -o đặt tên file đầu ra. Server không do profiler khởi chạy — Tachyon kết nối vào tiến trình đang tồn tại, thu thập mẫu rồi ngắt kết nối, còn server vẫn tiếp tục chạy bình thường.
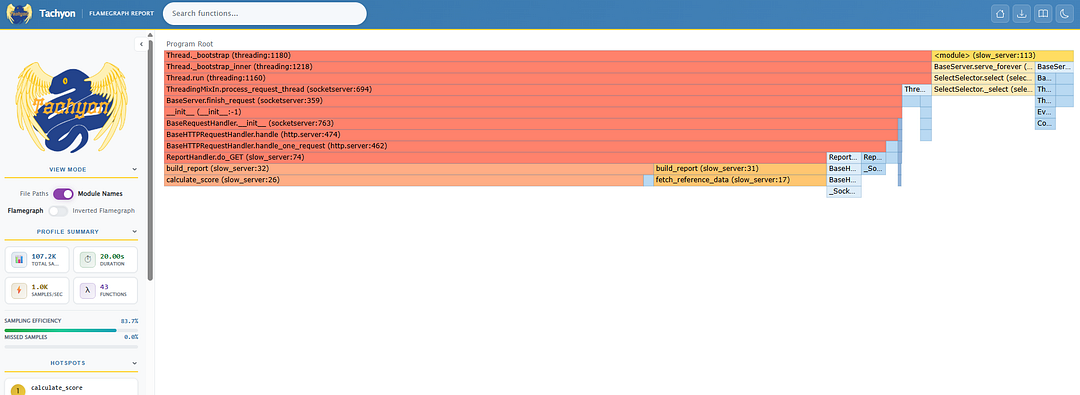
Kết quả là một flame graph tự chứa trong một file HTML, mở được offline bằng trình duyệt.
 Ví dụ flame graph do Tachyon tạo ra
Đọc flame graph: độ rộng quan trọng hơn vị trí
Trong flame graph, call stack chạy từ trên xuống dưới. Một ô nằm dưới ô khác đại diện cho hàm được gọi bởi hàm phía trên. Điều quan trọng nhất là độ rộng: ô càng rộng, hàm đó xuất hiện càng nhiều trong các mẫu và do đó càng chiếm nhiều thời gian thực thi.
Với ví dụ trên, calculate_score lập tức nổi bật vì là ô lá rộng nhất — phần lớn thời gian xử lý request nằm trong vòng lặp Python lồng nhau này. Ngoài ra còn một khối khá lớn cho fetch_reference_data, hàm chứa time.sleep(0.04). Profiler vẫn ghi nhận 40 mili giây đó dù tiến trình đang chờ chứ không dùng CPU, bởi profile mặc định dựa trên thời gian đồng hồ thực (wall-clock).
Tách thời gian chờ khỏi thời gian tính toán
Đây là điểm mạnh đáng chú ý nhất của Tachyon. Chế độ wall-clock ghi lại bất cứ thứ gì luồng đang làm tại thời điểm lấy mẫu: chạy Python, sleep, chờ I/O, chờ lock. Điều này hữu ích vì người dùng cảm nhận thời gian trôi qua — một truy vấn database chậm vẫn khiến request chậm, dù tiến trình Python gần như không dùng CPU.
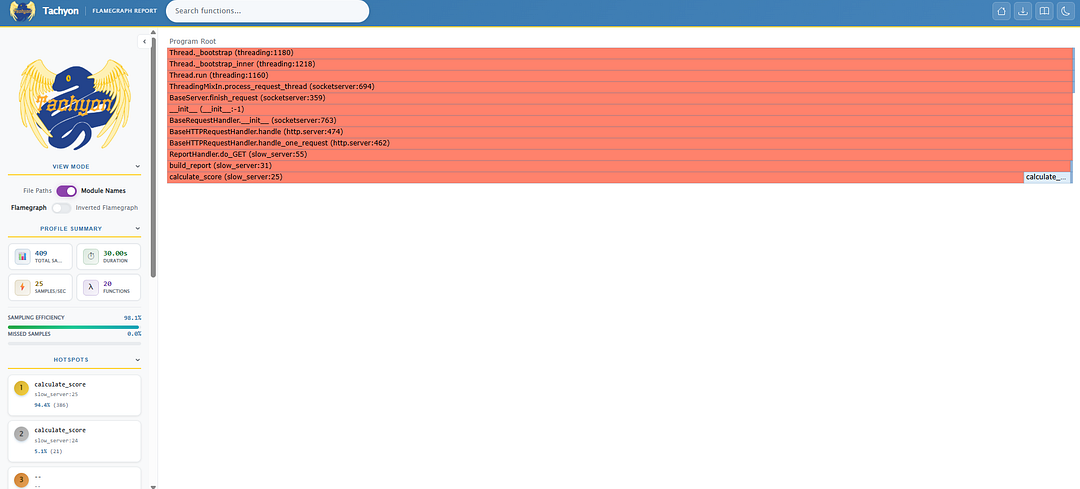
Khi chuyển sang chế độ CPU-only:
python -m profiling.sampling attach -a -r 100 --mode cpu -d 20 --flamegraph -o report-cpu.html 53432
Các mẫu được lấy khi luồng đang sleep, bị block hay chờ I/O sẽ bị loại bỏ. Kết quả: calculate_score() chiếm tới 94% HotSpot score, còn fetch_reference_data() biến mất hoàn toàn vì độ trễ của nó đến từ time.sleep(), không phải từ công việc CPU.
Quy tắc thực dụng rút ra:
- Hàm rộng trong đồ thị wall-clock nhưng nhỏ trong đồ thị CPU → nhiều khả năng đang chờ. Viết lại mã Python không loại bỏ được độ trễ database, độ trễ mạng hay thời gian chờ lock.
- Hàm nổi bật ở cả hai profile → đang thực sự ngốn CPU. Đây là chỗ nên cân nhắc đổi thuật toán, dùng thư viện native hoặc song song hóa theo tiến trình.
Tìm đoạn mã đang giữ GIL
Server xử lý request trên nhiều luồng, nhưng calculate_score() vẫn là mã Python. Trên bản CPython thông thường, chỉ một luồng được chạy bytecode Python tại một thời điểm. Chế độ GIL chỉ giữ lại các mẫu khi luồng đang nắm giữ Global Interpreter Lock:
python -m profiling.sampling attach -a --mode gil -d 20 --flamegraph -o report-gil.html 53432
calculate_score() sẽ chiếm ưu thế trong đồ thị này vì các vòng lặp lồng nhau chạy bytecode Python và giữ GIL. Nhiều luồng worker có thể đã sẵn sàng xử lý request, nhưng chúng không thể cùng lúc chạy các vòng lặp đó. Hệ quả là thêm luồng không giúp phần này mở rộng theo số luồng.
Các hướng khắc phục gồm: giảm khối lượng tính toán, đổi thuật toán, chuyển phép tính sang process pool, hoặc dùng thư viện native có khả năng nhả GIL.
Chỉ ra thời gian nằm ngoài Python
Endpoint /native gọi hashlib.pbkdf2_hmac() với số vòng lặp cố ý đặt rất cao, đẩy phần lớn công việc vào mã native đã biên dịch. Khi bật cờ --native cùng chế độ CPU, Tachyon quy thời gian nằm trong hashlib.pbkdf2_hmac() về cho hàm Python gọi nó, kèm theo các khung tổng hợp đánh dấu điểm chuyển ra khỏi Python. Vị trí khung này thay đổi tùy nền tảng và bản build Python.
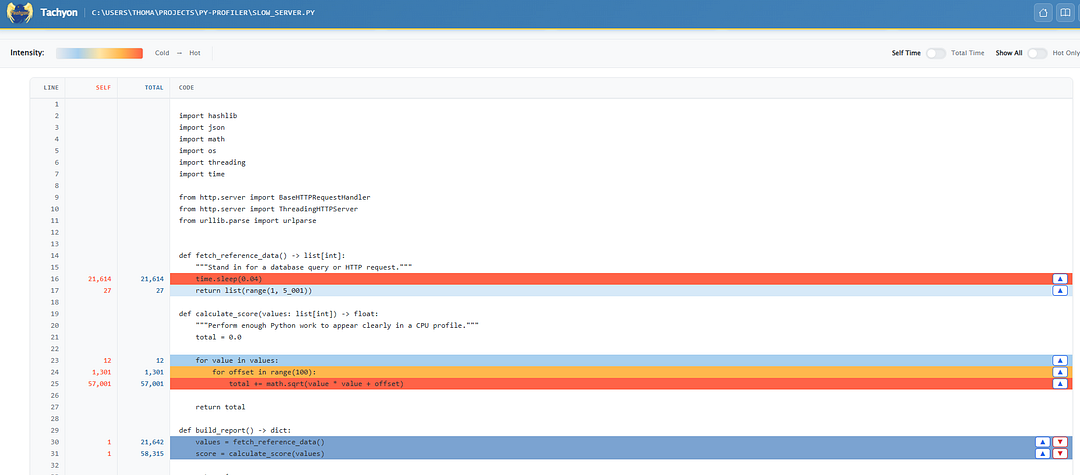 Heatmap nhiệt độ theo mã nguồn
Heatmap theo mã nguồn
Flame graph giữ nguyên cấu trúc gọi hàm. Nhưng đôi khi bạn đã biết hàm nào đắt đỏ và chỉ muốn tìm dòng nào chịu trách nhiệm. Dùng cờ --heatmap:
python -m profiling.sampling attach -a -d 20 --heatmap -o report-heatmap 53432
Đầu ra lần này là một thư mục chứ không phải file HTML đơn lẻ. Mở report-heatmap/index.html rồi chọn file nguồn cần xem. Trang hiển thị được cả self time (chỉ tính mẫu quy trực tiếp cho dòng đó) lẫn total time (bao gồm cả công việc của các hàm được gọi từ dòng đó). Nhờ vậy, khi xem build_report() ở chế độ total time, bạn thấy được tổng chi phí của cả fetch_reference_data() và calculate_score().
Màu chạy từ lạnh đến nóng — dòng càng nóng càng xuất hiện nhiều trong mẫu ở chế độ xem đang chọn.
Một lưu ý nhỏ: nếu thư mục report-heatmap đã tồn tại, Tachyon không ghi đè mà tạo thư mục con như report-heatmap/heatmap_18472. Cách đơn giản nhất là cấp cho mỗi lần chạy một thư mục đầu ra mới.
Khi nào cProfile vẫn là lựa chọn đúng?
Tachyon không khiến cProfile trở nên lỗi thời. Sampling có thể bỏ sót những hàm rất ngắn bắt đầu và kết thúc giữa hai lần lấy mẫu. Giả sử một bộ parser gọi một hàm chuyển đổi nhỏ hai triệu lần — từng lời gọi không đủ dài, nên hàm có thể không nổi bật trong profile thống kê.
Profiler tất định ghi lại mọi lời gọi. Nếu bạn cần xác minh rằng một lần refactor đã giảm số lần gọi từ hai triệu xuống hai mươi nghìn, tracing là lựa chọn phù hợp hơn:
python -m profiling.tracing batch_job.py
Lệnh quen thuộc python -m cProfile batch_job.py vẫn dùng được như cũ. Tracing cũng hợp với các script ngắn kết thúc trước khi profiler lấy mẫu đủ nhiều.
Đừng nhầm profiling với benchmarking. Profiler cho biết chương trình tốn thời gian ở đâu; nó không phải công cụ để quyết định xem một cách cài đặt có nhanh hơn cách khác hay không.
Kết quả sampling luôn có nhiễu, nên chênh lệch nhỏ chưa chắc có ý nghĩa. Ngược lại, tracing ghi mọi thứ nhưng phần instrument thêm vào có thể làm mã Python chậm đi nhiều hơn mã native. Nếu muốn biết một cách cài đặt nhanh hơn cách kia đúng 2% hay không, hãy dùng timeit hoặc pyperf thay vì profiler.
Kết luận
cProfile vẫn hữu ích khi cần số lần gọi chính xác hoặc muốn soi một chương trình ngắn từ đầu đến cuối, nhưng nó chưa bao giờ được thiết kế để trả lời mọi câu hỏi về hiệu năng. Nó gần như bất lực với một service đã chạy được một thời gian rồi đột nhiên chậm đi, có thể bỏ sót công việc ở các luồng khác, và việc tracing mọi lời gọi hàm làm thay đổi hiệu năng ngay trong lúc bạn đang đo.
Sampling profiler của Python 3.15 lấp đúng khoảng trống đó. Chỉ với thư viện chuẩn, lập trình viên giờ có thể soi một tiến trình đang sống ngay lúc sự cố diễn ra — xem các luồng đang làm gì và tách bạch tính toán với chờ đợi — mà không cần viết lại hay khởi động lại bất cứ thứ gì.
Với các đội phát triển backend tại Việt Nam đang vận hành dịch vụ Python trong môi trường production, đây là một bổ sung đáng chú ý: khả năng gắn profiler vào container đang chạy tại chỗ, không cần redeploy và không phá vỡ trạng thái lỗi, vốn là bài toán khó giải quyết trước đây.