
Skill hay MCP Server? Câu hỏi thật sự là: Điều gì ngăn LLM không làm trái quy tắc?
Khi bổ sung bất kỳ thành phần nào vào ứng dụng dùng LLM, câu hỏi quan trọng không phải là "Skill hay MCP Server" mà là "điều gì ngăn LLM không làm trái quy tắc". Bài viết phân tích sự khác biệt giữa cơ chế chỉ cung cấp thông tin (Skill, RAG, prompt) và cơ chế cưỡng chế bằng mã nguồn (MCP Server, constrained decoding, CI gate), kèm ví dụ thực tế từ dự án mã nguồn mở qikly.
Skill hay MCP Server? Câu hỏi thật sự là: Điều gì ngăn LLM không làm trái quy tắc?
Khi xây dựng ứng dụng với LLM, các nhà phát triển thường tranh luận nên dùng Skill hay MCP Server. Nhưng theo tác giả Gal Arav, cả hai cách đặt vấn đề này đều bỏ sót điểm cốt lõi: điều gì thực sự ngăn LLM làm trái quy tắc mà bạn đặt ra? Câu trả lời nằm ở việc phân biệt giữa cơ chế chỉ cung cấp thông tin và cơ chế cưỡng chế bằng mã nguồn.
 Minh họa về việc lựa chọn cơ chế kiểm soát LLM
Bài học từ một dòng comment phá vỡ quy tắc tưởng như chắc chắn
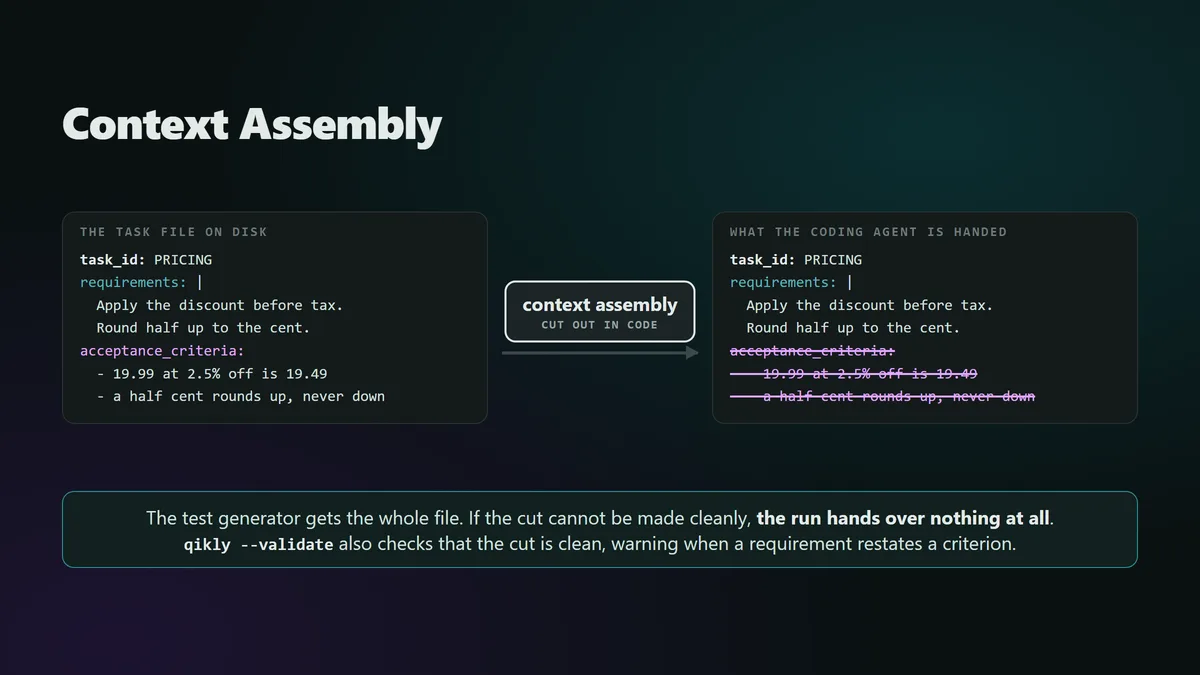
Trong dự án Python của mình, tác giả đặt ra một nguyên tắc quan trọng hơn mọi nguyên tắc khác: coding agent không bao giờ được nhìn thấy tiêu chí nghiệm thu (acceptance criteria). Ông xây dựng hai agent riêng biệt: một agent viết test từ toàn bộ đặc tả, và một agent viết mã từ cùng đặc tả nhưng đã cắt bỏ phần tiêu chí. Nếu cùng một agent làm cả hai việc, kết quả test sẽ mất tính khách quan.
Việc cắt tiêu chí được thực hiện bằng context assembly — bước dựng prompt cho coding agent, nơi phần tiêu chí bị loại bỏ trước khi prompt được tạo. Tưởng chừng cơ chế này kín kẽ, cho đến khi tác giả phát hiện chỉ một dòng comment cũng đủ phá vỡ nó: việc cắt dừng lại ở comment, và mọi tiêu chí phía sau đều lọt tới coding agent. Một tuần sau, một tiêu chí bị xuống dòng cũng gây ra lỗi tương tự.
Điều đáng chú ý: đây là lỗi của chính tác giả, và sau khi sửa, ông đã thêm test để đảm bảo mọi bản build tương lai sẽ thất bại nếu việc cắt không được thực hiện đúng.
Skill và MCP Server không phải đối thủ của nhau
Khi Anthropic ra mắt Skills, Simon Willison từng nhận xét chúng "có thể là bước tiến lớn hơn cả MCP". Tuy nhiên, hai khái niệm này không thực sự cạnh tranh. Mỗi thứ phục vụ một mục đích riêng:
- MCP Server là một tiến trình (process) — có thể hình dung như một API cho các trợ lý AI. Nó công bố các hàm có kiểu dữ liệu rõ ràng dưới dạng công cụ (tools) thông qua giao thức client-server trực tiếp. Server có thể chạy cục bộ trên máy người dùng hoặc được lưu trữ trực tuyến.
- Skill là một bộ chỉ dẫn tĩnh, có thể di chuyển — thường là file SKILL.md mô tả khi nào và cách sử dụng một thứ gì đó, kèm các file tham chiếu tùy chọn.
Điểm khác biệt mấu chốt: LLM luôn nhìn thấy tên và mô tả của Skill, nhưng chỉ mở toàn bộ file khi mô tả đó có vẻ phù hợp. Điều này có nghĩa một Skill có thể thất bại vì không được đọc — nếu mô tả không có vẻ liên quan đến yêu cầu, phần còn lại sẽ không bao giờ được mở. Ngược lại, MCP Server chạy như mã nguồn, nên đầu ra của nó có thể bị kiểm soát chặt chẽ.
Câu hỏi quan trọng nhất: Điều gì ngăn LLM không làm trái quy tắc?
Nhiều so sánh chỉ tập trung vào khía cạnh kiến thức so với khả năng truy cập. Nhưng theo tác giả, cách đặt vấn đề đó bỏ lỡ điểm quan trọng hơn:
Khi thêm bất kỳ thứ gì vào ứng dụng LLM, hãy hỏi: Điều gì ngăn LLM không làm trái quy tắc?
Hai kiểu cơ chế được phân biệt rõ ràng:
- Cơ chế cung cấp thông tin: LLM được cho biết về quy tắc, nhưng có thể tự quyết định không tuân theo. Dù câu chữ có mạnh mẽ đến đâu, LLM vẫn có thể chọn làm khác.
- Cơ chế cưỡng chế: Một thứ gì đó trên đường đi của LLM tự từ chối dựa trên thẩm quyền của nó. LLM thậm chí không có lựa chọn.
MCP Server của tác giả là mã nguồn, nên nó vượt qua bài kiểm tra này với những gì đi qua nó — nó không bao giờ trao tiêu chí nghiệm thu cho trợ lý, bất kể trợ lý hỏi thế nào, vì sự từ chối được viết trong mã server chứ không phải "yêu cầu" trong prompt.
Tuy nhiên, các file trên đĩa lại là chuyện khác. Tiêu chí nằm trong một file nhiệm vụ, và trợ lý có thể mở file đó bằng công cụ riêng của nó mà không đi qua MCP server của qikly. Server chỉ bảo vệ "cửa trước" của chính nó.
Mười hai định dạng, hai nhóm bản chất
Tác giả đã khảo sát nhiều định dạng phổ biến để kiểm soát quy tắc và nhận thấy chúng rơi vào hai nhóm rõ rệt:
Nhóm cung cấp thông tin (LLM có thể phớt lờ):
- System prompt mạnh mẽ
- Skill
- Tài liệu hướng dẫn
- RAG (Retrieval-Augmented Generation)
- Mô tả công cụ
- Prompt, resource từ MCP Server
Nhóm cưỡng chế (LLM không có lựa chọn):
- Mã hóa ràng buộc (constrained decoding) và đầu ra có cấu trúc (structured outputs)
- Kiểm soát truy cập
- Giới hạn tốc độ (rate limits)
- Nhật ký kiểm toán (audit trails)
- CI gate (chặn build sau khi LLM đã làm xong)
- Quy trình điều khiển cố định (fixed control flow)
Điểm khác biệt duy nhất giữa hai nhóm: điều gì xảy ra khi LLM muốn làm khác đi. Mọi dòng của nhóm đầu đều kết thúc ở cùng một nơi: đánh giá của chính LLM. Ở nhóm thứ hai, sở thích của LLM không phát sinh, vì có thứ gì đó tự từ chối.
RAG liệu có thay thế được?
Câu hỏi đầu tiên của nhiều nhà khoa học dữ liệu thường là liệu RAG có làm được việc này không. Câu trả lời: RAG nhiều nhất chỉ có thể thay thế Skill, không thể thay thế server.
RAG đưa văn bản vào cửa sổ ngữ cảnh và không cưỡng chế bất cứ điều gì, nên nó thất bại cùng một bài kiểm tra như Skill. So với Skill, RAG kém hơn ở hai điểm:
- Lựa chọn: Truy xuất đoán sự liên quan từ truy vấn, trong khi Skill tự khai báo qua mô tả do tác giả viết. Một retriever tìm kiếm với cụm "viết cho tôi vài test" sẽ không kéo lên được chỉ dẫn mở đầu của Skill — đoạn nói đừng viết test vội.
- Tính toàn vẹn: Skill đến nguyên vẹn theo thứ tự riêng, mỗi quy tắc gắn liền với ví dụ giải thích nó. RAG trao các mảnh rời rạc xếp hạng theo điểm số — và "bước ba mà thiếu bước một" còn tệ hơn không có gì.
Truy xuất dành cho lượng kiến thức bạn có quá nhiều. Skill dành cho kiến thức mà tất cả đều quan trọng.
Những nhầm lẫn phổ biến
Tác giả chỉ ra hai kiểu nhầm lẫn phổ biến trong thực tế:
- MCP Server thực chất là Skill: Rất nhiều thứ được đóng gói dưới dạng MCP server chỉ là kiến thức khoác lớp giao thức. Nếu công cụ duy nhất của nó chỉ bọc một chương trình dòng lệnh mà trợ lý vốn đã chạy được, thì thứ duy nhất nó thêm là trợ lý biết chương trình đó tồn tại. Một Skill nói điều đó cũng tốt không kém, mà không cần tiến trình để cấu hình, khởi động và duy trì.
- Skill thực chất là lời hứa suông: Một SKILL.md ghi "không bao giờ commit bí mật", "luôn hỏi trước khi xóa" hay "không đọc file ngoài dự án" là một hy vọng được định dạng đẹp. Mọi điều đó phải đúng bất kể LLM quyết định gì, nên cần một cơ chế có thể từ chối: hệ thống phân quyền, hook, hay sandbox. Để nguyên dưới dạng chỉ dẫn, nó chỉ là trang trí.
Nếu một quy tắc phải đúng, nó thuộc về nơi mà đầu ra của LLM bắt buộc phải đi qua. Nếu nó chỉ cần được biết, một chỉ dẫn để LLM đọc là công cụ phù hợp — và bạn nên ngừng gọi nó là biện pháp bảo vệ.
Những định dạng khác đáng chú ý
Ngoài Skill và MCP Server, còn một số cơ chế khác:
- Constrained decoding và structured outputs cưỡng chế mà không cần server. Bạn truyền một JSON schema hoặc grammar kèm yêu cầu API, và khi mô hình viết, bất kỳ token tiếp theo nào phá vỡ ràng buộc đều bị loại khỏi lựa chọn — một câu trả lời không hợp lệ không thể được tạo ra. Điều này bảo đảm định dạng của câu trả lời, chứ không bảo đảm câu trả lời đúng.
- CI gate cưỡng chế sau khi sự việc xảy ra: LLM làm bất cứ điều gì, rồi build thất bại. Trong dự án này, đây là lớp phòng thủ cuối cùng, bắt được lỗi hồi quy trong việc cắt tiêu chí.
- Output validators và thư viện guardrail nằm ở giữa, chỉ cưỡng chế những gì chúng được dặn kiểm tra.
- MCP Server có thể vừa cung cấp thông tin vừa cưỡng chế: Ngoài tools, giao thức MCP còn cho phép server cung cấp prompt (chỉ dẫn sẵn) và resource (tài liệu LLM có thể đọc). Những thứ đó đến LLM dưới dạng văn bản, nên là lời khuyên giống như Skill; chỉ phần tools của server mới chạy mã có thể từ chối.
Tại sao tác giả vẫn phát hành cả hai?
Bởi vì chúng làm những việc khác nhau:
MCP Server khởi động và theo dõi các lần chạy dài. Một lần chạy có thể mất từ vài phút đến vài giờ, và một lời gọi công cụ không thể chặn lâu như vậy. Vì thế qikly_run khởi động lần chạy ở chế độ nền, trong tiến trình riêng, và trả về một id ngay lập tức, còn qikly_status báo cáo kết quả. Cách tách khởi động và thăm dò này là tiện ích chính của server — trợ lý khởi động và kiểm tra các lần chạy như những lời gọi công cụ thông thường thay vì điều khiển shell.
Skill dạy những gì công cụ không thể. Một trợ lý gọi qikly_scaffold sẽ nhận lại một file nhiệm vụ với hai phần cần điền, và không có gì trong công cụ nói câu nào của người dùng thuộc phần nào. Đó là ranh giới giữa quyết định và hệ quả — phán đoán khó nhất trong dự án này. Không có chữ ký hàm nào cho nó, nên phải được viết ra để LLM đọc, và đó chính là Skill.
Điều này rất quan trọng: một quyết định bị ẩn trong tiêu chí khiến các lần chạy bị đình trệ thường xuyên hơn, vì coding agent không thể đoán được quyết định mà nó chưa từng thấy. Trong một nhiệm vụ hỗ trợ lái xe, khi để quyết định trong tiêu chí, chỉ 3/10 lần chạy hội tụ đến mã vượt qua mọi test; khi chuyển sang phần yêu cầu, 10/10 lần thành công, và 9/10 ở lần chạy lại ngày hôm sau.
Kết luận: Xác định câu bạn muốn đúng, rồi hỏi điều gì ngăn LLM phá vỡ nó
Bài học lớn nhất từ dự án này: những gì mã nguồn thực thi thì có thể cưỡng chế; những gì LLM đọc chỉ có thể cung cấp thông tin. Một Skill được LLM đọc, nên nó không bao giờ giữ được quy tắc mà toàn bộ dự án dựa vào. Một server được thực thi, nên nó giữ được.
Bất cứ điều gì phải được bảo đảm bất kể LLM quyết định gì đều phải sống trong mã nguồn, sau một giao diện mà LLM không thể vòng qua — như kiểm soát truy cập, việc cắt tiêu chí, giới hạn tốc độ, nhật ký kiểm toán. Nói cách khác, bất cứ điều gì bạn muốn nói "điều này không thể xảy ra".
Bất cứ điều gì là kiến thức, phán đoán hay quy trình đều thuộc về một Skill, vì một lời gọi công cụ không có chỗ để đặt chúng.
Viết câu bạn muốn trở thành sự thật, rồi hỏi điều gì ngăn LLM không làm trái nó.
Bài viết liên quan
Phần mềm
VoidAccess: Công cụ OSINT mã nguồn mở biến dark web thành đồ thị tình báo mối đe dọa
20 tháng 10, 2026
Công nghệ
Cloudflare và VoidZero phát triển tsrs: Bản chuyển TypeScript sang Rust nhanh gấp 8 lần
20 tháng 10, 2026
Công nghệ
Năm 2026 bùng nổ của trình biên dịch Rust: Những khoản đầu tư dài hạn bắt đầu sinh lời
20 tháng 10, 2026