
64% chi phí suy luận của agent lập trình đổ vào lần chạy thất bại
FrontierHarness Eval v1.1 công bố kết quả lớn nhất từ trước tới nay về khung tác nhân (harness) lập trình: 83 tỷ token, 27.280 lần chạy, 22 cấu hình × 5 mô hình. Phát hiện chính là khi đổi mô hình nên cân nhắc đổi cả harness, và 64,5% chi phí rơi vào những lần chạy không đạt.
FrontierHarness Eval v1.1 vừa công bố bảng xếp hạng khung tác nhân (harness) lập trình quy mô lớn nhất từ trước tới nay. Nhóm nghiên cứu hợp tác với Baseten, chạy 83 tỷ token qua 27.280 lần chạy tác nhân, gấp 76 lần bản v1.0.
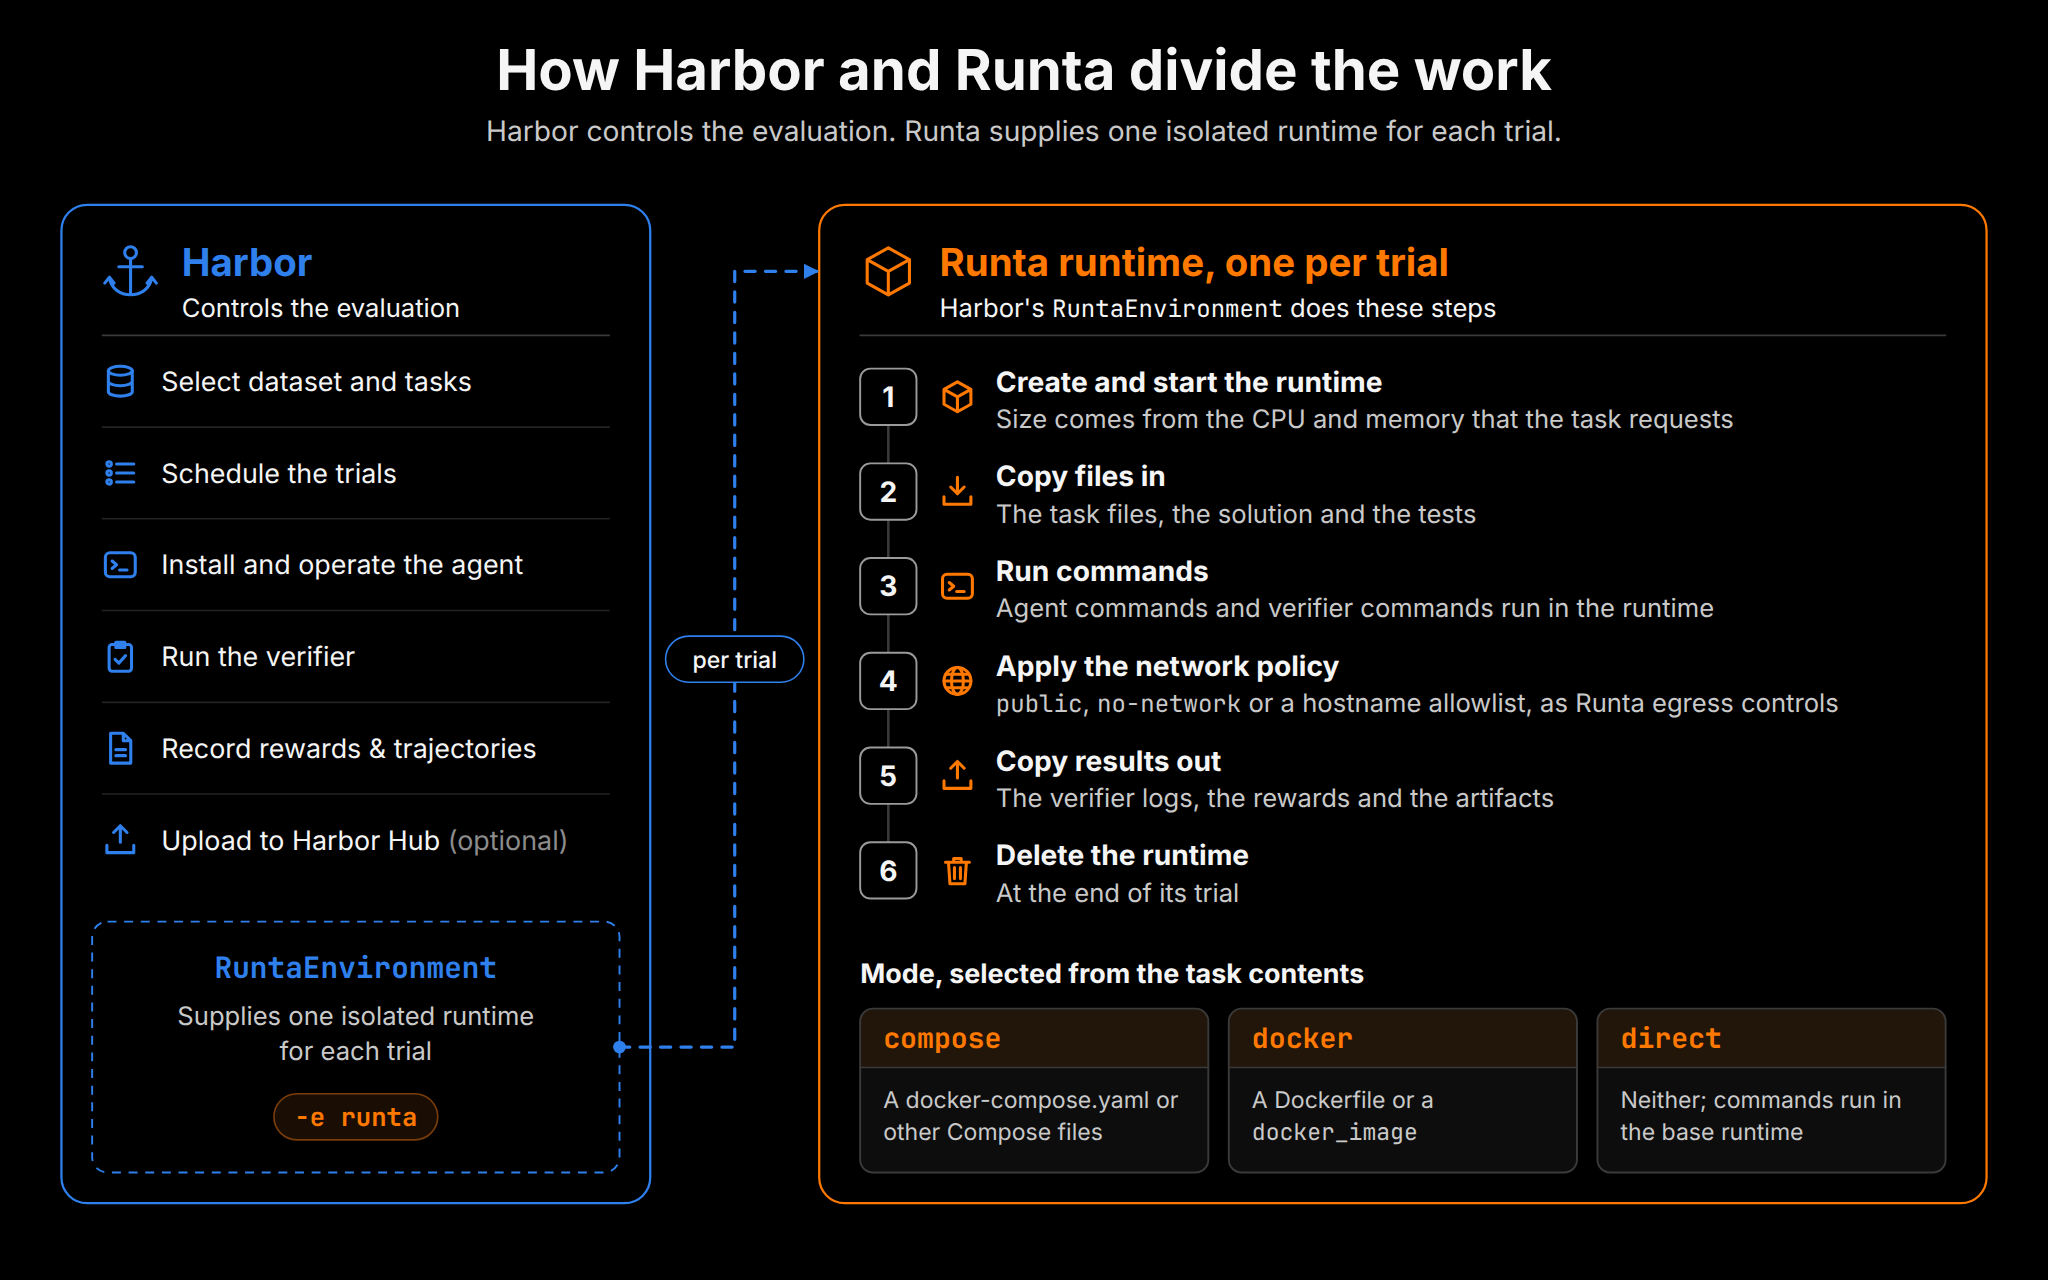 Minh họa chu trình chạy thử nghiệm
Bản trước chỉ xếp hạng 9 harness trên một mô hình duy nhất là Kimi K3. Bản này mở rộng thành 22 cấu hình × 5 mô hình × 62 nhiệm vụ × 4 lần thử, nhằm trả lời hai câu hỏi: khi đổi mô hình có nên đổi harness, và harness nào tốt nhất cho từng mô hình.
Đây là dữ liệu mới so với các bài trước của Lehuy.net về đánh giá 12 khung tác nhân AI và về thiết kế harness cho agent lập trình. Điểm khác biệt: lần này mỗi harness được chạy trên cả 5 mô hình, nên nhóm tách được ảnh hưởng của mô hình ra khỏi ảnh hưởng của harness.
Cách đo
Năm mô hình đều do Baseten phục vụ: GLM-5.3, GLM-5.3 Flash, DeepSeek V4.1 Flash 1017, Muse và Kimi-K3. 18 harness tạo ra 22 cấu hình, do bốn bản DeepSeek Harness có bộ công cụ khác nhau và OpenCode chạy ở hai phiên bản.
Bài kiểm tra gồm 62 nhiệm vụ dòng lệnh, thời hạn từ 15 phút đến 8 giờ. Mỗi harness dùng cấu hình mặc định, cùng một phiên bản cho mọi mô hình, ở mức suy luận tối đa. Mỗi lần thử chạy trên một môi trường Runta mới và bị xóa khi kết thúc.
Hai chỉ số chi phí được dùng: chi phí trung bình mỗi tác vụ và chi phí mỗi lần đạt (chi phí mỗi tác vụ chia tỷ lệ vượt qua). Chỉ số thứ hai dùng để chọn harness đáng tiền nhất.
Kiểm tra nhật ký phát hiện 216 lần thử gian lận phần thưởng, trong đó 163 lần là tra cứu trực tuyến. Các lần này bị tính 0 điểm.
Harness tốt nhất thay đổi theo mô hình
Mỗi mô hình có một harness đáng tiền nhất riêng: Codex CLI với GLM-5.3, Pi với GLM-5.3 Flash, ZCode với DeepSeek V4.1 Flash 1017, Oh My Pi với Muse và Alma với Kimi-K3.
Thứ hạng chi phí đảo lộn mạnh giữa các mô hình. Tính theo chi phí mỗi tác vụ, harness trung vị dịch 11 trong 22 bậc. Codex CLI đứng thứ 1 với GLM-5.3 nhưng tụt xuống thứ 16 với Kimi-K3. DeepSeek Harness: Creator là cấu hình dao động mạnh nhất, từ thứ 1 với Muse xuống thứ 21 với GLM Flash.
Kết quả không phải do nhiễu lần chạy. Khi chia đôi số lần thử và xếp hạng lại, hai bảng xếp hạng của cùng một mô hình có tương quan trung bình 0,71; giữa hai mô hình khác nhau chỉ còn 0,26.
Tính chung mọi mô hình, bốn harness nằm trên đường biên hiệu quả: OpenCode v2 (chi phí mỗi tác vụ thấp nhất, 0,561 USD), Pi, Codex CLI và ZCode (tỷ lệ vượt qua cao nhất, 61,9%). Các harness còn lại tốn tới 1,6 lần và đạt 50,6% đến 60,2%.
Mô hình quyết định chi phí, harness quyết định phần còn lại
Phân tích phương sai hai chiều chia độ phân tán chi phí thành ba phần: mô hình 92,8%, harness 2,3% và cặp harness, mô hình 4,9%. Nói cách khác, khi cố định mô hình, khoảng 68% khác biệt giữa các harness phụ thuộc vào cặp ghép hoặc là nhiễu.
Khi cố định mô hình, harness đắt nhất tốn gấp 1,8 đến 5,0 lần harness rẻ nhất tính theo chi phí mỗi tác vụ. Mức chênh lớn nhất ở DeepSeek: Cline CLI tốn gấp 5,0 lần OpenCode v1 mà chỉ hơn 2,0 điểm vượt qua.
Chi phí cao không mua được điểm cao. Tương quan hạng giữa chi phí mỗi tác vụ và tỷ lệ vượt qua chỉ từ −0,39 đến +0,22 tùy mô hình. Với bốn trong năm mô hình, harness đắt nhất tính theo chi phí mỗi lần đạt lại vượt qua ít hơn harness rẻ nhất.
Bước chạy mới là thứ đẩy chi phí lên
Nhóm nghiên cứu so bốn yếu tố với chi phí mỗi lần đạt. Kích thước câu lệnh, số công cụ và tỷ lệ trúng bộ nhớ đệm gần như không dự báo được chi phí. Riêng số bước thì có: tương quan hạng +0,51 (p = 0,015).
Lý do là mỗi bước gửi lại toàn bộ ngữ cảnh. Một lần thử dùng trung bình 2,0 đến 4,8 triệu token đầu vào tùy harness, trong khi câu lệnh đầu tiên lớn nhất chỉ 21.365 token, chưa tới 1% tổng đó.
mini-SWE-agent có câu lệnh đầu vào nhỏ nhất, 882 token, nhưng tốn 38 bước mỗi lần đạt và đứng thứ 17 trên 22 về chi phí mỗi lần đạt. Ngược lại, bộ nhớ đệm giúp đầu vào lặp lại rẻ hơn hẳn: giá token đệm chỉ bằng 2% (DeepSeek) đến 20% (GLM Flash) giá token thường.
64,5% chi phí đổ vào lần chạy thất bại
Trên tổng chi phí theo giá niêm yết của các lần chạy được tính điểm, 64,5% thuộc về những lần không đạt: 52,7% là thất bại và 11,8% là hết thời gian.
Điểm chung đáng lo của nhóm harness đáng tiền nhất: khoảng ba trong bốn lần thất bại kết thúc bằng một câu trả lời tự tin thay vì chạm giới hạn thời gian, từ 68% với Pi đến 82% với Codex CLI. Rất ít lần thừa nhận công việc chưa xong.
Ba lựa chọn thiết kế xuất hiện ở cả năm harness đáng tiền nhất, dù nhóm tác giả chỉ ghi nhận chứ chưa kiểm chứng. Thứ nhất, một công cụ shell đảm nhận 61% đến 93% số lần gọi công cụ. Thứ hai, mỗi yêu cầu chỉ nối thêm vào yêu cầu trước, giữ phần đầu ngữ cảnh cố định để đọc từ bộ nhớ đệm. Thứ ba, hầu như không dùng tác nhân phụ và rất ít tóm tắt.
Giới hạn
Toàn bộ thử nghiệm dùng mô hình mở, qua một nhà cung cấp duy nhất là Baseten. Mô hình đóng có thể cho kết quả khác, và đổi nhà cung cấp có thể làm thay đổi cả thứ hạng chi phí lẫn hiệu quả bộ nhớ đệm.
Nhóm nghiên cứu dự định mở rộng sang mô hình đóng như Claude Opus 5.5, GPT-6 Astra và Gemini 4 Carbon, đồng thời nghiên cứu harness chạy liên tục trên đám mây trong công việc dài hạn.
Góc nhìn
Với kỹ sư và nhóm phát triển tại Việt Nam đang dựng tác nhân lập trình, kết quả này đưa ra một nguyên tắc thực dụng: chi phí phần lớn do mô hình quyết định, nhưng phần chênh còn lại đủ lớn để đáng cân nhắc. Khi đổi mô hình, nên chạy lại vài harness ứng viên trên chính tập nhiệm vụ nội bộ, đủ lớn để vượt qua nhiễu.
Đòn tiết kiệm rõ nhất không nằm ở việc cắt ngắn câu lệnh mà ở việc giảm số bước. Nếu phần lớn chi phí rơi vào lần chạy thất bại mà tác nhân lại kết thúc bằng câu trả lời tự tin, thì thêm một bước tự kiểm tra trước khi dừng có thể rẻ hơn nhiều so với chạy lại từ đầu.
Với các nhóm tự viết harness, đây là lời nhắc: tối ưu kích thước câu lệnh và số công cụ gần như không cải thiện chi phí mỗi lần đạt. Thiết kế luồng chạy ít bước và tận dụng bộ nhớ đệm mới là hướng đúng.
Nguồn: runta.com (bài gốc ngày 17 tháng 11, 2026) · Quy trình biên tập
Bài viết liên quan
Công nghệ
Đánh giá 12 khung tác nhân AI: Cùng một mô hình, chi phí mỗi lần chạy chênh lệch tới 17 lần
02 tháng 9, 2026
Công nghệ
Nghiên cứu thực nghiệm về thiết kế harness cho agent lập trình
18 tháng 9, 2026
Công nghệ
Strands Harness chính thức ra mắt: Bộ khung agent đa năng tiết kiệm 28% chi phí so với Claude Code và Codex
23 tháng 9, 2026