
719 bài báo toán học của OpenAI có ý nghĩa gì với khoa học dữ liệu?
OpenAI công bố bộ sưu tập 719 bài báo toán học do một mô hình nội bộ chưa phát hành tạo ra, bao trùm 17 lĩnh vực với hơn 34.000 trang. Nhiều kết quả hứa hẹn cải thiện các bài toán quen thuộc trong khoa học dữ liệu như so khớp văn bản, phân cụm, sinh dữ liệu so sánh. Nhưng khoảng cách giữa định lý và một triển khai thực tế vẫn còn rất lớn.
Ngày 6 tháng 10 năm 2026, OpenAI công bố một bộ sưu tập hiện đã lên tới 719 bài báo thuộc 372 nhóm kết quả liên quan, được tạo ra bởi một mô hình nội bộ chưa phát hành. Bộ tài liệu trải dài trên 17 lĩnh vực với tổng cộng 34.669 trang PDF. Với giới khoa học dữ liệu, câu hỏi đáng quan tâm không phải là "mô hình này giỏi đến đâu", mà là "những định lý này thực sự hứa hẹn điều gì cho các bài toán tính toán quen thuộc, và còn điều gì ngăn cách giữa định lý với một công cụ dùng được".
Ẩn dụ của Scott Aaronson
Scott Aaronson mô tả một người săn bắt hái lượm đã dành cả đời học cách sinh tồn trong rừng mưa, rồi bỗng thấy một khu nghỉ dưỡng mọc lên ngay cạnh, đầy hồ bơi nước nóng và nhà Airbnb. Người này nhanh chóng điều chỉnh kế hoạch sự nghiệp: "được rồi, nghề mới của tôi là tổ chức các khóa tu dã ngoại cho khách du lịch, hay gì đó".
Đó là cách Aaronson mô tả tâm trạng của giới toán học sau khi OpenAI công bố bộ tài liệu này, trong bài viết The Mathocalypse. Một định lý có thể chứng minh rằng một phương pháp tốt hơn là khả thi, từ rất lâu trước khi bất kỳ ai có được một triển khai đáng dùng.
Bức tranh tổng thể: khoa học máy tính nhiều nhóm nhất, xác suất nhiều trang nhất
OpenAI gọi mỗi nhóm kết quả liên quan là một "result family" (nhóm kết quả). Một nhóm có thể chứa nhiều kết quả liên kết hoặc nhiều cách chứng minh khác nhau cho cùng một kết quả. Trong 372 nhóm, có 205 nhóm chỉ chứa một bài báo và 301 nhóm chứa không quá hai bài. Nhóm lớn nhất chứa 14 bài.
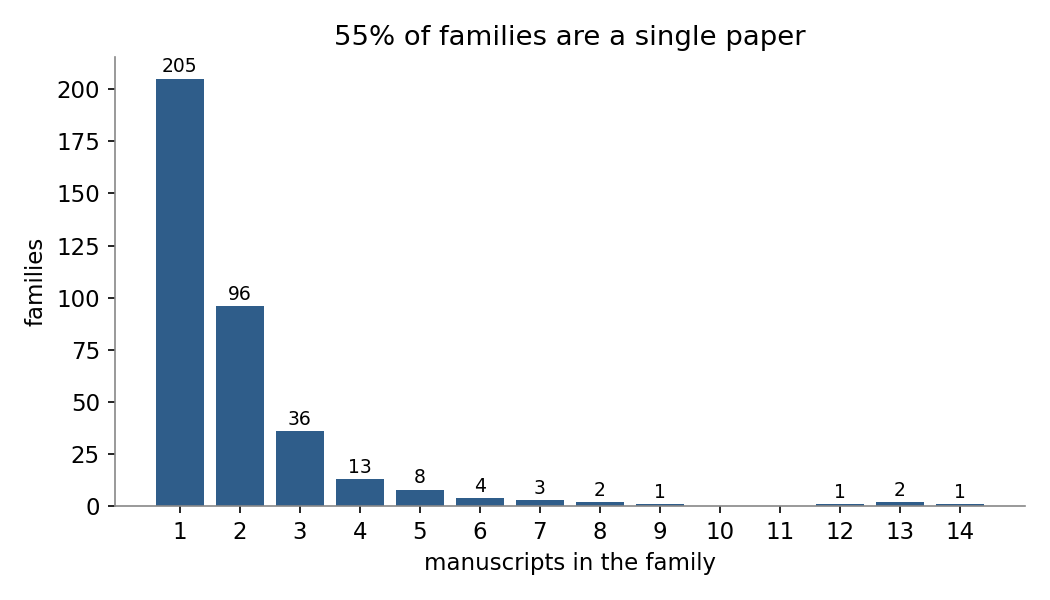 Phân bố số bài báo theo nhóm kết quả
Nếu đếm theo số nhóm, khoa học máy tính lý thuyết dẫn đầu với 40 nhóm, chiếm khoảng 11% tổng số. Nhưng nếu đếm theo số trang, xác suất và cơ học thống kê lại chiếm phần lớn nhất: 29 nhóm chứa 105 bài báo và 7.232 trang, tương đương khoảng 21% toàn bộ số trang.
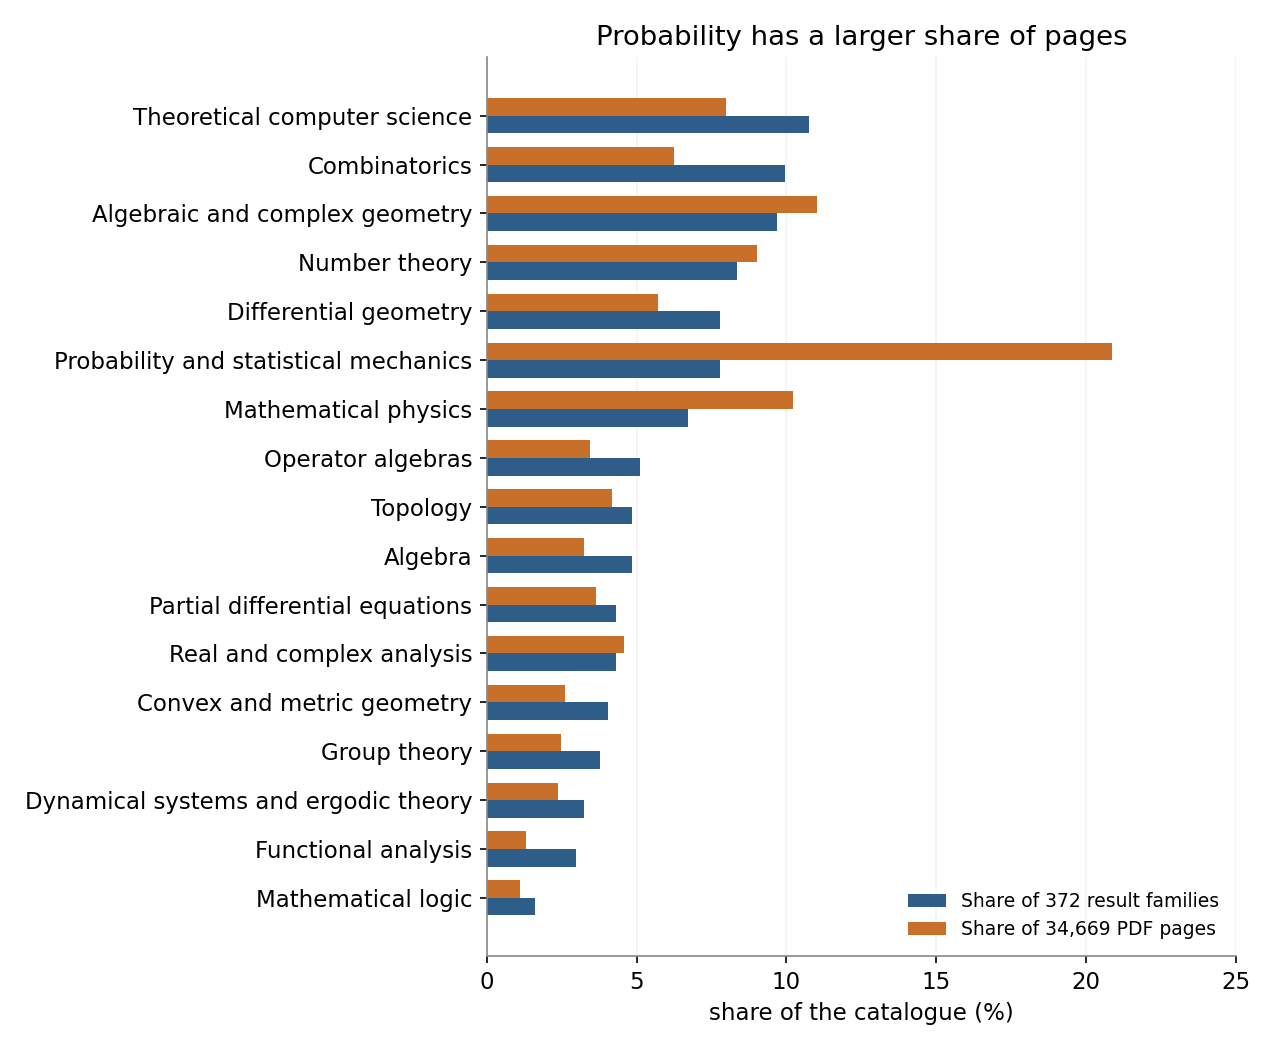 So sánh 17 lĩnh vực theo số nhóm và số trang
Bài báo trung vị dài 39 trang, và 57 bài vượt mốc 100 trang. Đọc mỗi ngày một PDF sẽ mất gần hai năm — giả sử một bài 262 trang được coi là ngày thứ Ba bình thường.
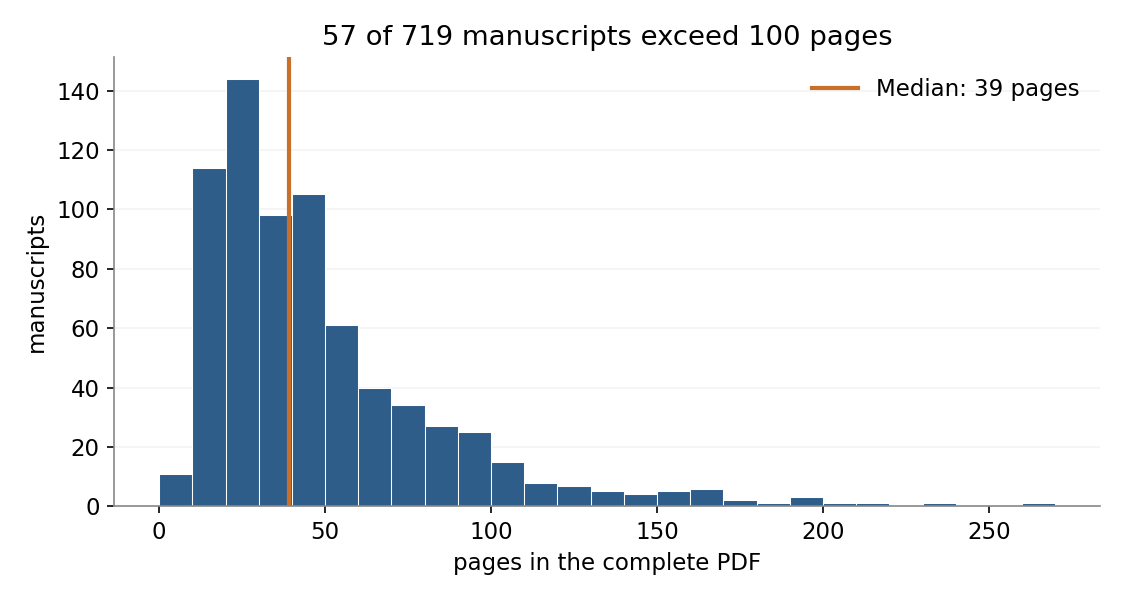 Số trang của toàn bộ 719 PDF trong bộ sưu tập
So khớp chuỗi dài: bảo đảm tốc độ nhờ thuật toán xấp xỉ
Hãy tưởng tượng hai dòng trong bảng khách hàng: Jon Smith và John Smyth. Phép so khớp văn bản nghiêm ngặt coi chúng là hai người xa lạ. Để so sánh cách viết, ta đếm số phép chèn, xóa và thay thế ký tự ít nhất cần thiết để biến chuỗi này thành chuỗi kia — ở đây là hai phép (chèn h, thay i bằng y). Đây chính là khoảng cách chỉnh sửa (edit distance), thành phần hữu ích khi so khớp các bản ghi có văn bản hơi khác nhau.
Cách tính chính xác tiêu chuẩn dựng một lưới, với vị trí trong chuỗi này theo hàng và vị trí trong chuỗi kia theo cột. Hai chuỗi 10.000 ký tự cho khoảng 100 triệu ô. Gấp đôi độ dài, lưới phình lên gấp bốn lần.
Bài báo mới về khoảng cách chỉnh sửa tuyên bố một phương pháp có khối lượng tính toán trung bình tăng gần như tỷ lệ thuận với tổng độ dài văn bản, với bất kỳ mức sai số phần trăm cố định nào. Chọn 1%: nếu khoảng cách thật là 100, một ước lượng thành công sẽ là 100 hoặc 101. Phương pháp này dùng tính ngẫu nhiên và hứa hẹn ước lượng nằm trong mức cho phép ít nhất hai lần trong ba lần chạy.
Tuy nhiên, công thức đã công bố vẫn dùng cách tính lưới chính xác dưới một ngưỡng kích thước đầu vào khổng lồ. Việc biến tốc độ tăng trưởng tốt hơn này thành lợi ích thực tế ở những độ dài ta có thể lưu trữ được vẫn là công việc còn ở phía trước. Đầu ra của nó là một điểm số, hữu ích để xếp hạng các ứng viên so khớp, chứ chưa phải danh sách chỉnh sửa cụ thể.
Phân cụm: bảo đảm tốt hơn giới hạn chi phí của một câu trả lời tồi
Giả sử bạn có hàng nghìn phiếu hỗ trợ khách hàng và một đồng nghiệp sẵn lòng đọc sáu phiếu. Sự sẵn lòng của người đó là nguồn lực khan hiếm. Bạn muốn sáu phiếu ấy đại diện cho toàn bộ kho lưu trữ càng sát càng tốt.
Biểu diễn mỗi phiếu thành một vector đặc trưng, với các phiếu tương tự nằm gần nhau. Chọn một số phiếu thực tế rồi cộng khoảng cách từ mỗi phiếu đến phiếu được chọn gần nó nhất. Tổng càng nhỏ nghĩa là độ phủ càng tốt theo thước đo khoảng cách bạn chọn.
Cách chọn k quan sát thực tế như vậy gọi là k-medoids. KMeans có thể đặt tâm giữa các quan sát — hợp lý về mặt hình học nhưng lúng túng khi đồng nghiệp của bạn yêu cầu đọc một phiếu cụ thể. Bài toán k-median mở rộng hơn cho phép một danh sách vị trí ứng viên riêng, ví dụ các kho hàng phục vụ khách hàng.
Số lượng cách chọn khả thi nhanh chóng khiến việc kiểm tra tất cả trở nên đắt đỏ. Bài báo về k-median của OpenAI tuyên bố một bảo đảm chặt hơn cho thuật toán của mình: nếu cách chọn tốt nhất tốn 100, bảo đảm tổng quát trước đây cho phép khoảng 200; mức trần mới tiến gần 173,6.
Bảo đảm xấp xỉ này áp dụng cho mọi tập dữ liệu hợp lệ, với điều kiện khoảng cách phải tuân thủ quy tắc rằng đi vòng qua điểm thứ ba không thể ngắn hơn đường trực tiếp.
Điều đáng chú ý: nếu áp dụng công thức đã công bố một cách nguyên văn, ngay cả với bảo đảm lỏng hơn, thuật toán chia một vị trí mở hoàn toàn thành hơn 6 × 10²⁸ mảnh nhỏ. Chạm vào từng mảnh một lần với tốc độ giả định nghìn tỷ mảnh mỗi giây cũng mất gần hai tỷ năm. Một triển khai thực tế sẽ cần tránh việc tạo ra từng mảnh riêng lẻ.
Dữ liệu so sánh: giữ nguyên mọi tổng hàng và cột
Giả sử bạn có số liệu doanh số trà và cà phê ở hai vùng. Để nghiên cứu mô hình khu vực, bạn có thể sinh ra các bảng so sánh vẫn giữ cố định cả hai bộ tổng. Mỗi vùng vẫn phải bán 50 ly, với tổng cộng 60 trà và 40 cà phê.
Đây là một bảng dự phòng (contingency table): các số đếm được phân chia theo hai tiêu chí. Một cách ngẫu nhiên hóa nó là cho mọi bảng thỏa mãn các tổng có xác suất bằng nhau.
Bài báo lấy mẫu mới tuyên bố một phương pháp tạo ra chính xác phân phối đồng đều này cho các tổng tương thích tùy ý, với cả số hàng lẫn số cột đều có thể tăng. Các bảo đảm về thời gian chạy trước đây được mô tả trong phần mở đầu yêu cầu những hạn chế, chẳng hạn số hàng cố định. Bảo đảm mới bao phủ cả những tổng rất không đồng đều.
Mô hình xác suất rất quan trọng: cho mọi bảng trọng số bằng nhau khác với việc xáo trộn từng bản ghi bán hàng, vốn có thể tạo ra một số bảng theo nhiều cách hơn những bảng khác. Bạn nên quyết định loại so sánh nào phù hợp với phân tích của mình trước khi chọn bộ lấy mẫu.
Bộ nhớ hạn chế buộc mô hình phải dùng nhiều dữ liệu hơn
Hãy tưởng tượng bạn huấn luyện một mô hình khi các hàng dữ liệu lần lượt đến, mà không lưu giữ toàn bộ tập dữ liệu. Thông tin hữu ích từ các hàng cũ phải tồn tại trong trạng thái lưu trữ của mô hình.
Bài báo về bộ nhớ và độ chính xác nghiên cứu đầu vào phân phối chuẩn cùng nhãn được tính từ trọng số thật, không có nhiễu. Bộ nhớ bao gồm cả số bit cần để lưu trữ các con số một cách chính xác.
Một bản tóm tắt kích thước cố định chỉ có hữu hạn trạng thái, nên những lịch sử khác nhau có thể để lại thông tin lưu trữ giống hệt nhau. Ước lượng tinh tế hơn đòi hỏi nhiều phân biệt hơn giữa các trọng số khả dĩ. Giữ thêm chữ số có thể bảo toàn những phân biệt đó, nhưng tốn nhiều bộ nhớ hơn.
Với mọi bản tóm tắt nằm trong ngân sách bộ nhớ đã nêu, bài báo đặt ra giới hạn dưới cho ngân sách mẫu mà mô hình phải được phép sử dụng. Kết quả này kết nối câu hỏi "thu thập bao nhiêu dữ liệu" với câu hỏi "giữ lại bao nhiêu thông tin". Ngay cả tập dữ liệu rất tử tế của định lý, không có nhãn sai nào, cũng không thể xóa bỏ được sự đánh đổi đó.
Chấp nhận một chút sai số khoảng cách có thể tiết kiệm nhiều tọa độ
Một vector đặc trưng là một hàng số. Để tìm các quan sát tương tự, có thể bạn cần khoảng cách giữa các hàng hơn là từng tọa độ gốc.
Các quan sát tại (0, 0), (3, 4) và (6, 8) có khoảng cách lần lượt là 5, 5 và 10. Lưu chúng thành 0, 5 và 10 trên một trục, và những khoảng cách ấy vẫn được bảo toàn chỉ với một số mỗi quan sát.
Bài báo mới liên quan đến các quy tắc khoảng cách khác. Một quy tắc cộng lũy thừa bậc bốn của hiệu tọa độ rồi lấy căn bậc bốn, thay vì dùng bình phương và căn bậc hai. Từ (0, 0), khoảng cách đến (1, 1) trở thành khoảng 1,19 thay vì 1,41, trong khi (1, 0) giữ nguyên khoảng cách 1.
Bảo toàn khoảng cách một cách chính xác có thể đòi hỏi số tọa độ tăng theo bình phương số quan sát. Cho phép một tỷ lệ sai số cố định, giới hạn của bài báo cuối cùng tăng chậm hơn căn bậc hai của con số đó.
Chứng minh khẳng định rằng một biểu diễn như vậy tồn tại cho các điểm đã cho. Một cách xây dựng hiệu quả và việc xử lý các quan sát đến sau vẫn còn là công việc phía trước.
Các kỷ lục tốc độ dùng cách đếm khối lượng khác nhau
Các tuyên bố về tốc độ cho ba thao tác quen thuộc phụ thuộc vào cách đếm khối lượng công việc:
| Tác vụ | Bài báo tuyên bố gì | Bài báo đếm gì |
|---|---|---|
| Nhân ma trận | Tốc độ tăng trưởng tốt hơn cho số phép toán khi ma trận lớn dần | Phép toán số học; bài báo "không nêu kích thước ma trận hữu hạn cạnh tranh được" |
| Biến đổi Fourier | Cải thiện nhỏ về tốc độ tăng của khối lượng số học | Phép toán số học chính xác; phần mềm FFT thông thường dùng tính toán làm tròn |
| Lấy mẫu từ một phân phối | Giới hạn tốt hơn cho số lần yêu cầu giá trị hàm và gradient | Số lần yêu cầu giá trị và gradient; tính toán giữa các lần yêu cầu không bị giới hạn |
Kết quả lấy mẫu dùng cách hạch toán của một báo cáo đếm số truy vấn cơ sở dữ liệu và coi toàn bộ phần Python sau đó là chuyện cá nhân. Mười lời gọi vẫn có thể theo sau bởi một ngày xử lý các phản hồi.
Một bài báo về việc di chuyển phân phối này sang phân phối khác phát hiện một bảo đảm ổn định yếu hơn những gì các nhà nghiên cứu từng phỏng đoán: những phân phối mục tiêu tương tự nhau có thể đòi hỏi những dịch chuyển từng điểm ít tương tự nhau hơn. Với một pipeline căn chỉnh dữ liệu, bạn nên kiểm tra cả cách các quan sát di chuyển lẫn mức độ khớp giữa các phân phối.
Chứng minh được máy kiểm tra vẫn cần đọc kỹ tuyên bố
Một trình kiểm tra chứng minh là chương trình xác minh liệu các bước lập luận có thiết lập được một phát biểu được viết chính xác từ các giả thiết hay không. Lean là một chương trình như vậy.
OpenAI báo cáo các chứng minh được máy kiểm tra cho những kết quả chính trong 300 trên 719 bài báo, khoảng 42%. Những kiểm tra này bao phủ các kết quả cụ thể trong mỗi bài.
Nếu đếm theo nhóm: 242 trên 372 nhóm, khoảng 65%, có liên kết đến một trang mô tả chứng minh Lean. Cả sáu nhóm logic toán học đều có liên kết như vậy, so với ba trong mười tám nhóm tôpô.
Lịch sử kho lưu trữ ghi nhận ba bài báo bị rút lại: một lỗi dấu làm vô hiệu một cách xây dựng, và hai bài phụ thuộc vào nó.
Các chuyên gia tìm thấy ý tưởng đáng học trong những chứng minh xa lạ
Dana Moshkovitz đã dành khoảng hai thập kỷ nghiên cứu Unique Games, một bài toán liên quan đến giới hạn mức độ các thuật toán có thể tiến gần đáp án tốt nhất. Phản ứng đầu tiên của cô trước chứng minh mới là sự bối rối. Aaronson dẫn lại những phàn nàn của cô về các bước không được giải thích và trích dẫn gây nhầm lẫn, cùng mô tả của cô về cách xây dựng này là "một thứ điên rồ ngoài hành tinh nào đó".
Cô nhờ Astra, một trợ lý AI, giải thích chứng minh theo kiểu tương tác. Đến hôm sau, Aaronson cho biết cô đã hiểu phần lớn chứng minh và kinh ngạc trước những ý tưởng mới của nó.
Aaronson so sánh mô hình với một nhà nghiên cứu trẻ có kiến thức rộng phi thường, khả năng kết nối kỹ thuật giữa các lĩnh vực, và sự kiên trì bất thường. Moshkovitz cũng nhấn mạnh rằng các kết quả mới được xây dựng trên những cộng đồng người và công trình trước đó.
Tôi cho rằng đây là lý do để nghiên cứu bộ tài liệu này ngay cả trước khi các thuật toán của nó trở nên khả dụng. Một phương pháp trông cồng kềnh trong chứng minh tổng quát có thể chứa một ý tưởng mà ta có thể chuyển thể cho một tác vụ hẹp hơn.
Một hệ quả bất ngờ: môi trường học tăng cường
Một hệ quả khác của việc công khai những kết quả này: Hugging Face đã chuyển đổi 369 trong số các thách thức toán học của OpenAI thành môi trường học tăng cường, nơi các mô hình cố gắng chứng minh hình thức và nhận phản hồi từ một trình xác minh.
Đây không phải là chưng cất mô hình thông thường: không cần truy cập vào trọng số hay lý luận nội bộ của OpenAI. Thay vào đó, nó cung cấp một dạng chuyển giao năng lực, cho phép các mô hình mở nhỏ hơn huấn luyện dựa trên các bài toán toán học và hạ tầng xác minh bắt nguồn từ nghiên cứu tiên tiến.
Trình xác minh hiện tại còn hạn chế và có thể từ chối những chứng minh tương đương về mặt toán học nhưng được diễn đạt khác đi. Câu hỏi thú vị là liệu quá trình huấn luyện này có khái quát hóa vượt ra ngoài việc tái tạo các kết quả đã biết hay không.
Ý nghĩa thực tiễn với người làm khoa học dữ liệu
Với bài báo k-median, bước hữu ích tiếp theo là biến kế hoạch mở một phần của nó thành một triển khai khả thi, xác định những bảo đảm nào còn sống sót qua mọi đơn giản hóa, rồi so sánh cả chất lượng câu trả lời lẫn thời gian chạy.
Các phương pháp phân cụm quen thuộc vốn đã làm khá tốt trên bộ kiểm thử nhỏ hiện có: hai phiên bản của phương pháp hoán đổi đại diện đều khớp chi phí tốt nhất trên 14 trong 15 bài toán, với sai số lớn nhất lần lượt là 0,8% và 0,3%. Điều đó có nghĩa là các bộ dữ liệu khá "thân thiện" này để lại rất ít dư địa cải thiện chất lượng câu trả lời — và việc so sánh thuật toán của OpenAI sẽ cần một triển khai hoạt động được, những ví dụ khó hơn và số liệu thời gian.
"Tôi nghĩ đây là lý do để nghiên cứu bộ tài liệu này ngay cả trước khi các thuật toán của nó trở nên khả dụng."
Bài học lớn nhất có lẽ nằm ở chỗ: những lựa chọn về độ chính xác, khoảng cách và tính ngẫu nhiên quyết định khối lượng tính toán, lưu trữ và dữ liệu mà ta cần. Và khoảng cách giữa một định lý đẹp và một công cụ dùng được trong sản xuất vẫn là nơi mà công việc kỹ thuật thật sự diễn ra.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
So sánh bảy mô hình ra quyết định mã nguồn mở với LLM tạo sinh: Bài học từ routing ngân hàng
15 tháng 10, 2026