
Agent neurosymbolic và lỗ hổng ở bước dịch sang logic
Bài viết phân tích cách các agent neurosymbolic giao phần suy luận cho bộ giải ràng buộc như Z3 để kiểm chứng câu trả lời của mô hình ngôn ngữ. Kết quả nghiên cứu rất mạnh, nhưng bước dịch từ tiếng Anh sang logic vẫn là điểm yếu chưa khắc phục được.
Tháng 11/2022, một hành khách tên Moffatt hỏi chatbot trên website Air Canada về giá vé tang chế. Bà của anh vừa mất, và anh cần bay từ Vancouver đến Toronto để dự tang lễ.
Chatbot trả lời rằng anh có thể mua vé thường rồi xin hoàn lại phần chênh lệch trong vòng 90 ngày. Thông tin đó sai. Chính sách thật của hãng không cho hoàn tiền, và chatbot còn đính kèm liên kết đến trang ghi rõ điều này.
Air Canada từ chối hoàn tiền. Khi vụ việc được đưa ra tòa án hành chính, hãng lập luận rằng mình không chịu trách nhiệm về những gì chatbot nói. Tháng 2/2024, tòa bác lập luận đó và buộc hãng trả khoản chênh lệch.
Sự cố này cho thấy một lỗi cốt lõi của agent dùng mô hình ngôn ngữ: câu trả lời tự tin nhưng hoàn toàn sai. Agent neurosymbolic (neuro-symbolic) là một hướng khắc phục, bằng cách giao một phần suy luận cho công cụ hình thức.
Agent neurosymbolic là gì?
Từ thế kỷ 17, Gottfried Wilhelm Leibniz đã mơ về một ngôn ngữ hình thức đủ chính xác để mọi tranh luận trở thành phép tính. Kế hoạch thất bại vì lý do thực tế: phải có người dịch câu hỏi đời thường sang ngôn ngữ hình thức bằng tay.
Hệ thống hình thức như hệ chuyên gia suy luận đáng tin nhưng con người phải viết từng luật. Mạng nơ-ron học từ dữ liệu nhưng không bảo đảm đầu ra đúng. Mô hình ngôn ngữ lớn thay đổi cục diện vì có thể tự dịch tiếng Anh sang các ngôn ngữ hình thức như SQL hay PDDL.
Định nghĩa hẹp dùng trong bài: agent neurosymbolic là agent mà ít nhất một quyết định được đưa ra hoặc kiểm tra bởi thành phần làm việc trên ký hiệu tường minh, có ý nghĩa hình thức, để kết quả kiểm chứng được mà không cần tin mô hình nơ-ron.
Bộ giải thực sự kiểm tra điều gì?
Gọi x là yêu cầu bằng tiếng Anh. Mô hình ngôn ngữ với tham số θ dịch x thành đặc tả hình thức φ. Bộ giải hình thức Σ trả về đáp án y kèm chứng nhận c, ví dụ một chứng minh hoặc một phép gán thỏa mãn.
Chứng nhận chứng minh y thỏa mãn φ, nhưng không chứng minh φ phản ánh đúng x. Không ai kiểm tra hình thức được liệu y có đúng ý người dùng hay không, vì "ý người dùng" không có định nghĩa hình thức.
Khoảng cách giữa x và φ được gọi là khoảng trống hình thức hóa (formalization gap).
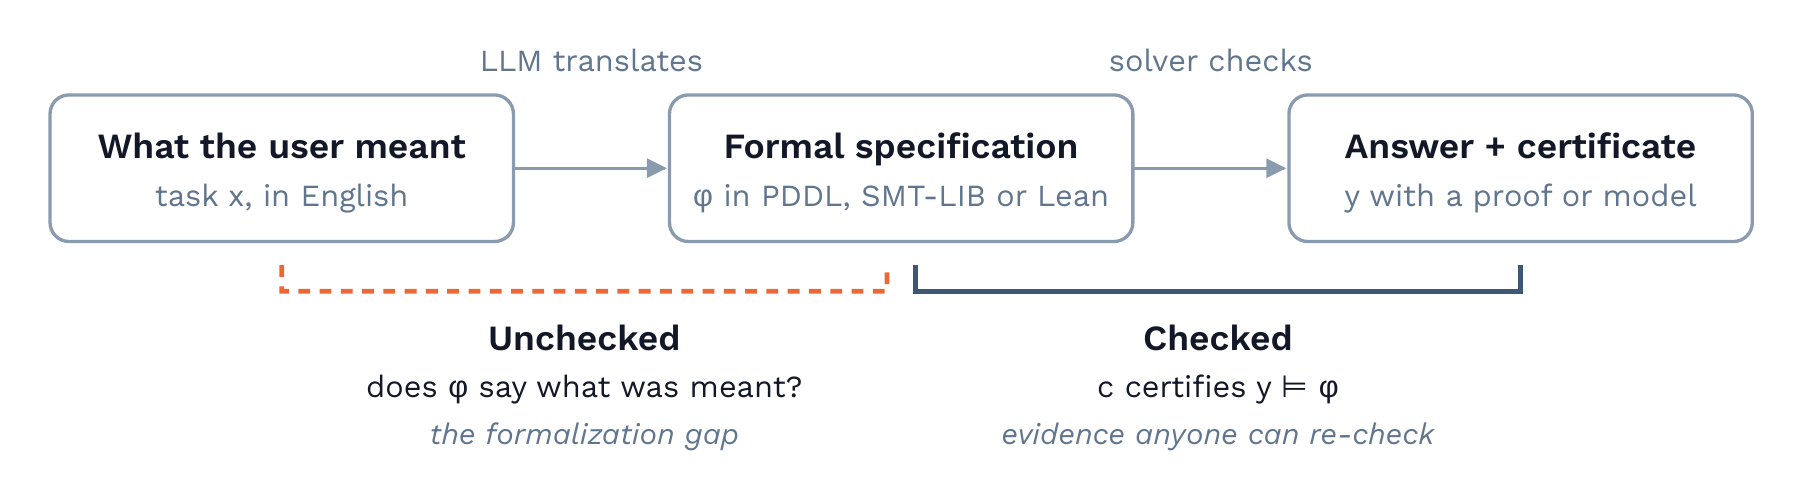 Mô hình agent neurosymbolic với bộ giải ràng buộc
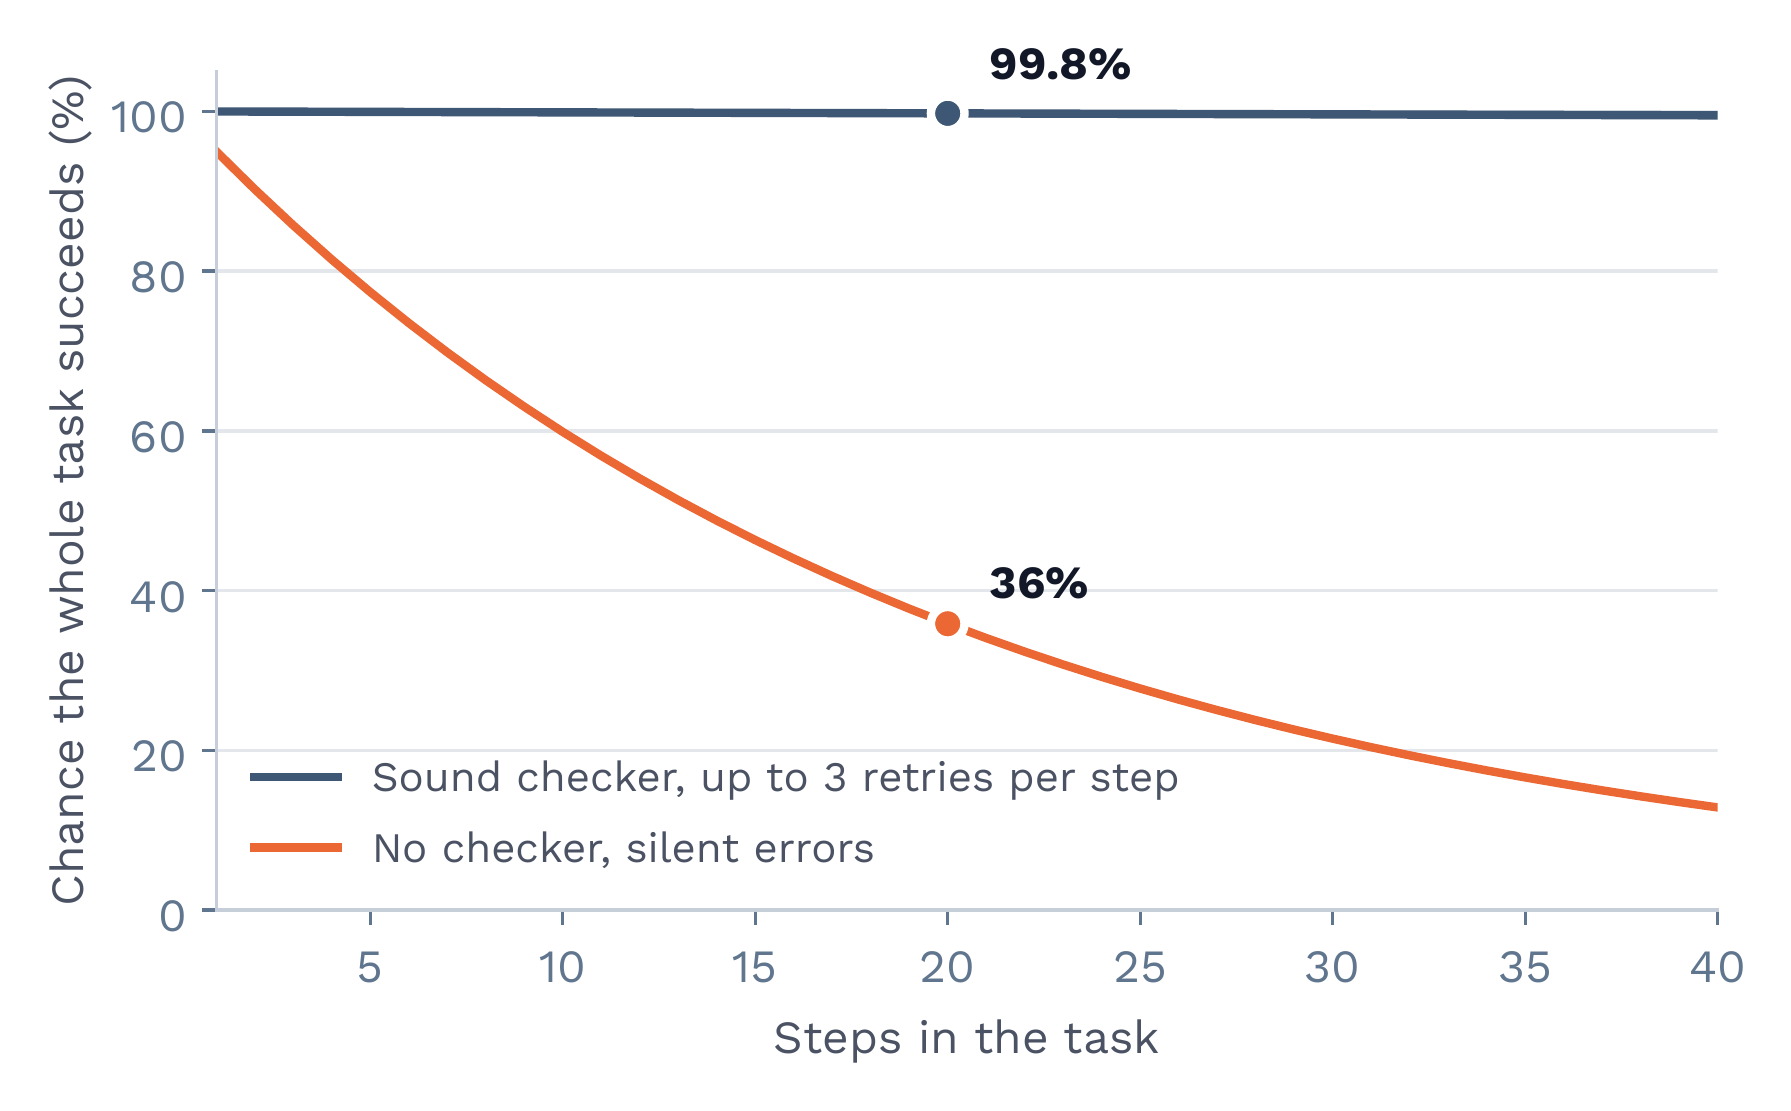
Vì sao vẫn nên thêm bộ kiểm tra? Vì sai số tích lũy. Nếu mỗi bước đúng với xác suất p và lỗi không bị phát hiện, tác vụ n bước thành công với xác suất pⁿ. Có bộ kiểm tra âm thanh và ba lần thử mỗi bước, tỷ lệ này cao hơn nhiều.
Với p = 0,95 và 20 bước, agent không có bộ kiểm tra chỉ hoàn thành đúng 36% số lần. Có bộ kiểm tra và ba lần thử mỗi bước, con số lên 99,8%.
Bốn vị trí đặt bộ kiểm tra
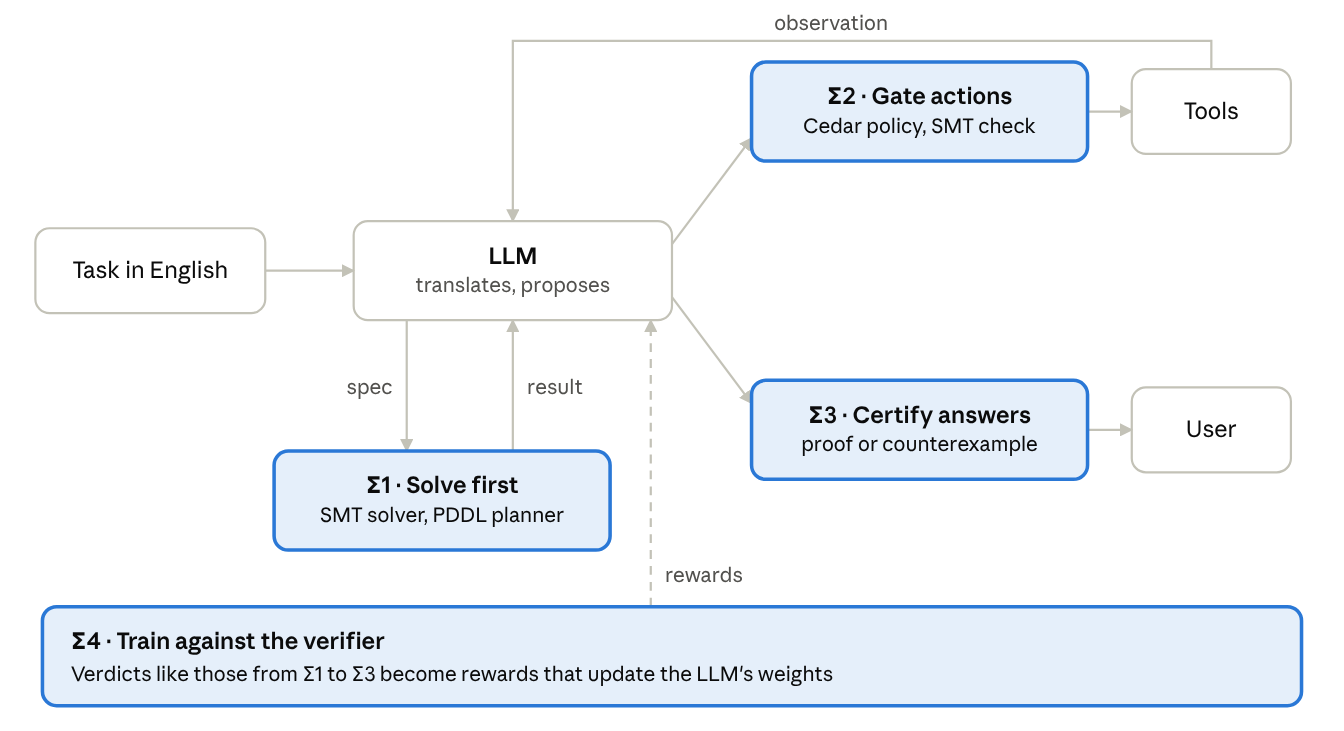
Để bộ giải tạo đáp án. Trong Logic-LM, mô hình viết bài toán dạng ký hiệu và bộ giải lo phần suy luận. Khi bộ giải báo lỗi, thông báo được gửi lại để mô hình sửa bản dịch. Trên năm bộ dữ liệu suy luận logic, Logic-LM vượt prompting thông thường 39,2% và vượt chain-of-thought 18,4%.
Kiểm tra từng hành động trước khi thực hiện. Agent-C viết luật như "xác thực người dùng trước khi truy cập dữ liệu" bằng ngôn ngữ luật nhỏ, chuyển thành logic và dùng bộ giải SMT để chặn lệnh gọi công cụ vi phạm. Trên các bài kiểm thử dịch vụ khách hàng ngành bán lẻ và hàng không, hệ đạt 100% tuân thủ chính sách với cả Claude Sonnet 4.5 và GPT-5. Điểm hữu ích của tác vụ cũng tăng.
Kiểm tra đáp án cuối. Automated Reasoning checks của Amazon, thuộc Bedrock Guardrails, chuyển chính sách bằng văn bản thành logic và đối chiếu từng câu trả lời của mô hình. Mỗi câu trả lời được dịch nhiều lần, các bản phải khớp nhau mới được tin. Nhóm tác giả báo cáo độ âm thanh trên 99% và gần như không có dương tính giả.
Dùng bộ kiểm tra làm phần thưởng khi huấn luyện. Đây là cách các trình chứng minh định lý mạnh nhất hiện nay được huấn luyện. Một bài tổng quan năm 2026 trên 178 công trình ghi nhận mức cải thiện 23% trong hoàn thành tác vụ robot và 95,4% thành công khi tự hành, so với 18,6% của mô hình nơ-ron thuần.
 Kiến trúc kiểm chứng nhiều tầng cho agent
Ví dụ Python với Z3
Tác vụ: xếp bốn công việc lên một node GPU duy nhất gồm ingestion, training, evaluation và deployment. Ingestion chạy trước training và evaluation. Evaluation chạy sau training và trước cửa sổ bảo trì lúc 12:00. Không có gì chạy lúc 12:00. Deployment diễn ra buổi chiều, ít nhất hai giờ sau evaluation.
Mô hình không viết mã Z3 trực tiếp. Nó điền vào một định dạng có kiểu, mỗi câu tiếng Anh ứng với một ràng buộc có tên, rồi mã chuyển định dạng đó sang Z3. Nhờ vậy không có mã do mô hình viết nào được chạy.
Trong ví dụ, mô hình dịch ngược một câu:
llm_spec = {
    "base":             base(),
    "ingest_first":     And(t["ingest"] <= t["train"], t["ingest"] <= t["evaluate"]),
    "eval_order":       t["evaluate"] >= t["train"],
    "eval_before_noon": t["evaluate"] = 13,    # deploy_gap: sai chiều
}

print(schedule(llm_spec))
Kết quả trả về tên ba trong sáu ràng buộc không thể cùng đúng. Mỗi tên gắn với một câu tiếng Anh, nên agent chỉ đúng câu cần xem lại. Phản hồi này hữu ích hơn nhiều so với một nhận xét văn xuôi từ mô hình ngôn ngữ khác.
Sau khi mô hình sửa, bộ giải tìm ra lịch: ingestion lúc 9:00, training lúc 10:00, evaluation lúc 11:00, deployment lúc 13:00.
Điểm gãy nằm ở đâu?
Công trình Planetarium yêu cầu GPT-4o dịch các bài toán lập kế hoạch sang PDDL. Gần như toàn bộ đầu ra là PDDL hợp lệ và bộ lập kế hoạch giải được. Nhưng chỉ khoảng một phần tư mô tả đúng bài toán thực sự được hỏi.
Một nghiên cứu năm 2026 về kiểm chứng neuro-formal ghi nhận trường hợp tệ hơn. Một agent lập trình được hỏi các chương trình Python có đúng không, và nó chuyển mỗi câu hỏi thành bài chứng minh cho Dafny. Khi nối agent với bộ kiểm chứng một cách đơn giản, agent "chứng minh" 98% chương trình đúng và 98% chương trình có lỗi.
Bộ kiểm chứng không bao giờ chấp nhận chứng minh sai. Vấn đề là agent đã chứng minh những mệnh đề không còn mô tả chương trình gốc. Độ chính xác chỉ lên 92% khi tách bản dịch thành các giai đoạn riêng, không thấy trước kết luận mong muốn. Kể cả vậy, hệ chỉ quyết định được 57% số ca.
 Khoảng trống giữa câu tiếng Anh và đặc tả hình thức
Bộ giải có bắt được bản dịch sai?
Ví dụ xếp lịch cũng vướng lỗi này. "Buổi chiều" có thể nghĩa là từ 13:00 hoặc từ 14:00. Mô hình chọn một cách hiểu mà không nói ra.
Thay vì tin một bản dịch, agent có thể ghi cả hai cách hiểu và hỏi bộ giải liệu chúng có mâu thuẫn không. Lịch mà hai cách hiểu bất đồng chính là lịch có deployment lúc 13:00, đúng lịch mà bộ giải vừa "xác thực".
Cách sửa có thể đơn giản: hỏi thẳng người dùng "13:00 có tính là buổi chiều không?". Hoặc chọn lịch mà cả hai cách hiểu đều chấp nhận, đẩy deployment sang 14:00. Nếu lịch như vậy tồn tại, mơ hồ không ảnh hưởng đến quyết định và agent có thể đi tiếp mà không cần hỏi.
Amazon Automated Reasoning checks dùng đúng ý tưởng này trong môi trường thật: dịch mỗi câu trả lời nhiều lần và kiểm tra các bản có khớp nhau.
Bốn thực hành khi xây agent neurosymbolic
- Cho mô hình điền vào đặc tả có kiểu thay vì viết mã cho bộ giải.
- Đặt tên mỗi ràng buộc theo câu gốc, để truy vết lỗi về đúng đoạn văn.
- Dịch tác vụ ít nhất hai lần, để bộ giải tìm mâu thuẫn trước khi tin bất kỳ bản nào.
- Dành thời gian người kiểm duyệt cho phần đặc tả, không chỉ cho đầu ra.
Góc nhìn
Với đội phát triển ở Việt Nam đang gắn mô hình ngôn ngữ vào quy trình nghiệp vụ, bài học thực dụng là đừng xem bộ giải ràng buộc như lớp bảo hiểm tuyệt đối. Nó chỉ bảo đảm đáp án đúng với đặc tả, không bảo đảm đặc tả đúng ý người đặt yêu cầu.
Cách làm hợp lý là giữ định dạng trung gian có kiểu, gắn tên ràng buộc với câu gốc và dịch hai lần để đối chiếu. Với các bài toán có tiêu chuẩn đúng rõ ràng như kiểm tra chính sách, xếp lịch hay cấu hình hạ tầng, chi phí này thấp hơn nhiều so với rủi ro một câu trả lời sai được đưa thẳng cho khách hàng.
Nguồn: towardsdatascience.com (bài gốc ngày 18 tháng 11, 2026) · Quy trình biên tập
Bài viết liên quan
AI & ML
AI Agent Tự Tinh Chỉnh Mô Hình Giữa Chừng: Rò Rỉ Bí Mật và Xóa Bỏ Cơ Chế Từ Chối
17 tháng 9, 2026
Phần mềm
Tại sao hầu hết AI Agent thất bại khi đưa vào vận hành: Xây dựng theo tư duy ngược
27 tháng 5, 2026
Công nghệ
Xây dựng AI Agents bền vững: Bài học từ quá khứ để vượt qua chu kỳ Hype
17 tháng 6, 2026