
AI đọc 158.059 bài báo và tìm ra 872 lỗi khoa học
Casey Handmer, tiến sĩ vật lý thiên văn lượng tử tại Caltech, dùng AI đọc toàn bộ lĩnh vực chuyên môn của mình: 158.059 bài báo và 554.670 trích dẫn. Hệ thống phát hiện 872 lỗi trong 433 bài, phần lớn bị các bài sau sao chép mà không ai đính chính. Kết quả đặt câu hỏi về khả năng tự sửa sai của khoa học.
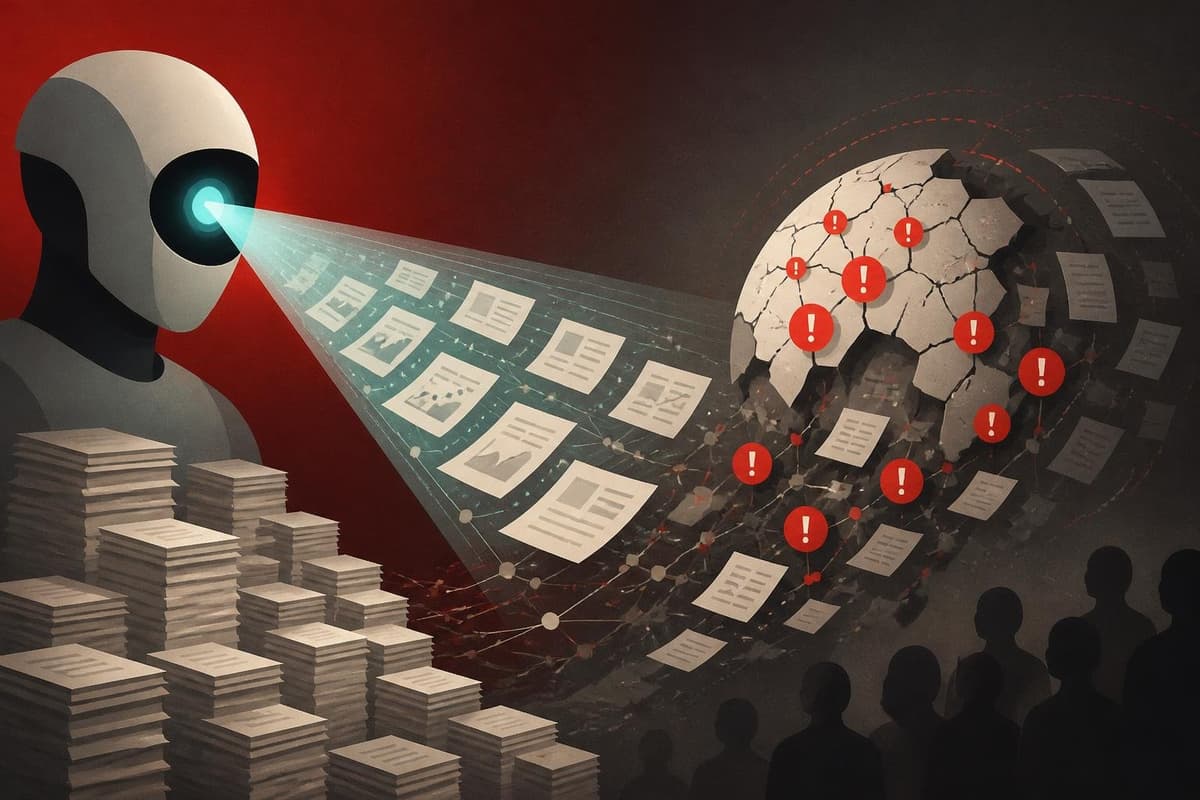
Một nghiên cứu sinh sau tiến sĩ tự kiểm tra lại cả một ngành khoa học bằng mô hình ngôn ngữ lớn. Kết quả không nằm ở chỗ AI viết được bài báo, mà ở chỗ nó chỉ ra bao nhiêu sai sót đang được truyền tay từ bài này sang bài khác.
Casey Handmer làm luận án tiến sĩ vật lý thiên văn lượng tử tại Caltech. Anh kể rằng trong 5 năm làm nghiên cứu, một phần thời gian dành cho việc xử lý những lỗi đã được biết đến trong tài liệu ngành.
Nền tảng cho các phương trình trong phần mềm của anh là bài báo năm 1997 của Bishop, Gómez, Lehner, Maharaj và Winicour. Nhiều người biết bài này có sai sót, nhưng cách sửa nằm rải rác trong khoảng 10.000 dòng email qua lại và mâu thuẫn nhau. Bản thân bài báo chưa bao giờ được đính chính.
Quy mô của dự án
Handmer lấy nhóm nghiên cứu TAPIR của Caltech, nơi anh làm nghiên cứu sinh, làm điểm xuất phát. Nhóm có 4.093 bài báo của 326 thành viên từ năm 2004. Cộng thêm mọi bài mà nhóm này trích dẫn và mọi bài trích dẫn nhóm này, anh có 158.059 bài báo nối với nhau bằng 554.670 trích dẫn.
Một bản đồ trực quan xếp các bài theo trục thời gian, mỗi đường mờ là một trích dẫn, các điểm sáng là những bài mà phần còn lại dựa vào nhiều nhất.
Cách phân loại theo tiểu ngành hình thành tự nhiên: các bài trích dẫn lẫn nhau sẽ kéo lại gần nhau, tạo thành các cột. Bản đồ có 32 cột như vậy, từ chớp vô tuyến nhanh đến quầng thiên hà Milky Way (Ngân Hà).
Lớp sàng lọc và lớp kiểm tra lại
Hai tầng kiểm tra có chi phí rất khác nhau.
Tầng thứ nhất sàng lọc toàn bộ văn bản lấy được: 50.269 bài, 421 triệu từ, chiếm 76% số bài trên bản đồ. Mục tiêu là tìm dấu hiệu của những vấn đề nghiêm trọng nhất. Kết quả: không có ngôn ngữ kiểu "nhà máy bài báo", không có dấu vết chatbot hay chỉ dẫn ẩn gửi cho người phản biện AI. Có 43 cặp bài chia sẻ văn bản mà không có tác giả chung, chủ yếu là các catalogue khảo sát và bản công bố dữ liệu nối tiếp.
Có 62 bài đưa lên arXiv còn sót ghi chú TODO và FIXME. Trong 184.733 bài có mã DOI, chỉ có 13 bài bị rút lại.
Tầng thứ hai đắt hơn nhiều: 200 bài được trích dẫn nhiều nhất của TAPIR giai đoạn 2006–2019, mỗi bài có một người phản biện AI riêng. Hệ thống nhận mã nguồn LaTeX, có công cụ tự tính toán, và được lệnh tính lại mọi thứ có thể. Nó làm việc mù, không xem được đính chính hay bài báo sau đó.
Kết quả: 2.623 vấn đề được đánh dấu, trong đó 112 vấn đề lớn. Sau khi một người phản biện thứ hai tính lại độc lập, 56 vấn đề được xác nhận là lỗi, 34 lỗi toàn phần và 22 lỗi một phần.
Sai số được sao chép nhiều hơn bị phê bình
Con số lớn hơn nằm ở bước mở rộng. Nhóm chạy cùng quy trình kiểm tra trên thêm 459 bài vẫn còn được trích dẫn, phần lớn là bài trích dẫn cao. Bước này xác nhận thêm 816 lỗi.
Tổng cộng là 872 lỗi trong 433 bài. Trong đó 159 lỗi bị sao chép, kèm cả giá trị sai, vào ít nhất một bài sau đó.
Tính theo số bài: 367 bài sao chép một lỗi, chỉ 68 bài phê bình một lỗi. Chỉ 47 trong 872 lỗi từng bị phê bình trên ấn phẩm, và 21 trong số đó vẫn tiếp tục bị sao chép sau đó, bởi thêm 51 bài khác.
Một ví dụ cụ thể: bài của Smith, Kamionkowski và Cooray về chuyển đổi sóng hấp dẫn còn lại từ lạm phát thành mật độ năng lượng. Bài bị mất hai hệ số một phần hai, nên kết quả lớn hơn bốn lần. Bản thân các số trong bài, đưa vào công thức chuẩn, chỉ cho ra một phần tư kết quả. Lỗi này bị sao chép 6 lần từ 2005 đến 2014. Năm 2008 có một bài phản đối. Việc sao chép vẫn tiếp tục thêm 6 năm.
Phản biện ngang chặn được khoảng một phần năm
Có 136 trong 200 bài nói trên được sửa đổi giữa bản preprint đầu tiên và bản trên tạp chí. Đọc lại các preprint đó theo cùng cách, nhóm tìm thấy 13 lỗi đã được sửa qua phản biện. 56 lỗi khác đi qua được khâu phản biện và nằm lại trên tạp chí. Như vậy, trên mẫu này, phản biện ngang loại bỏ khoảng một lỗi trong năm lỗi.
Lỗi còn sống bao lâu? Đường cong của nhóm cho thấy 52% số lỗi bị sao chép vẫn đang bị sao chép sau 7 năm. Tỷ lệ này về một nửa ở năm thứ 8, xuống 39% ở năm thứ 10.
Trong 56 lỗi thuộc 200 bài đọc kỹ nhất, 52 lỗi vẫn còn trong bản arXiv mới nhất, nơi việc sửa là miễn phí. Chỉ 2 trong 200 bài có ghi nhận đính chính trong cơ sở dữ liệu. Trong 87 lỗi đã biến mất, có 67 lỗi chưa từng bị ai phê bình.
Lý do chúng biến mất: tiểu ngành chuyển sang vấn đề khác, và những bài đúng với bài sai bị bỏ lại như nhau.
Giới hạn và chi phí
Handmer nói rõ đây là một phương pháp thế hệ đầu. Không có người nào kiểm tra lại từng lỗi được nêu. Mỗi lỗi do một phiên AI tìm ra và một phiên độc lập khác tính lại, xác nhận trên bản tạp chí. Năm lỗi được kiểm từng bước với nguồn.
Như một phép thử, 40 lỗi chọn ngẫu nhiên được đưa cho phiên thứ ba chỉ thấy bài báo và đoạn liên quan. Phiên này xác định 33 trong 40 trường hợp là sai, nghĩa là một số lỗi được nêu sẽ không đứng vững khi bị soi kỹ.
Phần kiểm tra tốn kém mới phủ 659 bài, chỉ khoảng 4% số bài được trích dẫn cao trên bản đồ. Từ tỷ lệ đó, nhóm ước tính số lỗi chưa phát hiện trong các bài của ngành được trích dẫn từ 100 lần trở lên vào khoảng 34.000, với khoảng tin cậy 25.000 đến 48.000.
Về chi phí: nếu mua theo giá niêm yết, toàn bộ công việc tốn khoảng 2.720 USD, tức khoảng 3 USD cho mỗi lỗi được xác nhận. Thực tế dự án chạy gọn trong một gói thuê bao Claude Max. Toàn bộ dự án tiêu tốn khoảng 4,9 tỷ token và khoảng 44 giờ làm việc của tác giả trong 41 ngày.
Góc nhìn
Với người làm kỹ thuật, giá trị thực tế của thử nghiệm này không nằm ở việc AI đúng hay sai trong từng trường hợp. Nó nằm ở chỗ chi phí đọc và tính lại toàn bộ một kho tri thức đã giảm xuống mức một cá nhân có thể tự chi trả.
Các nhóm phát triển phần mềm trong nước có tài liệu kỹ thuật, tài liệu thiết kế hệ thống hoặc quy trình nội bộ cũng gặp vấn đề tương tự. Một công thức sai, một cấu hình lỗi thời trong tài liệu nội bộ sẽ bị các dự án sau sao chép tiếp, và không ai được trả tiền để quay lại sửa gốc.
Quy trình trong bài đáng tham khảo: sàng lọc rộng bằng mô hình rẻ, chỉ dùng mô hình đắt cho phần quan trọng nhất, và luôn để một lượt kiểm tra độc lập xác nhận trước khi kết luận. Kết quả do AI tìm ra chỉ là tín hiệu để con người soi lại, không phải kết luận cuối cùng.
Nguồn: science.caseyhandmer.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Sự trỗi dậy của "rác thải khoa học" AI: Khi trí tuệ nhân tạo đe dọa sụp đổ hệ thống bình duyệt
15 tháng 5, 2026
Công nghệ
Đừng "thuê ngoài" quá trình học hỏi: Cạm bẫy của việc phụ thuộc quá mức vào AI khi viết code
17 tháng 5, 2026
Công nghệ
Tôi dùng AI để tạo một bài báo khoa học giả: Chuyện gì đã xảy ra?
29 tháng 10, 2026