Các phòng thí nghiệm AI không thực sự muốn 'kiềm chế biên giới' – họ chỉ đang đạp ga
Bài viết trên LessWrong lập luận rằng những tuyên bố về việc 'kiềm chế tốc độ phát triển AI' từ các phòng thí nghiệm hàng đầu chỉ là chiêu trò truyền thông nhắm vào nhân viên và công chúng, trong khi thực tế họ vẫn tăng tốc xây dựng AGI. Tác giả so sánh với câu chuyện đại sứ Schulenburg năm 1941 để cảnh báo: hãy nhìn vào hành động, đừng nghe lời nói.
Các phòng thí nghiệm AI không thực sự muốn "kiềm chế biên giới" – họ chỉ đang đạp ga
Trong bài viết mới nhất trên LessWrong, tác giả phân tích một cách gay gắt về những tuyên bố "kiềm chế tốc độ phát triển AI" từ các phòng thí nghiệm hàng đầu. Theo tác giả, đây chỉ là những thông điệp được thiết kế để trấn an nhân viên và công chúng, trong khi thực tế các lab vẫn đang tăng tốc hướng tới AGI mà không hề có dấu hiệu chậm lại.
"Kiềm chế biên giới" – khẩu hiệu hay hành động?
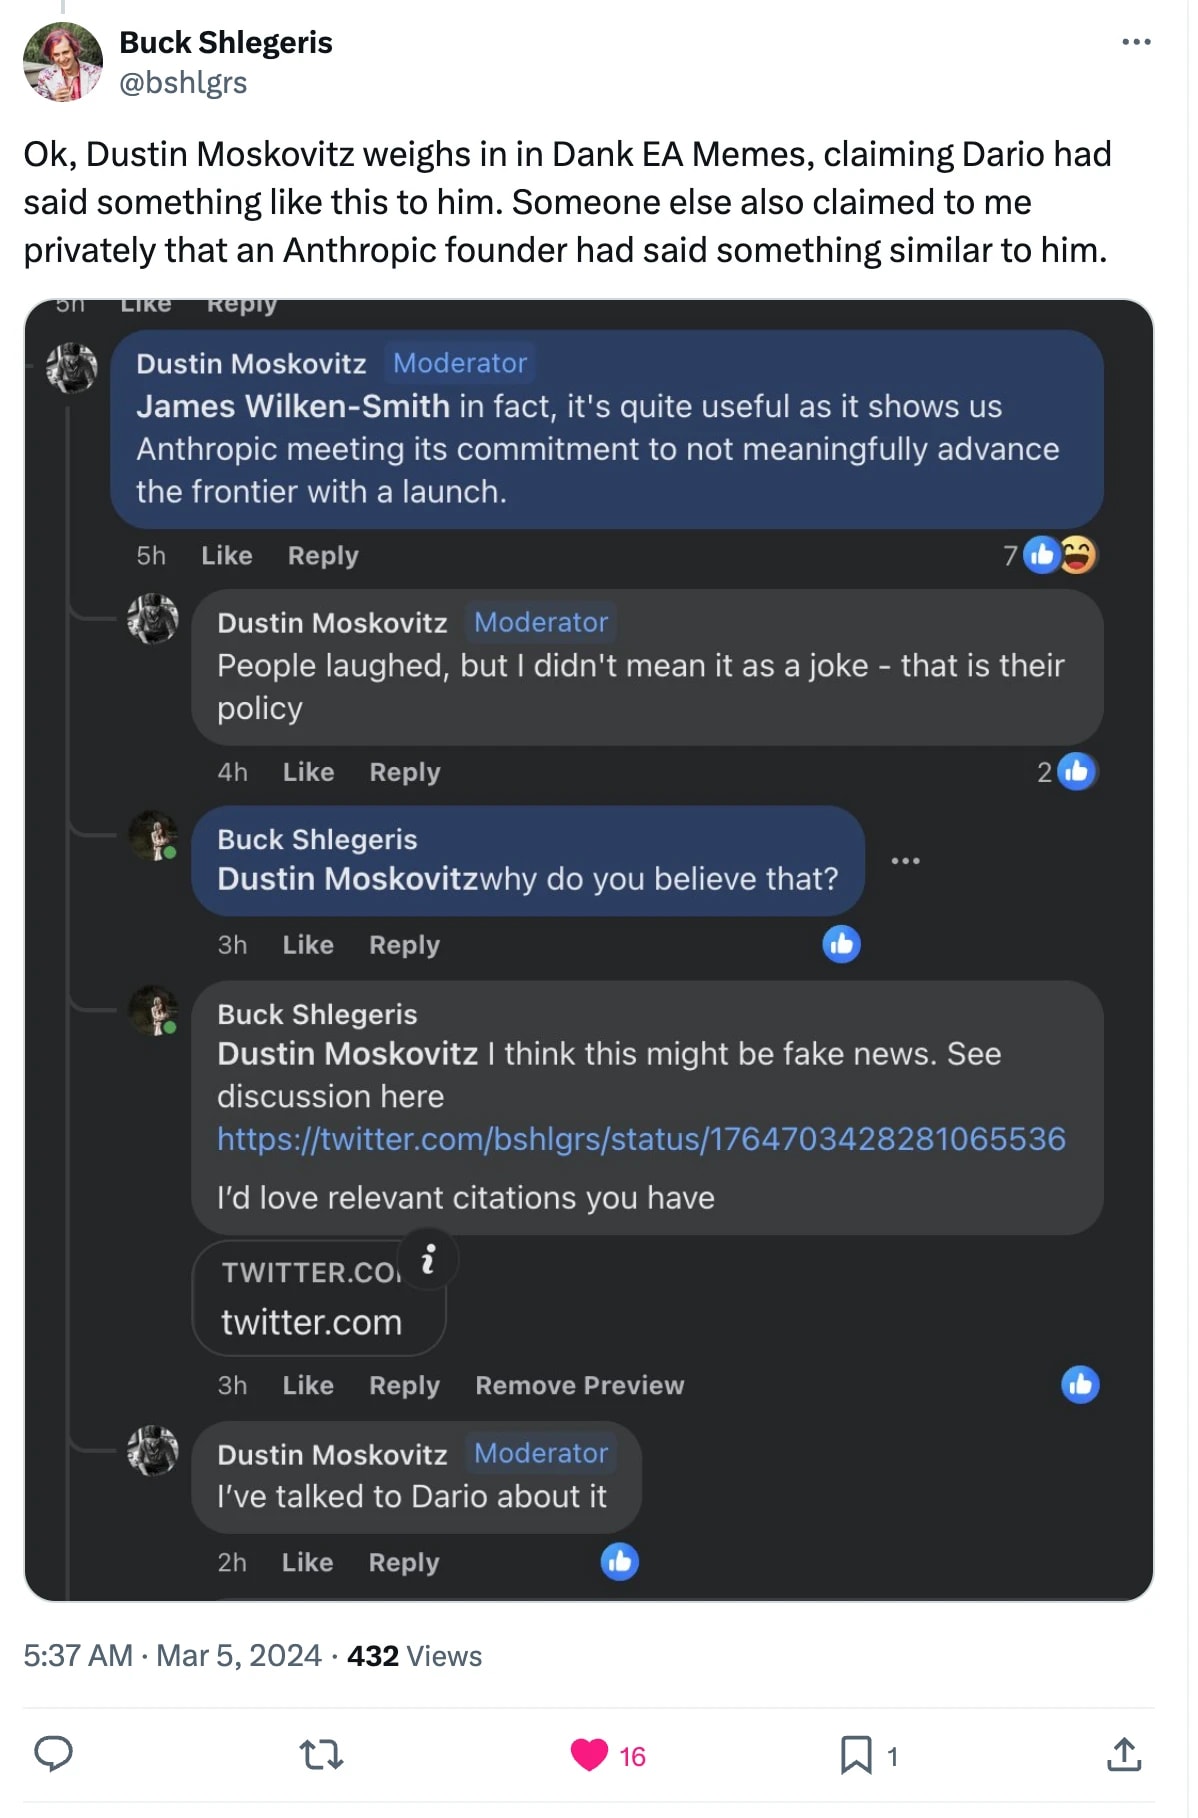
Dario Amodei, CEO của Anthropic, gần đây viết rằng ông đã "bị thuyết phục rằng việc giải quyết đầy đủ các rủi ro đòi hỏi sự thận trọng hơn nữa – không chỉ đầu tư vào phòng ngừa rủi ro, mà còn phải kiềm chế tốc độ tiến bộ của năng lực AI để công tác phòng ngừa có thời gian theo kịp".
Ông nêu hai lý do: thứ nhất, từ khoảng mùa hè năm nay, AI đang tiến bộ nhanh chóng nhờ khả năng tự cải thiện đệ quy (recursive self-improvement); thứ hai, nếu không kiểm soát, nó có thể vượt xa khả năng hiểu và kiểm soát của chúng ta.
Nghe có vẻ hợp lý. Nhưng tác giả bài viết chỉ ra một nghịch lý: kể từ khi tuyên bố CAIS 2023 được ký bởi chính các CEO này, họ gần như không làm gì giống với việc "kiềm chế biên giới". Thay vào đó, họ đạp ga.
"Mọi bằng chứng đều cho thấy họ đang theo đuổi RSI (tự cải thiện đệ quy) ngay khi nhìn thấy khả năng đó."
Sau khi mọi người đồng ý "kiềm chế biên giới", các lab vẫn tung ra thêm nhiều mô hình vượt qua các chỉ số SOTA trước đó, thậm chí bắt đầu con đường tự động hóa nghiên cứu sinh học. Những biện pháp an toàn nào được thực hiện ngoài "có con người trong vòng lặp" thì vẫn chưa rõ.
Một mô hình tư duy sai lầm
Tác giả cho rằng chúng ta đang mắc sai lầm khi cố gắng dung hòa những gì các lab nói công khai thành một niềm tin nhất quán. Thay vào đó, hãy nhìn vào hành động thực tế.
Ông kể câu chuyện lịch sử từ Eliezer Yudkowsky: Ngày 22 tháng 6 năm 1941, Đức xâm lược Liên Xô bất chấp Hiệp ước Molotov-Ribbentrop. Trước đó, đại sứ Đức Schulenburg liên tục trấn an Moscow rằng quan hệ hai nước vẫn tốt đẹp. Chỉ vài giờ trước cuộc tấn công, Schulenburg mới được thông báo về cuộc xâm lược.
"Sẽ là một sai lầm kỳ quặc nếu nghĩ rằng phần cơ quan của Đức nói chuyện với bạn – và có vẻ rất hòa giải – lại đang kiểm soát nước Đức lớn hơn đang hành động."
Bài học: Đừng nghe đại sứ nói gì. Hãy nhìn quân đội đang tiến sát biên giới.
Động lực thực sự của các CEO
Theo tác giả, các CEO của phòng thí nghiệm biên giới là những người được tự chọn lọc – những người chấp nhận rủi ro cao và tìm kiếm quyền lực. Họ nhìn thấy AGI như "cây đèn thần": thần đèn xuất hiện và ban cho họ ba điều ước.
Để xây dựng cây đèn đó, họ cần những kỹ sư ML giỏi nhất thế giới – những người mà họ phụ thuộc hoàn toàn. Và những kỹ sư này thường rất lo ngại về rủi ro tồn vong (x-risk).
Đây chính là mấu chốt: Các lab tuyên bố quan tâm đến an toàn để giữ chân nhân tài. Nếu không có một bộ phận lớn nhân viên thúc ép, họ sẽ không đưa ra bất kỳ lời thừa nhận công khai nào về rủi ro.
Tác giả dẫn chứng: Mark Zuckerberg đề nghị gói lương 300 triệu USD nhưng vẫn khó lôi kéo nhân tài khỏi các lab – vì nhân tài tin rằng các lab đang thận trọng hơn.
Nhiều "phần cơ quan" khác nhau
Một điểm thú vị trong bài viết là ý tưởng về "nhiều phần cơ quan" (appendages) của cùng một CEO:
- Một phần phát biểu trên podcast Dwarkesh, nhắm vào nhân viên hiện tại và tương lai, nói nhiều về rủi ro
- Một phần khác lên 60 Minutes, nhắm vào công chúng đại chúng, chỉ nói về lợi ích
- Một phần khác nói với nhà đầu tư về doanh thu 30 nghìn tỷ USD vào năm 2030
- Một phần khác nói rằng "tiền sẽ không còn quan trọng trong tương lai"
"Sẽ là sai lầm nếu cố gắng hiểu mục tiêu thực sự của họ bằng cách dung hòa những gì họ nói công khai thành một niềm tin nhất quán duy nhất."
Tác giả so sánh điều này với một chính trị gia gửi thông điệp trực giao đến các nhóm cử tri khác nhau để tối đa hóa phiếu bầu – không cần tạo ra một chính sách nhất quán nội bộ.
Điều gì sẽ xảy ra tiếp theo?
Tác giả đưa ra dự đoán cá nhân về kịch bản "AI-2027":
- Khi AI đủ giỏi để làm công việc năng lực AI, điều đó sẽ xảy ra theo mặc định mà không cần suy nghĩ về hậu quả
- Đòn bẩy của nhân viên sẽ biến mất – những người lo ngại sẽ bị thay thế bằng những người "gật đầu" nhiều hơn
- Giọng điệu của CEO sẽ thay đổi – tránh hoàn toàn các cuộc thảo luận về mất kiểm soát hoặc tuyệt chủng
- Không ai trong chính phủ đủ năng lực can thiệp khi GDP và thuế vẫn tăng
- Các lab sẽ tuyên bố "đã giải quyết được alignment" với chi tiết mơ hồ hoặc dài 500 trang không ai hiểu nổi
"Cây đèn thần là mục tiêu cuối cùng. Các CEO có thể đã tự thuyết phục rằng rủi ro 95% nếu ai khác làm sẽ thành 94% nếu chính họ làm AGI – vì họ an toàn hơn, thông minh hơn, hoặc có ý định tốt hơn."
Kết luận
Bài viết đưa ra một lời cảnh báo mạnh mẽ: hãy đánh giá các phòng thí nghiệm AI qua hành động, không phải lời nói. Giống như việc nhìn quân đội Đức tiến sát biên giới thay vì tin lời đại sứ Schulenburg.
Nếu các lab được phép tự quản lý hoặc tham gia viết luật, tác giả dự đoán sẽ có đủ "lỗ hổng" để họ tiếp tục chạy đua hết tốc lực, trong khi chính phủ chỉ giám sát những vấn đề không liên quan như mã hóa dữ liệu người dùng.
Đối với độc giả Việt Nam quan tâm đến AI, đây là một lời nhắc nhở quan trọng: đừng để những tuyên bố về "an toàn AI" ru ngủ. Khi các công ty công nghệ lớn nói về trách nhiệm, hãy nhìn vào sản phẩm họ tung ra và tốc độ họ phát triển – đó mới là sự thật.