Các tác nhân LLM thi đấu Pokémon: Khi AI học cách phối hợp với đồng đội
Một nghiên cứu mới xây dựng môi trường đấu Pokémon Showdown 2v2 để đo khả năng phối hợp của các tác nhân LLM. Kết quả cho thấy các đội AI được tự do trò chuyện giành tỷ lệ thắng 64% so với 42% khi không thể giao tiếp, nhưng cái giá phải trả là lượng token tiêu thụ tăng gần gấp bốn lần.
Các tác nhân LLM thi đấu Pokémon: Khi AI học cách phối hợp với đồng đội
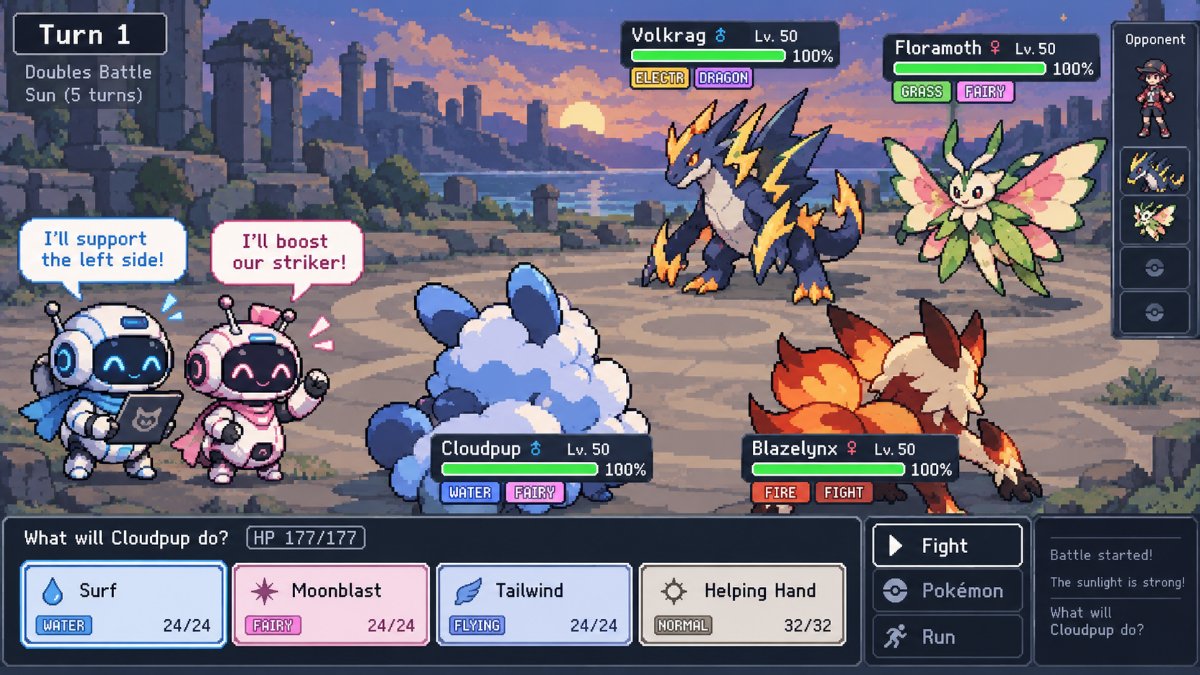
 Minh họa các tác nhân LLM phối hợp trong trận đấu Pokémon
Trong bối cảnh các mô hình ngôn ngữ lớn ngày càng được triển khai theo nhóm, câu hỏi đặt ra là liệu chúng có thực sự biết hợp tác hay không. Một nghiên cứu mới của Oliver Grabner đã dùng đấu trường Pokémon Showdown 2v2 để kiểm tra chính xác điều này.
Kết quả khá bất ngờ: những đội AI được phép trò chuyện tự do với nhau giành chiến thắng 64% số trận trước một bot tối ưu sát thương, trong khi đội không thể nói chuyện chỉ thắng 42%. Nhưng khả năng giao tiếp ấy cũng khiến lượng token tiêu thụ tăng vọt gần bốn lần.
Vì sao lại là Pokémon?
Đấu Pokémon đôi (doubles) là một môi trường lý thuyết trò chơi thiếu thông tin hoàn hảo. Bộ kỹ năng của đối thủ bị ẩn, sát thương có yếu tố ngẫu nhiên, nên muốn thắng thì phải có chiến thuật thực sự: đọc bài của đối phương, chia mục tiêu và tính toán phối hợp cùng đồng đội.
Nghiên cứu trước đây như PokéAgent Challenge đã đánh giá khả năng thi đấu Pokémon, nhưng mỗi bên chỉ do một tác nhân duy nhất điều khiển và các tác nhân học tăng cường chuyên biệt vẫn vượt trội hơn LLM đa dụng. Điều đó không kiểm tra được khả năng phối hợp giữa các đồng đội.
Mục tiêu là tạo ra một môi trường có kiểm soát để đo cách các tác nhân LLM phối hợp, và sau đó có thể dùng để huấn luyện chúng bằng học tăng cường nhằm khuyến khích các hành vi hợp tác.
Phương pháp thực hiện
Nhóm nghiên cứu dùng chính trình giả lập Pokémon Showdown chính thức, đóng gói thành môi trường kiểu Gym. Bốn người chơi, mỗi người điều khiển một Pokémon trong đội ba con, hai con mỗi bên.
Mỗi lượt, tác nhân đọc một bản tóm tắt trận đấu bằng ngôn ngữ tự nhiên và danh sách các nước đi hợp lệ được đánh số. Nó có thể gửi tin nhắn riêng cho đồng đội hoặc chọn nước đi, và khi đã chọn thì đồng đội sẽ được thông báo về lựa chọn đó.
Thử nghiệm so sánh bốn chế độ giao tiếp:
- Trò chuyện tự do: hai tác nhân tiếp tục trao đổi cho đến khi cả hai đã chọn xong nước đi
- Mỗi bên một tin nhắn: giới hạn đúng một lượt trao đổi
- Không trò chuyện: mỗi tác nhân tự quyết định
- Một mô hình điều khiển cả hai: một LLM duy nhất ra quyết định cho cả hai Pokémon
Mô hình Qwen3.8-27B đảm nhận vai trò cả hai đồng đội, đối đầu với một bot kịch bản tối ưu sát thương. Các trận đấu được gieo hạt cố định và mỗi cặp đội hình đều được chơi từ cả hai phía để đảm bảo tính công bằng giữa các chế độ.
Kết quả: nói chuyện có ích, nhưng tốn kém
| Chế độ | Tỷ lệ thắng | Token mỗi trận |
|---|---|---|
| Trò chuyện tự do | 64% | 978k |
| Một mô hình điều khiển cả hai | 54% | 450k |
| Mỗi bên một tin nhắn | 52% | 654k |
| Không trò chuyện | 42% | 259k |
Có thể thấy rõ giao tiếp tạo ra khác biệt. Đội được trò chuyện tự do thắng 64% số trận, cao hơn hẳn mức 42% của đội câm lặng. Ngay cả một tin nhắn mỗi bên (52%) cũng đã tốt hơn không nói gì.
Đáng chú ý là phương án một mô hình điều khiển cả hai Pokémon chỉ đạt 54%, tốt hơn không trò chuyện nhưng vẫn kém xa hai tác nhân trò chuyện tự do. Điều này cho thấy lợi ích đến từ chính cuộc hội thoại, chứ không chỉ từ việc một bộ óc lập kế hoạch cho cả hai nước đi.
Tuy nhiên, giao tiếp cũng có cái giá của nó. Chế độ trò chuyện tự do tiêu tốn 978k token mỗi trận, gấp 3,8 lần so với 259k của chế độ không nói chuyện, bởi mỗi tin nhắn đồng nghĩa với một lần gọi mô hình phải đọc lại toàn bộ trận đấu và lịch sử hội thoại.
Môi trường có phân biệt được năng lực mô hình?
Nhóm nghiên cứu cũng kiểm tra xem môi trường có đủ độ nhạy để phân biệt các mô hình hay không. Một đội Qwen3.8-27B trò chuyện tự do thắng tới 96% khi đối đầu với đội mô hình 2B, 74% trước đội 9B, và 64% trước bot tối ưu sát thương.
Đối thủ càng mạnh thì trận đấu càng sát nút, điều này khiến môi trường trở nên hữu ích như một bộ đánh giá chuẩn (benchmark) để so sánh các mô hình khác nhau.
Hướng phát triển tiếp theo
Tác giả đang tách bạch tác động của việc trò chuyện và tác động của việc nhìn thấy nước đi đồng đội chọn. Song song đó, nghiên cứu hướng tới việc biến môi trường này thành một benchmark có bảng xếp hạng giữa các mô hình, đồng thời dùng nó cho huấn luyện học tăng cường nhằm khuyến khích các hành vi hợp tác.
Các thử nghiệm được chạy trên cụm máy chủ Grace của Đại học Texas A&M, dưới sự hướng dẫn của Maria Teleki và Giáo sư James Caverlee.
Với cộng đồng AI tại Việt Nam, hướng nghiên cứu này đáng chú ý bởi nó tiếp cận được một câu hỏi rất thực tế: khi các hệ thống AI ngày càng được triển khai dưới dạng nhiều tác nhân phối hợp, làm sao để chúng giao tiếp hiệu quả mà không đốt quá nhiều chi phí suy luận. Môi trường mô phỏng nhẹ và mã nguồn mở như thế này cũng là bài tập tốt cho các nhóm nghiên cứu muốn tự xây dựng harness đánh giá tác nhân của riêng mình.