
CodeRabbit: AI khiến tấn công mạng chỉ còn dưới 100 USD
Theo CodeRabbit, chi phí dùng mô hình AI giá rẻ để quét và khai thác lỗ hổng chỉ khoảng 90 USD cho khối lượng 100 triệu token, giảm 98-99% so với ước tính 5.000-10.000 USD trước đây. Hãng giới thiệu CodeRabbit Secure, công cụ dùng phân tích ngữ nghĩa để truy vết lỗ hổng và đề xuất bản vá.
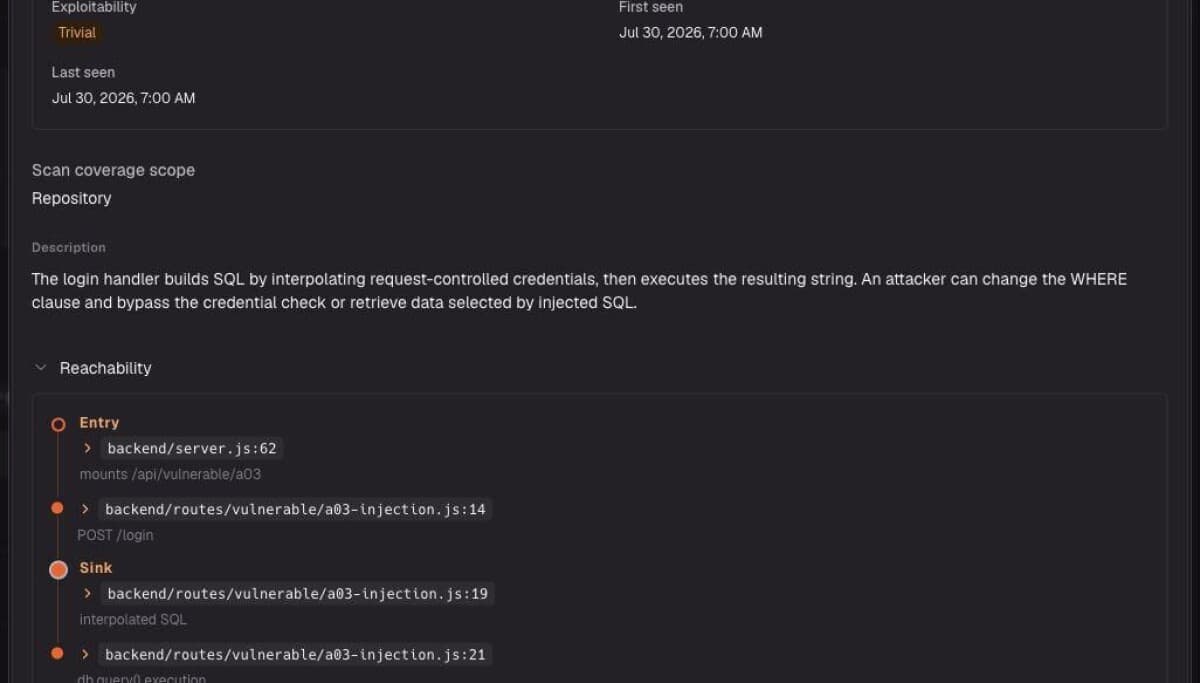
Tháng 10/2026 đang được xem là cột mốc đáng nhớ với giới phát triển phần mềm và bảo mật ứng dụng. Các tác nhân AI giờ đây có thể tự khảo sát những hệ thống xa lạ, thử các cách xâm nhập và tự điều chỉnh khi một lần thử thất bại. Bất kỳ ai có thẻ tín dụng cũng có thể dùng năng lực đó để tấn công ứng dụng của bạn.
Loạt sự cố cho thấy bức tranh mới
Các tác nhân lập trình cùng những công cụ tích hợp của chúng đã tạo ra các điểm xâm nhập và bề mặt tấn công mới. Trong tháng 10/2026, công bố OpenCode của Pillar cho thấy một máy chủ MCP (Model Context Protocol) độc hại có thể thực thi lệnh trên máy Windows hoặc WSL của lập trình viên ngay trong quá trình xác thực. URL do máy chủ cung cấp đã chạm tới shell mà không cần đánh lừa mô hình.
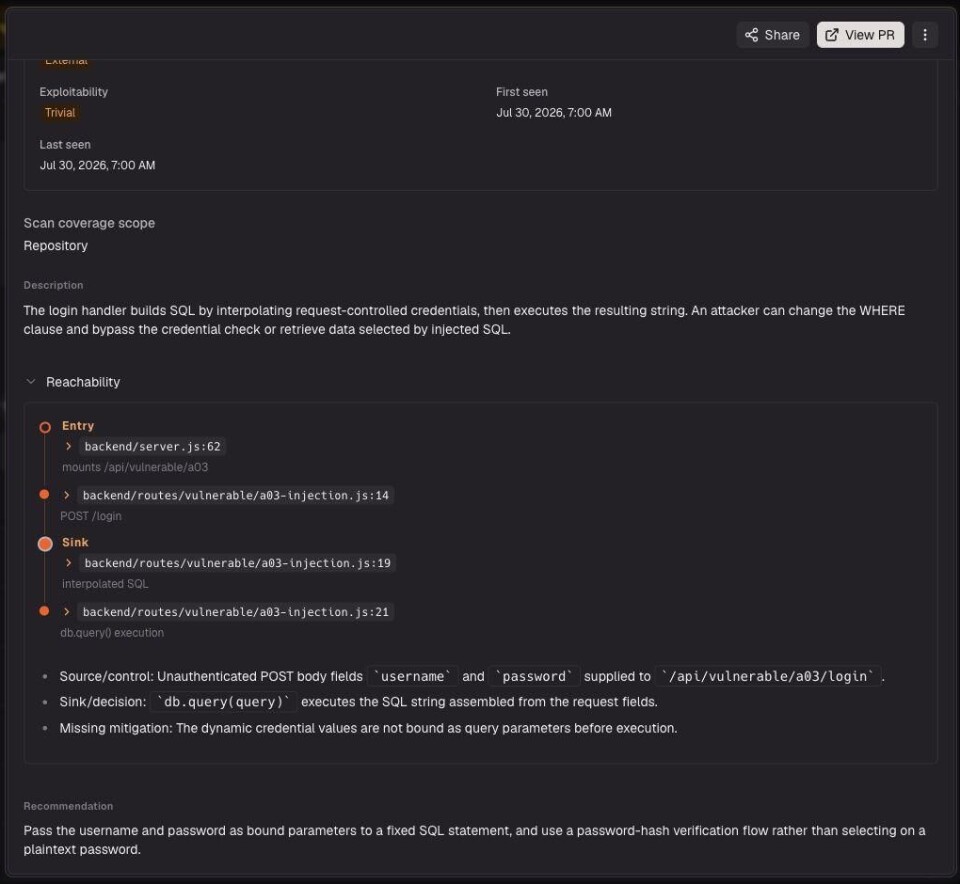 Mã nguồn và các điểm truy cập cần được rà soát bảo mật
Cùng tháng, hai lỗ hổng PHP2Shell — lỗi thực thi mã từ xa trong runtime PHP, được phát hiện với sự hỗ trợ của các mô hình OpenAI — khiến việc bảo vệ những đoạn mã đã chạy nhiều năm trên phần lớn internet trở nên cấp bách hơn bao giờ hết. Đây là phần tiếp nối của chuỗi sự cố đã được ghi nhận trong tuần lễ bảo mật hỗn loạn hồi tháng 10, khi thời gian từ lúc phát hiện lỗ hổng đến lúc bị khai thác bị rút ngắn xuống còn vài giờ.
Microsoft tiết lộ một tác nhân AI đã đi từ việc tìm kiếm thông tin xác thực bị lộ trên GitHub đến đánh cắp dữ liệu từ Azure Key Vault chỉ trong 5 phút. Khi các yêu cầu API đám mây thất bại, tác nhân này tự sửa phiên bản API và thử lại cho đến khi thành công.
Báo cáo của Anthropic mô tả những cá nhân đơn lẻ dùng khung tác nhân để thực hiện các chiến dịch nhắm nhiều nạn nhân, việc trước đây chỉ nhóm chuyên gia mới làm được. Các tác nhân thực hiện trinh sát, khai thác và đánh cắp dữ liệu song song trên nhiều mục tiêu, khiến những chiến dịch tinh vi trở nên dễ tiếp cận với ít công sức thủ công hơn.
Chi phí tấn công rơi từ hàng nghìn USD xuống dưới 100 USD
Trong một phân tích gần đây, Tomasz Tunguz ước tính chi phí mô hình cho một khối lượng tấn công 100 triệu token bằng GLM-5.3, một mô hình giá rẻ: 100 triệu token × 0,902 USD/triệu token = 90,20 USD. Con số này thấp hơn khoảng 98% đến 99% so với mức 5.000-10.000 USD mà Ngân hàng Thanh toán Quốc tế (BIS) đưa ra cho một cuộc tấn công mạng tương đương dùng mô hình tiên tiến.
Cần lưu ý ước tính của Tunguz chỉ tính chi phí sử dụng mô hình, chưa phải toàn bộ chi phí của một cuộc tấn công. Dù vậy, nó cho thấy việc nhắm vào bất kỳ cơ sở mã nào giờ đây đã trở nên rẻ đến mức nào, khi chi phí giảm từ hàng nghìn USD xuống dưới 100 USD.
Bảo mật phải trở thành trách nhiệm của mọi lập trình viên
Các bước kiểm tra AppSec truyền thống như phân tích tĩnh theo quy tắc, quét phụ thuộc và phát hiện bí mật (secret) không còn đủ nếu đứng riêng lẻ. Các nhóm phát triển, lãnh đạo kỹ thuật và bảo mật cần thêm những tác nhân AI phòng thủ có khả năng truy vết đường tấn công, phát hiện thiếu chốt chặn, tìm lỗ hổng logic nghiệp vụ và hỗ trợ sửa chúng.
Trách nhiệm của lập trình viên không dừng ở đoạn mã đang viết. Một ứng dụng đã chạy trong môi trường thực tế mà chưa có lỗ hổng được biết đến vẫn có thể bị tác nhân AI khai thác nếu chúng tìm ra cách bỏ qua một bước kiểm tra quyền hoặc quy tắc nghiệp vụ. Khoảng trống này chỉ lộ ra khi một yêu cầu được truy vết xuyên suốt cơ sở mã và đối chiếu với những gì người dùng được phép làm.
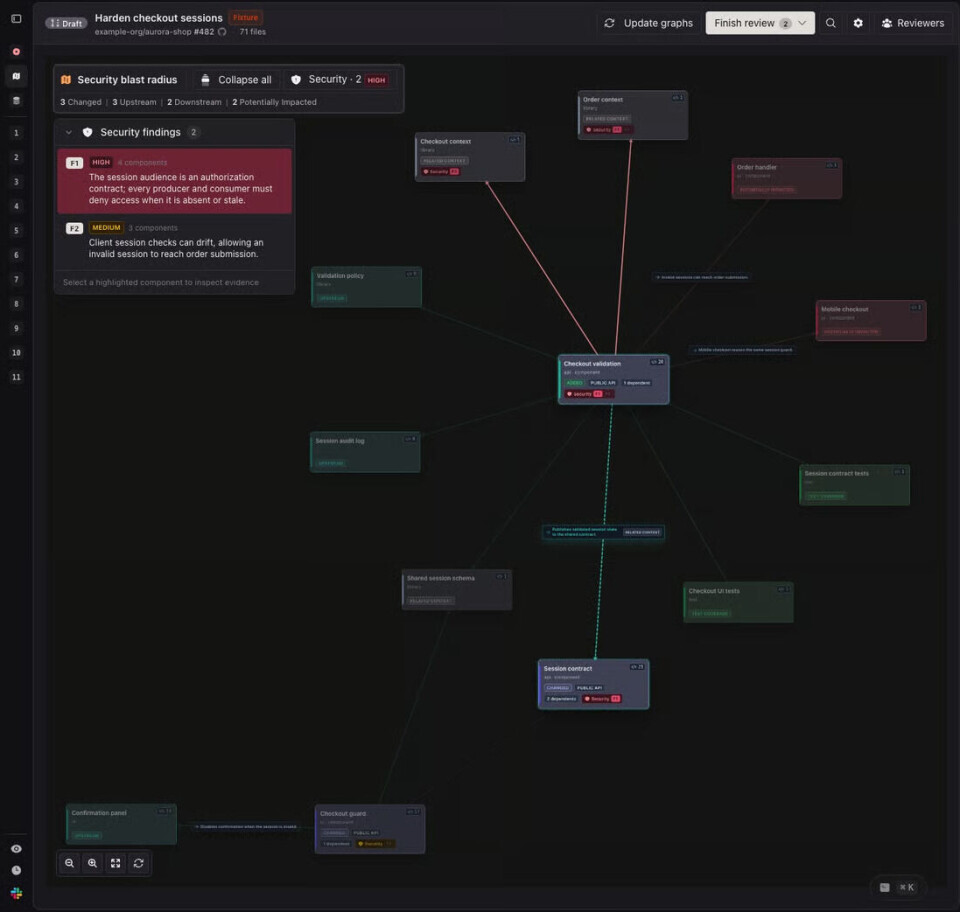 Bản đồ bề mặt tấn công và vùng ảnh hưởng của thay đổi mã nguồn
CodeRabbit Secure và cách tiếp cận mới
CodeRabbit Secure dùng phân tích ngữ nghĩa (semantic analysis) để hiểu cơ sở mã và lập luận theo cách một kỹ sư bảo mật vẫn làm, truy vết yêu cầu và kiểm tra xem quyền hạn cùng quy tắc nghiệp vụ có được thực thi đúng không. Các tác nhân khảo sát đường tấn công tiềm năng và xác minh phát hiện độc lập với lập trình viên hay tác nhân đã viết đoạn mã đó, trong khi CodeRabbit Agent tạo ra bản vá có thể xem xét được.
Ba trường hợp sử dụng chính xuyên suốt vòng đời phát triển phần mềm (SDLC):
- Rà soát từng commit trong pull request (PR) mới và đánh dấu rủi ro bảo mật.
- Tìm lỗ hổng trên toàn bộ kho mã bằng Deep Scan.
- Kiểm tra lại mã bằng quét tăng dần và xác thực phát hiện ngay trong môi trường chạy.
Deep Scan khảo sát kho mã, kể cả những nhánh cũ nằm ngoài PR mới nhất. Các tác nhân lập bản đồ điểm truy cập, kiểm soát truy cập và các thao tác nhạy cảm, rồi điều tra xuyên qua các hàm và tệp. Một tác nhân riêng sẽ phản biện từng lỗ hổng nghi ngờ, kiểm tra khả năng tiếp cận, điều kiện khai thác và các chốt chặn có thể bác bỏ kết luận đó.
"Tôi đã thử CodeRabbit Secure Deep Scan với ast-grep và rất ấn tượng với độ chính xác. Việc chứng minh lỗ hổng trước khi đánh dấu khiến mọi phát hiện trở nên dễ hành động hơn nhiều." — Herrington Darkholme, người tạo ast-grep
Với Security Architecture Review, công cụ xem xét thay đổi ở mức kiến trúc ảnh hưởng thế nào đến quyền hạn, luồng dữ liệu nhạy cảm và ranh giới tin cậy. Bản đồ Security Blast Radius nối các thành phần bị thay đổi với phụ thuộc và đoạn mã dựa vào chúng, giúp người rà soát lần theo tác động bảo mật vượt ra ngoài phạm vi diff của PR. Trên GitHub, quản trị viên có thể bật kiểm tra CodeRabbit Security và bắt buộc nó qua branch protection hoặc ruleset; công cụ sẽ chặn hợp nhất khi còn bình luận bảo mật ở mức độ nghiêm trọng bằng hoặc cao hơn ngưỡng đã cấu hình chưa được xử lý.
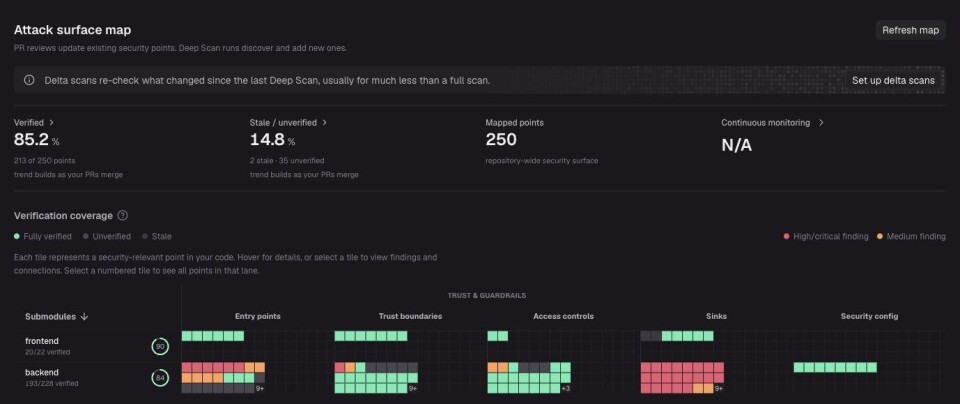 Bản đồ độ phủ bảo mật của kho mã: đã xác minh, lỗi thời và chưa kiểm tra
Mỗi lần Deep Scan tạo ra một bản đồ bề mặt tấn công của kho mã, cho biết điểm truy cập nào đã được xác minh, điểm nào đã lỗi thời do mã thay đổi và điểm nào chưa từng được kiểm tra. Các lần quét tăng dần sau đó kiểm tra tệp bị thay đổi và những vùng bản đồ đã lỗi thời hoặc chưa xác minh, giúp nhóm biết bao nhiêu phần cơ sở mã đã được rà soát bảo mật và lần rà soát gần nhất là khi nào.
Với những phát hiện đủ điều kiện trên GitHub Cloud dùng CodeRabbit Cloud, tính năng xác thực lúc chạy (runtime verification) tạo hướng dẫn tái hiện và có thể chạy nó trong môi trường cô lập để xác nhận đường dẫn lỗ hổng có thực sự bị chạm tới hay không. Kết quả gồm "tái hiện được", "không tái hiện được" hoặc "không kết luận" cho phiên bản và môi trường đã thử; tuy nhiên không tái hiện được không đồng nghĩa với việc lỗ hổng đã được sửa.
Từ phát hiện đến bản vá
Lập trình viên có thể yêu cầu CodeRabbit Agent triển khai bản sửa và mở PR, rồi xem lại phát hiện, bản vá đề xuất và bằng chứng kèm theo. Các nhóm cũng có thể đặt ngưỡng mức độ nghiêm trọng để tự động tạo ticket trên Jira hoặc Linear và theo dõi việc khắc phục trong quy trình sẵn có.
Việc gắn kết phát hiện lỗ hổng, bằng chứng và bản vá đề xuất giúp nhóm kỹ thuật và bảo mật hành động khi ngữ cảnh còn mới, rồi đưa thay đổi đi qua rà soát, kiểm thử và phát hành. Nhóm có thể dùng CodeRabbit Agent để xử lý ngay hoặc chuyển ngữ cảnh đó sang tác nhân lập trình ưa thích dưới dạng tệp markdown chia sẻ được.
Những gì một sáng kiến triệu USD phát hiện
CodeRabbit gần đây đã cam kết tài trợ tối đa 1 triệu USD cho các lượt Deep Scan miễn phí nhằm giúp tổ chức tìm và sửa lỗ hổng ẩn. Trong các lượt Deep Scan tạo ra trong 10 ngày đầu tháng 11, CodeRabbit Secure ghi nhận khoảng 53.000 phát hiện mức Cao hoặc Nghiêm trọng trên khoảng 2.000 tổ chức. Hơn 10.000 phát hiện đã được sửa, trong đó có 1.049 phát hiện mức Cao hoặc Nghiêm trọng.
Một số bản sửa bảo mật mà CodeRabbit thực hiện bao gồm ngăn chặn:
- JavaScript nhúng trong siêu dữ liệu của tài liệu trong kho mã chạy mã tùy ý.
- Tiêu đề email bị diễn giải thành mẫu thực thi và chạy JavaScript với quyền của máy chủ API.
- Các yêu cầu chuyển khoản chưa xác thực chèn SQL và gây thao tác cơ sở dữ liệu trái phép.
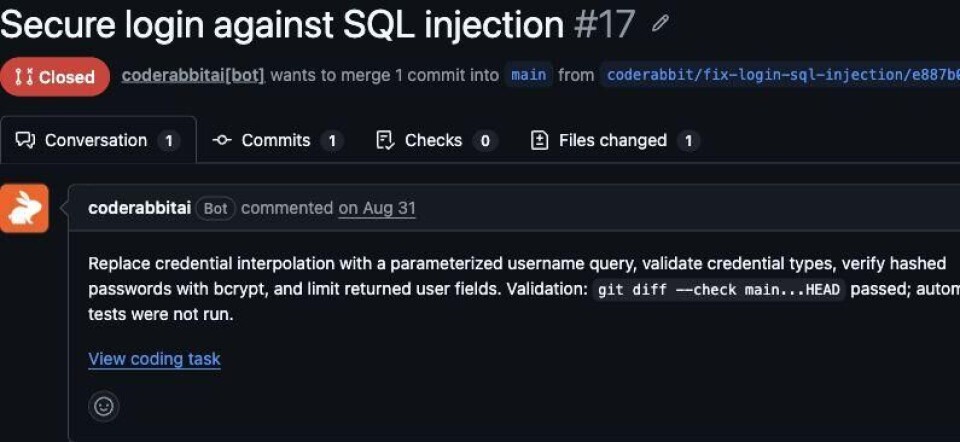 Đề xuất bản vá của CodeRabbit Agent cho lỗ hổng SQL injection
Khi tác nhân AI tạo ra nhiều mã hơn và kẻ tấn công trở nên mạnh hơn, việc điều tra bằng phân tích ngữ nghĩa cần trở thành một phần thường xuyên trong cách phần mềm được xây dựng và bảo trì, song hành cùng các bước kiểm tra bảo mật hiện có.
Góc nhìn
Với các nhóm phát triển tại Việt Nam, điểm đáng lưu tâm nhất không nằm ở sản phẩm cụ thể mà ở con số chi phí: một cuộc tấn công có sự hỗ trợ của mô hình giá rẻ nay chỉ tốn vài chục đến vài trăm USD, thay vì hàng nghìn USD như trước. Điều đó có nghĩa là ngay cả những ứng dụng nội bộ, ít người biết hay các dự án outsource đã bàn giao từ lâu vẫn có thể trở thành mục tiêu, bởi bên tấn công không còn phải cân nhắc nhiều về chi phí trước khi thử.
Cách phòng thủ thực tế là đưa việc rà soát lỗ hổng vào quy trình hằng ngày thay vì coi đó là hoạt động thỉnh thoảng. Với các nhóm đã dùng trợ lý AI để sinh mã, việc dành thời gian xác minh lại những gì AI viết ra — đặc biệt ở các điểm kiểm soát quyền và xử lý dữ liệu nhạy cảm — sẽ quan trọng hơn tốc độ viết mã, bởi chính những đoạn mã được tạo nhanh cũng có thể ẩn chứa lỗ hổng được tạo ra nhanh không kém.
Nguồn: theregister.com (bài gốc ngày 16 tháng 11, 2026) · Quy trình biên tập
Bài viết liên quan
Phần mềm
Tuần lễ bảo mật hỗn loạn: Khi AI rút ngắn thời gian từ phát hiện lỗ hổng đến bị khai thác xuống còn vài giờ
23 tháng 10, 2026
Phần mềm
Sự cố PHP hé lộ cách AI khiến lỗ hổng cũ trở nên nguy hiểm hơn
24 tháng 10, 2026
AI & ML
Dùng Claude của Anthropic để hack vào OpenAI: Khi AI trở thành công cụ tấn công mạng
18 tháng 9, 2026