
Độ lệch và Độ nhọn: Từ Moment đến Học máy
Bài viết đi sâu vào hai khái niệm thống kê quan trọng bậc nhất trong phân tích dữ liệu: độ lệch (skewness) và độ nhọn (kurtosis). Từ nền tảng về quần thể và mẫu, moment trung tâm, đến cách chuẩn hóa để tạo ra các thước đo bất biến theo đơn vị, tác giả giải thích trực quan vì sao hai chỉ số này lại đóng vai trò then chốt trong phân tích khám phá dữ liệu (EDA) và tiền xử lý cho các mô hình học máy.
Trong thế giới học máy và khoa học dữ liệu, chúng ta thường quen thuộc với giá trị trung bình và phương sai. Nhưng đó mới chỉ là phần nổi của tảng băng. Hình dạng thực sự của một phân phối dữ liệu — đặc biệt là độ lệch (skewness) và độ nhọn (kurtosis) — mới là thứ quyết định rất nhiều đến chất lượng mô hình và quyết định phân tích.
Bài viết dưới đây tổng hợp và diễn giải lại nội dung chuyên sâu về hai khái niệm này, từ nền tảng lý thuyết cho đến ứng dụng thực tiễn.
Vì sao phải hiểu quần thể và mẫu trước tiên?
Hãy tưởng tượng câu hỏi: "Tôi muốn biết điểm trung bình môn của tất cả học sinh lớp 12 khối tự nhiên trên toàn Việt Nam". Ai sẽ đi từng trường, từng huyện, từng tỉnh để thu thập? Gần như bất khả thi.
Giải pháp nằm ở một khái niệm nền tảng của thống kê: quần thể (population) và mẫu (sample). Kích thước quần thể ký hiệu là N, kích thước mẫu ký hiệu là n.
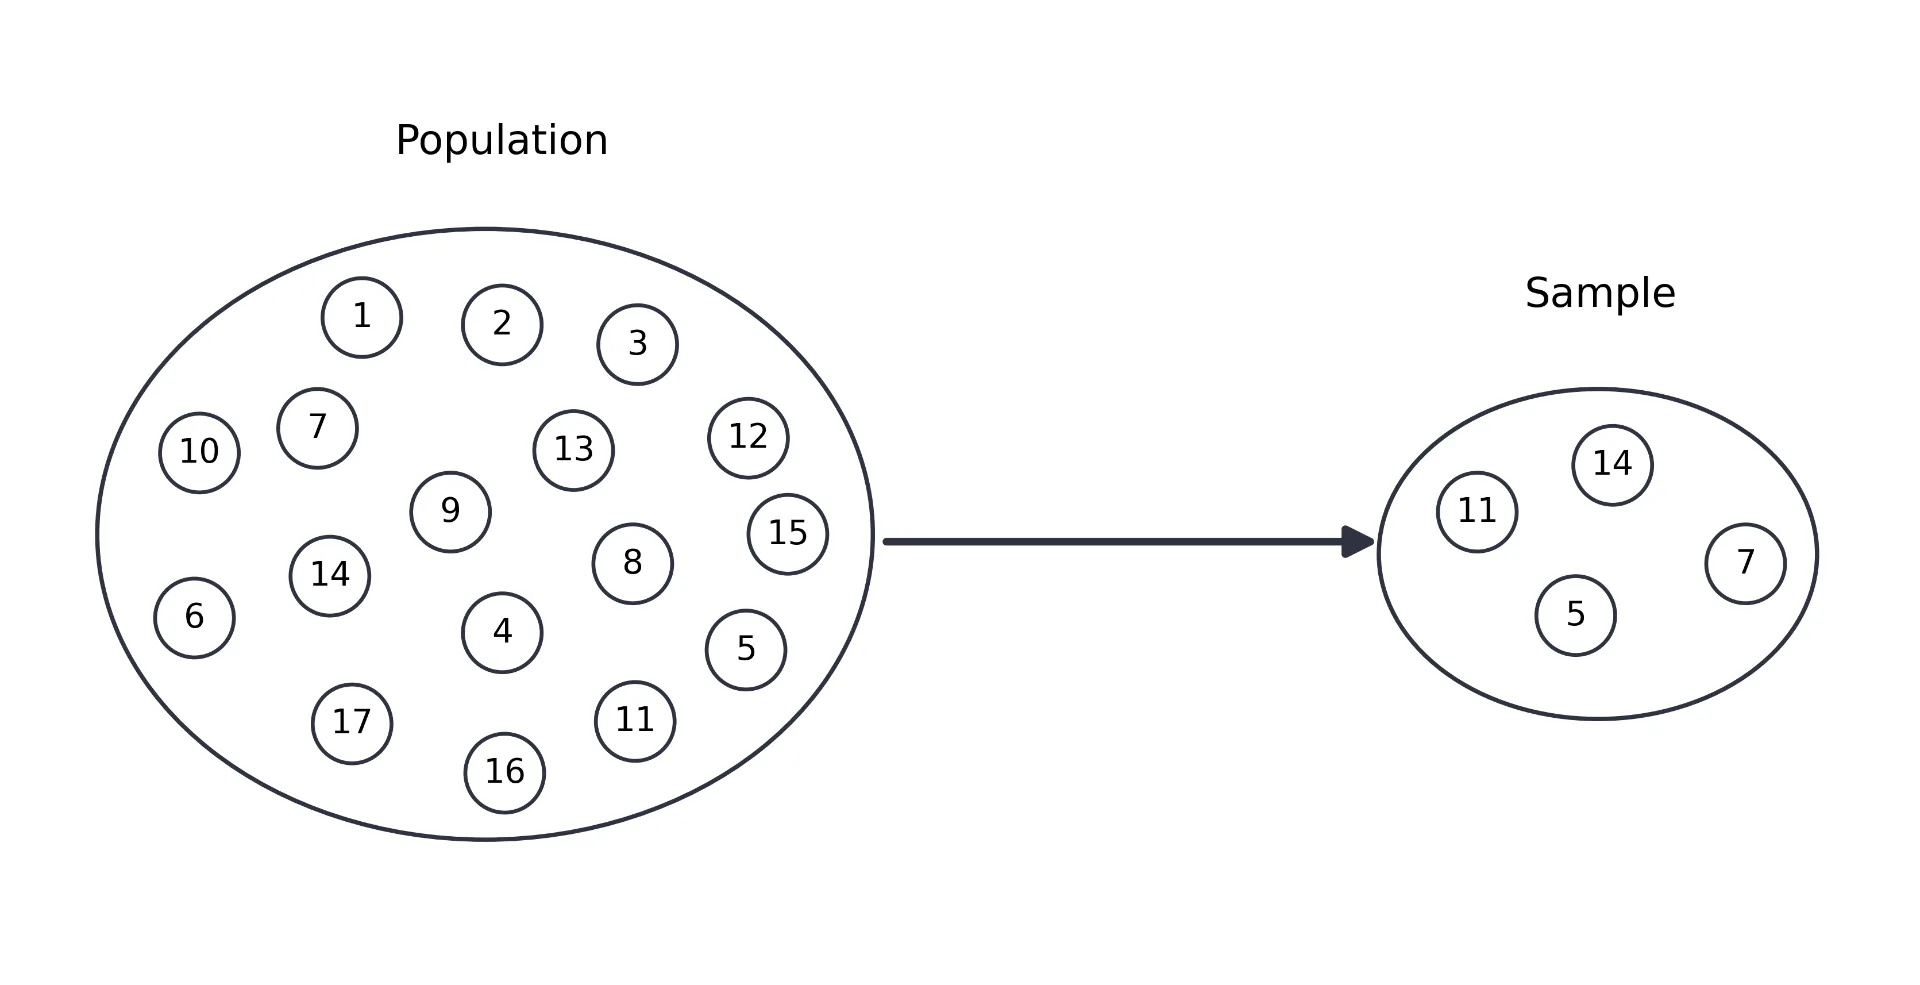 Minh họa phân biệt giữa quần thể và mẫu trong thống kê
Điều kiện tiên quyết khi lấy mẫu: nó phải đại diện cho quần thể và không tạo ra sai lệch hệ thống. Nếu chỉ chọn học sinh đạt 90% trở lên, điểm trung bình chắc chắn sẽ cao vô lý. Nhưng khi lấy đủ dải điểm từ thấp đến cao, kết quả sẽ tiến gần đến giá trị thực của quần thể.
Vì sao chia cho n−1 và khái niệm bậc tự do
Một câu hỏi kinh điển: khi tính phương sai mẫu, tại sao lại chia cho (n−1) thay vì n?
Lý do gốc rễ nằm ở một sự thật đẹp về toán học: tổng các độ lệch so với trung bình luôn bằng 0:
Σᵢ₌₁ⁿ (xᵢ − x̄) = 0
Giả sử ta có ba độ lệch: −2, 0 và ?. Giá trị thứ ba bắt buộc phải là +2 để tổng bằng 0. Nói cách khác, trong n độ lệch, chỉ n−1 giá trị có thể biến đổi tự do — đây chính là trực giác đầu tiên về bậc tự do (degrees of freedom).
Điểm thứ hai tinh tế hơn: khi tính phương sai mẫu, ta dùng trung bình mẫu thay cho trung bình quần thể. Nếu chia cho n, ước lượng sẽ có xu hướng nhỏ hơn giá trị thực một cách hệ thống. Chia cho n−1 khử đúng sai lệch này và cho ra ước lượng không chệch (unbiased).
Moment: các viên gạch tạo nên hình dạng phân phối
Trước khi đến skewness và kurtosis, cần nắm moment trung tâm (central moments):
- Moment trung tâm bậc 1 → luôn bằng 0 → μ₁ = E[(X − μ)]
- Moment trung tâm bậc 2 → Phương sai → μ₂ = E[(X − μ)²]
- Moment trung tâm bậc 3 → Liên quan đến độ lệch → μ₃ = E[(X − μ)³]
- Moment trung tâm bậc 4 → Liên quan đến độ nhọn → μ₄ = E[(X − μ)⁴]
Công thức trên dành cho quần thể. Để tính moment mẫu, ta thay kỳ vọng quần thể bằng trung bình mẫu:
mᵣ = (1/n) Σᵢ₌₁ⁿ (xᵢ − x̄)ʳ
Độ lệch: đo mức bất đối xứng
Phân phối đối xứng và phân phối lệch
Độ lệch (skewness) mô tả mức độ bất đối xứng của phân phối. Có hai loại phân phối lệch:
- Lệch phải (right-skewed, positive skew): đuôi kéo dài về phía phải
- Lệch trái (left-skewed, negative skew): đuôi kéo dài về phía trái
 Ba dạng phân phối: lệch phải, chuẩn, lệch trái
Cần nhớ nguyên tắc vàng: hãy nhìn vào đuôi, không nhìn vào khối lượng. Người mới thường nhầm lẫn vì nghĩ bên có nhiều dữ liệu hơn là bên đặt tên — thực tế ngược lại.
Vị trí trung bình, trung vị, yếu vị
- Phân phối lệch trái → Mean < Median < Mode
- Phân phối đối xứng → Mean ≈ Median ≈ Mode
- Phân phối lệch phải → Mean > Median > Mode
Vì sao chuẩn hóa bằng bậc 3?
Công thức độ lệch quần thể:
γ₁ = E[(X − μ)³] / σ³
Moment bậc ba có đơn vị lập phương (cm³, km³...). Chia cho σ³ sẽ triệt tiêu đơn vị và cho ra một đại lượng không thứ nguyên.
Vì sao không bình phương mà lập phương? Vì bình phương làm mất dấu của độ lệch. Còn lập phương giữ nguyên dấu: (+2)³ = +8, còn (−2)³ = −8. Nhờ đó moment bậc ba phản ánh được hướng của sự bất đối xứng. Đồng thời, lập phương cũng khuếch đại trọng số của các giá trị cực trị (5³ = 125 so với 2³ = 8), nên skewness rất nhạy cảm với outlier.
Hệ số Fisher–Pearson và hiệu chỉnh chệch
Khi tính từ mẫu, ta dùng hệ số Fisher–Pearson:
g₁ = [(1/n) Σ(xᵢ − x̄)³] / [(1/n) Σ(xᵢ − x̄)²]^(3/2)
Tuy nhiên ước lượng này có thể chệch, đặc biệt với mẫu nhỏ. Do đó ta nhân thêm hệ số hiệu chỉnh C(n) phụ thuộc vào cỡ mẫu:
G₁ = [√(n(n − 1)) / (n − 2)] · g₁
Hệ số hiệu chỉnh chỉ phụ thuộc vào n — vì vấn đề cần khắc phục là bài toán mẫu hữu hạn, không liên quan đến đơn vị dữ liệu (đồng, mét, hay lương). Khi n đủ lớn, hệ số tiến về 1 và G₁ ≈ g₁.
Cách diễn giải độ lệch
- Skewness ≈ 0 → dữ liệu gần như đối xứng
- Skewness > 0 → phân phối lệch phải
- Skewness < 0 → phân phối lệch trái
- |Skewness| lớn → mức bất đối xứng mạnh
Lưu ý quan trọng: dấu thể hiện hướng, giá trị tuyệt đối thể hiện độ mạnh. Và không có ngưỡng tuyệt đối nào cho mọi trường hợp — giá trị 1 có thể chấp nhận được trong ngữ cảnh này nhưng là vấn đề ở ngữ cảnh khác.
Độ nhọn: câu chuyện về phần đuôi, không phải đỉnh
Kurtosis thực sự đo gì?
Nhiều tài liệu mô tả kurtosis là "độ nhọn của đỉnh". Điều này không chính xác. Kurtosis thực chất là moment trung tâm bậc 4 đã chuẩn hóa — nó đo hành vi của phần đuôi và độ nhạy cảm với các quan sát cực trị.
 Minh họa hình dạng đuôi phân phối liên quan đến Kurtosis
Công thức quần thể:
β₂ = E[(X − μ)⁴] / σ⁴ = E[(X − μ)⁴] / (E[(X − μ)²])²
Vì sao dùng bậc 4?
Lũy thừa bậc 4 khiến cả độ lệch dương và âm đều đóng góp tích cực: (−2)⁴ = 16 và (2)⁴ = 16. Đồng thời nó khuếch đại cực trị rất mạnh: 10⁴ = 10.000. Nghĩa là quan sát càng xa trung bình, đóng góp của nó vào moment bậc 4 càng tăng vọt — đây là lý do kurtosis đặc biệt nhạy với đuôi dày.
Con số "3" bí ẩn đến từ đâu?
Với biến chuẩn hóa Z = (X − μ) / σ, phân phối chuẩn tắc có Z ~ N(0,1). Moment bậc chẵn của nó tuân theo công thức:
E[Z²ᵏ] = (2k − 1)!!
Với k = 2: 3!! = 3 × 1 = 3. Do đó kurtosis của phân phối chuẩn đúng bằng 3.
Để dễ diễn giải, người ta định nghĩa độ nhọn thừa (excess kurtosis) = kurtosis − 3:
- Excess Kurtosis > 0 → đuôi dày hơn phân phối chuẩn, nhạy cảm hơn với cực trị
- Excess Kurtosis = 0 → tương đương phân phối chuẩn
- Excess Kurtosis < 0 → đuôi mỏng hơn phân phối chuẩn
Ví dụ, scipy.stats.kurtosis() trong Python mặc định trả về excess kurtosis, không phải kurtosis thô — đây là điểm nhiều người mới dùng hay nhầm.
Ứng dụng trong phân tích khám phá dữ liệu (EDA)
Trong thực tế, skewness và kurtosis kết hợp với các phép biến đổi như Box-Cox hay Yeo-Johnson giúp đưa dữ liệu về gần phân phối chuẩn hơn — điều kiện quan trọng cho nhiều mô hình học máy thống kê.
Quy trình EDA điển hình gồm:
- Tính các đại lượng tóm tắt: trung bình, trung vị, độ lệch chuẩn, skewness, kurtosis
- Trực quan hóa bằng histogram, boxplot, KDE plot và Q-Q plot
- Quyết định có cần biến đổi dữ liệu hay không trước khi đưa vào mô hình
Với dữ liệu lệch mạnh và đuôi dày, các mô hình tuyến tính có thể bị ảnh hưởng nghiêm trọng; việc phát hiện sớm qua skewness và kurtosis giúp tiết kiệm rất nhiều thời gian tinh chỉnh mô hình về sau.
Kết luận
Skewness và kurtosis không chỉ là những con số thống kê khô khan. Chúng là tấm bản đồ cho biết dữ liệu của bạn đang cư xử như thế nào ở phần đuôi — nơi những giá trị bất thường và rủi ro thực sự trú ngụ. Hiểu rõ hai chỉ số này là bước đệm bắt buộc trước khi bước vào bất kỳ dự án học máy nghiêm túc nào.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Gemini 4 Argon tự động tối ưu 200.000 dòng mã Python của Google ADK chỉ trong một đêm
24 tháng 10, 2026