Frostbite: CPU do AI tự thiết kế đạt hiệu năng trên watt gấp 4,59 lần
Architect Labs công bố Frostbite, một CPU đa dụng với tập lệnh hoàn toàn mới, được hệ thống AI tự thiết kế từ kiến trúc đến GDS cuối cùng. Trên 25 tác vụ, chip đạt hiệu năng trên watt gấp 4,59 lần một lõi CPU superscalar hiện đại, nhờ dựa trên nền tảng interaction nets.
Architect Labs vừa công bố Frostbite, một CPU đa dụng với tập lệnh (ISA) xây dựng lại từ đầu. Bài trước của hãng, Redwood, chỉ chứng minh AI có thể triển khai một bộ tăng tốc suy luận khi kiến trúc đã có sẵn. Lần này, AI tự chọn kiến trúc.
Nhóm nghiên cứu đặt câu hỏi liệu hệ thống AI có thể tạo ra một phát hiện phần cứng mới, vượt xa thiết kế do con người làm. Frostbite là câu trả lời.
Điểm tựa: interaction nets
CPU thông thường che giấu phụ thuộc giữa các phần của chương trình. Bất kỳ đoạn mã nào cũng có thể đọc hoặc ghi biến qua trạng thái dùng chung, nên phần cứng phải chạy hết tốc lực để tự tìm ra lệnh nào phụ thuộc lệnh nào.
Hiệu năng lõi đơn gần như đứng yên từ đầu những năm 2000. Các hãng chuyển sang nhiều lõi, kéo theo hệ thống cache nhiều tầng và giao thức nhất quán (coherence), tốn diện tích và điện năng, khó mở rộng.
Interaction nets đi hướng khác. Chương trình là một đồ thị các nút, tính toán diễn ra bằng cách viết lại các cặp nút nối với nhau. Mỗi bước chỉ chạm vào một phần nhỏ, cục bộ của đồ thị.
Mỗi nút có đúng một cổng chính, nên hai cặp hoạt động không bao giờ chồng lấn. Chúng có thể chạy theo bất kỳ thứ tự nào, hoặc cùng lúc, kết quả vẫn vậy. Mỗi giá trị chỉ được dùng đúng một lần, không có trạng thái dùng chung để phần cứng phải bảo vệ.
Ngôn ngữ Vine biên dịch chương trình trông như bình thường trực tiếp sang interaction nets. Trong ví dụ tám quân hậu trên bàn 5x5, bản C++ duyệt từng nhánh một, còn mạng interaction net thực hiện 3.183 tương tác với đường găng chỉ 262 bước.
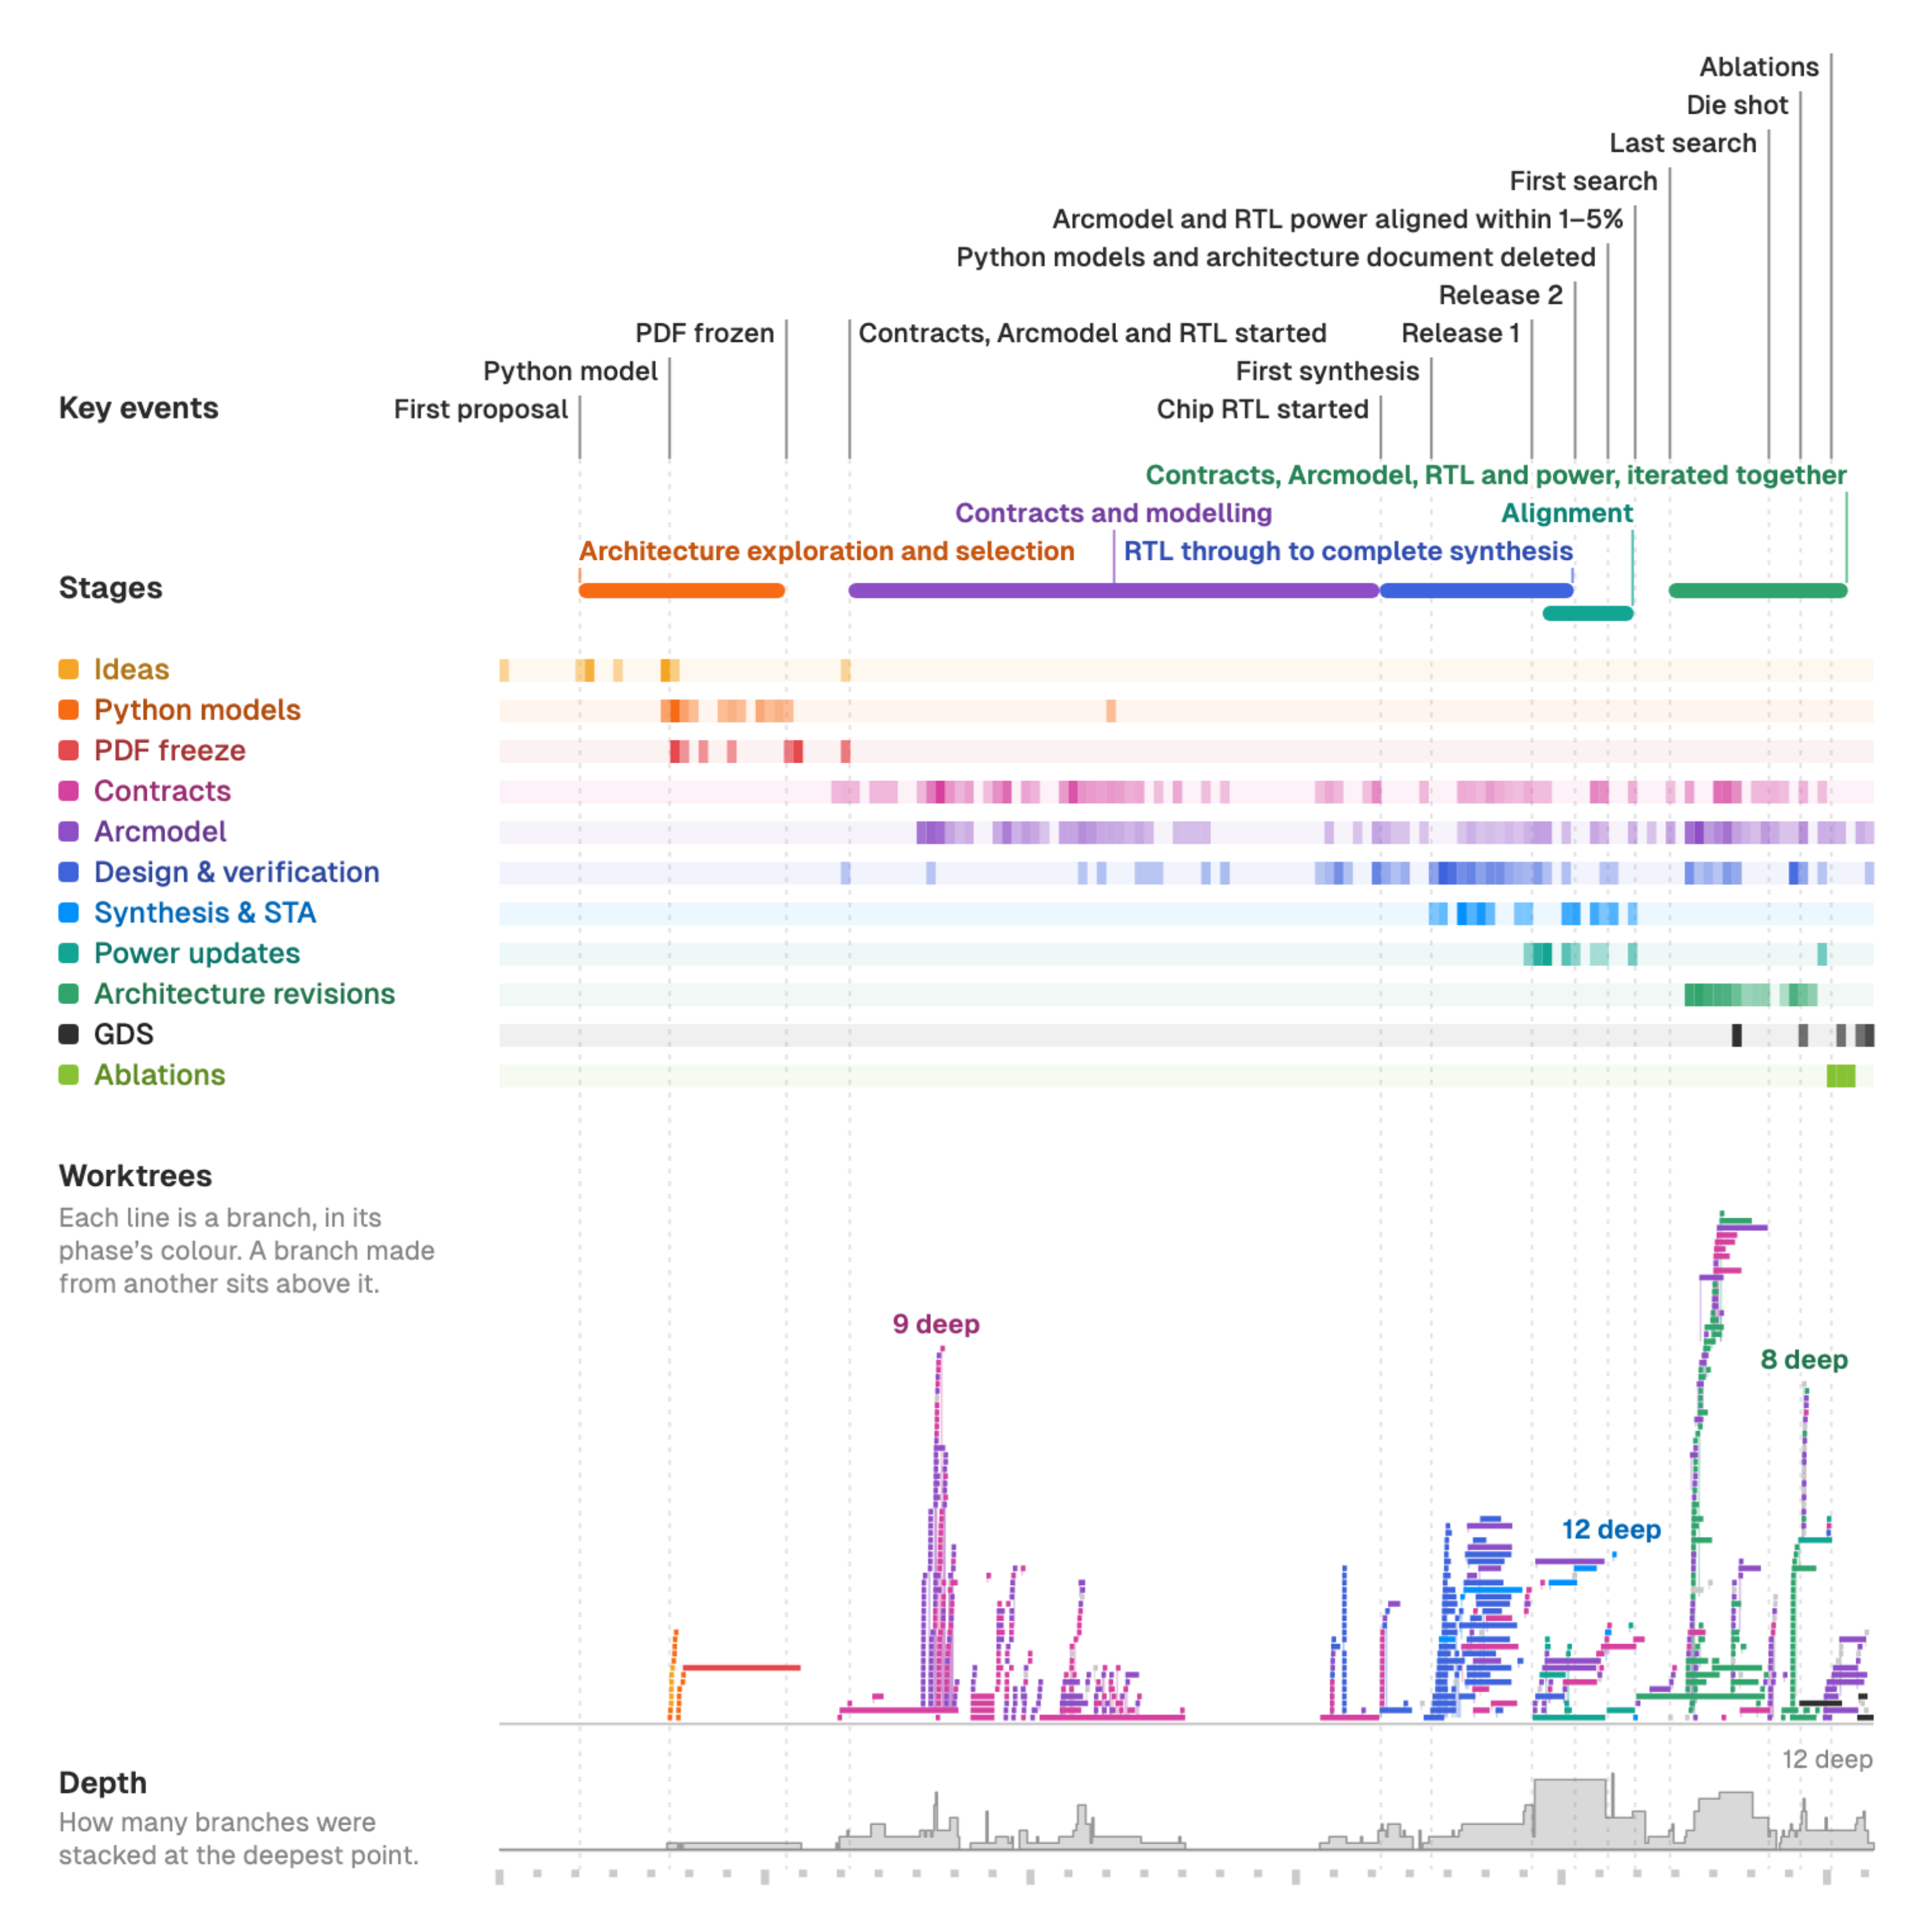 Sơ đồ quy trình thiết kế Frostbite từ đề xuất đầu tiên đến các vòng đánh giá
Quy trình: không có định kiến kiến trúc
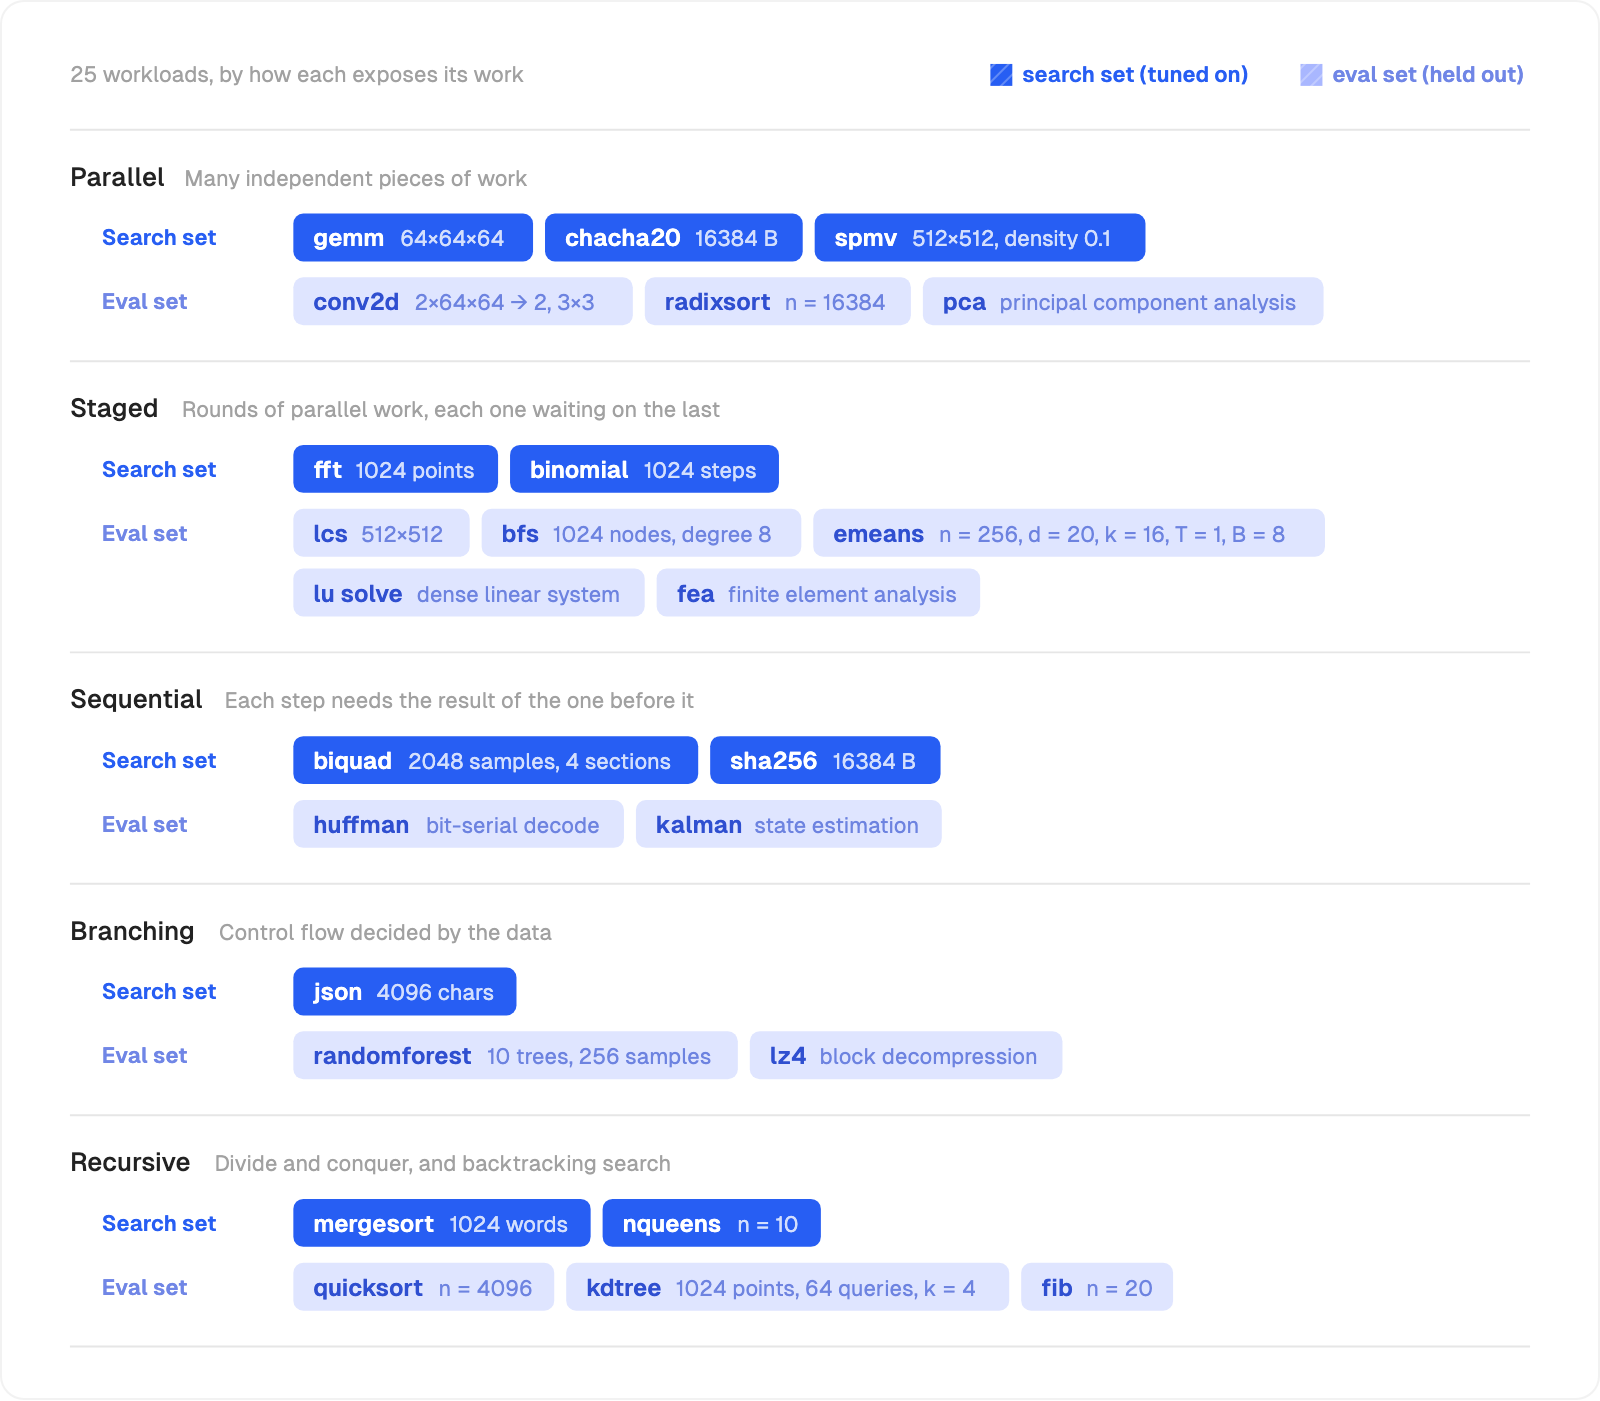
Frostbite được thiết kế không dựa trên bất kỳ kiến trúc có sẵn nào. Nhóm nghiên cứu chọn 25 tác vụ, chia theo cách chương trình bộc lộ công việc: nhiều phần độc lập, các vòng song song, chuỗi tuần tự dài, nhánh phụ thuộc dữ liệu và đệ quy.
Mười tác vụ tạo thành tập tìm kiếm để các tác nhân AI tinh chỉnh. Mười lăm tác vụ còn lại, gồm Kalman filter, PCA, phân tích phần tử hữu hạn, giải LU và giải nén LZ4, được giữ kín đến vòng đánh giá cuối.
Các tác nhân AI tổng hợp bài báo khoa học, dựng mô hình Python để so sánh các ý tưởng kiến trúc, rồi thu hẹp về một khái niệm duy nhất. Kết quả là một tài liệu PDF 141 trang, chỉ là điểm khởi đầu chứ không phải kiến trúc cuối.
Nhóm phát triển một ngôn ngữ đặc tả nội bộ tên ASL, có khả năng kiểm chứng bằng máy. Mô hình hệ thống của chip, gọi là Arcmodel, viết bằng ASL, chạy nhanh khoảng 200 lần so với mô phỏng RTL và ước lượng năng lượng trong sai số 1–5%.
Khác với quy trình thiết kế chip truyền thống, nơi kiến trúc sư viết hàng loạt tài liệu PDF tiếng Anh rồi bàn giao cho nhóm triển khai, nhóm này chọn đặc tả hình thức. Ngôn ngữ tự nhiên không đủ chính xác, và không bắt được lỗi ảo giác (hallucination) của tác nhân AI trong lúc thiết kế.
ASL chuyển thẳng sang Lean, dùng để chứng minh định lý, đối chiếu đầu ra AI trên RTL, UVM, C, SVA. Đến cuối dự án, đặc tả ASL hạ xuống hơn 800.000 dòng Lean. Mọi vòng lặp đều giữ đặc tả ASL làm nguồn sự thật duy nhất.
Khi mô hình và phần cứng phải khớp nhau
Arcmodel chưa biết gì về vật lý, nên ước lượng công suất ban đầu lệch tới gần 250% so với RTL đã tổng hợp. Một quy trình tự động đối chiếu hai bên: tìm điểm nóng công suất trong RTL, truy về các bộ đếm trong đặc tả như số lần đọc ghi SRAM hay số gói tin gửi nhận, rồi viết hàm Python dự đoán công suất cho đến khi sai số dưới 5%.
Sau khi khớp, mô phỏng Arcmodel chạy nhanh hơn RTL 660 lần. Nhờ vậy, AI phát hiện các kỹ thuật tắt xung nhịp (clock gating) rất mịn và chỉnh runtime phần mềm tương ứng trong vài giờ. Kiểu tối ưu xuyên tầng như vậy gần như bất khả thi trong quy trình ASIC truyền thống.
Qua bốn vòng tìm kiếm và một vòng đánh giá, nhóm tác nhân AI thử 58 ý tưởng, giữ lại 37.
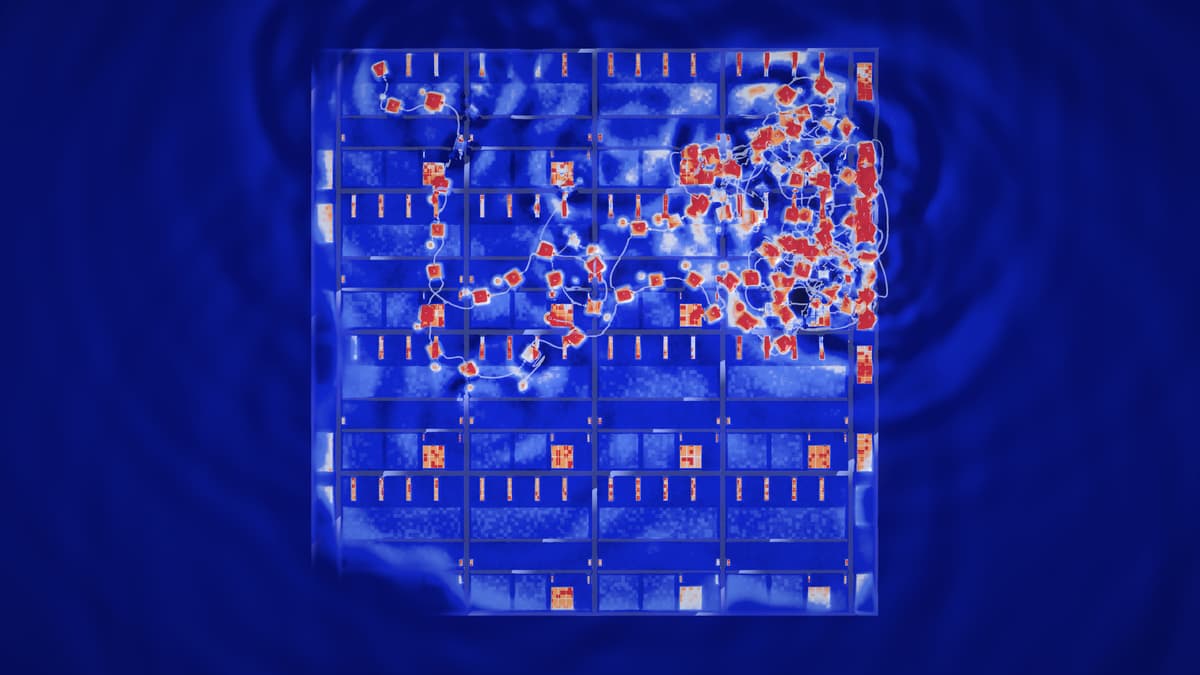
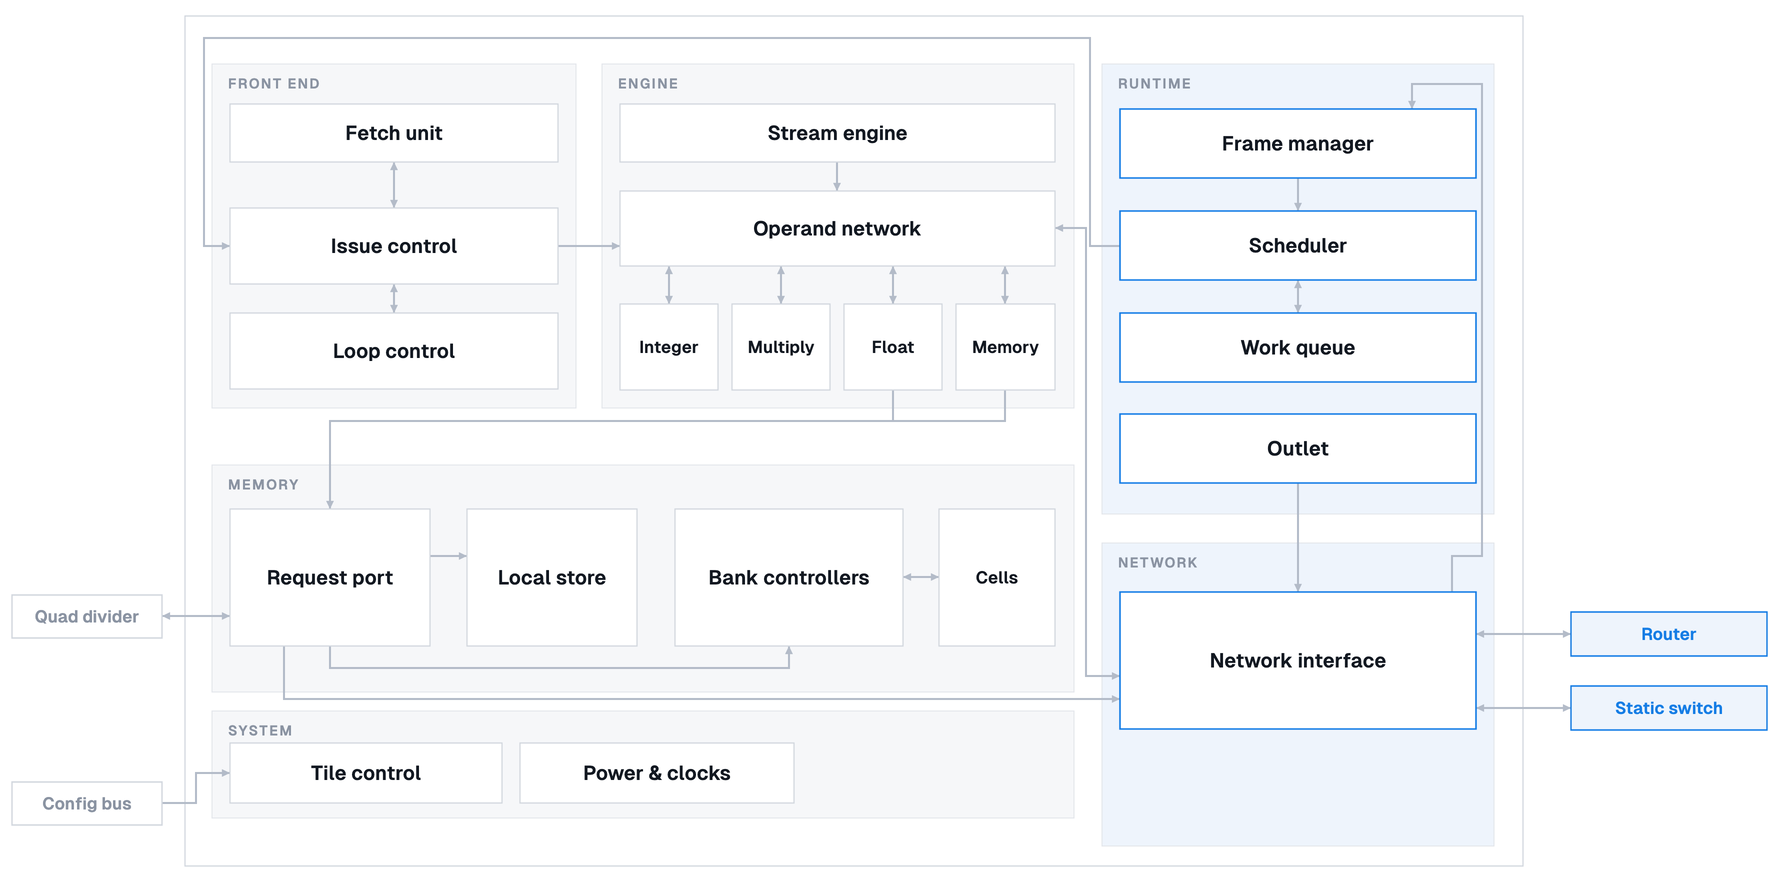 Một ô xử lý Frostbite với các khối chức năng
Điểm mới lạ: tự chia việc, không cần bộ điều phối
Chương trình Frostbite viết bằng Vine, biên dịch sang Ivy, một dạng biểu diễn trung gian mã hóa cấu trúc interaction net. Mạng Ivy cuối cùng gồm ba loại nguyên thủy: nút dữ liệu, nút tính toán và nút điều khiển.
Song song không nằm trong cấu trúc mà phải suy ra lúc chạy, rồi trải ra trong không gian. Không có bộ điều phối trung tâm. Mỗi ô xử lý (tile) hoạt động theo ba quy tắc do AI tự nghĩ ra:
- Chạy việc của mình trước, tức việc nằm ở cổng vào.
- Nếu cổng trống, lấy việc từ ô lân cận đang dư.
- Nếu không tìm được, tự ngủ để tiết kiệm điện.
Khi vòng lặp hoặc nhánh tách thành các phần song song chưa biết trước kích thước, phần đang chạy cất phần còn lại vào bộ nhớ cục bộ tên frame manager. Nó đẩy việc mới vào hàng đợi phần cứng, tự nhận việc mới nhất, và các ô lân cận rảnh sẽ kéo phần còn lại qua mạng nội bộ.
Cơ chế này không được ai đặc tả. Nó xuất hiện khi AI leo dốc chỉ số hiệu năng trên các bài kiểm thử cụ thể.
Kết quả đo
Frostbite tổng hợp trên tiến trình 7 nm, đạt tần số 800 MHz khi tổng hợp và 500 MHz trong GDS cuối. Mỗi quad Frostbite, gồm lưới hai nhân hai ô, cộng bốn nút L3, chiếm 0,792 mm².
Lõi CPU superscalar hiện đại dùng để so sánh (nhóm nghiên cứu gọi là TCPU) chiếm 0,895 mm² trên cùng tiến trình. Hãng không tiết lộ tên CPU vì lý do pháp lý.
So một quad Frostbite với một lõi TCPU, tức hai bên có diện tích tương đương, Frostbite đạt trung bình 8,77 lần hiệu năng trên diện tích.
Trên cả 25 tác vụ, hiệu năng trên watt trung bình hình học gấp 4,59 lần TCPU: 6,02 lần trên 10 tác vụ tìm kiếm và 3,83 lần trên 15 tác vụ giữ kín, chưa từng được tinh chỉnh.
Về phân bổ năng lượng, trừ phân phối xung nhịp, TCPU dành 57% cho bộ nhớ và 27% cho tìm nạp, giải mã, phát lệnh. Frostbite giảm bộ nhớ xuống 38% và khối tìm nạp xuống 6%. Bù lại, chip dành 26% cho mạng nội bộ và bộ điều phối việc chia sẻ giữa các ô.
Khi mở rộng lên lưới bốn nhân bốn, phân bổ công suất gần như giữ nguyên. Mỗi ô có bộ nhớ nhỏ riêng, không cần hệ thống cache nhiều tầng dùng chung.
 Mô hình mô phỏng hệ thống và đối chiếu công suất
Bước tiếp theo
Architect Labs cho biết sẽ mở sân chơi phần mềm để bất kỳ ai chạy chương trình trên Frostbite, đặt trên FPGA. Hãng cũng dự định xây hệ điều hành sơ khai quản lý tài nguyên, nhiều chương trình và ảo hóa, mở rộng quy mô tác nhân AI để tăng hiệu năng trên watt, và công bố RTL cùng ISA.
Trong các tháng tới, nhóm sẽ đo cấu hình lưới Frostbite so với CPU nhiều lõi dùng cache lớn, gồm cả lõi ngoài thứ tự (out-of-order), trên các bộ benchmark như SPEC và PARSEC.
Góc nhìn
Với kỹ sư Việt Nam, điểm đáng học không nằm ở con số 4,59 lần. Đó là cách nhóm này biến đặc tả hình thức thành nguồn sự thật duy nhất cho cả RTL, mô hình hệ thống và kiểm chứng.
Khi AI viết ngày càng nhiều mã, một bản đặc tả kiểm chứng được bằng máy, dịch thẳng sang Lean, là hàng rào chống lỗi tốt hơn nhiều so với tài liệu Word hay PDF. Các nhóm thiết kế chip và cả nhóm làm phần mềm nhúng tại Việt Nam có thể thử cách này ở quy mô nhỏ trước.
Còn Frostbite mới ở mức trước khi sản xuất (pre-silicon) và mới so với một lõi đơn. Chưa có bằng chứng nào cho thấy nó thay thế được CPU nhiều lõi trên các tải thực tế.
Nguồn: architectlabs.com · Quy trình biên tập