
Hồi quy bị kiểm duyệt và bị cắt cụt trong Python
Một khảo sát lương mô phỏng cho thấy hồi quy OLS thu hẹp hiệu ứng 5.000 USD/năm xuống còn 3.222 USD, trong khi mô hình Tobit và hợp lý cụt khôi phục lại gần đúng giá trị thật. Bài viết giải thích khác biệt giữa dữ liệu bị kiểm duyệt và bị cắt cụt, cùng cách tự lập trình các mô hình này trong Python.
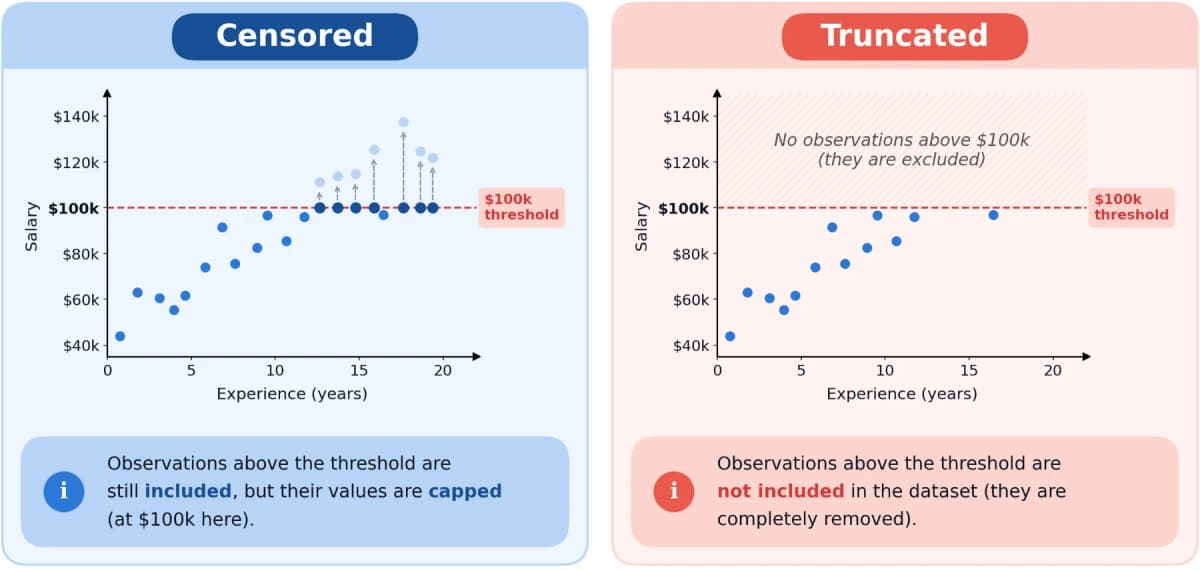
Hãy bắt đầu với một tình huống quen thuộc: dựng mô hình hồi quy cho mối quan hệ giữa lương và số năm kinh nghiệm từ dữ liệu khảo sát. Vì lý do bảo mật, đơn vị khảo sát ghi mọi mức lương trên 100.000 USD thành đúng 100.000 USD. Giả sử thay vào đó, họ loại hẳn những người thu nhập trên 100.000 USD khỏi tập dữ liệu. Hai cách xử lý này có cùng một vấn đề thống kê không? Câu trả lời là không: trường hợp đầu là kiểm duyệt (censoring), trường hợp sau là cắt cụt (truncation).
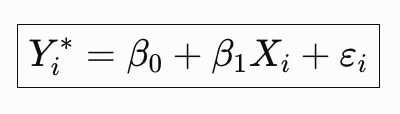 Minh họa hai kiểu dữ liệu bị kiểm duyệt và bị cắt cụt
Dữ liệu bị kiểm duyệt là gì
Xét năm người với mức lương thực tế lần lượt 45.000, 65.000, 85.000, 125.000 và 180.000 USD. Sau khi ghi nhận theo quy tắc trần 100.000 USD, hai người cuối cùng đều được ghi là 100.000 USD.
Ta không mất quan sát nào. Vẫn đủ năm người. Ta còn biết hai người kia kiếm ít nhất 100.000 USD, chỉ là không biết chính xác bao nhiêu. Đây là kiểm duyệt phải (right censoring).
Có ba kiểu kiểm duyệt chính:
- Kiểm duyệt trái: biết giá trị thật nằm dưới một ngưỡng, ví dụ thiết bị đo không phát hiện được nồng độ chất ô nhiễm dưới 0,01 mg/L.
- Kiểm duyệt phải: biết giá trị thật nằm trên một ngưỡng, như trường hợp lương ở trên.
- Kiểm duyệt khoảng: chỉ biết giá trị rơi vào một khoảng, ví dụ khảo sát thu nhập theo bậc thay vì con số chính xác.
Trong cả ba trường hợp, ta vẫn có thông tin về quan sát, chỉ thiếu giá trị chính xác.
Dữ liệu bị cắt cụt là gì
Nếu khảo sát chỉ giữ những người có lương dưới 100.000 USD, tập dữ liệu chỉ còn ba người. Hai người thu nhập cao biến mất hoàn toàn. Nếu ai đó đưa ta tập dữ liệu này mà không giải thích cách thu thập, ta có thể không nhận ra một nhóm dân số đã bị loại bỏ. Đây là cắt cụt phải (right truncation). Tương tự, nếu khảo sát chỉ giữ người lương trên 50.000 USD, đó là cắt cụt trái.
Khác biệt nghe có vẻ nhỏ, nhưng hệ quả thống kê rất khác: kiểm duyệt làm mất thông tin về một quan sát, cắt cụt làm mất cả quan sát.
Gặp kiểm duyệt và cắt cụt ở đâu trong thực tế
| Lĩnh vực | Kiểm duyệt | Cắt cụt |
|---|---|---|
| Khảo sát thu nhập | Lương bị chặn ở mức trần báo cáo | Loại người nằm ngoài khoảng thu nhập |
| Bảo hiểm | Chi trả bị chặn theo hạn mức hợp đồng | Loại khiếu nại dưới ngưỡng báo cáo |
| Y tế | Số đo dưới ngưỡng phát hiện của thiết bị | Số đo dưới ngưỡng bị loại bỏ |
| Bán lẻ | Doanh số bị giới hạn bởi tồn kho | Loại cửa hàng doanh số thấp |
| Tín dụng | Người vay chưa vỡ nợ khi kết thúc nghiên cứu | Loại số tiền thu hồi dưới ngưỡng |
Ví dụ dễ thấy là dự báo nhu cầu bán lẻ. Một tiệm bánh làm 100 chiếc croissant mỗi ngày và luôn bán hết. Không thể kết luận nhu cầu thực sự chỉ là 100. Có thể 30 khách khác đã đến sau khi hết hàng. Tiệm quan sát doanh số, không quan sát nhu cầu. Huấn luyện mô hình học máy trên số liệu lịch sử đó mà bỏ qua giới hạn tồn kho sẽ cho ra mô hình đánh giá thấp nhu cầu của các mặt hàng bán chạy.
Vì sao hồi quy tuyến tính thường thất bại
Gọi X là số năm kinh nghiệm, Y là lương. Với dữ liệu bị kiểm duyệt phải ở ngưỡng C, giá trị quan sát được là min(Y, C). Với dữ liệu bị cắt cụt phải, ta chỉ thấy một cá nhân nếu Y dưới C.
Cách thứ nhất coi lương 125.000 USD và 180.000 USD đều là 100.000 USD. Cách thứ hai loại hẳn nhóm lương cao. Cả hai cơ chế đều bóp méo mối quan hệ giữa lương và kinh nghiệm. Mức độ bóp méo đến đâu? Hãy kiểm tra bằng Python.
Mô phỏng dữ liệu trong Python
Sinh 6.000 cá nhân với kinh nghiệm từ 0 đến 20 năm. Mô hình gốc: lương khởi điểm kỳ vọng 40.000 USD, mỗi năm kinh nghiệm cộng thêm 5.000 USD, độ lệch chuẩn sai số 12 (đơn vị nghìn USD).
import numpy as np
import pandas as pd
from scipy.stats import norm
from scipy.optimize import minimize
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(42)
n = 6000
x = rng.uniform(0, 20, n)

beta0, beta1, sigma = 40, 5, 12
y_star = beta0 + beta1 * x + rng.normal(0, sigma, n)

df = pd.DataFrame({"Experience": x, "Salary": y_star})
c = 100
df["Censored_Salary"] = np.minimum(df["Salary"], c)
df["Is_Censored"] = df["Salary"] >= c
truncated_df = df[df["Salary"] < c].copy()
Tập gốc và tập bị kiểm duyệt đều có 6.000 quan sát. Tập bị cắt cụt chỉ còn 3.639 quan sát. Khoảng 39,35% dữ liệu bị ảnh hưởng.
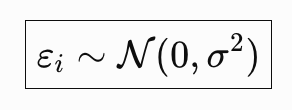 So sánh phân phối gốc, bị kiểm duyệt và bị cắt cụt
Hai điểm đáng lưu ý trên đồ thị. Phân phối bị kiểm duyệt có một cột dựng đứng bất thường ở mức 100.000 USD, vì mọi người lương cao đều bị gán cùng một giá trị. Phân phối bị cắt cụt chỉ đơn giản dừng ở 100.000 USD, không có cột dựng đứng nào.
Hồi quy OLS trên ba tập dữ liệu
X = df[["Experience"]].to_numpy()
y = df["Censored_Salary"].to_numpy()
d = df["Is_Censored"].to_numpy()
Xt, yt = X[~d], y[~d]

ols_full = LinearRegression().fit(X, y_star)
ols_c = LinearRegression().fit(X, y)
ols_t = LinearRegression().fit(Xt, yt)
Kết quả:
| Mô hình | Hệ số ước lượng |
|---|---|
| Hệ số thật | 5,000 |
| OLS trên dữ liệu gốc | 4,983 |
| OLS trên dữ liệu bị kiểm duyệt | 3,222 |
| OLS trên dữ liệu bị cắt cụt | 4,095 |
Trên dữ liệu bị kiểm duyệt, OLS ước lượng mức tăng chỉ khoảng 3.222 USD mỗi năm, đánh giá thấp gần 36% so với giá trị thật 5.000 USD. Mô hình trên dữ liệu bị cắt cụt cũng lệch đáng kể. Vậy làm sao ước lượng đúng quan hệ gốc khi không có mức lương thật?
Hồi quy kiểm duyệt: mô hình Tobit
Nhà kinh tế James Tobin đề xuất mô hình Tobit năm 1958 cho biến phụ thuộc bị giới hạn. Ý tưởng cốt lõi: thay vì giả vờ mọi quan sát đều là số đo chính xác, hãy đưa vào hàm hợp lý (likelihood function) mọi thông tin ta thực sự có.
Với quan sát không bị kiểm duyệt, ta biết chính xác mức lương, nên đóng góp vào hàm hợp lý là mật độ xác suất chuẩn φ. Với quan sát bị kiểm duyệt, ta chỉ biết lương ít nhất 100.000 USD, nên đóng góp là xác suất lương vượt ngưỡng, tức 1 trừ hàm phân phối tích lũy Φ.
Nói cách khác, mô hình không cần giải thích vì sao ai đó kiếm đúng 100.000 USD. Nó chỉ cần tính xác suất người đó kiếm từ 100.000 USD trở lên.
def tobit_nll(theta, x, y, d, c):
    b0, b1, log_sigma = theta
    sigma = np.exp(log_sigma)
    mu = b0 + b1 * x
    exact = norm.logpdf(y[~d], loc=mu[~d], scale=sigma)
    censored = norm.logsf(c, loc=mu[d], scale=sigma)
    return -(exact.sum() + censored.sum())

initial = [ols_t.intercept_, ols_t.coef_[0],
           np.log(np.std(yt - ols_t.predict(Xt)))]

tobit_result = minimize(tobit_nll, initial,
                        args=(x, y, d, c), method="L-BFGS-B")
Hai lưu ý kỹ thuật. Ta ước lượng logarit của độ lệch chuẩn để đảm bảo giá trị ước lượng luôn dương. Hàm norm.logsf() tính logarit của hàm sống sót (survival function), ổn định số học hơn cách tính logarit của 1 trừ hàm phân phối tích lũy. Ta cực tiểu hóa âm log hợp lý (negative log-likelihood).
Hệ số ước lượng thu được khoảng 5,032, rất sát giá trị thật là 5. Ta không khôi phục được chính xác mức lương của những người bị kiểm duyệt, nhưng với các giả định của mô hình, ta ước lượng được mối quan hệ gốc tốt hơn nhiều.
Hồi quy cắt cụt
Với dữ liệu bị cắt cụt, cách làm phải khác. Ta không có quan sát nào trên 100.000 USD. Nhưng ta biết điều kiện để một người lọt vào tập dữ liệu: lương phải dưới 100.000 USD. Hàm hợp lý phải phản ánh cơ chế chọn lọc này.
Theo định nghĩa mật độ có điều kiện, đóng góp vào hàm hợp lý là mật độ chuẩn chia cho xác suất lương dưới ngưỡng. Mẫu số chính là phần quan trọng nhất, nó hiệu chỉnh phân phối để phản ánh việc ta chỉ quan sát một phần của phân phối gốc.
def truncated_nll(theta, x, y, c):
    b0, b1, log_sigma = theta
    sigma = np.exp(log_sigma)
    mu = b0 + b1 * x
    log_density = norm.logpdf(y, loc=mu, scale=sigma)
    log_selection_prob = norm.logcdf(c, loc=mu, scale=sigma)
    return -np.sum(log_density - log_selection_prob)

truncated_result = minimize(truncated_nll, initial,
                            args=(Xt.ravel(), yt, c),
                            method="L-BFGS-B")
Hệ số ước lượng khoảng 5,088, cũng cải thiện rõ rệt so với hồi quy OLS trên cùng tập dữ liệu.
So sánh tổng hợp
| Mô hình | Hệ số chặn | Hệ số góc |
|---|---|---|
| Mô hình thật | 40,000 | 5,000 |
| OLS trên dữ liệu gốc | 40,010 | 4,983 |
| OLS trên dữ liệu bị kiểm duyệt | 49,048 | 3,222 |
| OLS trên dữ liệu bị cắt cụt | 43,179 | 4,095 |
| Hồi quy Tobit | 39,780 | 5,032 |
| Hồi quy cắt cụt | 39,527 | 5,088 |
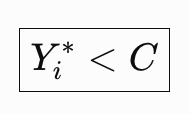 So sánh đường hồi quy OLS, Tobit và hồi quy cắt cụt
Ta không thêm biến giải thích nào, không làm kỹ thuật đặc trưng phức tạp, không tăng độ phức tạp của hàm hồi quy. Chỉ thay đổi cách mô hình diễn giải dữ liệu có sẵn. Chỉ riêng điều đó đã tạo ra khác biệt lớn.
Vì sao dân học máy cần quan tâm
Nếu thay hồi quy tuyến tính bằng rừng ngẫu nhiên (random forest), XGBoost hay mạng nơ-ron sâu thì có giải quyết được vấn đề? Không hẳn.
Một mô hình học máy đủ linh hoạt huấn luyện bằng hàm mất mát bình phương sai số sẽ học kỳ vọng có điều kiện của đúng thứ dữ liệu đưa vào. Với dữ liệu bị kiểm duyệt, đó là kỳ vọng của min(Y, C). Với dữ liệu bị cắt cụt, đó là kỳ vọng của Y trong điều kiện Y dưới C. Cả hai đều không nhất thiết trùng với đại lượng ta muốn ước lượng ban đầu. Nói cách khác, mô hình càng mạnh thì càng giỏi dự đoán đúng thứ sai.
Có thể xây mạng nơ-ron nhận biết kiểm duyệt. Thay hàm tuyến tính bằng mạng nơ-ron cho kỳ vọng có điều kiện, rồi sửa hàm mất mát: quan sát không bị kiểm duyệt học từ mật độ xác suất của kết quả chính xác, quan sát bị kiểm duyệt học từ xác suất kết quả vượt ngưỡng. Cách này kết hợp được tính linh hoạt của mạng nơ-ron với lập luận xác suất của hồi quy kiểm duyệt. Ý tưởng tương tự áp dụng cho hệ gợi ý, dự báo y tế, hệ tự hành và AI công nghiệp, nơi cách thu thập dữ liệu giới hạn những gì ta quan sát được.
Hạn chế cần nhớ
Mô hình Tobit và hồi quy cắt cụt chuẩn giả định sai số phân phối chuẩn, phương sai không đổi (homoskedastic), quan hệ hồi quy gốc được chỉ định đúng, và cơ chế kiểm duyệt hoặc cắt cụt được mô tả đúng. Vi phạm các giả định này có thể cho ước lượng lệch hoặc không vững.
Không phải tập dữ liệu có nhiều số 0 đều là dữ liệu bị kiểm duyệt. Nếu ai đó chi 0 đồng cho một sản phẩm vì thực sự không có nhu cầu, số 0 là kết quả thật chứ không phải quan sát thiếu. Tùy bản chất dữ liệu, có thể cần cách tiếp cận khác:
- Phân tích sống sót (survival analysis) cho dữ liệu thời gian đến sự kiện bị kiểm duyệt.
- Mô hình chọn lọc Heckman cho một số bài toán chọn mẫu.
- Mô hình hurdle và hai phần cho kết quả bằng 0 thật.
- Hồi quy phân vị có kiểm duyệt khi giả định phân phối khác.
- Hàm mất mát học máy nhận biết kiểm duyệt cho quan hệ phi tuyến.
Hiểu dữ liệu được sinh ra thế nào quan trọng ngang với hiểu mô hình thống kê.
Góc nhìn
Với kỹ sư dữ liệu và lập trình viên Python ở Việt Nam, bài học thực dụng nằm ở bước kiểm tra dữ liệu trước khi huấn luyện. Những cột có nhiều giá trị trùng ở đúng một ngưỡng, hoặc phân phối bị dừng đột ngột ở một mốc, thường là dấu hiệu của kiểm duyệt hoặc cắt cụt. Nếu bỏ qua, mô hình vẫn chạy, chỉ số đánh giá vẫn đẹp, nhưng dự đoán sẽ lệch hệ thống.
Về mặt công cụ, các mô hình trong bài chỉ dùng numpy, scipy và scikit-learn, không cần thư viện chuyên dụng. Chi phí triển khai thấp, trong khi lợi ích là ước lượng sát giá trị thật hơn hẳn. Với các đội làm dự báo nhu cầu, chấm điểm tín dụng hay phân tích bảo hiểm, việc hỏi "dữ liệu này được thu thập thế nào" trước khi chọn thuật toán có thể tiết kiệm nhiều công sức tinh chỉnh siêu tham số về sau.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Khi dữ liệu thiếu không chỉ là 'thiếu': Những giả định ẩn sau các ô trống
01 tháng 9, 2026
Công nghệ
Một nhà cung cấp, bốn cách viết: Vì sao các bước xác định lại hiệu quả hơn điểm tương đồng
19 tháng 9, 2026
Phần mềm
Phát Hiện Những Khoản Thuê Bao Ngấm Ngầm Qua Sao Kê Ngân Hàng Với Python
06 tháng 4, 2026