
Kết hợp Unsiloed và TypeSafe Jev để kiểm tra tài liệu: khi OCR đọc đúng nhưng dữ liệu vẫn sai
Unsiloed trích xuất trường dữ liệu có cấu trúc kèm điểm tin cậy, còn Jev đặt câu hỏi có kiểu trả lời để đánh giá tính hợp lý. Kết hợp hai công cụ giúp phát hiện cả lỗi đọc sai lẫn lỗi logic mà chỉ một mình OCR không thể bắt được.
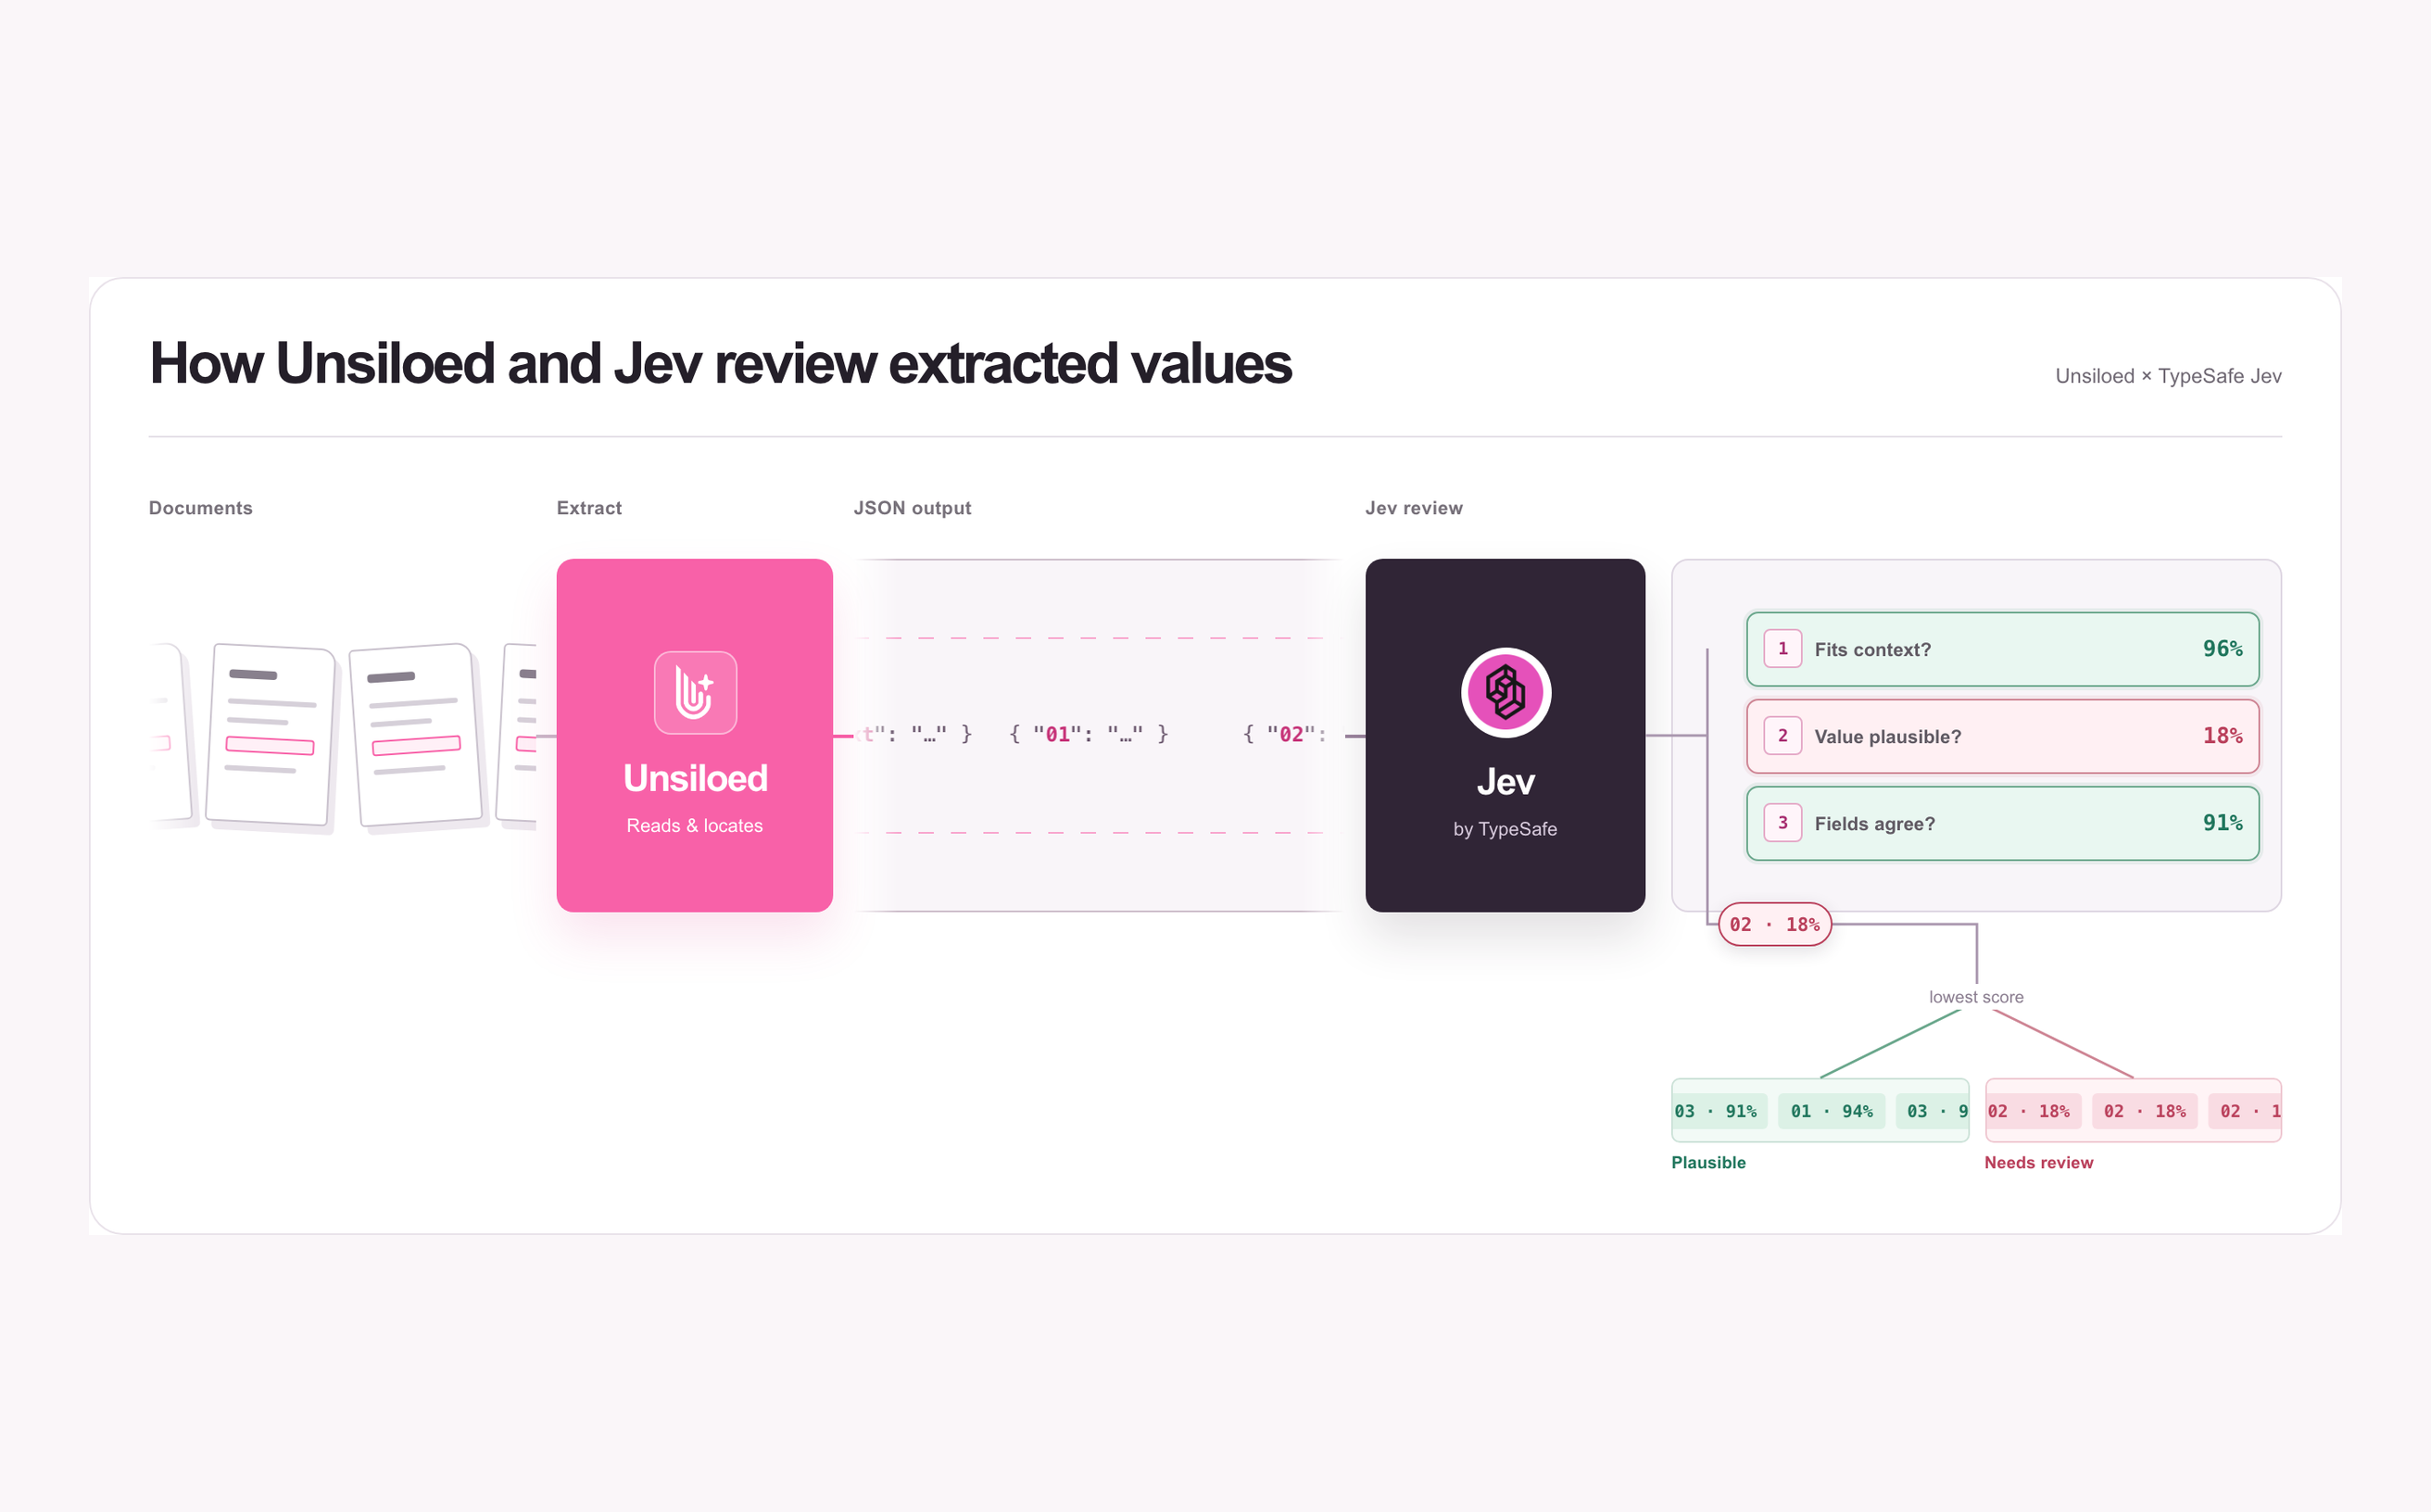
Kết hợp Unsiloed và TypeSafe Jev để kiểm tra tài liệu: khi OCR đọc đúng nhưng dữ liệu vẫn sai
Một pipeline trích xuất dữ liệu có thể đọc đúng con số nhưng vẫn đẩy dữ liệu tồi xuống các bước sau. Một số 0 in thừa rõ ràng vẫn có thể vượt qua cả hệ thống nhận dạng ký tự quang học (OCR) tốt nhất. Kết hợp Unsiloed và Jev của TypeSafe giúp chúng ta kiểm tra cả lỗi OCR lẫn những sai sót thông thường trong tài liệu.
 Minh họa quy trình kiểm tra tài liệu với Unsiloed và Jev
Jev biến câu hỏi tập trung thành câu trả lời có kiểu dữ liệu
Một yêu cầu gửi tới Jev tách biệt phần thông tin nó xem xét (state) với phần quyết định nó đưa ra (questions). Trong quy trình của chúng ta, state chứa các bản ghi mà Unsiloed đã trích xuất cùng ngữ cảnh cần thiết để diễn giải chúng. Mỗi câu hỏi cho Jev biết cần kiểm tra điều gì và trả về kiểu câu trả lời nào; câu hỏi cũng có thể định nghĩa tiêu chí cho các câu trả lời có thể có.
Kiểu dữ liệu quyết định thứ mà đoạn mã của chúng ta nhận được:
- Noul: trả về xác suất một phát biểu là đúng.
- Choice: chọn từ các lựa chọn được đặt tên.
- Score: đánh giá theo một thang mức có thứ tự.
Cả Choice và Score cũng trả về phân phối xác suất cùng một giá trị độ tin cậy tóm tắt mức độ tập trung của phân phối đó. Riêng Noul không có trường độ tin cậy tách biệt.
Ba kiểu này có thể dùng chung state trong một yêu cầu duy nhất. Trong ví dụ dưới đây, chúng ta chỉ dùng Noul.
Một giá trị Noul bằng 0.04 nghĩa là xác suất 4% cho câu trả lời "có" — tức một câu "không" mạnh mẽ. Nó không có nghĩa là "Jev tự tin 4%". Các giá trị gần hai đầu cho thấy hướng rõ ràng; giá trị gần giữa cần thận trọng.
Gửi các trường Unsiloed trích xuất tới Jev, rồi định tuyến kết quả
Unsiloed giữ nguyên nội dung được in và cung cấp điểm tin cậy giúp nhận diện những chỗ đọc mơ hồ. Trong ví dụ của chúng ta, ta dùng một danh sách thuốc gồm sáu dòng. Một vết cà phê che khuất một liều, trong khi một dòng khác chứa số lượng in rõ ràng nhưng vô lý.
Lược đồ trích xuất định nghĩa các trường Unsiloed cần trả về cho mỗi loại thuốc. Nó yêu cầu toàn bộ ô liều dùng, gồm cả số lượng và đơn vị, mà không tự sửa những con số đáng ngờ hay đoán phần chữ bị che từ thói quen kê đơn. Hãy bật trích dẫn nguồn với enable_citations=true và đợi tác vụ trích xuất hoàn tất trước khi dựng state cho Jev.
Mỗi trường có hai điểm tin cậy từ Unsiloed: extraction_score đo độ tin cậy vào giá trị được trích xuất, còn grounding_score đo độ tin cậy rằng giá trị đó đã được định vị trong tài liệu. Cả hai nằm trong khoảng từ 0 đến 1. Phần trích dẫn xác định trang và hộp giới hạn (bounding box) — hình chữ nhật bao quanh văn bản nguồn.
Dưới đây là liều cetirizine bị dính vết bẩn trong phản hồi đã lưu, với tọa độ pixel trên ảnh gốc 1.200 × 1.500:
{
  "value": "1 tablet",
  "score": { "grounding_score": 0.76, "extraction_score": 0.74 },
  "citation": {
    "page": 1,
    "bbox": [582, 975, 649, 994],
    "page_width": 1200,
    "page_height": 1500
  }
}
 Minh họa câu hỏi và tiêu chí dạng hợp đồng của Jev
Hãy gán cho mỗi dòng thuốc một ID như row-5 và giữ nó cùng các trường được trích xuất và trích dẫn tương ứng. Điều này cho phép mã của ta khớp câu trả lời của Jev với đúng dòng đó sau này. Giữ lại trích dẫn để người kiểm duyệt có thể định vị từng trường đã trích xuất trên trang gốc.
Gửi cho Jev các giá trị đã trích xuất kèm ngữ cảnh. Nó đánh giá hướng dẫn như đã trích xuất, không nhìn thấy ảnh và không thấy điểm của Unsiloed. Ta đặt một câu hỏi Noul cho mỗi dòng: liều và tần suất này có hợp lý với loại thuốc này không? Cả sáu dòng dùng chung một yêu cầu, với mỗi câu hỏi được đánh giá độc lập.
Trong module phía máy chủ kết nối hai API, hãy dựng yêu cầu như sau:
const request = {
  model: "jev-1.13.0",
  state: {
    context: "Check for obvious quantity, unit or frequency errors. " +
      "Dose means amount taken each time, not supply quantity. " +
      "Do not assess patient-specific safety or propose corrections.",
    careContext: "Adult outpatient medication reconciliation, age 52",
    medications: [{
      id: "row-5", medicine: "Cetirizine 10 mg tablet",
      dose: "1 tablet", frequency: "Once daily as needed",
      route: "Oral", instructions: "For allergy symptoms."
    }]
  },
  questions: {
    "row-5": {
      type: "noul",
      instructions: {
        question: "Is the extracted dose and frequency plausible on its " +
          "face for this medicine and strength in the stated adult " +
          "outpatient context, without an obvious quantity or " +
          "frequency transcription error?",
        row_id: "row-5"
      },
      criteria: {
        true: "Plausible on its face; no obvious quantity, unit or frequency error.",
        false: "Clearly implausible; warrants review of the original prescription."
      }
    }
  }
};
Phần ngữ cảnh và tiêu chí ở đây đã được rút ngắn; yêu cầu thực tế chứa văn bản đầy đủ và cả sáu dòng. Ta dùng row-5 làm ID câu hỏi để mã khớp được câu trả lời với dòng đó. Ta cũng đưa nó vào row_id bên trong instructions để Jev biết cần đánh giá bản ghi nào: ID câu hỏi không được gửi tới mô hình.
Gửi yêu cầu dưới dạng JSON tới https://api.typesafe.ai/v1/systemone. Xác thực bằng khóa API TypeSafe trong header Authorization: Bearer, và giữ khóa ở phía máy chủ. Câu trả lời ghi nhận tại answers["row-5"] là { "type": "noul", "noul": 0.94 }. Hãy khớp câu trả lời đó với trường row-5 đã lưu bằng ID chung.
Quyết định dòng nào cần kiểm duyệt
Mã của chúng ta giờ quyết định xem một dòng có cần được xem lại hay không. Với kiểm tra đọc, ta lấy điểm Unsiloed thấp nhất trong các trường của dòng, nên chỉ một trường điểm thấp là đủ để gắn cờ cả dòng. Với kiểm tra tính hợp lý, ta dùng giá trị noul của Jev.
Trong cùng module đó, truyền hai giá trị ấy dưới dạng reading và plausible vào hàm sau. Hàm trả về lý do cần gửi dòng đi kiểm duyệt, hoặc mảng rỗng khi không kiểm tra nào gắn cờ. Các quy tắc demo này cũng gắn cờ khi điểm bị thiếu hoặc không hợp lệ:
const valid = n => Number.isFinite(n) && n >= 0 && n <= 1;

function reviewReasons(reading, plausible) {
  return [
    ...(!valid(reading) || reading < 0.90 ? ["Verify source reading"] : []),
    ...(!valid(plausible) || plausible < 0.50 ? ["Review instruction"] : [])
  ];
}
Ở đây, điểm đọc dưới 0,90 hoặc câu trả lời hợp lý dưới 0,50 sẽ kích hoạt kiểm duyệt. Đây chỉ là các ngưỡng ví dụ: hãy thử nghiệm chúng với những tài liệu đã được kiểm duyệt thủ công trước khi dùng trong môi trường thực tế. Những câu trả lời Jev gần mức 0,50 cũng có thể cần xem lại vì cả "có" lẫn "không" đều không chiếm ưu thế rõ ràng.
Hãy giữ cả hai lý do khi cả hai kiểm tra đều thất bại. Một hướng dẫn hợp lý vẫn có thể chứa văn bản bị đọc sai, nên điểm Jev cao không được xóa bỏ điểm Unsiloed thấp. Lưu lại bản trích xuất gốc cùng yêu cầu và phản hồi của Jev bên cạnh quyết định của người kiểm duyệt, để sau này có thể tra cứu vì sao một dòng bị gắn cờ và nó đã được xử lý ra sao.
 Minh họa demo trích xuất đơn thuốc
Theo chân các dòng bị gắn cờ từ trích xuất tới kiểm duyệt
Hãy lần theo kết quả API đã lưu để thấy Unsiloed đọc gì, Jev kiểm tra gì, và vì sao hai dòng bị gắn cờ lại cần những kiểu kiểm duyệt khác nhau.
Với liều cetirizine bị dính bẩn, Unsiloed trích xuất "1 tablet" với điểm extraction 0,74 và điểm grounding 0,76. Jev trả về 0,94 cho tính hợp lý, nhưng nó không hề thấy vết bẩn. Phán đoán đó phụ thuộc vào việc văn bản được trích xuất có đúng hay không. Kiểm tra đọc vẫn gắn cờ dòng này vì phải có người xác nhận ký tự bị che khuất.
Dòng ibuprofen thì ngược lại. Unsiloed đọc "10 tablets, three times daily" với cả hai điểm đều 0,99; Jev trả về 0,04 cho cùng câu hỏi hợp lý. Người kiểm duyệt cần điều tra hướng dẫn in rõ ràng này. Cả hai mô hình đều không tự thay thế bằng một liều mà chúng cho là đúng ý định.
Mỗi kiểm tra gắn cờ một nhu cầu kiểm duyệt mà kiểm tra kia bỏ sót. Bốn dòng còn lại đều vượt cả hai ngưỡng demo. Các phần giải thích và nhãn định tuyến đến từ ứng dụng của chúng ta; Jev chỉ trả về câu trả lời có kiểu dữ liệu, không trả về những lời giải thích đó.
Điểm mấu chốt: một hướng dẫn hợp lý về mặt logic vẫn có thể chứa lỗi đọc, và một văn bản đọc chính xác tuyệt đối vẫn có thể vô lý về mặt nội dung. Chỉ kết hợp hai lớp kiểm tra mới bao phủ được cả hai loại lỗi.
Jev tốn thêm bao nhiêu cho mỗi tài liệu
Một danh sách thuốc trong demo này tạo ra yêu cầu Jev với sáu câu hỏi và 1.812 token đầu vào. Với mức giá công bố của Jev 1.13.0 là 42 USD cho mỗi tỷ token đầu vào, và đầu ra miễn phí, chi phí phát sinh là khoảng 0,000076 USD mỗi tài liệu. Xử lý 100.000 tài liệu tương tự sẽ tốn thêm khoảng 7,61 USD tiền Jev.
Đây chỉ là ước tính riêng cho Jev; chi phí trích xuất Unsiloed và kiểm duyệt thủ công được tính riêng. Chi phí thực tế phụ thuộc vào văn bản và câu hỏi bạn gửi đi. Để ước tính sát hơn, hãy lấy input_tokens từ một phản hồi Jev đại diện rồi áp mức giá công bố.
Với các đội ngũ xây dựng quy trình xử lý tài liệu — từ hóa đơn, sao kê ngân hàng tới chứng nhận bảo hiểm — cách tiếp cận hai lớp này là một hướng đáng cân nhắc: một lớp lo việc đọc chính xác, một lớp lo việc đánh giá nội dung có hợp lý hay không.
Bài viết liên quan
Công nghệ
Nghệ thuật Dithering và Phong cách Retro cho Web: Khi Shader Đưa Bạn Về Thập Niên 90
13 tháng 10, 2026
Công nghệ
Lập trình viên có phải là 'lao động phổ thông' từ trước đến nay?
13 tháng 10, 2026
Công nghệ
Văn phòng Nội các Anh thiệt hại 7,8 triệu bảng vì hủy hệ thống tuyển dụng, đối mặt án phạt 8,9 triệu bảng do IR35
13 tháng 10, 2026