Lakegres ra mắt tìm kiếm vector trên bảng Hudi và Iceberg
Onehouse công bố Lakegres hỗ trợ tìm kiếm vector với chỉ mục lưu ngay trong metadata của bảng Hudi và Iceberg hiện có. Cách làm này bỏ bước sao chép dữ liệu hồ sang cơ sở dữ liệu riêng, đồng thời giữ nguyên các tệp dữ liệu gốc.
Onehouse vừa công bố tính năng tìm kiếm vector trong Lakegres. Chỉ mục vector nằm ngay trong metadata của bảng mở, không tách thành dịch vụ riêng. Người dùng truy vấn embedding qua một điểm cuối Postgres trên chính bảng đang có trong hồ dữ liệu (data lake).
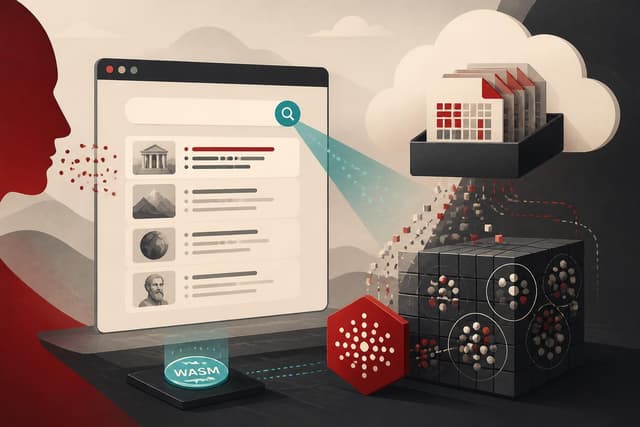
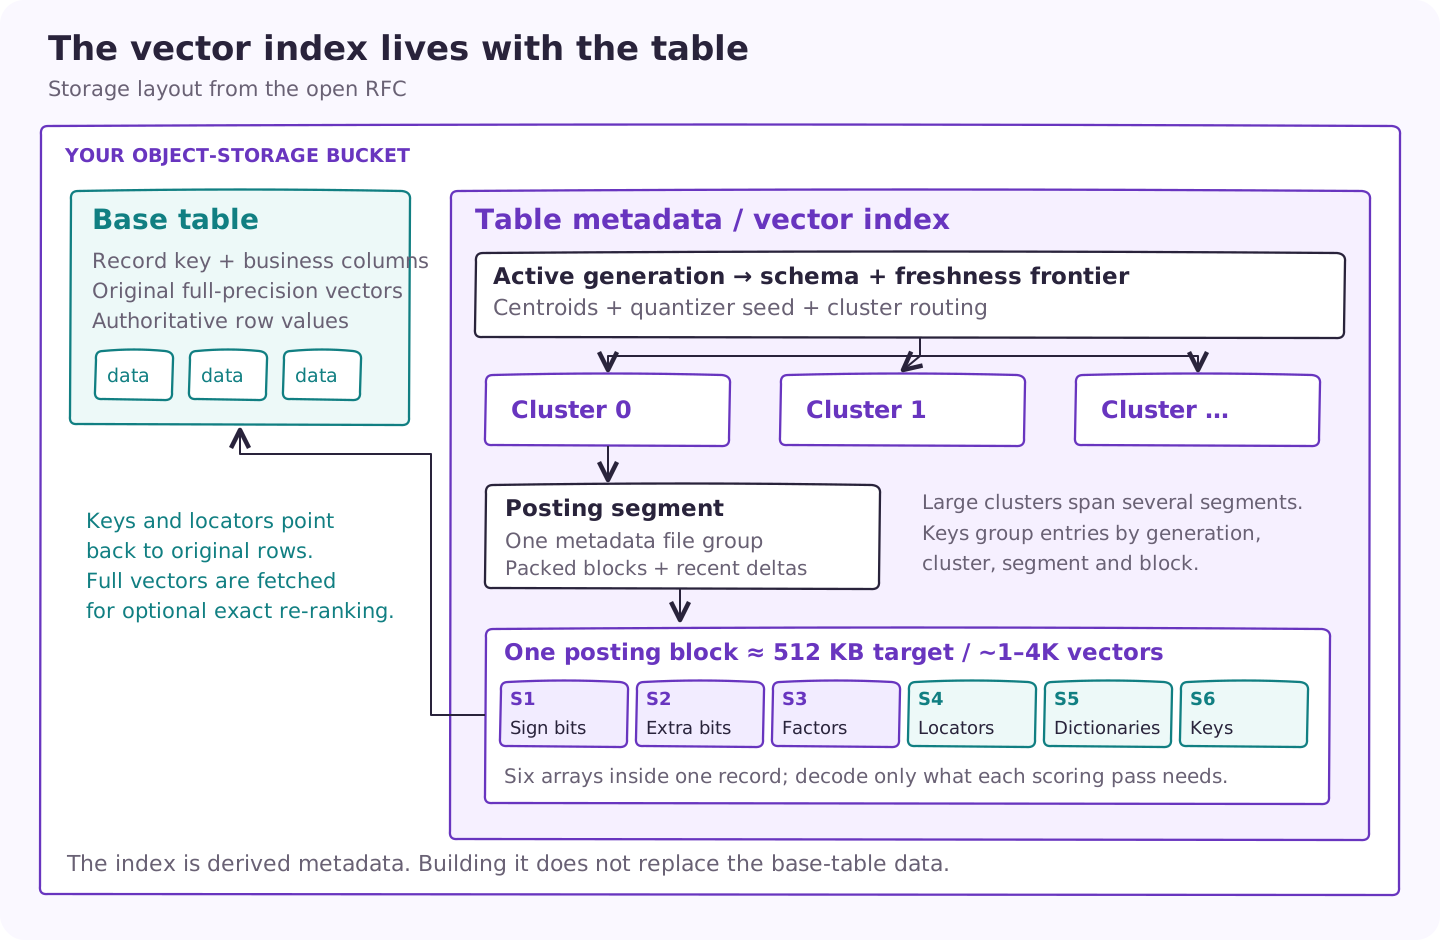 Sơ đồ bố trí chỉ mục vector
Vì sao cần tìm kiếm vector trên hồ dữ liệu
Những năm gần đây, muốn thêm tìm kiếm vector thường phải dựng một cơ sở dữ liệu riêng. Postgres có pgvector, OpenSearch có k-NN, MySQL, Oracle, MongoDB và SQL Server cũng có cách làm riêng. Tìm kiếm tương đồng đã trở thành một loại chỉ mục tiêu chuẩn cho dữ liệu ứng dụng.
Nhưng phần lớn dữ liệu mà các tác nhân AI (agent) cần truy vấn lại nằm trong hồ dữ liệu. Biên bản hỗ trợ, log, tài liệu, danh mục sản phẩm và lịch sử sự kiện nhiều năm được lưu trong các bảng mở trên lưu trữ đối tượng. Những tập dữ liệu này lớn hơn một phiên bản Postgres thông thường 100 đến 1.000 lần.
Muốn tìm kiếm bằng các cơ sở dữ liệu kể trên, trước tiên phải sao chép dữ liệu vào. Vừa tốn chi phí lưu hai lần, vừa phải vận hành đường ống đồng bộ liên tục.
Cách các nhà cung cấp khác đang làm
Các hãng lakehouse và kho dữ liệu cũng đã bổ sung tìm kiếm vector, nhưng đều đặt chỉ mục ngoài bảng mở:
- Snowflake: Cortex Search chạy như một dịch vụ đồng bộ từ bảng. Cột VECTOR đứng riêng chỉ tìm được bằng cách quét toàn bộ, và không hỗ trợ trên bảng Iceberg.
- Databricks: AI Search đồng bộ bảng Delta sang một điểm cuối phục vụ, chỉ mục nằm trên lưu trữ do Databricks quản lý.
- AWS: S3 Vectors lưu vector trong một loại bucket chuyên dụng, tách khỏi S3 Tables chứa Iceberg.
- Google BigQuery: chỉ mục IVF và TreeAH chỉ dựng được trên bảng chuẩn, không có trên bảng Iceberg.
- VAST Data: vector nằm trong Element Store riêng, bên ngoài định dạng Hudi hay Iceberg.
Hệ quả: khi chuyển sang công cụ khác, phải dựng lại toàn bộ chỉ mục theo định dạng của nhà cung cấp mới, dù bảng gốc vẫn mở.
Giới hạn của chỉ mục đồ thị khi dữ liệu lên hàng tỷ vector
Phần lớn tìm kiếm vector đang chạy trên OpenSearch hoặc Postgres, cả hai dùng chỉ mục HNSW (một cấu trúc đồ thị). HNSW chỉ nhanh khi toàn bộ đồ thị nằm trong bộ nhớ RAM.
Công thức tính dung lượng của AWS cho OpenSearch là 1,1 × (4 × số chiều + 8 × m) byte RAM cho mỗi vector. Bảng thử nghiệm của Onehouse có 247 triệu vector, 1.024 chiều. Với m bằng 16, cần khoảng 1,15 TB bộ nhớ cho một bảng, và khoảng 46 TB nếu lên 10 tỷ vector.
Chỉ mục HNSW của pgvector trong Postgres cũng phải nằm trong bộ đệm dùng chung hoặc bộ đệm trang thì mới nhanh. Độ trễ tăng vọt khi tập dữ liệu vượt quá RAM. Duyệt đồ thị cũng không hợp với lưu trữ đối tượng, vì mỗi bước nhảy là một lần đọc ngẫu nhiên nhỏ.
Quy mô hồ dữ liệu lớn hơn nhiều: LinkedIn từng báo cáo 1 exabyte trên các cụm Hadoop năm 2021, hồ của Uber chứa 350 petabyte và nạp 6.000 tỷ dòng mỗi ngày, Pinterest chạy hồ 500 petabyte trên Iceberg. Giữ hàng tỷ vector trong RAM là quá đắt với phần lớn đội ngũ.
Lakegres lưu chỉ mục ở đâu
Lakegres lưu chỉ mục vector trong metadata của bảng, cùng bucket với các tệp dữ liệu. Mỗi lần ghi thêm, cập nhật hay xóa dòng cũng cập nhật chỉ mục. Nhờ vậy chỉ mục luôn khớp với bảng, không cần tác vụ đồng bộ riêng và không cần bản sao thứ hai của vector.
Theo Onehouse, đây là chỉ mục tìm kiếm vector mở duy nhất hiện có cho bảng Hudi và Iceberg sẵn có, được duy trì cùng với thao tác ghi bảng và không đụng đến các tệp dữ liệu.
Phần hỗ trợ Iceberg dựa trên công việc đánh chỉ mục nền Hudi trong Apache XTable (đang ấp ủ). Thiết kế được phát triển công khai với các kỹ sư của Uber và Walmart để phục vụ bảng quy mô rất lớn của họ. Bản RFC mở ghi lại cách bố trí lưu trữ, đường truy vấn và mô hình nhất quán.
Thiết kế đã chốt và có trong Lakegres từ bản hiện tại. Phần triển khai Hudi đang được đưa lên nguồn mở, XTable đang ở giai đoạn thử nghiệm bản phát hành ứng viên.
Cách hoạt động
Thêm hoặc bỏ chỉ mục mà không viết lại bảng. Chỉ mục vector là metadata phái sinh. Có thể dựng nó trên bảng Hudi hoặc Iceberg đã có cột vector mà không phải viết lại tệp dữ liệu. Thử nghiệm xong có thể dựng lại với tham số khác hoặc xóa đi. Các truy vấn phân tích hiện tại vẫn chạy bình thường.
Phân cụm để giới hạn vùng đọc. Khi dựng chỉ mục, thuật toán k-means gom vector quanh các điểm đại diện gọi là tâm cụm (centroid). Mỗi vector được gán vào một cụm và mã hóa tương đối so với tâm bằng lượng tử hóa RaBitQ, dùng phép xoay ngẫu nhiên cố định với mã 1 đến 8 bit mỗi chiều, mặc định 4 bit. Mã lưu hỗ trợ tính khoảng cách L2, cosine và tích vô hướng.
Mỗi cụm chia thành các đoạn posting, mỗi đoạn nằm trong một nhóm tệp metadata. Trong một đoạn, khoảng 1.000 đến 4.000 mục vector được gói vào một khối khoảng 512 KB. Mỗi khối là một bản ghi metadata gồm sáu mảng: bit dấu, bit chính xác bổ sung, hệ số hiệu chỉnh, vị trí dòng, từ điển và khóa bản ghi.
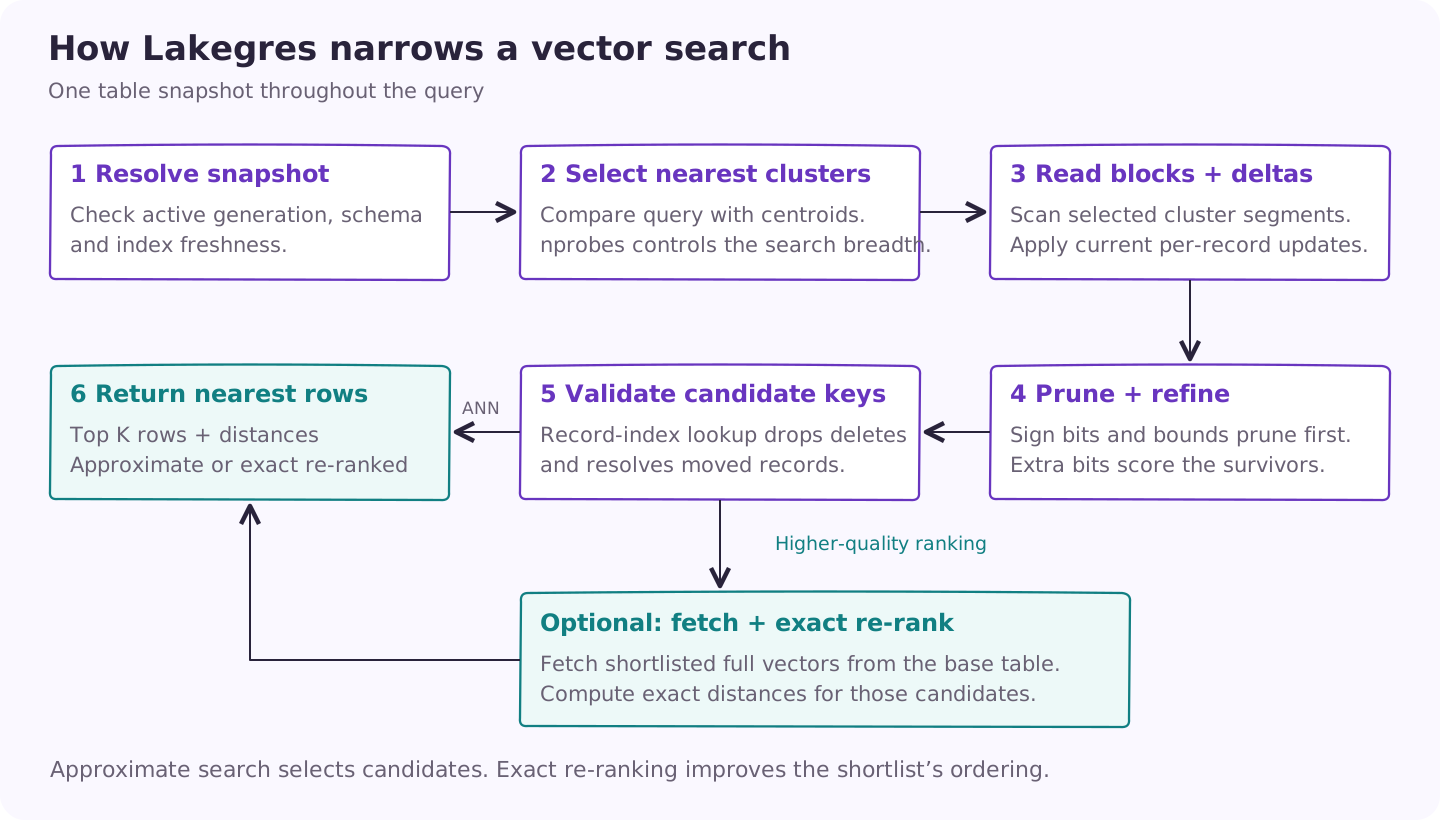 Đường truy vấn của chỉ mục vector
Bộ đọc lấy cả khối trong một lần, sau đó giải mã chọn lọc từng mảng để giảm công tính điểm. Lượt chấm điểm đầu chỉ giải mã bit dấu và hệ số. Các lượt sau mới giải mã bit bổ sung và danh tính dòng cho những ứng viên còn lại.
Thu hẹp ứng viên trước khi lấy vector đầy đủ. Lakegres so vector truy vấn với các tâm cụm và mở các cụm gần nhất. Tham số nprobes quyết định số cụm được mở: mở nhiều thì độ phủ (recall) cao hơn nhưng tốn công hơn. Trong các cụm đó, lượt đầu dùng ước lượng một bit và biên sai số để loại ứng viên không thể vượt danh sách rút gọn. Lượt hai dùng các bit còn lại để tinh chỉnh.
Trước khi trả kết quả, bộ đọc đối chiếu khóa ứng viên với chỉ mục bản ghi tại ảnh chụp (snapshot) của truy vấn. Ứng viên đã xóa bị loại, dòng đã di chuyển được đưa về vị trí hiện tại. Chế độ xếp hạng lại chính xác (tùy chọn) đọc vector đầy đủ của danh sách rút gọn từ bảng gốc để tính khoảng cách.
Chỉ mục bám theo thay đổi của bảng. Khi một vector thay đổi, bộ ghi đánh dấu mục cũ là đã xóa và thêm mục mới. Khi một dòng di chuyển, vị trí của nó trong chỉ mục được cập nhật. Truy vấn đọc các khối đóng gói cùng các cập nhật này, dùng mục mới nhất cho mỗi bản ghi. Tác vụ nén định kỳ gộp các cập nhật vào khối.
Trước khi tìm kiếm, bộ đọc kiểm tra lịch sử commit của bảng để chắc chỉ mục đã chứa các thao tác ghi mà ảnh chụp yêu cầu. Chỉ mục cũ hoặc không tương thích sẽ không phục vụ được truy vấn: tùy cấu hình, truy vấn báo lỗi hoặc quét bảng để lấy kết quả chính xác.
Có thể dựng lại chỉ mục trong lúc truy vấn vẫn chạy. Bản mới được tạo song song với bản hiện tại và tiếp nhận các thao tác ghi phát sinh trong lúc dựng. Khi xong, một lần commit metadata đưa bản mới vào phục vụ một cách nguyên tử, truy vấn không bao giờ đọc chỉ mục dựng dở.
Kết quả đo
Onehouse dùng bộ dữ liệu embedding Wikipedia đa ngôn ngữ công khai của Cohere: 247.154.006 đoạn văn, vector 1.024 chiều do Cohere Embed v3 tạo, bảng chiếm khoảng 1 TB trên S3. Đối thủ so sánh là Databricks AI Search ở hạng lưu trữ tối ưu (storage-optimized), dành cho dữ liệu lớn.
Mỗi hệ thống chạy cùng 200 truy vấn tìm 10 láng giềng gần nhất, lần lượt từng truy vấn. Độ phủ được chấm so với kết quả quét toàn bộ chính xác.
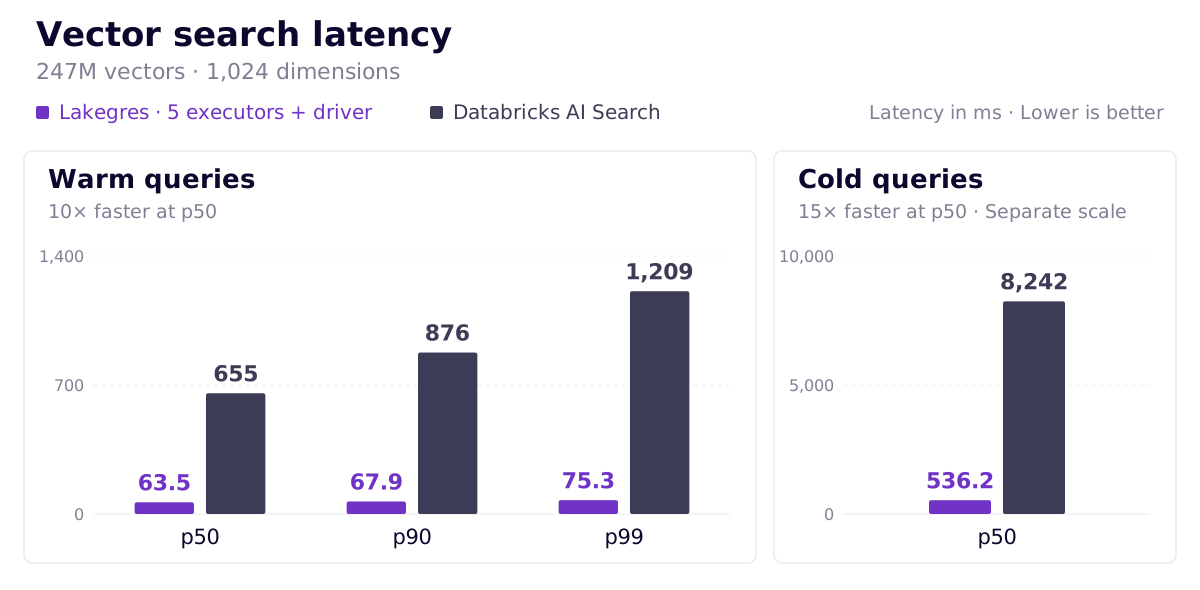 So sánh độ trễ truy vấn
- Với truy vấn đã làm nóng (warm), Lakegres trả kết quả trong 63,5 ms ở p50, 67,9 ms ở p90 và 75,3 ms ở p99. Databricks AI Search mất 655 ms, 876 ms và 1.209 ms.
- Truy vấn nguội (cold): p50 là 536,2 ms với Lakegres và 8.242 ms với AI Search.
- Recall@10 là 0,95 với Lakegres và 0,952 với AI Search.
- Thời gian dựng chỉ mục: 18 phút với Lakegres, khoảng 3 giờ 10 phút với AI Search.
Lakegres chạy trên 5 nút thực thi m8gd.4xlarge và 1 nút điều khiển r8gd.4xlarge. AI Search chạy trên 6 đơn vị lưu trữ tối ưu với 1 bản sao, phần cứng không hiển thị cho khách hàng. Nhóm tác giả dùng số đo độ trễ phía máy chủ của Databricks cho AI Search và đo bằng psql phía máy khách cho Lakegres, nên hai phép đo bao gồm các phần khác nhau của quá trình truy vấn.
Chi phí hạ tầng AWS của Lakegres khoảng 5,79 USD/giờ theo giá on-demand vùng US East, chưa gồm phí Onehouse; 6 đơn vị AI Search tốn 7,68 USD/giờ. Onehouse lưu ý đây không phải phép so sánh tổng chi phí.
Dùng thử
Tạo chỉ mục bằng câu lệnh CREATE INDEX:
CREATE INDEX embedding_idx ON wiki_passages
USING VECTOR (embedding)
OPTIONS (
  `vector.metric` = 'l2',
  `vector.num_clusters` = '65536',
  `vector.rabitq.bits` = '4'
);
Tìm kiếm bằng hàm bảng từ bất kỳ máy khách Postgres nào. Hàm trả về các dòng gần nhất kèm khoảng cách. Tham số nprobes điều khiển số cụm được mở, tức điểm cân bằng chính giữa độ trễ và độ phủ.
SELECT id, _distance
FROM vector_search(
  'wiki_passages', 'embedding',
  ARRAY[0.12, -0.03, 0.44],
  10, 'l2', 'ivf_rabitq_mdt',
  'vector.query.nprobes=128'
);
Những gì còn thiếu
Khoảng 20 đến 25 ms trong mỗi truy vấn bị tiêu vào Spark, ở khâu lập kế hoạch và điều phối tác vụ, trước khi đọc khối chỉ mục nào. Onehouse đã thiết kế cách loại bỏ phần chi phí cố định này khỏi tra cứu chỉ mục và dự định triển khai tiếp.
Bản đầu tiên chỉ hỗ trợ lọc qua cắt tỉa phân vùng (partition pruning). Chưa hỗ trợ kết hợp điều kiện tùy ý với tìm láng giềng gần nhất.
Góc nhìn
Với kỹ sư dữ liệu Việt Nam, điểm đáng giá nhất là bỏ được đường ống sao chép dữ liệu sang cơ sở dữ liệu vector riêng. Những đội đang giữ log, tài liệu hay danh mục sản phẩm trong Hudi hoặc Iceberg có thể thử tìm kiếm vector mà không phải dựng thêm hệ thống. Chỉ mục nằm cùng bucket nên bài toán đồng bộ và chi phí lưu trùng biến mất.
Tuy vậy, công cụ này chưa thay thế được các hệ chuyên dụng khi cần lọc phức tạp kèm tìm kiếm tương đồng. Các đội nên thử trên bảng nhỏ trước, đo độ phủ và độ trễ với dữ liệu thật của mình. Vì thiết kế được công bố công khai qua RFC, việc theo dõi Apache XTable cũng giúp chuẩn bị cho lúc chỉ mục này xuất hiện trong các công cụ mã nguồn mở khác.
Nguồn: onehouse.ai · Quy trình biên tập