Parsimony: Chuẩn mở đánh giá lượng mã mà các mô hình AI viết thêm
Parsimony là một dự án mã nguồn mở mới ra mắt, nhằm đo lường lượng mã mà các mô hình AI thêm vào codebase khi giải quyết bài toán lập trình. Khác với các benchmark hiện có chỉ đo tỷ lệ giải quyết và chi phí token, Parsimony tính toán các đơn vị mã ròng (thêm vào trừ đi đã xóa), giúp đánh giá mức độ "phình" mã nguồn mà AI tạo ra — yếu tố ảnh hưởng trực tiếp đến khả năng bảo trì lâu dài.
Trong bối cảnh các mô hình AI ngày càng được tin dùng để viết mã, một câu hỏi quan trọng thường bị bỏ qua: liệu AI có đang viết quá nhiều mã không? Một dự án mã nguồn mở mới có tên Parsimony ra mắt trên Hacker News đang cố gắng trả lời câu hỏi đó.
Vấn đề mà các benchmark hiện tại chưa giải quyết
Các benchmark lập trình phổ biến như SWE-bench Verified, SWE-bench Live hay DeepSWE chủ yếu đo hai chỉ số: tỷ lệ giải quyết bài toán (solve rate) và chi phí token. Tuy nhiên, theo tác giả dự án, chúng không hề trừ điểm những mô hình viết ra lượng mã dư thừa.
"Các benchmark hiện có đo tỷ lệ giải quyết và chi phí token, nhưng không trừng phạt việc viết mã thừa — điều khiến codebase trở nên khó làm việc hơn về lâu dài."
Đây là vấn đề thực tế mà nhiều đội phát triển tại Việt Nam cũng đang gặp: AI có thể giải đúng bài toán, nhưng nếu mỗi lần như vậy nó lại đắp thêm hàng trăm dòng mã không cần thiết, codebase sẽ nhanh chóng trở nên cồng kềnh và khó bảo trì.
Parsimony đo lường như thế nào?
Thay vì đếm số dòng mã — cách đo dễ bị "đối phó" bằng cách dồn mã vào một dòng — Parsimony sử dụng khái niệm đơn vị mã (coding unit).
- Đơn vị mã là các phần tử cú pháp như câu lệnh, lời gọi hàm, phép so sánh, tên biến và hằng số.
- Không đếm số dòng, nên việc viết dồn dòng không được khuyến khích.
- Mã bị xóa được trừ đi, nghĩa là chỉ số cuối cùng là đơn vị ròng = số thêm vào − số xóa đi.
Phương pháp này tận dụng lại các bản vá (patch) mà các benchmark đã công bố. Mỗi bản vá được áp dụng lên mã nguồn của bài toán, sau đó cả hai phiên bản của mọi tệp bị thay đổi đều được phân tích cú pháp. Toàn bộ quá trình không chạy mã, chỉ phân tích tĩnh.
Một số giới hạn được tác giả nêu rõ:
- Chỉ đo Python.
- Bỏ qua các tệp kiểm thử, tài liệu và tệp sinh tự động.
- Kết quả đúng/sai lấy từ công bố của SWE-bench, không chạy lại kiểm thử.
Bảng xếp hạng và cách đọc kết quả
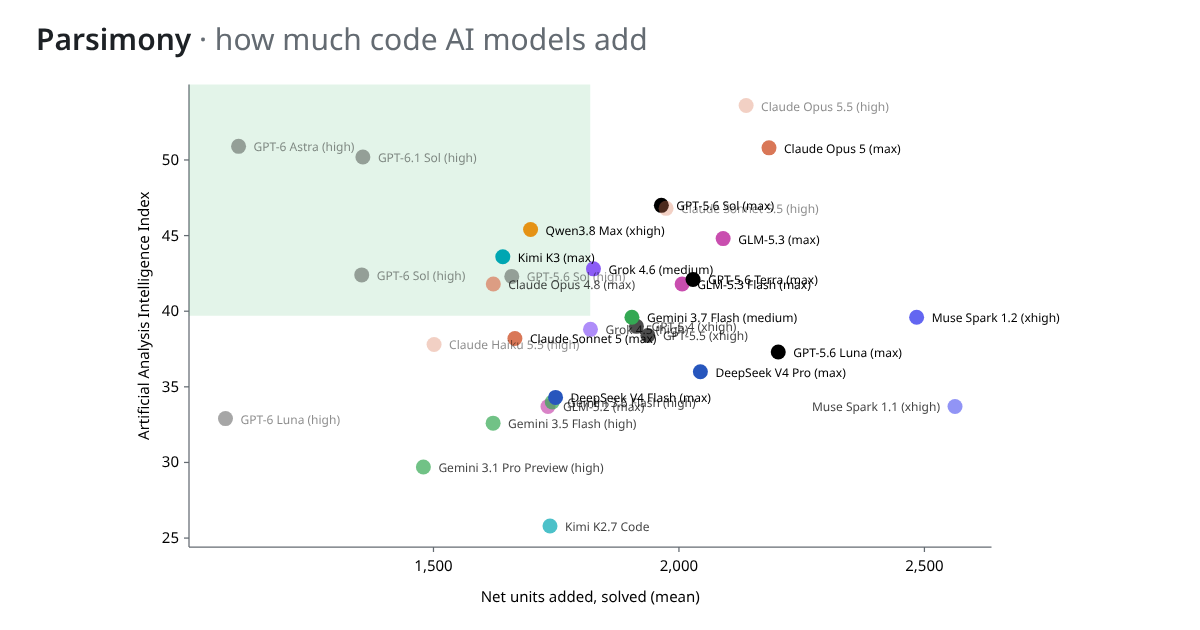
Các mô hình được xếp hạng theo số đơn vị ròng trung bình trên những bài toán chúng giải được, thấp nhất đứng đầu. Điều này có nghĩa: mô hình giải đúng bài toán với ít mã thêm hơn sẽ được đánh giá cao hơn.
Chỉ số Artificial Analysis Intelligence Index cũng được hiển thị để tham chiếu, nhưng không ảnh hưởng đến thứ hạng của Parsimony.
Đáng chú ý, tác giả tự chạy thử GPT-6 và Claude 5.5 trên 3–10 tác vụ DeepSWE Python bằng gói đăng ký cá nhân, vì các mô hình này chưa có bản vá công khai. Những kết quả này được hiển thị dưới dạng vòng tròn mờ và không được xếp hạng chính thức. Một chi tiết thú vị: khi chạy GPT-5.6 Sol theo cách riêng, lượng mã thêm vào chỉ bằng 0,88 lần so với bản công bố.
Những điều cần lưu ý
Tác giả cũng thẳng thắn thừa nhận các hạn chế của phương pháp:
- Ít hơn không phải lúc nào cũng tốt hơn: đơn vị mã đo kích thước, không đo khả năng đọc hiểu hay chất lượng thiết kế.
- Các mô hình viết nhiều mã hơn thường cũng giải được nhiều bài toán hơn (tương quan Spearman 0,33–0,60 trên các bảng có từ 26 mô hình trở lên).
- Mọi mô hình đều dùng chung một agent (mini-SWE-agent), nhưng bản thân agent vẫn ảnh hưởng đến lượng mã được viết ra.
Cộng đồng có thể đóng góp gì?
Parsimony khuyến khích cộng đồng tham gia bằng cách:
- Gửi phản hồi về phương pháp đo lường.
- Đóng góp kết quả từ các mô hình mới, đặc biệt là các bản vá công khai.
- Tải tệp JSON mẫu, điền kết quả từ benchmark khác và mở trực tiếp trên trình duyệt — dữ liệu không rời khỏi máy người dùng.
Dự án được phát triển trên GitHub tại github.com/La5u/Parsimony và không liên kết với bất kỳ benchmark nào trong số những benchmark được sử dụng làm nguồn dữ liệu.
Ý nghĩa với cộng đồng lập trình viên Việt Nam
Với các đội phát triển phần mềm tại Việt Nam đang ngày càng tích hợp AI vào quy trình làm việc, Parsimony mang lại một góc nhìn đáng suy ngẫm: hiệu quả của AI không chỉ nằm ở việc giải đúng bài toán, mà còn ở việc giữ cho mã nguồn gọn gàng, dễ bảo trì. Một mô hình giải đúng nhưng viết thừa mã có thể tiết kiệm thời gian trước mắt, nhưng lại tạo ra nợ kỹ thuật về sau. Công cụ mã nguồn mở như Parsimony có thể trở thành tham chiếu hữu ích khi các nhóm cân nhắc lựa chọn mô hình AI cho dự án dài hạn.