
Sáu mô hình AI của bạn thực ra chỉ đáng hai: Bài toán của những sai lầm tương quan
Khi nhiều mô hình AI cùng trả lời một câu hỏi, số phiếu bầu thực sự độc lập thường ít hơn rất nhiều so với số mô hình. Một công thức toán học cho phép đo chính xác con số này, và tác giả đã kiểm chứng trên sáu mô hình mã nguồn mở cùng 1.500 câu hỏi trắc nghiệm.
Sáu mô hình AI của bạn thực ra chỉ đáng hai: Bài toán của những sai lầm tương quan
Trong thế giới AI hiện đại, một kỹ thuật phổ biến là dùng nhiều mô hình cùng trả lời một câu hỏi rồi bỏ phiếu theo đa số, với hy vọng có được câu trả lời chính xác hơn. Nhưng một nghiên cứu gần đây cho thấy niềm tin này có thể là ảo tưởng: sáu mô hình AI hàng đầu khi bỏ phiếu chỉ tương đương với chưa đầy hai ý kiến độc lập thực sự.
 Minh họa bỏ phiếu giữa nhiều mô hình AI
Lời hứa của bỏ phiếu và cái bẫy "học chung tài liệu"
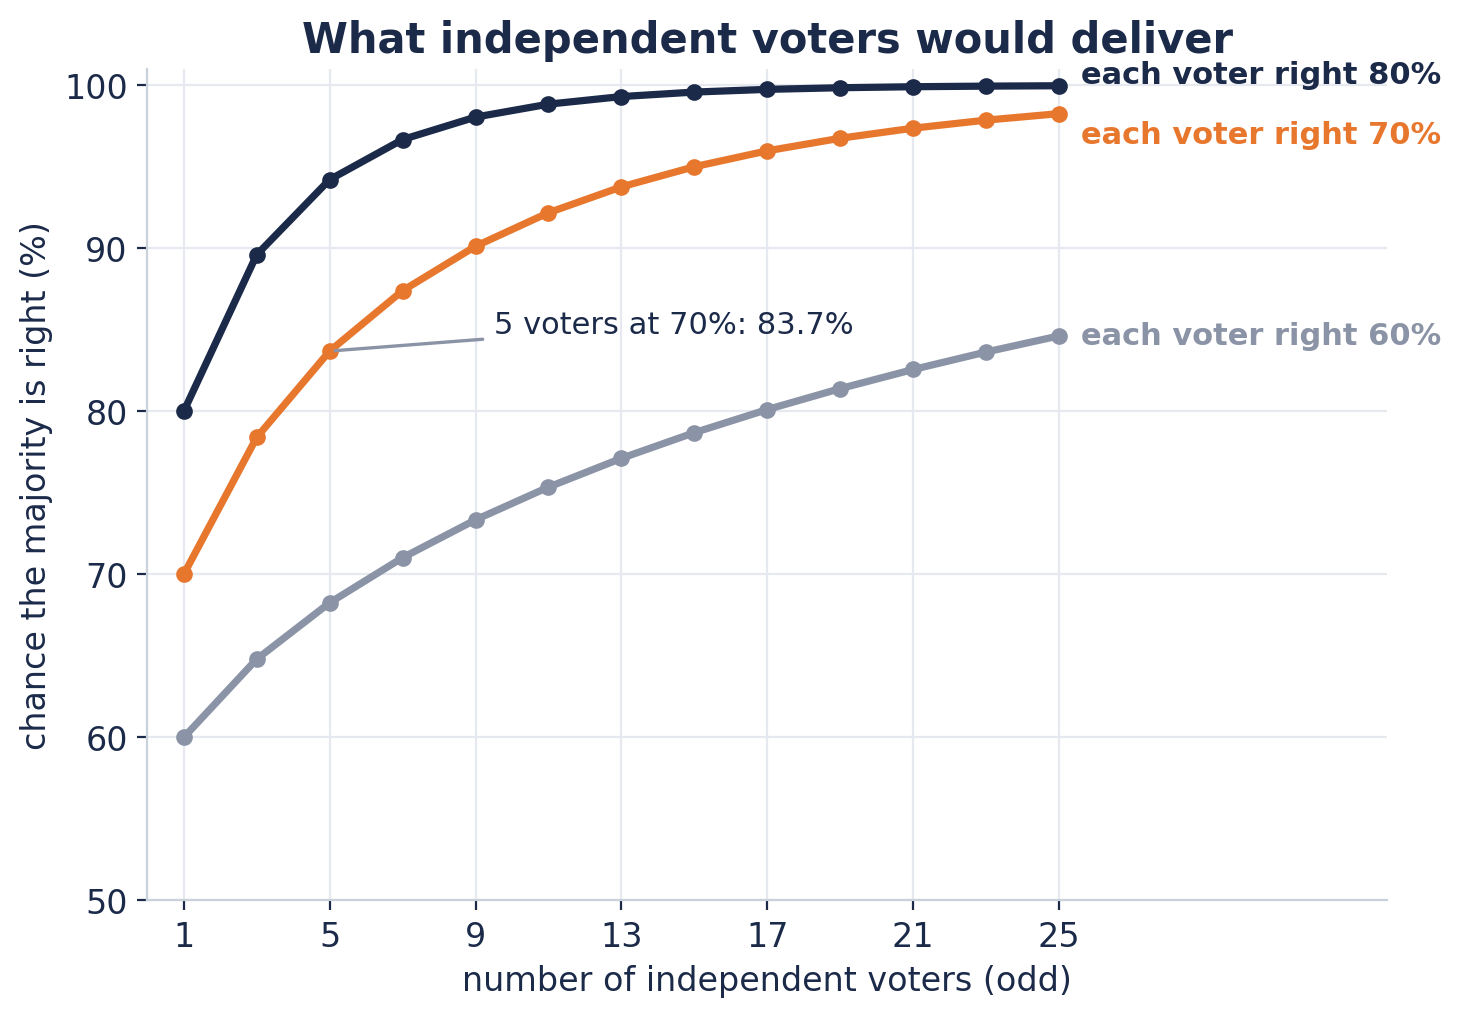
Niềm tin vào bỏ phiếu tập thể có gốc rễ từ định lý bồi thẩm đoàn Condorcet năm 1785. Theo định lý này, nếu mỗi cử tri đúng với xác suất p > 1/2 và các cử tri hoàn toàn độc lập, thì xác suất đa số đúng sẽ tiến dần về 1 khi số người bỏ phiếu tăng lên. Với p = 0.7, ba người cho kết quả đúng 78,4%, chín người đạt 90,1%, và 25 người đạt tới 98,3%.
Nhưng con số đẹp đẽ này phụ thuộc hoàn toàn vào chữ "độc lập". Hãy tưởng tượng năm người bạn cùng học từ một bộ tài liệu có lỗi — tất cả sẽ lặp lại sai lầm đó, và đa số sẽ sai với sự tự tin tuyệt đối. Năm người, một nguồn, một lá phiếu.
Các mô hình ngôn ngữ không phải là bạn bè, nhưng nỗi lo vẫn giữ nguyên. Các mô hình được huấn luyện trên nguồn văn bản chồng lấn, với thiết kế tương tự nhau, rất có thể chia sẻ chung những điểm mù. Câu hỏi trở thành: bao nhiêu ý kiến độc lập thực sự mà bạn đang có?
Mô phỏng: khi sai lầm chồng lấn, độ chính xác bốc hơi
Tác giả đã mô phỏng hai nhóm, mỗi nhóm gồm năm mô hình, mỗi mô hình đúng 70% thời gian. Ở nhóm thứ nhất, sai lầm rơi ngẫu nhiên vào các câu hỏi. Ở nhóm thứ hai, sai lầm chồng lấn — một số câu khó với tất cả mọi người.
Kết quả: xét riêng từng mô hình, hai nhóm hoàn toàn giống nhau. Nhưng khi bỏ phiếu đa số:
- Nhóm sai lầm độc lập: đúng 83,8% (khớp với dự đoán 83,7% của định lý Condorcet).
- Nhóm sai lầm chồng lấn: chỉ đúng 74,4%.
Hơn chín điểm phần trăm độ chính xác biến mất mà không một mô hình nào trở nên tệ hơn. Nhóm thứ hai thực chất chỉ đáng 2,2 phiếu hiệu dụng so với 5,0 phiếu hiệu dụng ở nhóm đầu.
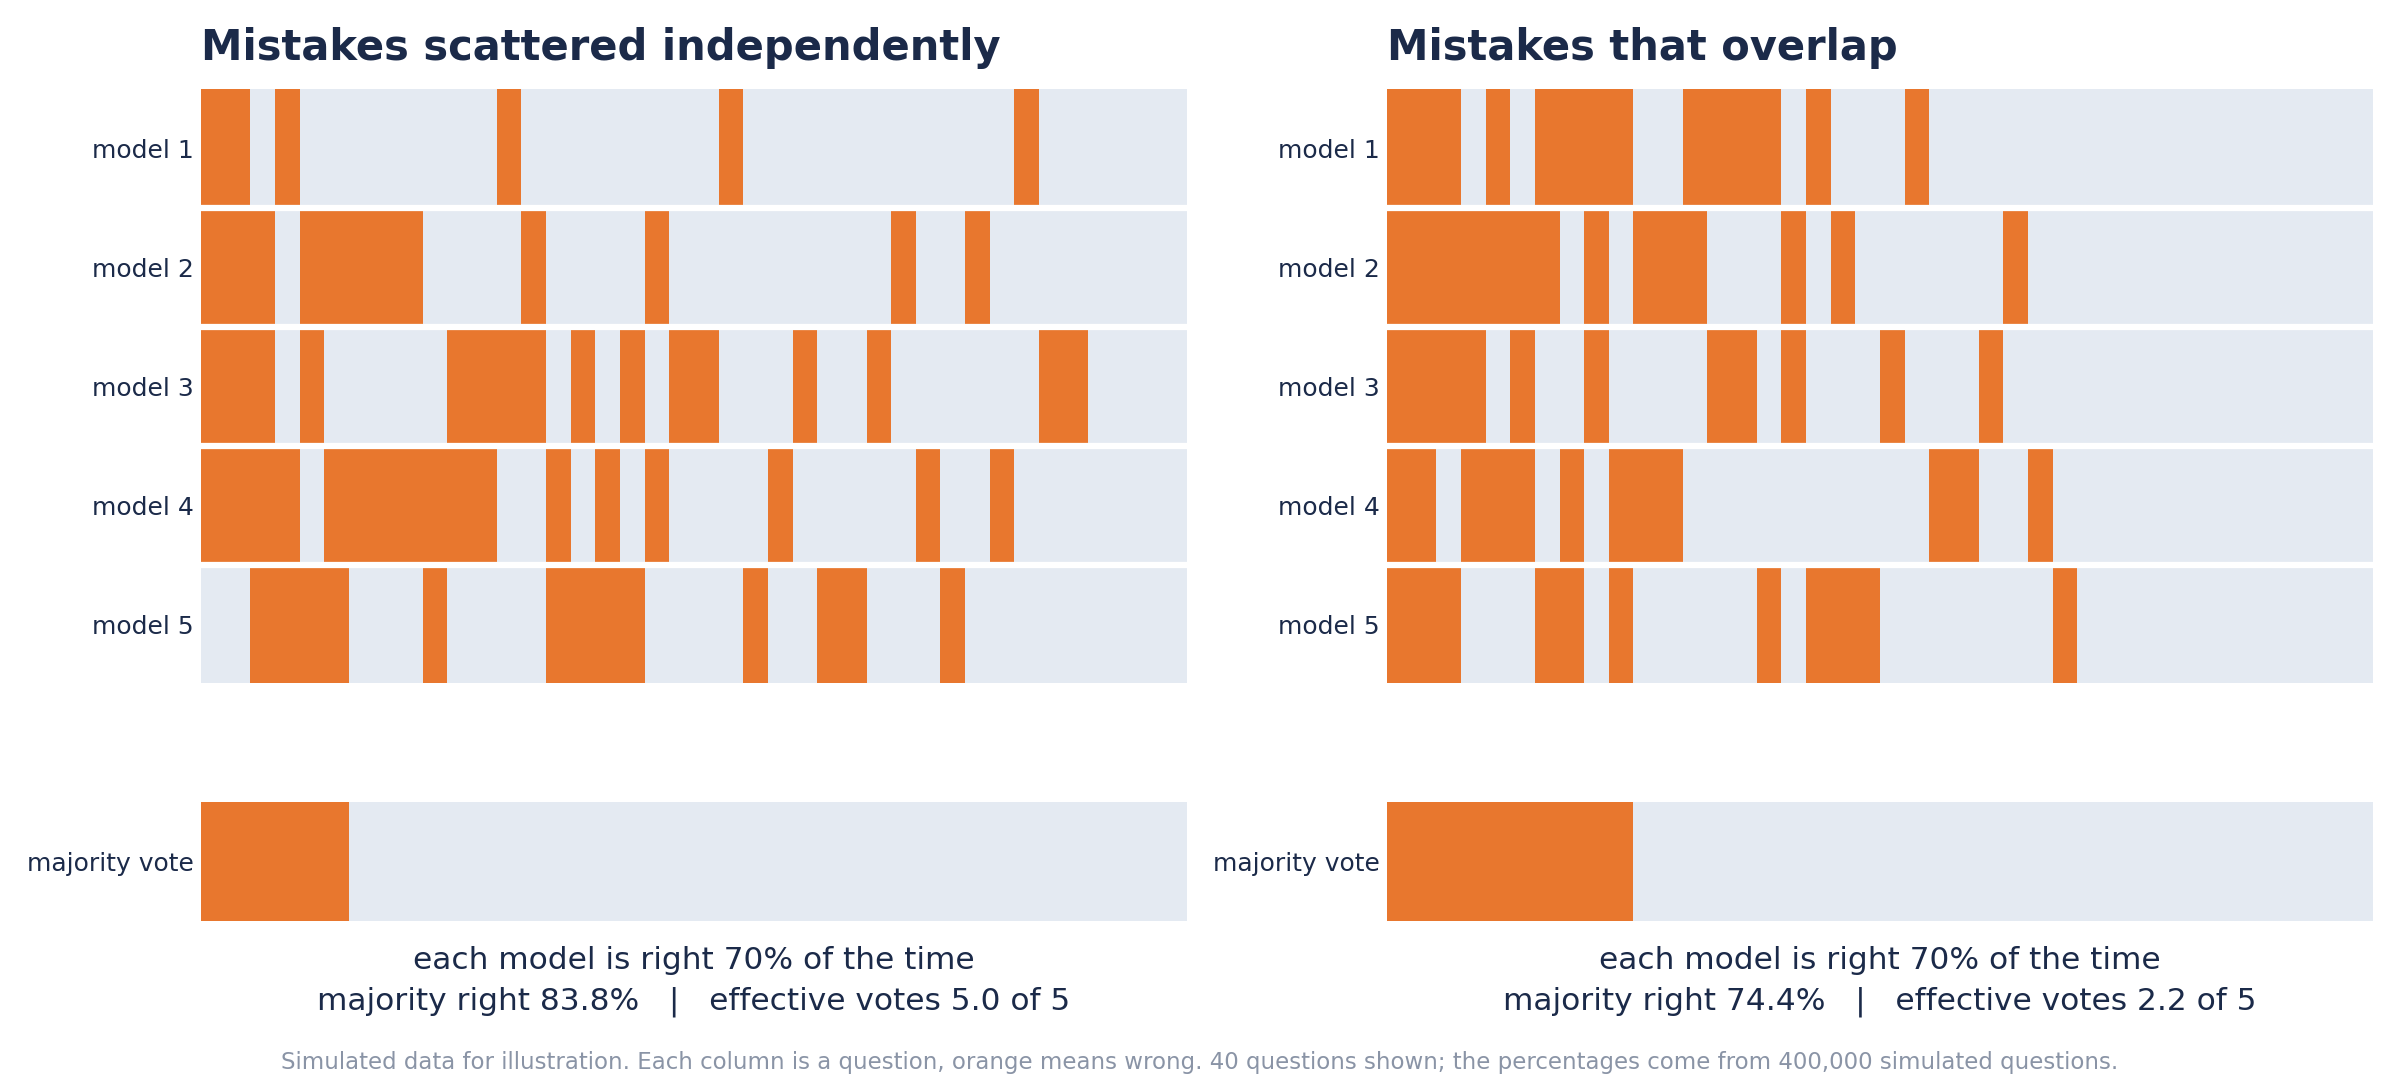 Hai nhóm mô hình: sai lầm độc lập và sai lầm chồng lấn
Một công thức đơn giản để "quy đổi" số phiếu thực
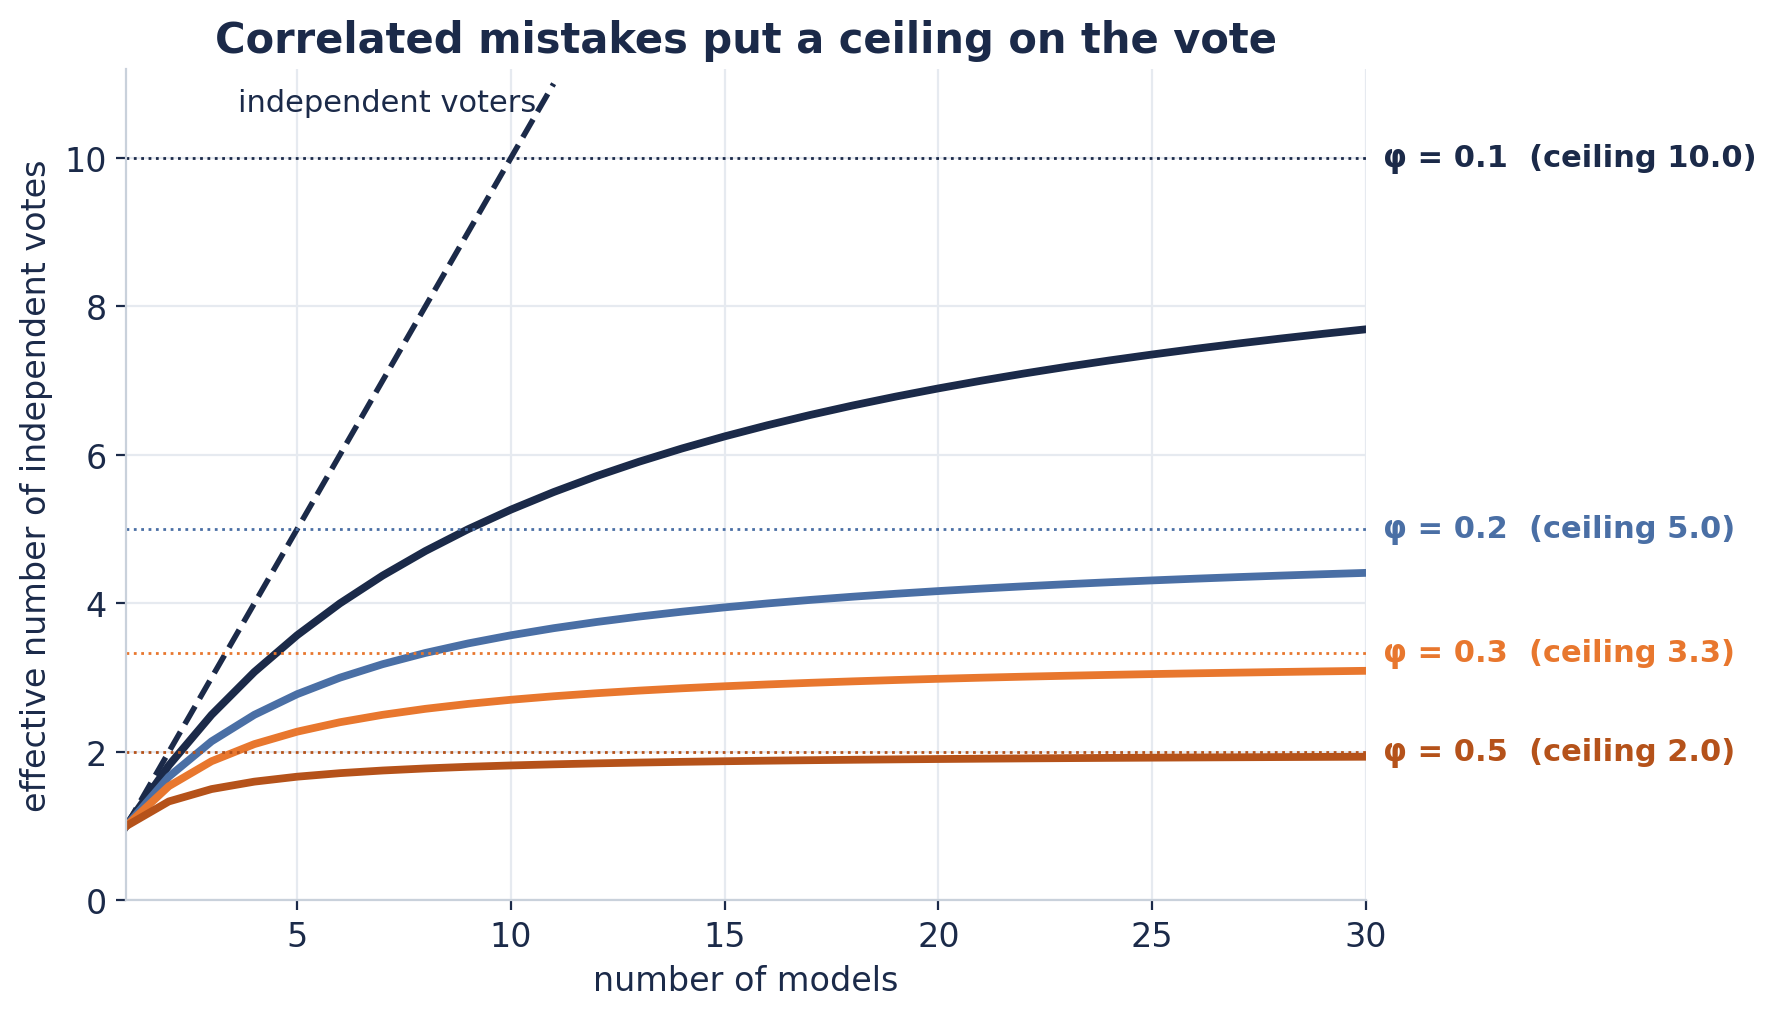
Với k cử tri có hệ số tương quan sai lầm trung bình là φ, số phiếu hiệu dụng được tính bằng:
n_eff = k / [1 + (k − 1)φ]
Khi φ = 0, mọi phiếu đều được tính. Nhưng khi k tăng, n_eff sẽ dần tiến về trần 1/φ và dừng lại. Với φ = 0,3, bảy mô hình chỉ đáng 2,5 phiếu, và dù thêm bao nhiêu mô hình tương tự, bạn cũng không bao giờ vượt quá 3,3 phiếu hiệu dụng.
| Tương quan sai lầm | 3 mô hình | 5 mô hình | 10 mô hình | Trần tối đa |
|---|---|---|---|---|
| 0,05 | 2,7 | 4,2 | 6,9 | 20 |
| 0,1 | 2,5 | 3,6 | 5,3 | 10 |
| 0,2 | 2,1 | 2,8 | 3,6 | 5 |
| 0,3 | 1,9 | 2,3 | 2,7 | 3,3 |
| 0,5 | 1,5 | 1,7 | 1,8 | 2 |
Một hệ số tương quan 0,3 nghe có vẻ khiêm tốn, nhưng nó khiến mười mô hình hoạt động như chưa đầy ba ý kiến độc lập. Đây chính là khái niệm "hiệu ứng thiết kế" mà nhà thống kê Leslie Kish đã đặt ra cho các mẫu khảo sát có phân cụm.
Kiểm chứng trên sáu mô hình thực với 1.500 câu hỏi
Tác giả đã thử nghiệm trên 1.500 câu hỏi MMLU (57 chủ đề từ toán tiểu học đến luật) với sáu mô hình mã nguồn mở từ 3 đến 4 tỷ tham số, đến từ năm nhà phát triển khác nhau: Qwen3-4B (72,7%), Phi-4-mini-instruct (67,5%), Qwen2.5-3B-Instruct (67,3%), Granite 4.1 3B (66,5%), SmolLM3-3B (60,9%) và Falcon3-3B-Instruct (58,3%).
Hai điểm quan trọng trong phương pháp:
- Đọc xác suất thay vì lấy mẫu: Mỗi mô hình được đọc xác suất mà nó gán cho các lựa chọn A, B, C, D, đảm bảo kết quả có thể tái lập chính xác.
- Khử thiên kiến chữ cái: Mỗi mô hình thấy mỗi câu hỏi với thứ tự đáp án ngẫu nhiên riêng, nhằm loại bỏ xu hướng chọn cùng một chữ cái (ví dụ mô hình 1 tỷ tham số của AI2 từng đặt 74% câu trả lời vào A hoặc B).
Kết quả gây sốc: Hệ số tương quan sai lầm trung bình giữa các cặp mô hình là 0,41 (khoảng tin cậy 95%: 0,39–0,44). Không cặp nào gần 0 — tất cả 15 cặp đều nằm trong khoảng 0,33 đến 0,48. Khi hai mô hình cùng sai, chúng chọn cùng một đáp án sai 59% số lần.
 Bản đồ tương quan sai lầm giữa các cặp mô hình
Áp vào công thức, sáu mô hình chỉ đáng 1,96 phiếu độc lập. Mỗi mô hình thêm vào đóng góp ít hơn mô hình trước: từ một lên hai mô hình thêm 0,4 phiếu hiệu dụng, nhưng từ năm lên sáu chỉ thêm 0,07.
Bỏ phiếu thực tế còn tệ hơn cả mô hình tốt nhất
Khi chạy bỏ phiếu đa số thực sự:
- Năm mô hình đạt 71,2%, trong khi mức nền của các cử tri độc lập cùng độ chính xác là 87,1% — hụt khoảng 16 điểm.
- Sáu mô hình đạt 71,8%, so với 90,3% nếu chúng độc lập.
- Mô hình tốt nhất đơn lẻ (Qwen3-4B) đạt 72,7% — và không một tổ hợp nào trong 57 nhóm từ hai đến sáu mô hình vượt được nó khi mỗi mô hình chỉ có một phiếu.
- Lấy trung bình xác suất (giữ lại nhiều thông tin hơn) giúp sáu mô hình đạt 73,8% — vượt 1,1 điểm nhưng vẫn không có ý nghĩa thống kê.
Đáng chú ý: cả sáu mô hình đồng thuận trên 35,8% câu hỏi, và khi đồng thuận thì chúng sai 5,8% số lần. Các cử tri độc lập sẽ chỉ đồng thuận trên 7,8% câu hỏi, và sai 0,008% khi đồng thuận. Nói cách khác, sự đồng thuận của cả sáu mô hình không phải là bằng chứng mạnh về tính đúng đắn.
Nguồn gốc của sai lầm chung
Một phần tương quan là hiển nhiên: chủ đề khó thì khó với mọi mô hình. Khi tác giả xáo trộn kết quả trong từng chủ đề, tương quan trung bình giảm từ 0,41 xuống 0,09 — nghĩa là độ khó chủ đề chỉ giải thích khoảng một phần năm, phần lớn còn lại nằm ở cấp độ từng câu hỏi cụ thể.
Thiên kiến thứ tự đáp án cũng góp phần: với thứ tự đáp án chung, tương quan là 0,45; khi mỗi mô hình có thứ tự riêng, còn 0,41. Khoảng cách 0,04 này là mức đóng góp của việc chia sẻ thứ tự đáp án.
Lấy mẫu lặp lại từ một mô hình còn tệ hơn
Kỹ thuật self-consistency (lấy mẫu nhiều câu trả lời từ một mô hình rồi bỏ phiếu) cũng không cứu được tình hình. Sáu lần lấy mẫu từ một mô hình chỉ đáng 1,4 phiếu hiệu dụng, tám lần đáng 1,5 — so với 2,0 phiếu của sáu mô hình khác nhau. Mức tăng độ chính xác cũng tương tự: năm mẫu từ một mô hình tăng 2,2 điểm, trong khi năm mô hình khác nhau tăng 5,7 điểm.
Ý nghĩa thực tiễn cho người làm AI tại Việt Nam
Nghiên cứu này không phủ nhận hoàn toàn giá trị của các nhóm mô hình hay nhóm agent, nhưng nó mang lại một công cụ đơn giản mà bất kỳ ai cũng dùng được: tính hệ số tương quan sai lầm trung bình φ trên vài trăm câu hỏi có đáp án đã biết trước khi thêm một mô hình mới vào nhóm.
Ba bài học chính:
- Mô hình từ nhà phát triển khác không tự động là ý kiến mới. Trong nghiên cứu này, việc đổi nhà phát triển chỉ giảm tương quan rất ít (0,45 cho cặp cùng nhà, 0,41 trung bình khác nhà).
- Trần 1/φ cho biết khi nào nên dừng thêm mô hình. Thay vào đó, hãy thêm thứ gì đó thực sự mới: gọi công cụ, bước truy xuất dữ liệu, một bài kiểm thử chạy được, hoặc con người.
- Đếm số mô hình thì dễ, nhưng đếm xem có bao nhiêu mô hình có thể sai theo những cách khác nhau mới là điều quan trọng — và chỉ cần một ma trận tương quan là làm được.
Với các đội ngũ phát triển sản phẩm AI tại Việt Nam đang ngày càng dựa vào nhiều mô hình để kiểm chứng chéo kết quả, việc hiểu rõ giới hạn toán học này có thể tiết kiệm đáng kể chi phí và tránh những quyết định dựa trên cảm giác "đa số tin cậy" nhưng thực chất chỉ là một ý kiến được lặp lại nhiều lần.

