
Mô hình AI số 1 có thực sự là số 1? Khi bảng xếp hạng chỉ là ảo giác thống kê
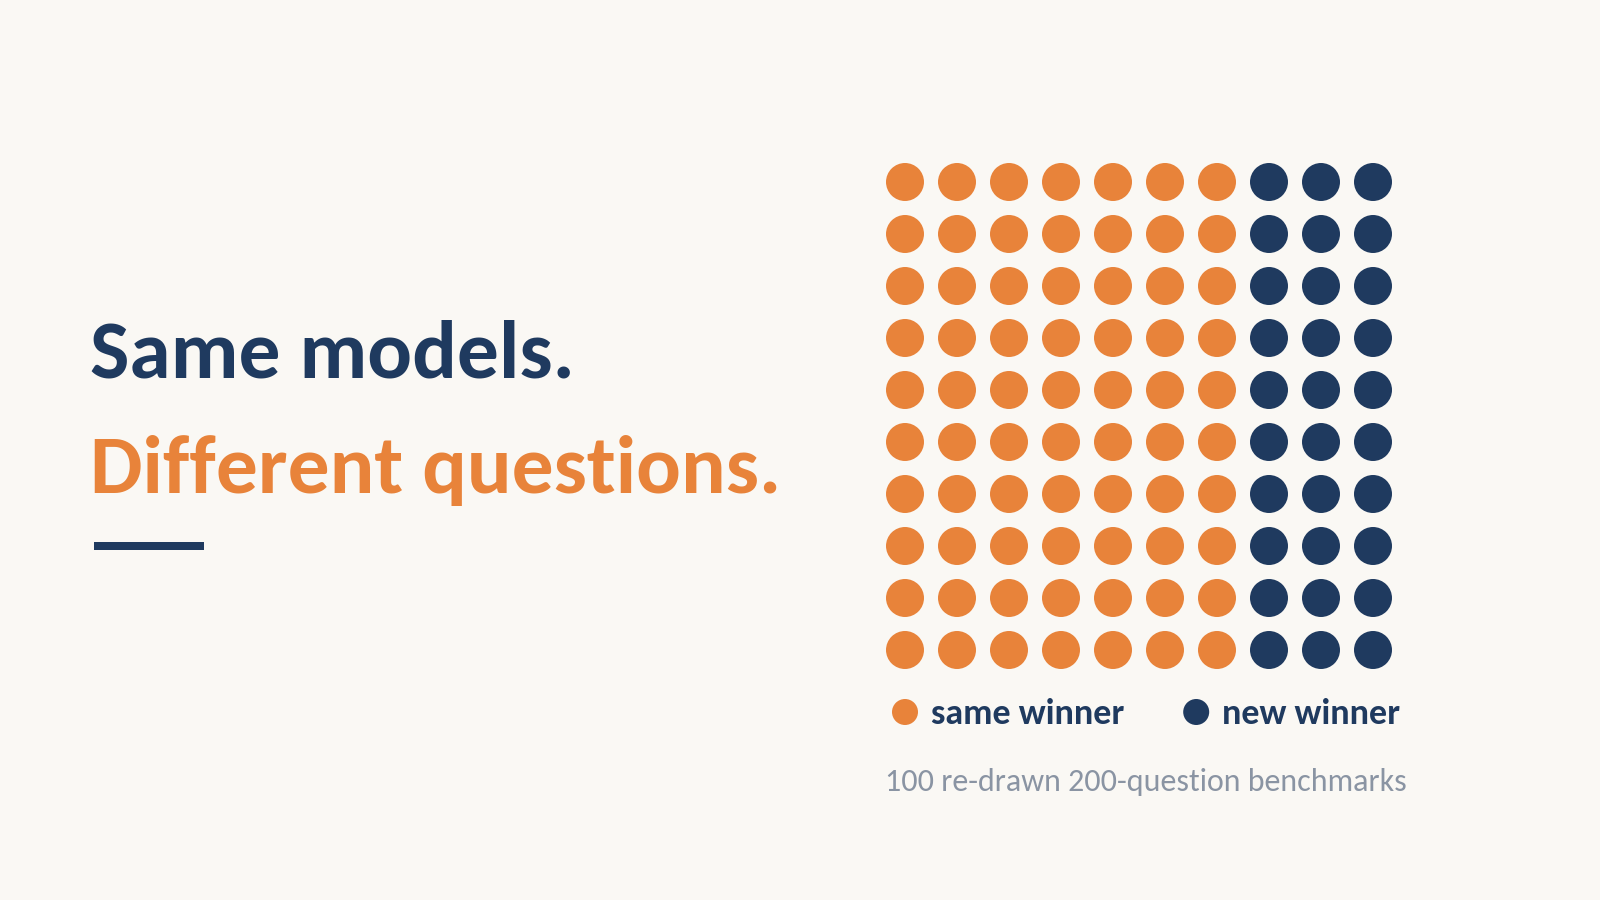
Một thử nghiệm trên 2.000 câu hỏi cho thấy hai mô hình AI dẫn đầu không thể phân biệt được ở mức ý nghĩa thông thường 5%. Với phiên bản 200 câu hỏi, một mô hình khác sẽ chiếm ngôi đầu trong khoảng ba trên mười lần chạy lại. Bài viết bóc tách khoảng cách điểm số nào thuộc về mô hình và khoảng cách nào chỉ là do may mắn của bộ câu hỏi.
Một mô hình mới xuất hiện trên đỉnh bảng xếp hạng với 71,8%. Mô hình về nhì đạt 70,0%. Bảng biểu khiến con số đó trông như một kết luận chắc chắn. Nhưng câu hỏi thực sự là: bao nhiêu phần trong khoảng cách ấy thuộc về năng lực của mô hình, và bao nhiêu thuộc về việc bộ câu hỏi kiểm tra tình cờ chứa những câu nào?
Trường hợp cực đoan là AIME — bộ đề chỉ có 30 bài toán. Trong một lần chạy, mỗi bài đáng 3,3 điểm, nên hai mô hình không thể chênh nhau 1,8 điểm. Chúng chênh 0, hoặc 3,3, hoặc 6,7 điểm. Mọi bài kiểm tra đều có phiên bản nhẹ hơn của vấn đề này: điểm số chỉ là phép đếm số câu trả lời đúng, và một phép đếm trên danh sách hữu hạn thì luôn dao động.
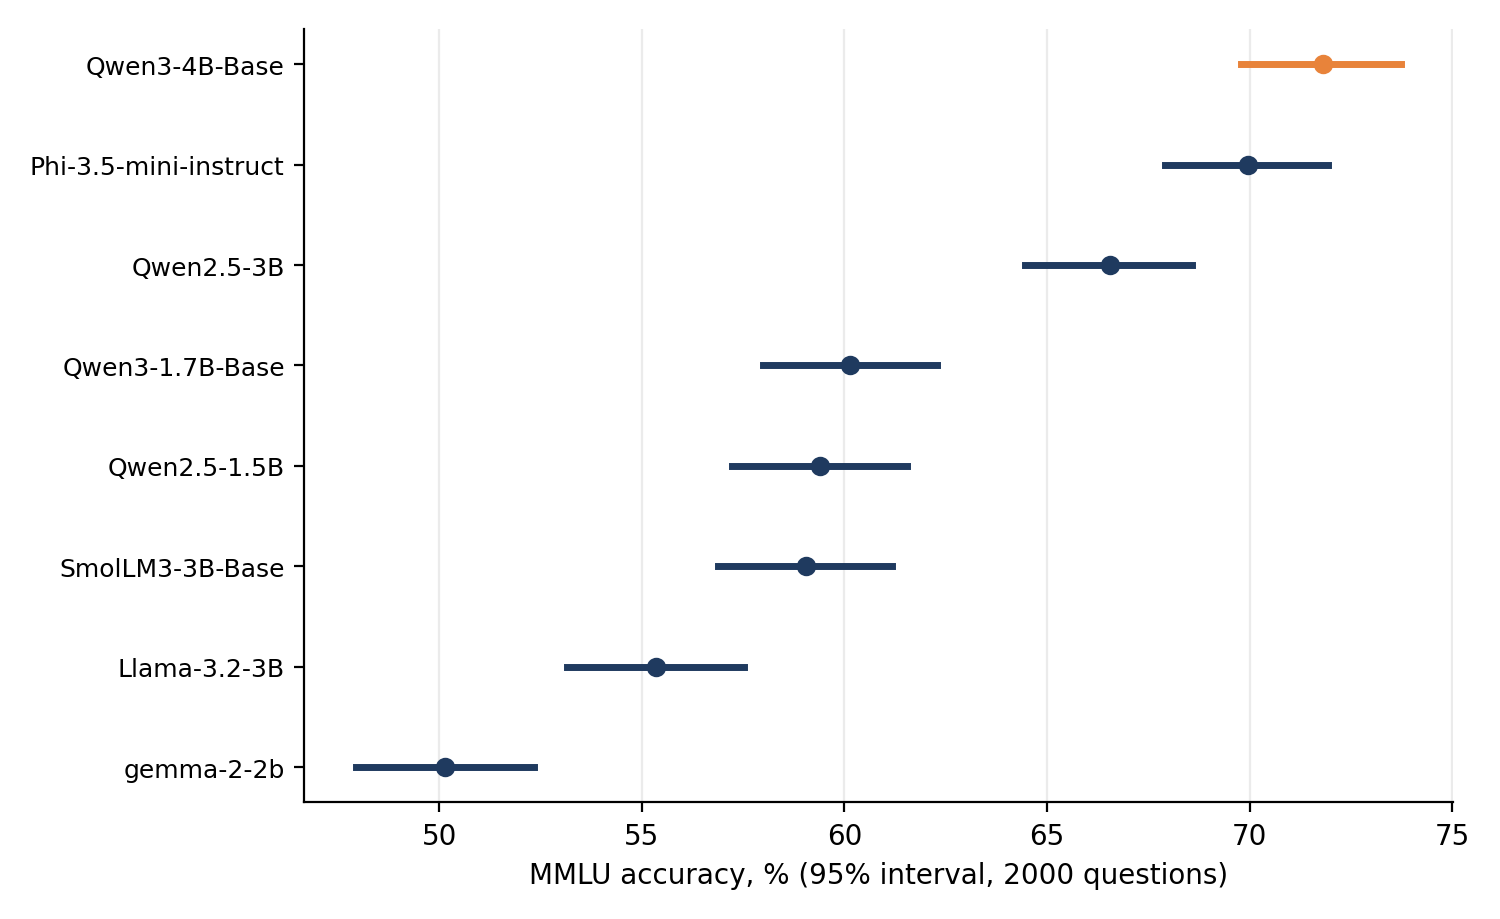 Bảng xếp hạng mô hình AI với khoảng tin cậy
Bối cảnh: khi bảng xếp hạng không nói lên tất cả
Evan Miller tại Anthropic đã viết tài liệu tham chiếu chuẩn về vấn đề này vào năm 2024. Lời khuyên của ông gồm: gắn thanh sai số vào điểm đánh giá, so sánh hai mô hình trên đúng những câu hỏi chúng cùng làm, và tính toán trước xem cần bao nhiêu câu hỏi mới đủ. Tác giả bài viết gốc đã áp dụng những lời khuyên này vào một bảng xếp hạng tự xây dựng, nên mọi con số dưới đây đều đến từ đoạn mã có thể kiểm chứng.
Thiết lập thử nghiệm: tám mô hình mở nhỏ được chấm trên cùng 2.000 câu hỏi, lấy ngẫu nhiên từ MMLU — bộ đề trắc nghiệm bốn lựa chọn trải trên 57 lĩnh vực. Mỗi mô hình thấy mọi câu hỏi mà không có ví dụ mẫu trong prompt, và hệ thống đọc xem ký tự đáp án nào (A, B, C hay D) được gán xác suất cao nhất. Không có sinh văn bản, nên toàn bộ chạy được trên một GPU Colab T4.
Tám mô hình gồm: Qwen3-4B-Base, Phi-3.5-mini-instruct, Qwen2.5-3B, Qwen3-1.7B-Base, Qwen2.5-1.5B, SmolLM3-3B-Base, Llama-3.2-3B và Gemma-2-2B. Điểm mấu chốt là mọi mô hình đều nhận đúng cùng một bộ câu hỏi.
Phần giữa bảng: ba hạng nhưng không có khác biệt
Nhìn vào bảng xếp hạng với khoảng tin cậy 95%, hai điều nổi bật. Ở giữa, Qwen3-1.7B-Base (60,2%), Qwen2.5-1.5B (59,4%) và SmolLM3-3B-Base (59,1%) chỉ cách nhau 1,1 điểm. Khi kiểm định chúng trên những câu hỏi chung, các giá trị p lần lượt là 0,49, 0,79 và 0,34 — không có bằng chứng nào cho thấy chúng khác nhau. Vậy mà bảng xếp hạng vẫn in chúng ở vị trí #4, #5 và #6.
Vẽ lại bộ đề: ngôi đầu phụ thuộc vào may mắn đến mức nào?
Ý tưởng ở đây là coi 2.000 câu hỏi như toàn bộ "thế giới". Rút ngẫu nhiên n câu (có hoàn lại) từ đó, chấm cả tám mô hình trên tập rút ra, ghi nhận ai về nhất. Lặp lại 2.000 lần. Tỷ lệ số lần mô hình đang đứng đầu lại đứng đầu chính là thước đo mức độ ngôi vương phụ thuộc vào việc chọn câu hỏi nào.
import numpy as np
from math import comb

rng = np.random.default_rng(0)

# C[m, i] = 1 nếu mô hình m đúng câu i; các hàng sắp theo mô hình tốt nhất trước
def p_top_stays_top(C, n, draws=2000):
    idx = rng.integers(0, C.shape[1], size=(draws, n))      # rút lại n câu hỏi
    scores = np.stack([row[idx].mean(axis=1) for row in C], axis=1)
    scores += rng.random(scores.shape) * 1e-9               # phá hòa ngẫu nhiên
    return (scores.argmax(axis=1) == 0).mean()
Kết quả khi chạy ở các kích thước bộ đề từ 30 đến đủ 2.000 câu:
- 30 câu: mô hình dẫn đầu lại dẫn đầu trong 45% số lần rút.
- 100 câu: 60%.
- 200 câu: 70%.
- 500 câu: 82%.
- 1.000 câu: 91%.
- 2.000 câu: 96% — ngay cả khi dùng toàn bộ đề, vẫn không phải 100%.
Ba mô hình dẫn đầu giữ đúng thứ tự chỉ trong 12% số lần ở 30 câu, 34% ở 100 câu, 54% ở 200 câu và 77% ở 500 câu.
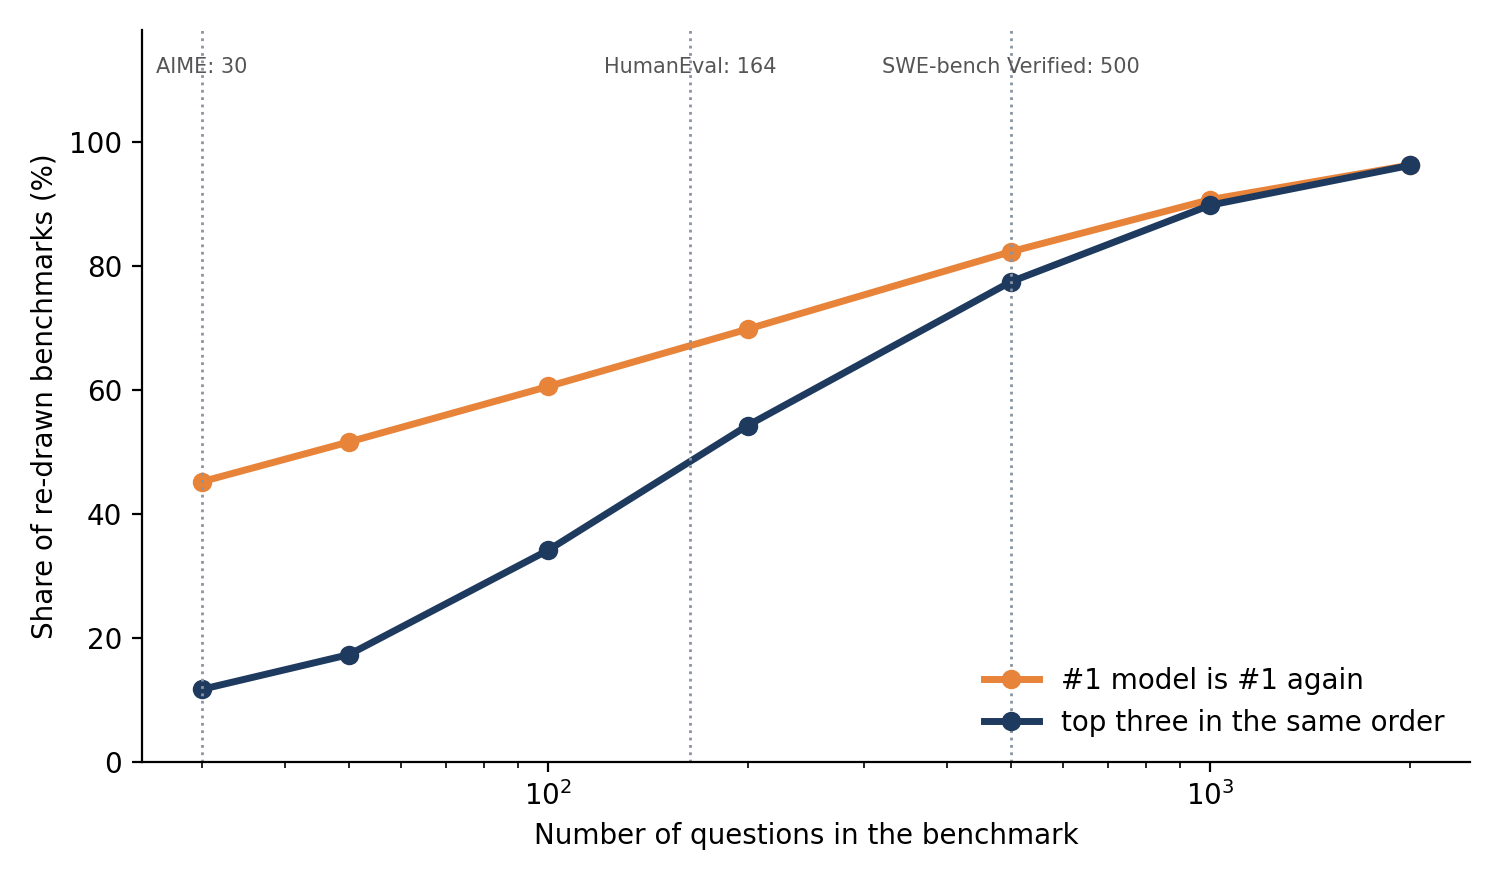 Độ ổn định của thứ hạng khi vẽ lại bộ đề
Các đường đứt nét đánh dấu số câu hỏi của AIME (30), HumanEval (164) và SWE-bench Verified (500) — chỉ để tham chiếu quy mô. Đường cong này thuộc về tám mô hình trên MMLU của thử nghiệm. Bộ đề mà hai mô hình dẫn đầu cách xa nhau hơn sẽ ổn định hơn, còn bộ đề có hai mô hình sát nhau sẽ dao động mạnh hơn. Điều hữu ích nằm ở hình dạng: giảm số câu hỏi xuống thì thứ hạng lung lay rất nhanh.
Cùng câu hỏi thì sai số hẹp hơn nhiều
Các thanh sai số thông thường coi như mỗi mô hình đối mặt với một tập câu hỏi ngẫu nhiên riêng. Nhưng trên thực tế chúng đối mặt cùng một bộ câu hỏi, và điều này giúp ích rất nhiều, bởi độ khó giữa các câu chênh lệch khủng khiếp. Trong 27% số câu, cả tám mô hình đều đúng. Trong 8% số câu, không mô hình nào đúng. Bảng xếp hạng thực chất được quyết định bởi những câu nằm giữa.
Vì vậy phép so sánh đúng cho hai mô hình là so sánh theo cặp. Với mỗi câu, xem ai đúng ai sai, và chỉ đếm những câu mà hai mô hình bất đồng. Đây chính là kiểm định McNemar.
def paired_test(x, y):
    b = int(((x == 1) & (y == 0)).sum())    # chỉ mô hình thứ nhất đúng
    c = int(((x == 0) & (y == 1)).sum())    # chỉ mô hình thứ hai đúng
    n, k = b + c, min(b, c)
    p = min(1.0, 2 * sum(comb(n, i) for i in range(k + 1)) / 2**n)
    return b, c, p
Với hai mô hình dẫn đầu, Qwen3-4B-Base đúng riêng 219 câu còn Phi-3.5-mini-instruct đúng riêng 182 câu. Chênh lệch ròng 37 câu trên 2.000 câu, tương ứng khoảng cách 1,85 điểm. Giá trị p là 0,072. Việc so sánh theo cặp giúp khoảng tin cậy 95% của khoảng cách hẹp hơn khoảng 30% so với cách so hai thanh sai số rời (±1,96 điểm thay vì ±2,82 điểm). Nhưng khoảng tin cậy vẫn trải từ khoảng −0,1 đến +3,8 điểm, nghĩa là mức 0 nằm ngay sát bên trong.
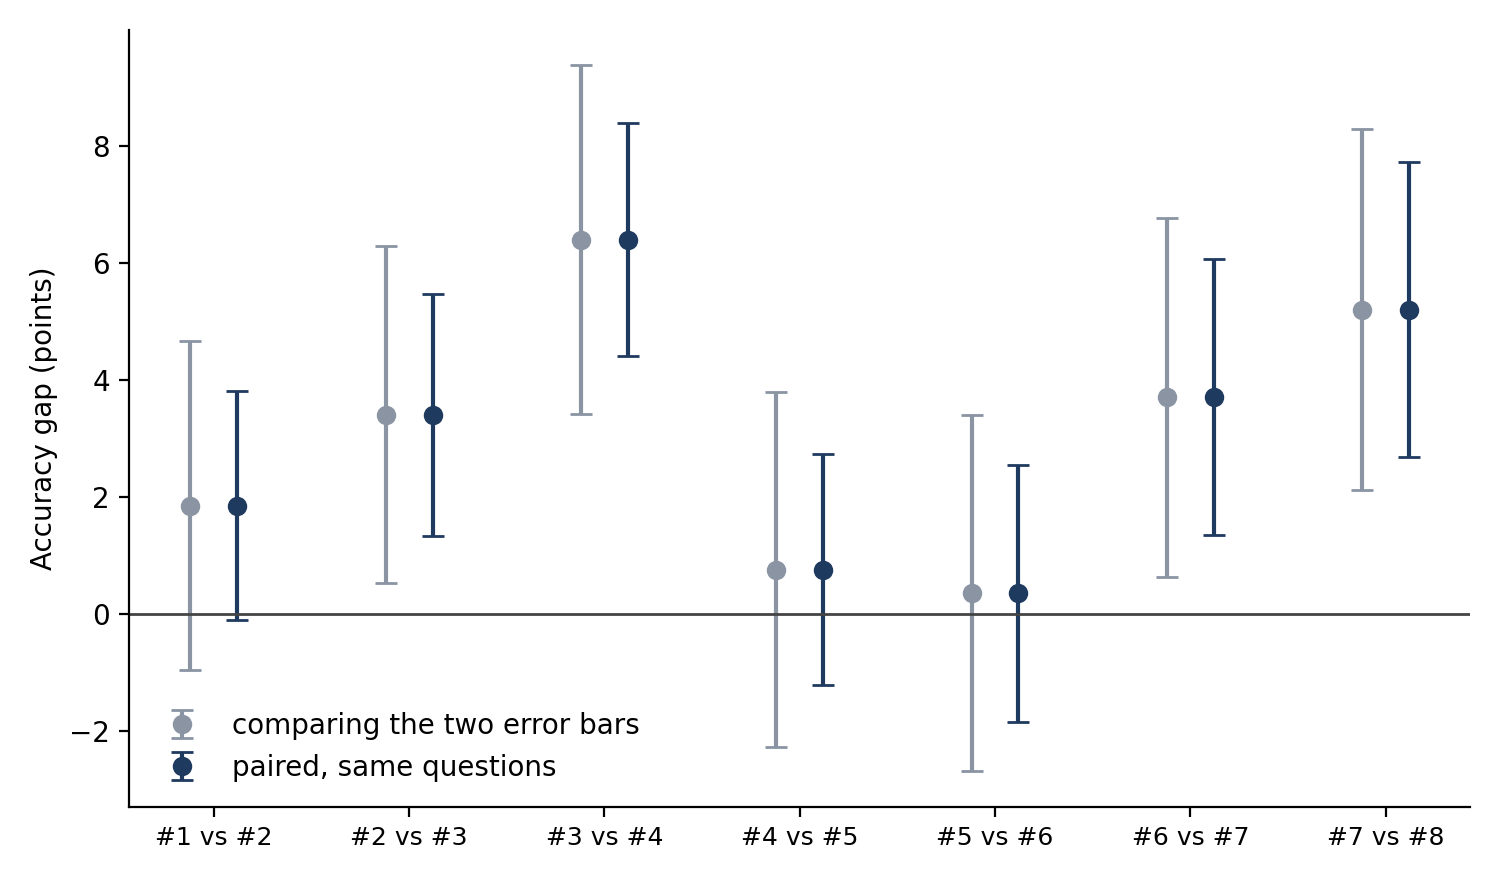 Khoảng cách điểm giữa các mô hình lân cận và khoảng tin cậy
Trong bảy cặp lân cận, bốn cặp tách biệt rõ ràng (p dưới 0,01, và vẫn giữ nguyên sau khi hiệu chỉnh cho bảy lần kiểm định). Ba cặp thì không: #1 so với #2, #4 so với #5 và #5 so với #6. Nghĩa là ngay phần đỉnh của bảng xếp hạng cũng là nơi không thể khẳng định thứ tự là thật.
Cần bao nhiêu câu hỏi mới đủ?
Đây là bài toán phân tích năng lực thống kê (power analysis). Với so sánh theo cặp, số câu hỏi cần để phát hiện đáng tin cậy một khoảng cách d, khi hai mô hình bất đồng trên tỷ lệ q số câu, xấp xỉ bằng:
n ≈ (1,96 + 0,84)² · q / d²
Hai hằng số 1,96 và 0,84 đến từ mức ý nghĩa 5% và năng lực 80%. Với hai mô hình dẫn đầu, q là 0,20 và d là 0,0185, cho ra khoảng 4.600 câu hỏi — trong khi thử nghiệm chỉ dùng 2.000. Trên tất cả các cặp mô hình, trung vị của q là 0,27, và yêu cầu cụ thể như sau:
| Khoảng cách cần phát hiện | Số câu hỏi cần |
|---|---|
| 1 điểm | khoảng 21.000 |
| 2 điểm | khoảng 5.300 |
| 3 điểm | khoảng 2.300 |
| 5 điểm | khoảng 840 |
| 10 điểm | khoảng 210 |
Yêu cầu tăng theo bình phương độ nhỏ của khoảng cách. Giảm một nửa khoảng cách thì cần gấp bốn lần số câu hỏi. Có thể chạy công thức theo chiều ngược lại: với tỷ lệ bất đồng như trên (20%), biên sai số 95% của khoảng cách là khoảng ±6 điểm ở 200 câu, ±4 điểm ở 500 câu và ±2 điểm ở 2.000 câu.
Người thắng có ít nhất giữ được phong độ?
Tác giả còn chia 2.000 câu thành hai nửa ngẫu nhiên 3.000 lần, chọn người thắng trên một nửa rồi kiểm tra trên nửa còn lại. Cùng một mô hình thắng cả hai nửa trong 94% số lần. Khoảng cách dẫn đầu là 1,88 điểm trên nửa dùng để chọn và 1,62 điểm trên nửa còn lại — tức khoảng 13% lợi thế biến mất.
Tuy vậy, không nên dựa quá nhiều vào con số 94% đó. Cả hai nửa đều cắt từ cùng một đống câu hỏi, nên chúng chia sẻ cùng thiên lệch. Nó chỉ nói rằng thứ tự ổn định bên trong tập câu hỏi này, không thể nói liệu một bộ 2.000 câu hoàn toàn mới có đồng ý hay không — mà tạo bộ câu hỏi mới chính là việc đắt đỏ nhất.
Cách đọc một bảng xếp hạng
- Tra xem điểm số dựa trên bao nhiêu câu hỏi, vì mỗi câu đáng 100 chia cho số đó điểm.
- Tìm khoảng tin cậy hoặc kiểm định theo cặp. Nếu trang không có cả hai, hãy coi khoảng cách vài điểm trên vài trăm câu hỏi là nằm trong nhiễu.
- Nghĩ theo nhóm thay vì theo thứ hạng: ba mô hình giữa trong thử nghiệm thực ra là một tầng, dù bảng in thành ba vị trí.
- Nếu chọn mô hình cho công việc thật, hãy tự chạy bộ câu hỏi của mình qua danh sách rút gọn — vì đó là bài kiểm tra duy nhất có câu hỏi mà bạn thực sự quan tâm.
Những gì thử nghiệm chưa chứng minh
Đây là các mô hình mở nhỏ, chấm trên một bộ trắc nghiệm duy nhất với một prompt zero-shot, nên con số không thể so sánh với điểm MMLU công bố. Việc rút lại bộ đề coi 2.000 câu là tổng thể, nên chỉ nắm bắt nhiễu từ việc chọn câu hỏi và không gì khác — không tính đến cách diễn đạt prompt, tính ngẫu nhiên của lấy mẫu hay ô nhiễm dữ liệu. Những bộ đề mà mô hình hay agent phải tự sinh câu trả lời, như SWE-bench, còn có thêm ngẫu nhiên giữa các lần chạy, nên độ bất định thực tế lớn hơn những gì đo được ở đây. Các kích thước bộ đề trên biểu đồ chỉ để tham chiếu quy mô.
Thông điệp dành cho người dùng Việt Nam đang theo dõi các bảng xếp hạng AI: một khoảng cách vài điểm trên bảng xếp hạng chưa chắc là sự thật về năng lực mô hình. Khi chọn công cụ AI cho sản phẩm hay quy trình của mình, hãy kiểm tra trên chính dữ liệu và tác vụ của bạn thay vì tin tuyệt đối vào thứ hạng.
"Một bảng xếp hạng không có khoảng tin cậy thì chỉ là một danh sách có thứ tự — chứ chưa phải một kết luận."
Toàn bộ mã nguồn nằm trong bài viết gốc, và lần chạy đầy đủ chỉ gồm vài ô trong một notebook Colab.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Difference-in-Differences và hồi quy kết quả trễ: chọn đúng thiết kế nào cho phân tích sản phẩm?
29 tháng 10, 2026