
Difference-in-Differences và hồi quy kết quả trễ: chọn đúng thiết kế nào cho phân tích sản phẩm?
Khi người dùng tự chọn dùng một tính năng, việc ước lượng tác động nhân quả đòi hỏi phải chọn đúng giả định. Bài viết dựa trên một nghiên cứu mô phỏng để so sánh Difference-in-Differences với hồi quy kết quả trễ, chỉ ra khi nào mỗi phương pháp sai lệch và cách dùng kiểm tra xu hướng trước can thiệp để quyết định.
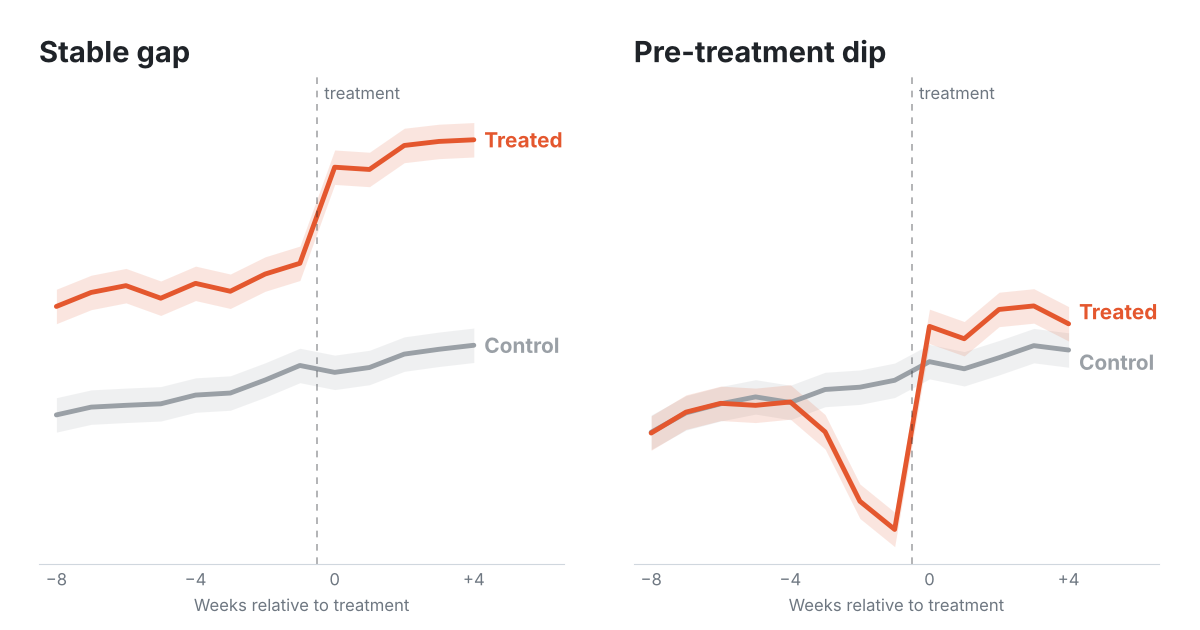
Difference-in-Differences và hồi quy kết quả trễ: chọn đúng thiết kế nào cho phân tích sản phẩm?
Trong phân tích sản phẩm, phần lớn các "can thiệp" là do chính người dùng lựa chọn: bật một tính năng, tham gia cộng đồng, hay bắt đầu dùng thử gói cao cấp. Không có phân bổ ngẫu nhiên, nhưng với những giả định phù hợp, ta vẫn có thể ước lượng tác động của các can thiệp tự chọn này.
Bài viết dưới đây tóm tắt một nghiên cứu mô phỏng so sánh hai thiết kế phổ biến — hồi quy kết quả trễ (lagged-outcome regression) và Difference-in-Differences (DiD) — đồng thời đề xuất cách dùng kiểm tra xu hướng trước can thiệp (pre-trend check) để chọn đúng công cụ.
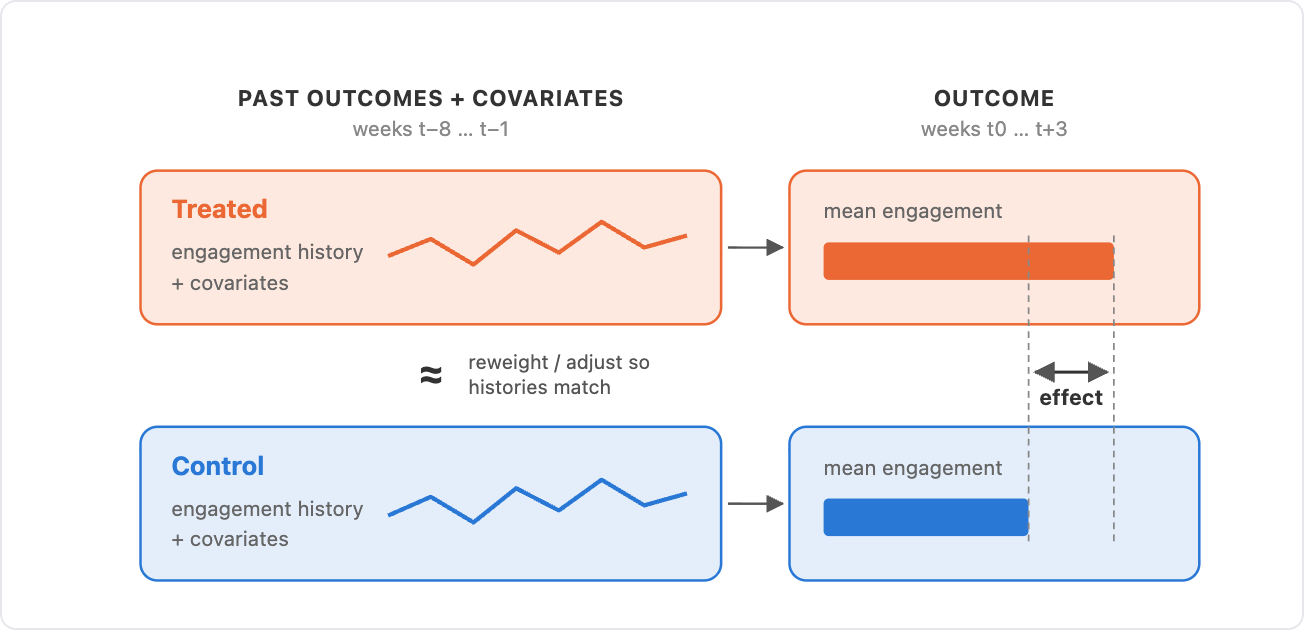 Mô phỏng dữ liệu bảng theo tuần cho các nhóm người dùng
Khi không thể thử nghiệm ngẫu nhiên
Khi không có công cụ hợp lệ hay một ngưỡng để khai thác (điều kiện cho biến công cụ hay hồi quy gián đoạn), các nhà phân tích thường rơi vào một trong hai trường phái:
- Hồi quy kết quả trễ, thường ước lượng bằng double machine learning (EconML, CausalML).
- Difference-in-Differences, được hiện đại hóa qua các nghiên cứu như Doubly Robust Difference-in-Differences Estimators của Sant'Anna và Zhao (2020).
Cả hai đều hợp lý, và cả hai đều có thể ước lượng bằng cùng bộ máy doubly robust (ví dụ DoubleML hỗ trợ cả hai). Điểm mấu chốt: công cụ ước lượng và giả định nhận dạng là hai lựa chọn tách biệt, và chính giả định mới quyết định đáp án đúng hay sai.
Hồi quy kết quả trễ giả định không có nhiễu chưa quan sát (unconfoundedness) sau khi đã kiểm soát kết quả trong quá khứ và các biến đồng hành. DiD giả định xu hướng song song (parallel trends): nếu không có can thiệp, kết quả của nhóm được can thiệp và nhóm đối chứng sẽ dịch chuyển cùng nhau.
Hai giả định, hai cách nhìn
Một cách hữu ích để thấy khác biệt là viết kết quả giai đoạn sau như một hàm của kết quả giai đoạn trước:
Y_post = α + τD + β·Y_pre + γ′X + ε
Trong đó D là biến can thiệp, τ là tác động cần ước lượng, X là các biến quan sát được.
- DiD đặt β = 1: coi mọi chênh lệch trước can thiệp là vĩnh viễn. τ trở thành chênh lệch mức thay đổi giữa hai nhóm.
- Hồi quy kết quả trễ ước lượng β: vì tương tác trước can thiệp trộn lẫn mức nền lâu dài với những cú sốc tạm thời đang phai dần, β thường nhỏ hơn 1.
Nói cách khác, mỗi thiết kế bị lệch khi khoảng cách giữa hai nhóm không đúng loại mà nó giả định.
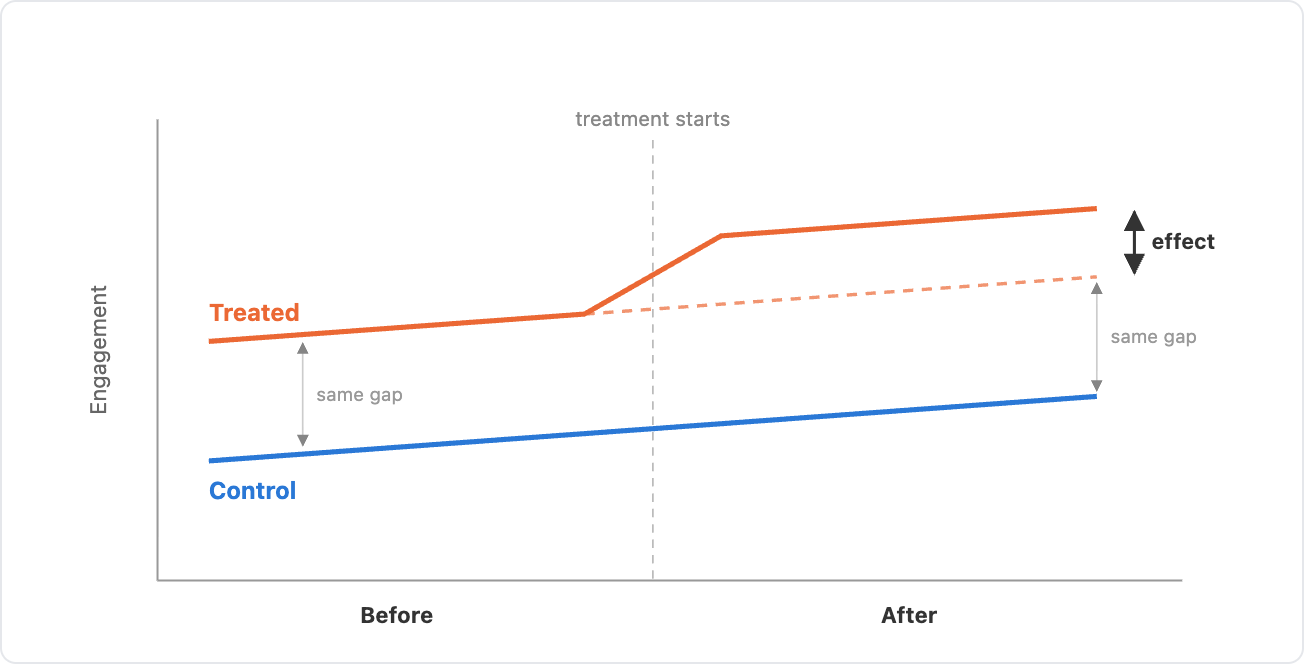 So sánh đường dự báo của hai thiết kế với phản thực tế thực
Hai kiểu thất bại điển hình
Kiểu 1 — Yếu tố gây nhiễu bất biến theo thời gian. Ví dụ: người thu nhập cao dễ bắt đầu dùng thử gói cao cấp hơn, và cũng tương tác nhiều hơn mỗi tuần. Thu nhập hiếm khi thay đổi trong vài tháng và thường không có trong dữ liệu. DiD xử lý được vì chênh lệch cố định sẽ bị triệt tiêu khi trừ đi giai đoạn trước. Hồi quy kết quả trễ thì chỉ điều chỉnh được trong phạm vi lịch sử tương tác phản ánh, nên một phần chênh lệch rò rỉ vào ước lượng.
Kiểu 2 — Tự chọn dựa trên một cú sụt tạm thời. Người dùng thường đăng ký khi vừa có biến cố. Chiến dịch "win-back" nhắm vào người đang giảm hoạt động: những người nhận lời phần lớn đang trong giai đoạn trầm xuống, và nhiều người trong số họ vốn sẽ tự phục hồi. DiD không tính đến cú sụt này vì giai đoạn nền bị kéo xuống, nên phần phục hồi bị tính nhầm thành tác động. Ngược lại, hồi quy kết quả trễ điều chỉnh trực tiếp trên chính cú sụt đó.
Kết quả mô phỏng
Nghiên cứu dựng một bảng dữ liệu tuần cho 10.000 người dùng, trong đó tương tác hàng tuần được tạo thành từ bốn thành phần: mức nền (theo biến quan sát và một yếu tố nhiễu ẩn bất biến), xu hướng, yếu tố mùa vụ dùng chung, và cú sốc tạm thời phai dần 20% mỗi tuần. Tính năng mới thêm 2 phút mỗi tuần cho mọi người dùng được can thiệp, nên tác động thực là 2,0.
Bốn kịch bản tự chọn được khảo sát, cùng với trạng thái của hai giả định:
- a. Chỉ dựa trên biến quan sát: cả hai giả định đều đúng.
- b. Có yếu tố nhiễu bất biến: unconfoundedness sai, parallel trends đúng.
- c. Cú sụt tạm thời: unconfoundedness đúng, parallel trends sai.
- d. Cả hai: cả hai giả định đều sai.
Kết quả sau 200 lần mô phỏng cho mỗi kịch bản:
- Kịch bản b: DiD gần như không lệch (0,00), trong khi hồi quy kết quả trễ ước lượng thiếu (−0,70).
- Kịch bản c: hồi quy kết quả trễ theo sát phản thực tế đúng, còn DiD ước lượng thừa (+1,01).
- Kịch bản d: một ước lượng quá nhỏ, một ước lượng quá lớn — sự thật nằm giữa hai giá trị.
Điều đáng lo: thiết kế bị lệch vẫn cho khoảng tin cậy rất hẹp. Ở kịch bản b, khoảng tin cậy 95% của DiD chứa tác động thực trong 94% lần lặp, còn của hồi quy kết quả trễ là 0%. Không có tín hiệu cảnh báo nào trong kết quả xuất ra.
Có thể "sửa" DiD bằng lịch sử tương tác không?
Trực giác thường gặp là bổ sung tương tác ở các tuần trước cửa sổ nền vào DiD. Daw và Hatfield (2018) chỉ ra điều này có thể phản tác dụng: khi hai nhóm khác nhau về mức nền, ghép theo kết quả quá khứ sẽ khiến nhóm đối chứng "hồi quy về trung bình" của chính họ.
Mô phỏng xác nhận:
- Kịch bản b: thêm lịch sử khiến DiD lệch gần bằng hồi quy kết quả trễ (−0,68 so với −0,70).
- Kịch bản c: có giúp giảm lệch nhưng không xóa được (+0,23 so với +1,01).
- Kịch bản d: kết quả gần sự thật chỉ vì hai nguồn lệch vô tình triệt tiêu nhau.
Vì vậy, nguyên tắc về biến đồng hành là: hồi quy kết quả trễ kiểm soát toàn bộ lịch sử kết quả; DiD chỉ dùng các biến phi kết quả đo trước cửa sổ nền.
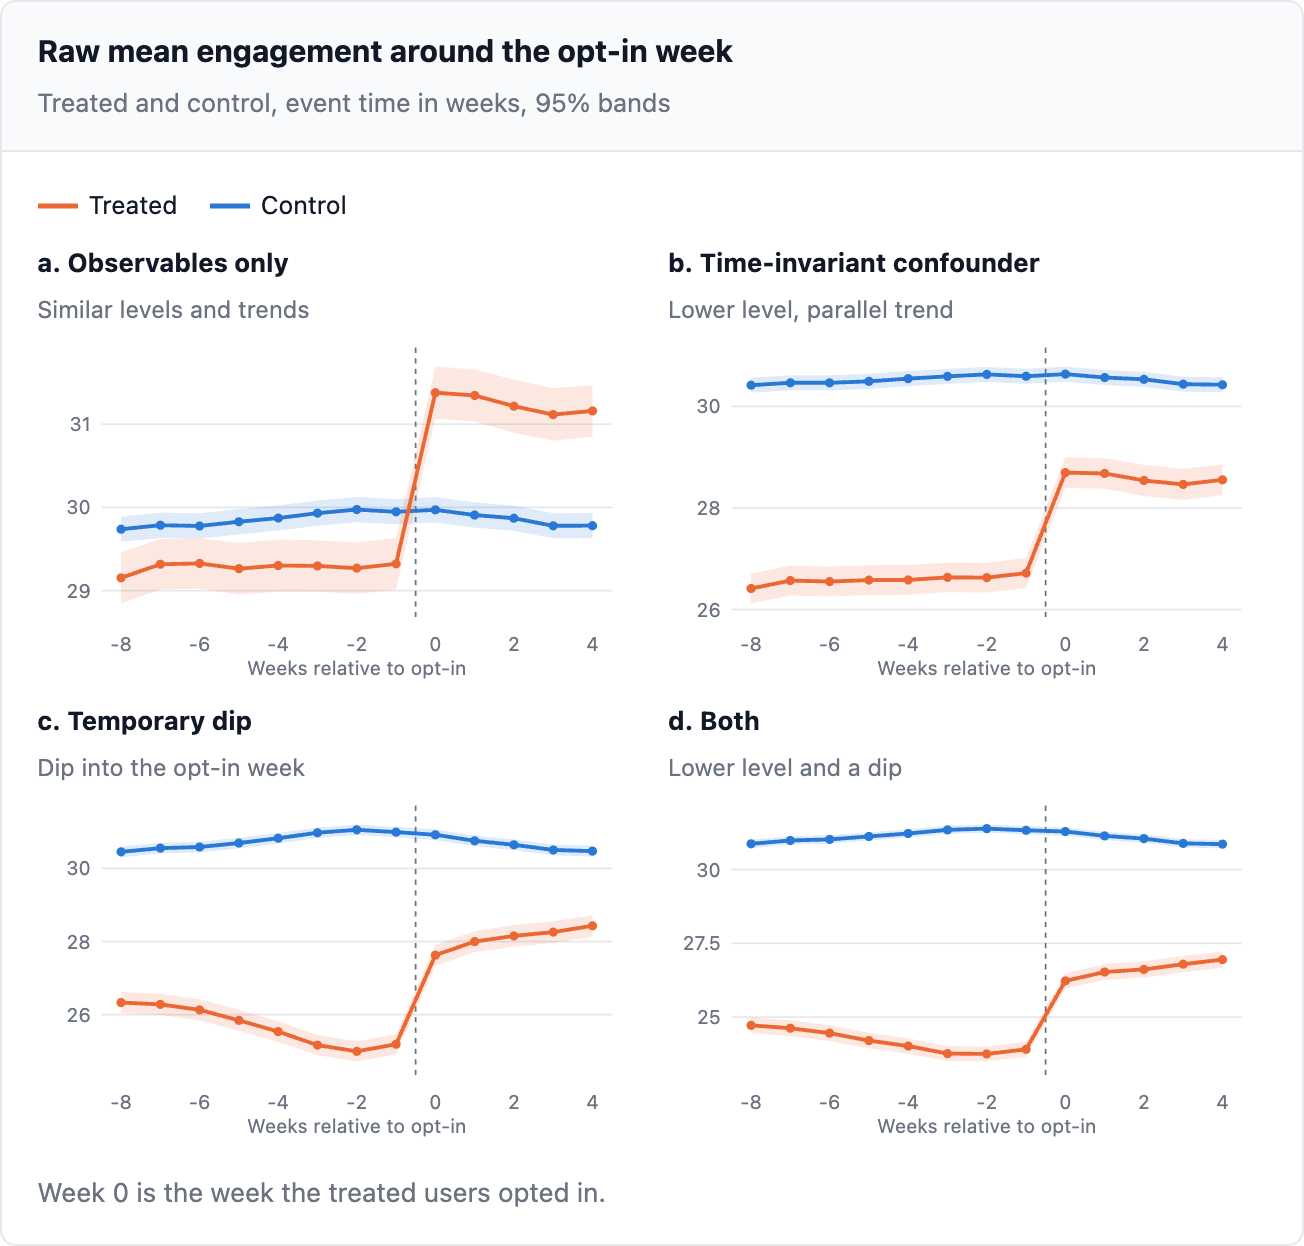 Kiểm tra xu hướng trước can thiệp qua các kịch bản
Chẩn đoán: kiểm tra xu hướng trước can thiệp
Để chọn giữa hai thiết kế, hãy nhìn vào giai đoạn trước can thiệp. Khi đó chưa ai được can thiệp, nên mọi khác biệt giữa hai nhóm đều đến từ quá trình tự chọn.
Hãy coi kiểm tra này như chạy DiD sớm hơn một cửa sổ: các tuần −8 đến −5 đóng vai trò giai đoạn nền, các tuần −4 đến −1 đóng vai trò giai đoạn sau. Cách làm:
- Lấy mức tương tác trung bình tuần −8 đến −5 làm mốc tham chiếu và trừ đi ở mọi tuần sau, giống như DiD loại bỏ chênh lệch mức nền.
- Trọng số hóa nhóm đối chứng chỉ theo các biến phi kết quả.
- Vẽ chênh lệch giữa nhóm được can thiệp và nhóm đối chứng đã trọng số hóa theo từng tuần.
Kết quả: đường kiểm tra phẳng ở a và b, sụt rõ ở c và d. Nghĩa là parallel trends thất bại đúng ở nơi DiD bị lệch. Ngưỡng 2,5 giữ tỷ lệ báo động giả quanh 5%.
Một xu hướng trước can thiệp phẳng ủng hộ parallel trends nhưng không chứng minh được nó: phép kiểm tra không thấy được những gì bắt đầu đúng lúc can thiệp, hay một cú sụt cũ hơn cửa sổ quan sát. Theo Roth (2022), các ước lượng chỉ được báo cáo sau khi vượt qua kiểm tra thường kém tin cậy hơn vẻ ngoài của chúng.
Quy tắc quyết định
Kết hợp kết quả kiểm tra với bối cảnh của bạn:
- Đường phẳng: dùng DiD, nhưng chỉ báo cáo hồi quy kết quả trễ nếu không có yếu tố nhiễu bất biến theo thời gian.
- Có cú sụt: dùng hồi quy kết quả trễ, trừ khi đồng thời có yếu tố nhiễu bất biến — khi đó báo cáo cả hai như hai cận.
- Trong mọi trường hợp: nên báo cáo cả hai. Khi kết quả kiểm tra bị sụt, DiD vẫn đáng báo cáo vì hai ước lượng kẹp lấy sự thật ở giữa (theo Ding và Li, 2019). Nếu cả hai dẫn tới cùng một quyết định, lựa chọn thiết kế không còn quan trọng. Nếu chúng nằm hai bên mức 0 hoặc ngưỡng quyết định của bạn, dữ liệu chưa thể phân xử.
Một số câu hỏi thường gặp
Vì sao hai ước lượng kẹp lấy sự thật? Nhóm được can thiệp khởi đầu thấp hơn nhóm đối chứng: DiD giả định toàn bộ khoảng cách tồn tại, hồi quy kết quả trễ giả định một phần khoảng cách thu hẹp lại, nên DiD cho ước lượng lớn hơn. Nếu một trong hai giả định đúng, sự thật nằm giữa hai giá trị — với điều kiện khoảng cách giữa người dùng không tự mở rộng theo thời gian.
Có dùng DiD với biến churn được không? Không trực tiếp. Churn là trạng thái hấp thụ và người dùng phải còn hoạt động mới được mời dùng tính năng, nên mọi người đều có churn bằng 0 trước đó. Với churn, hãy dùng hồi quy kết quả trễ hoặc mô hình sinh tồn với biến đồng hành biến thiên theo thời gian.
Phân tích độ nhạy có giúp chọn thiết kế không? Không. Các cận thiên lệch do biến bị bỏ sót của Chernozhukov và cộng sự chỉ cho biết một yếu tố nhiễu ẩn cần mạnh đến đâu để làm thay đổi ước lượng, chứ không nói nó có tồn tại hay không. Chính kiểm tra xu hướng trước can thiệp mới là thứ chọn thiết kế.
Kết luận
Cùng một công cụ ước lượng (DML) được dùng cho cả hai thiết kế. Cái đúng là cái có giả định khớp với cách người dùng tự chọn tham gia.
- Tách công cụ ước lượng khỏi thiết kế. DML là cách bạn ước lượng; việc ước lượng có mang tính nhân quả hay không phụ thuộc vào unconfoundedness hay parallel trends.
- Để xu hướng trước can thiệp quyết định. Phẳng thì dùng DiD; sụt thì dùng hồi quy kết quả trễ, kèm DiD làm cận còn lại.
- Bắt đầu từ câu hỏi: người dùng đã đến với can thiệp bằng cách nào? Sau đó mới nhìn đến xu hướng trước can thiệp.
Nghiên cứu mô phỏng cho thấy mỗi thiết kế thất bại trong một tình huống có thể dự đoán được, rằng thiết kế bị lệch vẫn tạo ra khoảng tin cậy hẹp, và rằng phép kiểm tra xu hướng nhận diện được cú sụt. Điều nó chưa cho biết là mỗi tình huống xuất hiện thường xuyên đến đâu trong sản phẩm thực tế — vì vậy, với dữ liệu của chính bạn, hãy bắt đầu từ cách người dùng tự chọn rồi mới xem xét xu hướng trước can thiệp.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Keplearn: Công cụ tìm ra phương trình toán học từ dữ liệu chỉ trong vài giây
29 tháng 10, 2026