
Số lượng tham số không phải là độ phức tạp: Giới thiệu về chiều hiệu dụng
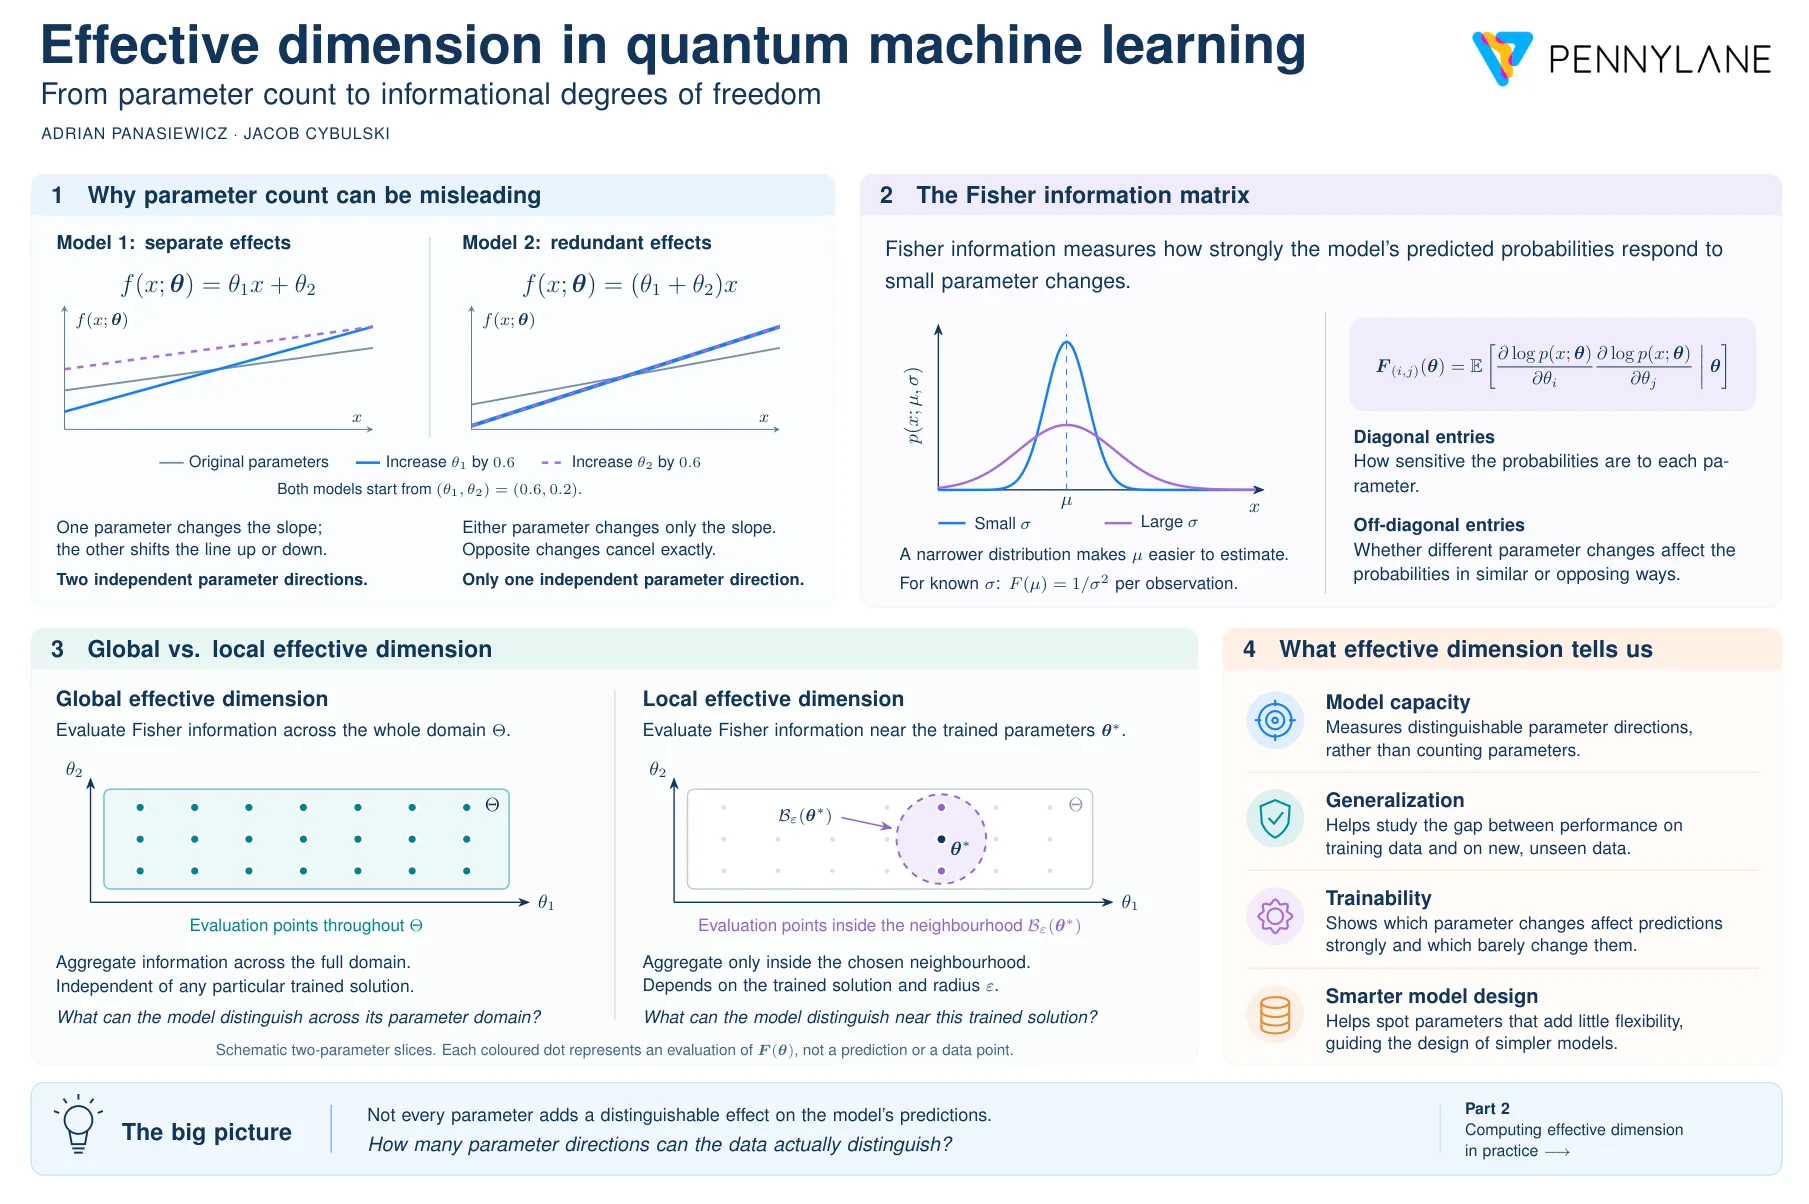
Số lượng tham số không phản ánh đúng độ phức tạp thực sự của một mô hình học máy. Chiều hiệu dụng (effective dimension) đo lường số hướng tham số thực sự phân biệt được từ dữ liệu, giúp đánh giá khả năng biểu đạt, khả năng huấn luyện và khả năng tổng quát hóa của mô hình một cách chính xác hơn.
Số lượng tham số không phải là độ phức tạp: Giới thiệu về chiều hiệu dụng
Trong học máy, chúng ta thường mô tả một mô hình bằng số lượng tham số huấn luyện được của nó. Tuy nhiên, con số này có thể gây hiểu lầm: một mô hình có thể chứa rất nhiều tham số nhưng không tạo ra các cách ảnh hưởng độc lập đến đầu ra, trong khi một mô hình nhỏ gọn lại có thể khai thác gần như toàn bộ tham số một cách có ý nghĩa. Chiều hiệu dụng (effective dimension) là một thước đo giúp định lượng sự khác biệt này.
Bài viết này là phần đầu tiên trong loạt hai bài về chiều hiệu dụng. Ở đây, chúng ta sẽ xây dựng trực giác và lý thuyết đằng sau thước đo này cùng các thành phần chính của nó. Phần 2 sẽ trình bày cách triển khai tính toán chiều hiệu dụng trong các thí nghiệm học máy.
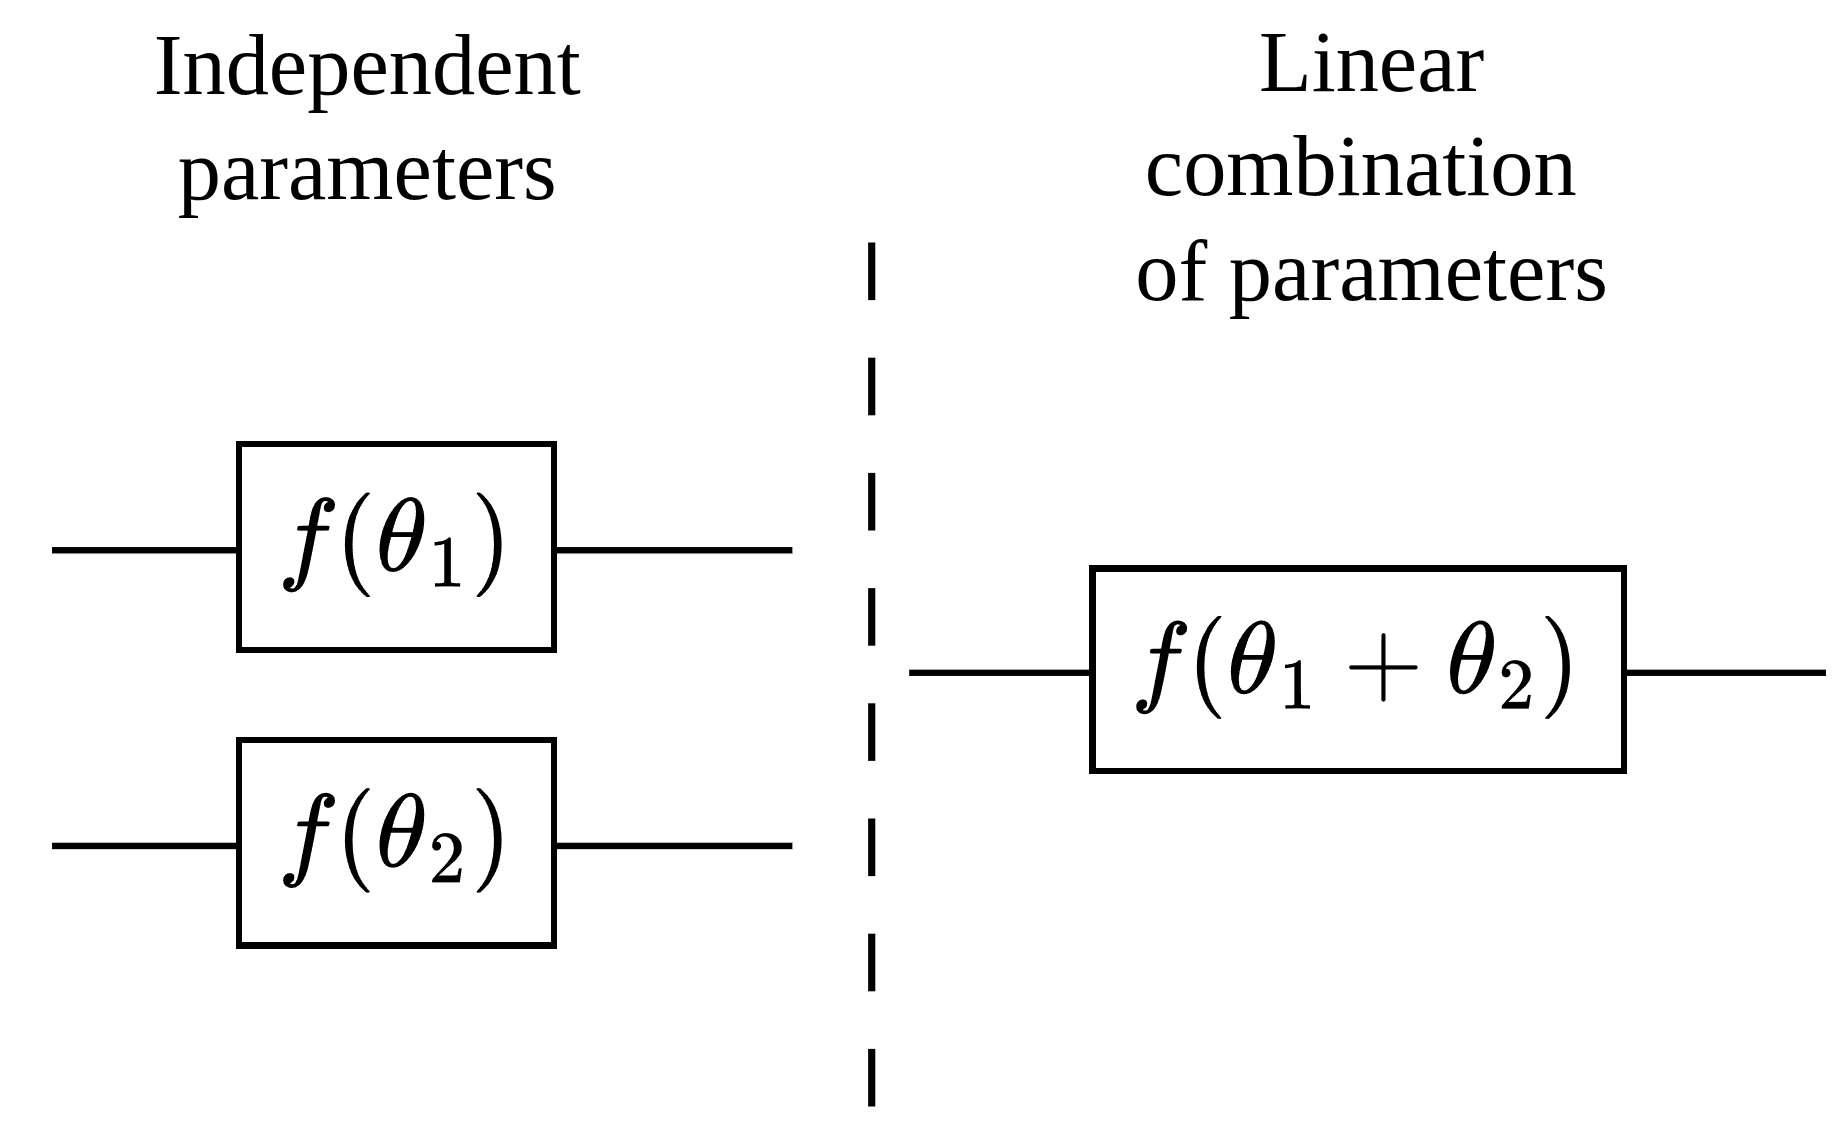 Minh họa các hướng tham số độc lập và dư thừa
Nhiều tham số hơn không đồng nghĩa với năng lực lớn hơn
Hãy xét một ví dụ đơn giản. Giả sử có hai mô hình với các tham số θ₁ và θ₂.
Ở mô hình thứ nhất, các tham số ảnh hưởng độc lập đến đầu ra. Thay đổi θ₁ tạo ra một hiệu ứng mà nói chung không thể tái tạo bằng cách thay đổi θ₂. Mô hình này có thể biến thiên theo hai "hướng" tham số độc lập.
Ở mô hình thứ hai, đầu ra chỉ phụ thuộc vào tổng của chúng: f(x; θ₁, θ₂) = f(x; θ₁ + θ₂). Ở đây, rất nhiều cặp tham số tạo ra đúng cùng một hàm. Chẳng hạn, tăng θ₁ thêm c và giảm θ₂ đi c sẽ giữ nguyên đầu ra. Dù về hình thức mô hình có hai tham số, nó chỉ có một bậc tự do: θ_eff = θ₁ + θ₂.
Ví dụ này minh họa ý tưởng cốt lõi: số lượng tham số không nhất thiết đại diện cho độ phức tạp hàm của mô hình.
Chiều hiệu dụng đo lường điều gì?
Chiều hiệu dụng là một thước đo độ phức tạp thông tin phụ thuộc vào thang đo. Ban đầu được phát triển trong lý thuyết thông tin thống kê để định lượng số lượng tham số thực sự hoạt động trong một mô hình, nó biến đổi hệ tọa độ để loại bỏ các tổ hợp tham số dư thừa dựa trên kích thước dữ liệu sẵn có. Phương pháp này sau đó được áp dụng trong học máy cổ điển và lượng tử để đánh giá chính xác khả năng biểu đạt, khả năng huấn luyện và khả năng tổng quát hóa của mô hình.
Ở mức độ khái quát, chiều hiệu dụng đặt câu hỏi: Trên một vùng tham số và phân phối dữ liệu được chọn, mô hình này có bao nhiêu hướng phân biệt được và mang thông tin?
Câu hỏi này khác với những gì có thể trả lời bằng độ chính xác, mất mát (loss) hay số lượng tham số thô:
- Số lượng tham số: cho biết kích thước danh nghĩa của vector tham số, nhưng bỏ qua các tham số dư thừa hoặc không hoạt động về mặt chức năng.
- Mất mát huấn luyện: cho biết mức độ tối ưu hóa khớp với dữ liệu huấn luyện, nhưng không phân biệt được hiệu suất kém đến từ tối ưu hóa, mô hình không phù hợp hay khởi tạo.
- Mất mát/độ chính xác kiểm tra: cho biết hiệu suất tổng quát hóa tiềm năng trên dữ liệu quần thể, nhưng không cho biết liệu mô hình còn có thể cải thiện bằng cách huấn luyện thêm với cách tối ưu hóa khác hay không.
- Chiều hiệu dụng: cho biết số hướng tham số phân biệt được rút ra từ dữ liệu, dù vẫn phụ thuộc vào phân phối dữ liệu, vùng tham số và thang mẫu.
Điều quan trọng là chiều hiệu dụng có liên hệ với khả năng tổng quát hóa. Theo các giả định của khung lý thuyết, nó có thể cung cấp một giới hạn phụ thuộc độ phức tạp cho hiệu suất tổng quát hóa. Trực giác rằng một mô hình có ít hướng tham số phân biệt được hơn sẽ ít có khả năng khớp với các dao động tùy ý trong một tập dữ liệu hữu hạn.
Chiều hiệu dụng cũng giúp phân tích khả năng huấn luyện. Các mô hình có khả năng biểu đạt cao không tự động dễ huấn luyện: một số hướng tham số có thể gần như không ảnh hưởng đến phân phối đầu ra, trong khi những hướng khác lại tương quan mạnh. Những hiệu ứng này có thể khiến tối ưu hóa bị điều kiện hóa kém hoặc gần như phẳng lì, đồng thời khiến mô hình dễ bị quá khớp hơn.
Mất mát huấn luyện và kiểm tra vẫn là những chẩn đoán thiết yếu, nhưng chúng phụ thuộc vào quỹ đạo tối ưu hóa. Một khởi tạo kém, tốc độ học không phù hợp hay bộ tối ưu yếu có thể khiến một kiến trúc vốn huấn luyện được trông như không thể huấn luyện trong một lần chạy cụ thể. Ngược lại, chiều hiệu dụng mô tả hình học tham số của mô hình so với dữ liệu, biến nó thành một chẩn đoán bổ sung thay vì thay thế các đường cong huấn luyện thực nghiệm.
Ngoài các chẩn đoán này, chiều hiệu dụng còn quan trọng vì số lượng tham số có thể phản ánh sai độ phức tạp thực sự của mô hình. Mỗi tham số bổ sung đều có chi phí: nhiều phép đánh giá mạch hơn để tính gradient, nhiều cổng chịu nhiễu hơn, và không gian tìm kiếm lớn hơn để tối ưu. Chi phí này chỉ đáng giá nếu tham số đó thêm một hướng mà mô hình thực sự có thể thay đổi hành vi. Chiều hiệu dụng ước lượng có bao nhiêu hướng như vậy tồn tại, qua đó cho biết kích thước của mô hình có đang được tận dụng hay không.
Khi hai mô hình có hiệu suất tương đương, mô hình có ít hướng hiệu dụng hơn thường là lựa chọn tốt hơn, vì nó đạt cùng kết quả với độ phức tạp thấp hơn. Đây chính là dao cạo Occam: ưu tiên lời giải thích đơn giản hơn khi nó giải thích các quan sát tốt như nhau. Mục tiêu không phải là giảm thiểu độ phức tạp bằng mọi giá, mà là tìm một mô hình có độ phức tạp phù hợp với bài toán.
Công cụ then chốt được sử dụng để tính chiều hiệu dụng là ma trận thông tin Fisher.
Thông tin Fisher: trực giác
Ma trận thông tin Fisher mô tả mức độ nhạy cảm của phân phối dự đoán của mô hình trước những thay đổi của tham số. Nói cách khác, nó định lượng mức độ dữ liệu quan sát được có thể cho chúng ta biết về các tham số trong hồ sơ thống kê của mô hình.
Hãy xét các mẫu được rút ra từ phân phối Gaussian với trung bình μ chưa biết và độ lệch chuẩn σ đã biết: x ~ N(μ, σ²). Giả sử ta muốn ước lượng μ từ n mẫu. Hãy so sánh hai trường hợp:
- Một Gaussian hẹp, với σ nhỏ.
- Một Gaussian rộng, với σ lớn.
Khi σ nhỏ, các điểm mẫu tập trung chặt quanh trung bình. Ngay cả một tập dữ liệu khiêm tốn cũng cung cấp bằng chứng mạnh về vị trí của μ. Khi σ lớn, các mẫu phân tán hơn nhiều. Cùng số lượng quan sát cho ước lượng μ kém chính xác hơn, vì nhiều giá trị trung bình gần đó vẫn còn hợp lý.
Đây chính là điều thông tin Fisher nắm bắt. Với một quan sát từ N(μ, σ²), thông tin Fisher về μ là F(μ) = 1/σ². Với n quan sát độc lập, thông tin cộng dồn: F_n(μ) = n/σ². Nhiều dữ liệu hơn làm tăng thông tin theo tuyến tính. Nhiều nhiễu hơn làm giảm thông tin.
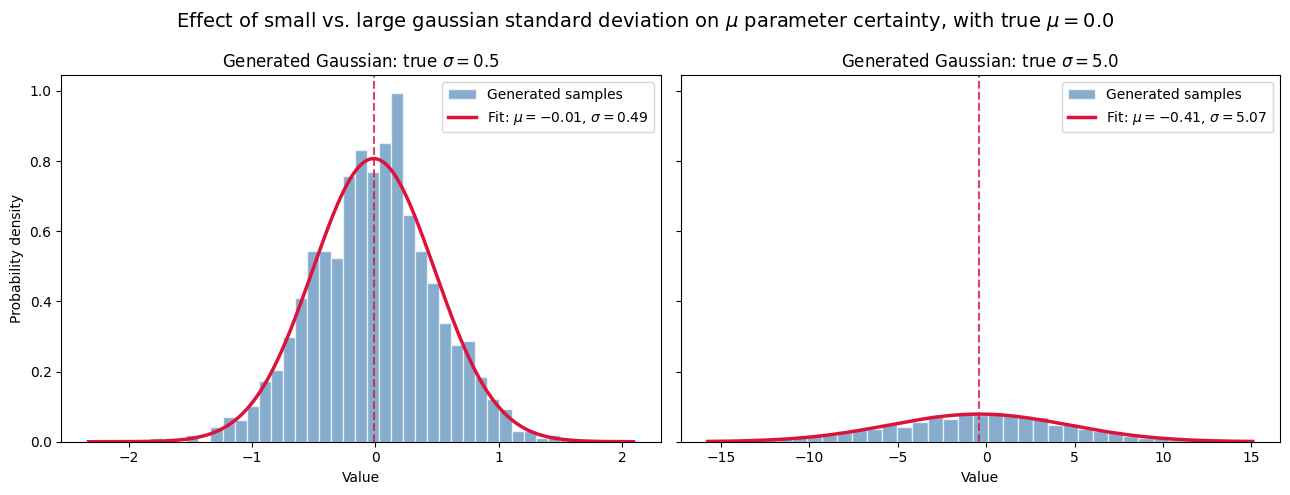 Hàm khả năng dốc hơn cho thấy quan sát ràng buộc tham số mạnh hơn
Từ hàm khả năng đến thông tin Fisher
Để hình thức hóa trực giác này, hãy cố định một điểm dữ liệu quan sát x và xem mật độ xác suất p(x | θ) như một hàm của tham số θ. Đây là hàm khả năng (likelihood).
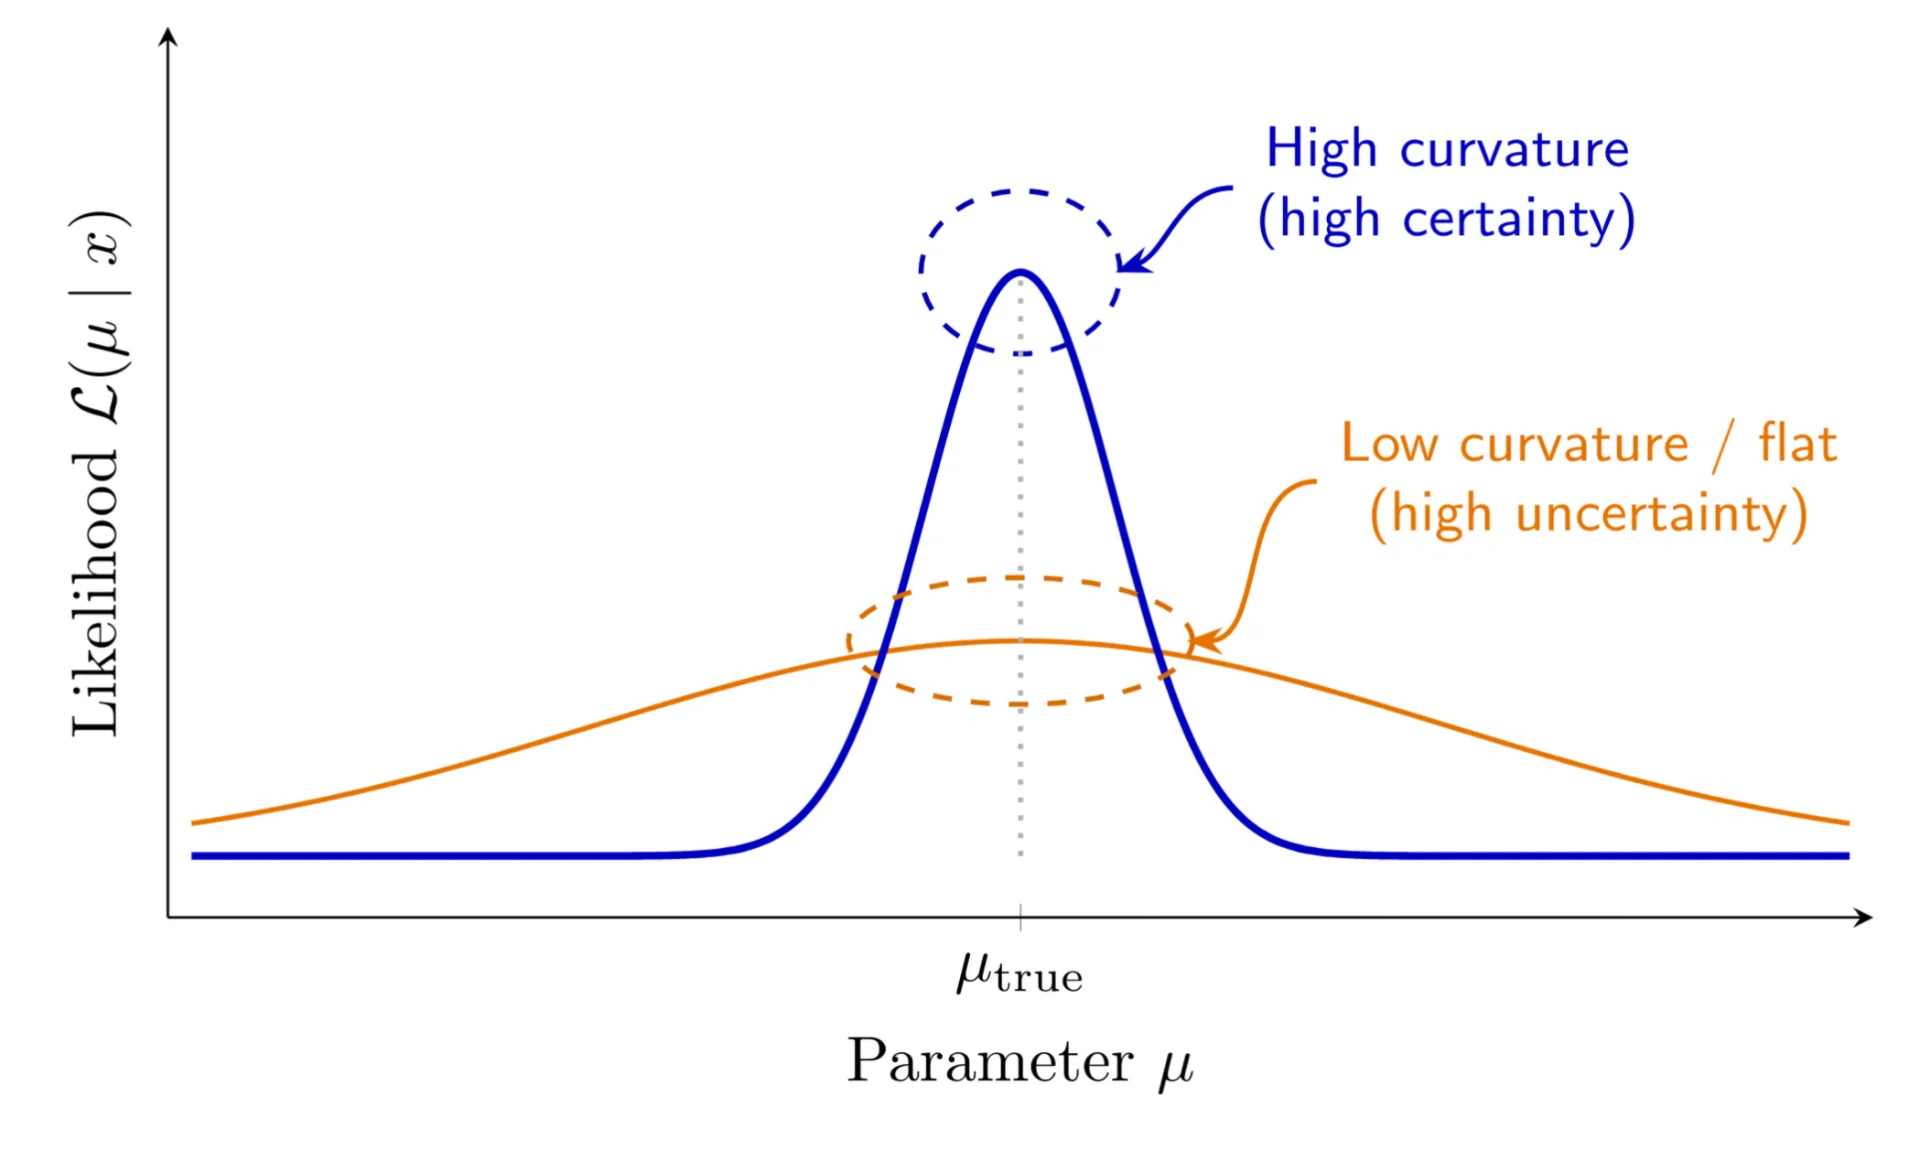
Hàm khả năng cho biết những giá trị tham số nào khiến dữ liệu quan sát hợp lý hơn hoặc kém hợp lý hơn. Hãy xét hai đường cong khả năng:
- Hàm khả năng phẳng: các giá trị tham số gần nhau giải thích dữ liệu gần như tương đương.
- Hàm khả năng nhọn: thay đổi nhỏ của tham số khiến quan sát kém hợp lý hơn nhiều.
Hàm khả năng nhọn nghĩa là quan sát mang nhiều thông tin về tham số. Hàm khả năng phẳng nghĩa là không.
Độ nhạy cục bộ của hàm khả năng được nắm bắt bằng cách lấy đạo hàm logarit của nó theo tham số: s(x; θ) = ∂/∂θ log p(x | θ). Đại lượng này được gọi là hàm điểm (score function), cung cấp gradient.
Hàm điểm có thể dương hoặc âm tùy theo hướng mà hàm khả năng thay đổi. Thông tin Fisher nên đo độ lớn thay vì hướng, nên ta bình phương hàm điểm và lấy trung bình trên tất cả các quan sát có thể sinh ra bởi mô hình:
F(θ) = E[(∂/∂θ log p(x | θ))² | θ]
Với biến ngẫu nhiên liên tục, kỳ vọng này trở thành:
F(θ) = ∫ p(x | θ) (∂/∂θ log p(x | θ))² dx
Đây là thông tin Fisher cho một mô hình một tham số.
Ví dụ Gaussian
Hãy tính thông tin Fisher cho trung bình μ của phân phối Gaussian với σ đã biết. Phân phối Gaussian:
p(x | μ) = 1/√(2πσ²) · exp[−(x−μ)² / (2σ²)]
Lấy logarit cho ta log-hàm khả năng:
log p(x | μ) = −½ log(2πσ²) − (x−μ)² / (2σ²)
Đạo hàm theo μ tạo ra hàm điểm:
∂/∂μ log p(x | μ) = (x−μ) / σ²
Bình phương nó:
((x−μ) / σ²)² = (x−μ)² / σ⁴
Cuối cùng, lấy kỳ vọng theo x ~ N(μ, σ²) cho ta:
F(μ) = E[(x−μ)² / σ⁴] = σ² / σ⁴ = 1/σ²
Kết quả khớp với trực giác: phương sai nhỏ khiến trung bình dễ ước lượng hơn, nên thông tin Fisher lớn. Phương sai lớn khiến trung bình khó ước lượng hơn, nên thông tin Fisher nhỏ.
Từ vô hướng đến ma trận
Các mô hình học máy thực tế có nhiều tham số: θ = (θ₁, θ₂, …, θ_k)ᵀ. Với mô hình nhiều tham số, thông tin Fisher là một ma trận mà phần tử (i,j) là kỳ vọng của tích các hàm điểm tương ứng:
F_(i,j)(θ) = E[(∂/∂θ_i log p(x; θ))(∂/∂θ_j log p(x; θ)) | θ]
Các phần tử trên đường chéo đo độ nhạy với từng tham số riêng lẻ. Các phần tử ngoài đường chéo đo mức độ "liên kết có hướng" giữa các hiệu ứng tham số, từ đó định nghĩa hình học của các tham số mô hình.
Sự liên kết này rất quan trọng. Nếu hai tham số ảnh hưởng đến đầu ra gần như cùng một cách, ma trận thông tin Fisher sẽ gần kỳ dị dọc theo một hướng. Đó là phiên bản đa biến của ví dụ trước, nơi chỉ có θ₁ + θ₂ là quan trọng.
Chiều hiệu dụng sử dụng hình học thông tin Fisher này để vượt ra khỏi số lượng tham số thô. Nó đặt câu hỏi không phải mô hình chứa bao nhiêu tham số, mà là dữ liệu thực sự có thể phân giải được bao nhiêu hướng trong không gian tham số.
Bức tranh trực giác về chiều hiệu dụng
Một mô hình thống kê có thể được viết dưới dạng một họ phân phối xác suất được đánh chỉ mục bởi các tham số huấn luyện được:
M_Θ = { p(·, ·, θ) : θ ∈ Θ }
Ở đây, θ là vector tham số và Θ là không gian tham số. Tùy theo bối cảnh học máy, p(·, ·, θ) có thể mô tả phân phối đồng thời p(x, y | θ) hoặc, phổ biến hơn trong học có giám sát, phân phối dự đoán có điều kiện p(y | x, θ).
Có hai cách hữu ích để nghiên cứu chiều hiệu dụng của họ này:
- Chiều hiệu dụng toàn cục, xét toàn bộ không gian tham số.
- Chiều hiệu dụng cục bộ, xét một lân cận quanh một cấu hình tham số cụ thể, thường là cấu hình đạt được trong hoặc sau khi huấn luyện.
Toàn cục hay cục bộ?
Chiều hiệu dụng toàn cục hỏi mô hình có bao nhiêu hướng tham số mang thông tin, tính trung bình trên toàn bộ không gian tham số Θ. Điều này khiến nó hữu ích cho việc so sánh ở cấp kiến trúc. Ví dụ, nếu muốn so sánh một mạch lượng tử biến phân với một mạng nơ-ron cổ điển trong khi kiểm soát các yếu tố khác, chiều hiệu dụng toàn cục có thể cho biết kiến trúc nào có nhiều bậc tự do chức năng phân biệt được hơn.
Vì lấy trung bình trên toàn bộ không gian tham số, chiều hiệu dụng toàn cục không gắn với một khởi tạo cụ thể hay một quỹ đạo tối ưu hóa. Điều này có giá trị khi thực hiện các so sánh có kiểm soát giữa các lớp mô hình.
Tuy nhiên, chiều hiệu dụng toàn cục không nên được hiểu là hoàn toàn độc lập với dữ liệu. Ma trận thông tin Fisher phụ thuộc vào phân phối dự đoán của mô hình và, trong học có giám sát, thường phụ thuộc vào phân phối dữ liệu đầu vào. Điều mà chiều hiệu dụng toàn cục loại bỏ là sự phụ thuộc vào một lời giải đã huấn luyện hoặc một vùng cụ thể mà một lần chạy bộ tối ưu hóa đã đi qua.
Góc nhìn rộng đó cũng chính là hạn chế chính của nó. Một mô hình có thể chứa những vùng không gian tham số mang nhiều thông tin mà trong thực tế không bao giờ đạt tới — vì khó tối ưu hóa, vì khởi tạo đặt quá trình huấn luyện ở xa chúng, hoặc vì chuẩn hóa (regularization) ngăn mô hình bước vào. Trong những trường hợp như vậy, chiều hiệu dụng toàn cục có thể mô tả năng lực lý thuyết của họ mô hình mà không phản ánh chính xác năng lực được sử dụng bởi một mô hình đã huấn luyện cụ thể.
Điều này dẫn đến động lực cho chiều hiệu dụng cục bộ. Thay vì tích phân trên toàn bộ Θ, chiều hiệu dụng cục bộ giới hạn phân tích trong một lân cận quanh vector tham số tham chiếu θ*, thường là các tham số đạt được sau huấn luyện:
B_ε(θ*) = { θ : ‖θ − θ*‖ ≤ ε }
Do đó, thước đo cục bộ đặt một câu hỏi thực tế hơn: Gần lời giải mà quá trình huấn luyện thực sự tìm ra, có bao nhiêu hướng tham số phân biệt được từ dữ liệu sẵn có?
Theo nghĩa này, chiều hiệu dụng cục bộ có thể phản ánh tương tác giữa kiến trúc, tập dữ liệu, khởi tạo và quy trình tối ưu hóa. Nó đặc biệt hữu ích khi muốn hiểu hành vi độ phức tạp và tổng quát hóa của một mô hình đã huấn luyện thay vì năng lực lý thuyết của toàn bộ kiến trúc. Hơn nữa, chiều hiệu dụng cục bộ có thể giúp xác minh liệu mô hình đã huấn luyện còn năng lực học chưa được sử dụng hay không.
 Chiều hiệu dụng toàn cục lấy trung bình trên toàn không gian tham số, trong khi chiều cục bộ xét một lân cận
Công thức chiều hiệu dụng
Giờ ta có thể giới thiệu chiều hiệu dụng toàn cục. Theo công thức được Abbas và cộng sự sử dụng, nó được định nghĩa là:
d_(n,γ)(M_Θ) := 2 · log( (1/V_Θ) ∫_Θ √det(I_k + (γn / (2π log n)) F̂(θ)) dθ ) / log( γn / (2π log n) )
Có nhiều ký hiệu ở đây, nhưng ý tưởng cơ bản là xem xét thông tin Fisher trên khắp một vùng không gian tham số được chọn và kết hợp những gì tìm được thành một con số duy nhất. Ở đây, k là số tham số huấn luyện được, I_k là ma trận đơn vị k×k, n là kích thước mẫu, và γ là một hằng số trong cấu trúc. Tích phân chạy trên vùng tham số Θ; chia cho thể tích của nó, V_Θ = ∫_Θ dθ, biến tích phân thành một giá trị trung bình.
Đối tượng lạ ở đây là F̂(θ). Đây là ma trận thông tin Fisher F(θ) nhưng với thang tổng thể được điều chỉnh. Để thấy cách làm, trước tiên lấy vết (trace) của F, tức tổng các trị riêng. Sau đó lấy trung bình vết đó trên vùng tham số. Ma trận chuẩn hóa cho phần tử (i,j) trở thành:
F̂_(i,j) := k · (V_Θ / ∫Θ Tr(F(ϑ)) dϑ) · F(i,j)(θ)
Mẫu số được tính một lần bằng toàn bộ vùng Θ. Mọi ma trận Fisher trong vùng đó sau đó được nhân với cùng một hệ số. Tại sao chọn hệ số này? Nó khiến vết trung bình của ma trận Fisher chuẩn hóa bằng k:
(1/V_Θ) ∫_Θ Tr(F̂(θ)) dθ = k
Nói cách khác, trị riêng Fisher trung bình được đặt bằng một. Điều này cho các ma trận một thang tham chiếu chung, nhưng không làm mọi trị riêng bằng một. Ví dụ, trong mô hình hai tham số, các trị riêng 1 và 1 có cùng vết như các trị riêng 1,9 và 0,1. Việc chuẩn hóa đối xử với tổng thang của chúng như nhau trong khi vẫn giữ khác biệt quan trọng giữa hai hướng mang thông tin tương đương và một hướng trội.
Với chiều hiệu dụng cục bộ, biểu thức tương tự được sử dụng, nhưng Θ được thay bằng quả cầu cục bộ B_ε(θ*), và V_Θ được thay bằng thể tích V_ε của quả cầu đó.
Sự khác biệt đó đi vào chiều hiệu dụng thông qua định thức:
det(I_K + (γn / (2π log n)) F̂(θ))
Đây là nơi hình học thông tin Fisher bước vào định nghĩa.
Đọc phổ Fisher
Để thấy định thức này làm gì, định nghĩa hệ số thang:
κ_(n,γ) = γn / (2π log n)
Hệ số này giống nhau tại mọi giá trị tham số θ và được dùng để đạt các tính chất tiệm cận mong muốn của chiều hiệu dụng.
Giờ chéo hóa ma trận thông tin Fisher chuẩn hóa:
F̂(θ) = U diag(λ₁(θ), …, λ_k(θ)) Uᵀ
Các vector riêng trong U xác định các hướng độc lập trong không gian tham số. Các trị riêng tương ứng λ_i(θ) định lượng mức độ mạnh mà thay đổi dọc theo các hướng đó ảnh hưởng đến phân phối đầu ra của mô hình.
Vì định thức bất biến dưới phép quay, ta thu được:
det(I_k + κ_(n,γ) F̂(θ)) = ∏(i=1)^k (1 + κ(n,γ) λ_i(θ))
Căn bậc hai trong công thức chiều hiệu dụng sau đó cho:
√det(I_k + κ_(n,γ) F̂(θ)) = ∏(i=1)^k √(1 + κ(n,γ) λ_i(θ))
Tại một điểm cố định θ, lấy logarit biến tích này thành tổng:
log √det(I_k + κ_(n,γ) F̂(θ)) = ½ ∑(i=1)^k log(1 + κ(n,γ) λ_i(θ))
Đây là biểu thức then chốt để hiểu chiều hiệu dụng. Mỗi hướng riêng Fisher đóng góp theo log(1 + κ_(n,γ) λ_i). Mức đóng góp phụ thuộc vào việc trị riêng lớn hay nhỏ so với thang phân giải 1/κ_(n,γ).
Những hướng gần như vô hình
Xét một hướng với κ_(n,γ) λ_i ≪ 1. Dùng xấp xỉ Taylor bậc một: log(1 + κ_(n,γ) λ_i) ≈ κ_(n,γ) λ_i. Đóng góp này nhỏ. Một hướng riêng như vậy tương ứng với tổ hợp tham số gần như không thay đổi phân phối dự đoán của mô hình ở độ phân giải đã chọn. Dữ liệu không thể phân biệt đáng tin cậy sự thay đổi theo hướng đó, nên nó đóng góp rất ít vào độ phức tạp hiệu dụng của mô hình.
Những hướng mang thông tin
Xét trường hợp ngược lại: κ_(n,γ) λ_i ≫ 1. Khi đó số 1 trở nên không đáng kể: log(1 + κ_(n,γ) λ_i) ≈ log(κ_(n,γ) λ_i) = log(κ_(n,γ)) + log(λ_i). Trong định nghĩa chiều hiệu dụng, tử số được chuẩn hóa bởi log(κ_(n,γ)). Ở chế độ n lớn, số hạng phụ thuộc thang chiếm ưu thế và tỷ lệ log κ_(n,γ) / log κ_(n,γ) = 1. Phần hiệu chỉnh còn lại phụ thuộc trị riêng, log λ_i / log κ_(n,γ), trở nên tương đối nhỏ khi κ_(n,γ) lớn và trị riêng vẫn hữu hạn.
Đây là lý do chiều hiệu dụng hành xử như một phép đếm "mềm" các hướng tham số mang thông tin, phụ thuộc độ phân giải. Nó không chỉ hỏi "mô hình có bao nhiêu tham số?" mà hỏi: Ở độ phân giải do n xác định, dữ liệu có thể phân biệt được bao nhiêu hướng tham số? Trong giới hạn n lớn, chiều hiệu dụng tiến tới hạng tối đa của ma trận thông tin Fisher theo các giả định của cấu trúc.
Tại sao thang đo lại quan trọng
Tham số n thường được mô tả là kích thước tập dữ liệu. Điều này nhìn chung đúng, vì khung chiều hiệu dụng liên kết n với tổng quát hóa mẫu hữu hạn. Nhưng cũng hữu ích khi hiểu n như một thang phân giải.
Một tập dữ liệu lớn hơn có thể phân biệt những khác biệt nhỏ hơn giữa hai phân phối dự đoán gần nhau. Khi n tăng, những hướng trước đây quá yếu để quan sát có thể trở nên mang thông tin.
Phép loại suy hình học ở đây rất hữu ích. Hãy tưởng tượng quan sát một vật thể ở các độ phóng đại khác nhau. Ở thang thô, nó có thể trông như một bề mặt hai chiều đơn giản. Ở thang mịn hơn, bạn có thể phát hiện rằng bề mặt đó thực ra là một đường cong hẹp uốn lượn trong không gian. Ở thang còn mịn hơn nữa, đường cong đó có thể lộ ra những dao động nhỏ hoặc cấu trúc bổ sung.
Đây là lý do nên đánh giá chiều hiệu dụng trên một loạt giá trị n thay vì chỉ báo cáo một con số. Trong ứng dụng thực tế, các giá trị phù hợp nhất là những giá trị gần với kích thước của các tập dữ liệu mà mô hình sẽ thực sự được huấn luyện.
Lời kết
Chiều hiệu dụng là một thước đo độ phức tạp dựa trên hình học của hồ sơ thống kê của mô hình. Nó vượt ra khỏi số lượng tham số thô bằng cách xác định có bao nhiêu hướng tham số thực sự phân biệt được từ dữ liệu.
Giá trị của nó đến từ việc kết nối nhiều ý tưởng thường được nghiên cứu riêng rẽ:
- Năng lực và khả năng biểu đạt của mô hình.
- Tính dư thừa và khả năng nhận dạng của tham số.
- Hình học thông tin Fisher.
- Khả năng tổng quát hóa với dữ liệu hữu hạn.
- Khả năng huấn luyện và cảnh quan tối ưu hóa.
Theo các giả định của lý thuyết nền tảng, chiều hiệu dụng có thể được dùng để suy ra các giới hạn cho sai số tổng quát hóa. Nó không nên được đọc như một dự đoán trực tiếp về độ chính xác kiểm tra, nhưng nó cung cấp một đại lượng độ phức tạp có nguyên tắc, bổ sung cho các đường cong huấn luyện thực nghiệm và kết quả kiểm định.
Điều quan trọng là chiều hiệu dụng định lượng năng lực học thông qua không gian tham số — một góc nhìn áp dụng như nhau cho các mô hình cổ điển và mô hình lượng tử được tham số hóa. Trong học máy lượng tử, các khung lý thuyết thay thế mô tả năng lực trực tiếp trên không gian Hilbert của các trạng thái lượng tử, điều mà thước đo này không đề c
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Brick Night: Thiết bị chặn ứng dụng tự động kích hoạt khi bạn bước vào phòng ngủ
23 tháng 10, 2026