Tác giả Platypush viết lại pipeline trợ lý giọng nói nội bộ
Fabio Manganiello đã thay openWakeWord bằng microWakeWord và đổi cách phát hiện đầu cuối câu nói trong pipeline trợ lý giọng nói tự vận hành trên Platypush. Thay đổi giúp giảm báo nhầm, bắt đúng từ khóa và kết thúc hội thoại nhanh hơn nhiều so với trước.
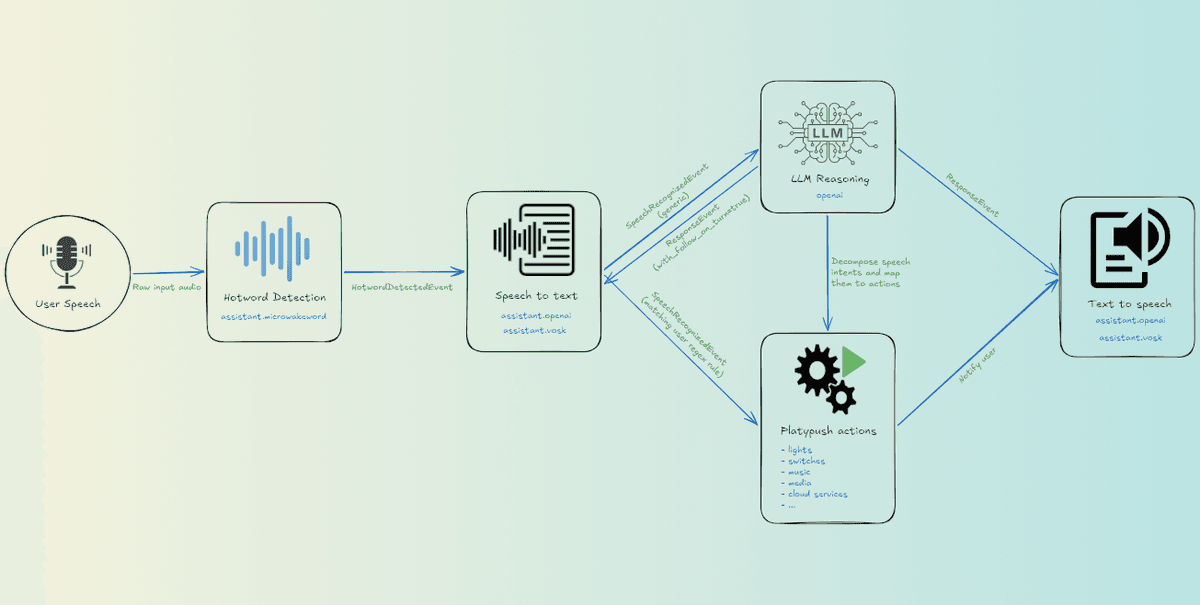
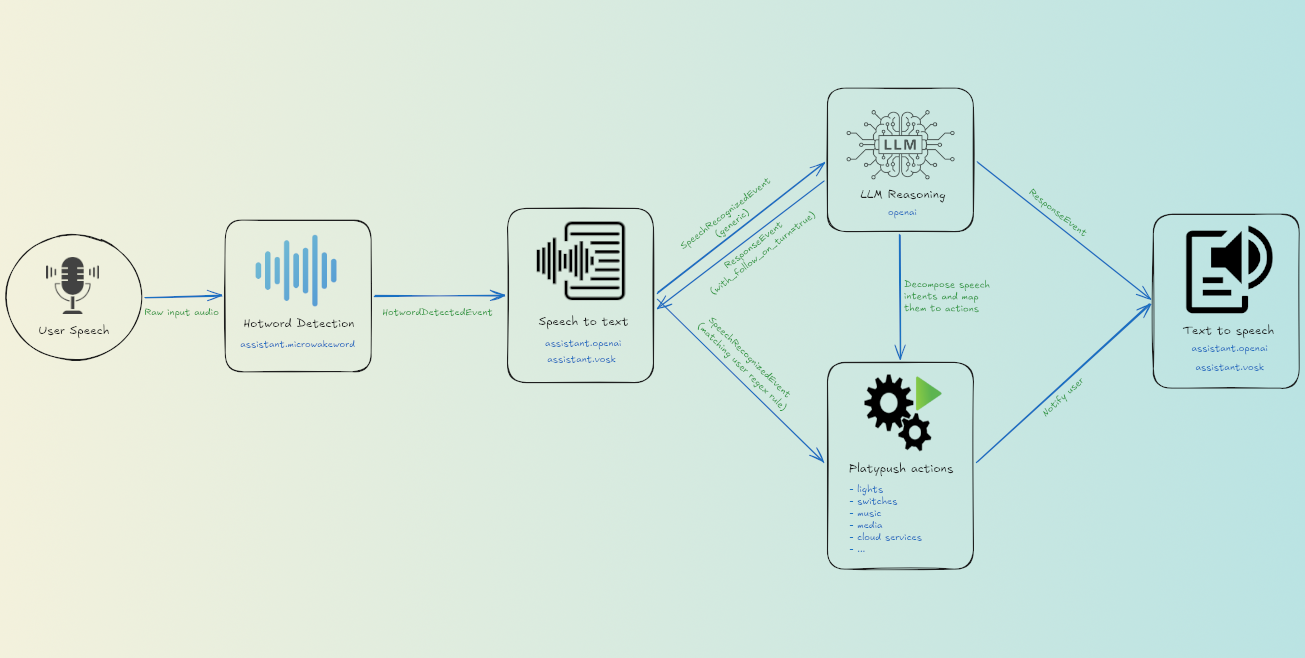 Sơ đồ pipeline trợ lý giọng nói
Fabio Manganiello vừa công bố bản viết lại pipeline trợ lý giọng nói tự vận hành của mình trên Platypush. Sau vài tháng dùng phiên bản cũ làm công cụ chính, ông không hài lòng với tỷ lệ báo nhầm và bỏ sót cao, cùng khả năng nhận biết lúc bắt đầu và kết thúc câu nói kém trong môi trường ồn ào.
Đổi engine phát hiện từ khóa đánh thức
Trước đây tác giả dùng assistant.openwakeword, lớp bọc quanh openWakeWord. Công cụ này vẫn chạy nhưng dự án đã im ắng một thời gian, toàn bộ mô hình huấn luyện sẵn đều là tệp v0.1 từ năm 2023, phần lớn dựa trên giọng nói tổng hợp. Hệ quả là từ khóa kích hoạt cả khi có tiếng ồn nền, và không được nhận ra nếu người dùng đứng xa micro.
Bản mới dùng assistant.microwakeword, xây trên microWakeWord qua bộ ràng buộc Python pymicro-wakeword. Đây là engine mà ESPHome và Home Assistant Voice dùng, mô hình được cập nhật thường xuyên và đi kèm gói cài đặt, gồm okay_nabu, hey_jarvis, hey_mycroft và alexa, không cần tải thêm.
Người dùng vẫn có thể nạp mô hình tự huấn luyện: đặt một manifest JSON của microWakeWord cùng tệp .tflite vào thư mục models của plugin rồi gọi theo tên.
Plugin giữ nguyên giao diện lập trình của bản cũ, gồm các tham số models, detection_threshold, frame_duration, patience_frames, input_device, input_volume, hành động list_models và sự kiện HotwordDetectedEvent. Chuyển sang chỉ cần sửa cấu hình:
assistant.microwakeword:
  models:
    - alexa
Nếu không đặt detection_threshold, mỗi mô hình dùng giá trị probability_cutoff trong manifest của nó, ví dụ 0.9 với alexa. Do mô hình đã tự làm mượt đầu ra theo cửa sổ trượt, patience_frames mặc định bằng 0, khác với openwakeword.
Luồng xử lý âm thanh không gọi trực tiếp mô hình TFLite. Nó đẩy các khung âm thanh và dấu đặt lại vào hàng đợi cho luồng chính, vì hàm MicroWakeWord.reset() nạp lại bộ thông dịch và không an toàn khi gọi đồng thời.
Nhận dạng giọng nói với khả năng nghe tốt hơn
assistant.openai ghi âm khi hội thoại bắt đầu và chuyển thành văn bản qua Whisper. Phần khó nhất luôn là xác định lúc người dùng nói xong. Cách làm cũ dựa trên một giá trị đúng/sai cho từng khung từ WebRTC VAD, và bất kỳ khung nào bị xếp là giọng nói đều đặt lại bộ đếm im lặng. Chỉ cần chút tiếng ồn nền, câu nói chỉ kết thúc khi chạm giới hạn thời lượng tối đa.
Lớp tiền xử lý âm thanh dùng chung cho các tích hợp nhận dạng giọng nói đã được làm lại:
- Dùng Silero VAD làm backend chính qua onnxruntime, không cần PyTorch; WebRTC VAD và bộ dò dựa trên RMS là phương án dự phòng. Mô hình Silero được tải về lần đầu và kiểm tra checksum.
- Trễ phân cấp và cửa sổ trượt: một khung được tính là giọng nói khi vượt ngưỡng VAD và giữ trạng thái đó cho tới khi điểm giảm quá một biên; quyết định từng khung được làm mượt bằng bỏ phiếu đa số trên cửa sổ 0.5 giây. Một đợt nhiễu đơn lẻ không còn kéo dài hội thoại.
- Sàn nhiễu thích ứng: mức ồn nền được theo dõi liên tục, khung nào không to hơn noise_floor_factor (mặc định 2.0, khoảng 6 dB) lần mức nền thì không được coi là giọng nói.
Trên một bài kiểm thử tổng hợp, ghép câu nói do Piper tạo với nhiễu babble và nhiễu xung, cấu hình cũ giữ hội thoại mở thêm 6 đến 10 giây sau khi nói xong. Pipeline mới kết thúc sau 1.0 đến 1.6 giây kể từ từ cuối cùng, tức là conversation_end_timeout cộng với độ trễ làm mượt.
Vì thay đổi nằm ngay trong AudioPreprocessor, các plugin nhận dạng giọng nói gốc khác cũng hưởng lợi, ví dụ assistant.vosk khi chạy hoàn toàn trên thiết bị.
Phản hồi và tổng hợp giọng nói
Câu đã chuyển thành văn bản được plugin openai xử lý, phụ trách cả khóa API lẫn ngữ cảnh hội thoại. Mặc định trợ lý đọc câu trả lời qua tts_plugin đã cấu hình; nếu câu trả lời kết thúc bằng dấu hỏi, hội thoại tiếp tục với lượt hỏi nối.
Người dùng có thể chèn hook để chặn câu lệnh trước khi câu trả lời mặc định chạy, ví dụ xử lý lệnh nhà thông minh ngay tại máy mà không cần gọi mô hình ngôn ngữ lớn qua mạng:
from platypush import run, when
from platypush.message.event.assistant import SpeechRecognizedEvent

@when(SpeechRecognizedEvent, phrase='play (the)? music')
def play_music():
    run('music.mpd.play')
Sự kiện từ khóa đánh thức được nối với thao tác bắt đầu hội thoại theo cách tương tự, dùng HotwordDetectedEvent và lệnh assistant.openai.start_conversation.
Phần đọc phản hồi do tts.openai đảm nhận, có thể chỉnh âm lượng và giọng. Trong thử nghiệm, tts.piper cũng cho kết quả tốt và chạy hoàn toàn cục bộ, nhưng trên Raspberry Pi 5 nó cộng thêm khoảng 3 đến 4 giây độ trễ khi chuyển phản hồi thành âm thanh so với tts.openai.
Do âm thanh đọc phát ra loa còn bộ dò từ khóa nghe bằng micro, các plugin trợ lý tạm dừng dò trong lúc hội thoại đang diễn ra, nếu không trợ lý sẽ nghe chính mình.
Những điểm cần lưu ý
Micro trên Raspberry Pi của tác giả không hỗ trợ tần số lấy mẫu 16 kHz gốc, nên âm thanh được thu ở 44.1 kHz rồi lấy mẫu lại bằng phần mềm. Cách này vẫn chạy, nhưng nếu cảm giác nhận dạng chậm thì bước lấy mẫu lại bằng phần mềm là nghi phạm đầu tiên.
Các giá trị mặc định của VAD và ngưỡng được tinh chỉnh trên âm thanh tổng hợp cùng vài bản ghi của chính tác giả. Phòng khác, micro khác và âm học khác có thể cho kết quả khác. Nếu chưa hài lòng, nên chỉnh detection_threshold ở plugin từ khóa đánh thức và noise_floor_factor ở plugin nhận dạng giọng nói.
Góc nhìn
Pipeline này cho thấy một trợ lý giọng nói tự vận hành vẫn khả thi nếu chọn đúng engine. Việc chuyển từ mô hình cũ sang microWakeWord không đòi hỏi viết lại toàn bộ hệ thống, vì giao diện lập trình được giữ nguyên và chỉ cần sửa tệp cấu hình.
Với kỹ sư Việt Nam đang làm sản phẩm nhà thông minh trên Raspberry Pi, phần đáng học nhất là cách xử lý đầu cuối câu nói. Phát hiện đúng lúc người dùng nói xong quan trọng hơn cả việc nhận dạng từng từ chính xác, và các kỹ thuật như trễ phân cấp, bỏ phiếu đa số, sàn nhiễu thích ứng có thể áp dụng ngay mà không phụ thuộc nhà cung cấp đám mây.
Nguồn: blog.platypush.tech · Quy trình biên tập