
Tự cải thiện đệ quy bằng trí tuệ tập thể: Bước ngoặt Odysseus của AI
Sakana AI giới thiệu MASS — phương pháp dùng chính mô hình AI làm người giải, người tối ưu và người đánh giá trong một vòng lặp tự cải thiện đệ quy. Bằng cách chưng cất trí tuệ tập thể từ các hệ đa tác tử, mô hình Qwen3.6-27B đạt hiệu suất trên mỗi token cao gấp 1,2–1,6 lần sau hai vòng huấn luyện.
Tự cải thiện đệ quy bằng trí tuệ tập thể: Bước ngoặt Odysseus của AI
Sakana AI vừa công bố nghiên cứu về MASS (Multi-Agent Self-Supervision) — một phương pháp cho phép mô hình AI tự tối ưu hóa quy trình làm việc đa tác tử, rồi chưng cất trí tuệ tập thể đó thành tín hiệu tự giám sát cho quá trình tự cải thiện đệ quy (RSI). Kết quả cho thấy mô hình có thể nâng cao "điểm trên mỗi token đầu ra" lên gấp 1,2–1,6 lần so với mô hình gốc trên nhiều chuẩn đánh giá nghiên cứu.
 Minh họa quy trình làm việc trong xưởng in — ẩn dụ cho quá trình tinh chỉnh lặp đi lặp lại
Vì sao cần tự cải thiện đệ quy?
Để vượt qua khối lượng tri thức mà nhân loại đã tích lũy qua nhiều thế hệ, AI có thể phải trở thành người tối ưu và người đánh giá tốt nhất cho chính mình. Ở biên giới tri thức đó, ngay cả các chuyên gia con người cũng có thể gặp khó khăn trong việc đánh giá kết quả và định hướng tiến bộ tiếp theo — đặc biệt với các nhiệm vụ không thể kiểm chứng tự động.
Ví dụ, việc thẩm định một phát minh khoa học có thể đòi hỏi chuyên môn khan hiếm, bằng chứng tốn kém, hoặc những thí nghiệm kéo dài lâu hơn nhiều so với thời gian sinh ra đề xuất. Trong bối cảnh đó, chính mô hình có thể là giám sát viên tài năng nhất hiện có.
Điều này dẫn đến khái niệm tự cải thiện đệ quy đồng nhất (homogeneous RSI): mô hình vừa là đối tượng được cải thiện (optimizee), vừa là bộ tối ưu (optimizer), vừa là bộ đánh giá (evaluator). Câu hỏi trung tâm là làm sao có được tín hiệu tự giám sát hữu ích trong vòng lặp khép kín này.
Các xã hội loài người là một phép so sánh hữu ích: qua các cộng đồng săn bắt, khu định cư nông nghiệp, xã hội công nghiệp và mạng lưới thông tin toàn cầu, con người mở rộng năng lực bằng cách phân chia công việc, kết hợp ý tưởng và truyền lại những gì học được. Thành tựu tập thể trở thành điểm khởi đầu cho việc học tiếp theo.
MASS hoạt động như thế nào?
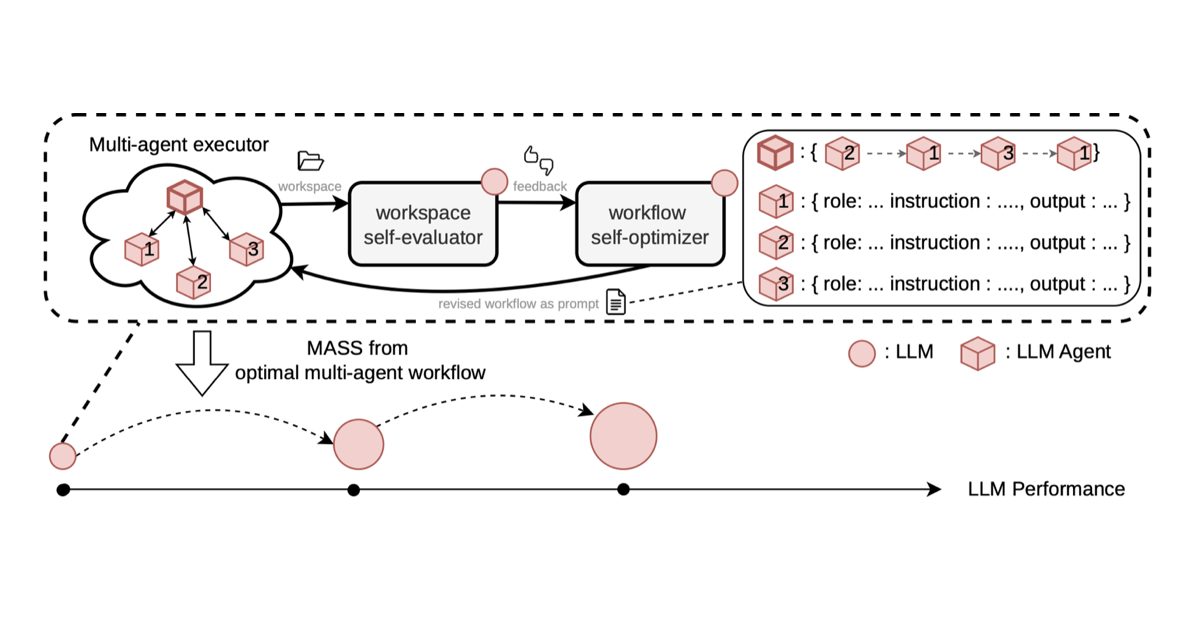
MASS sử dụng cùng một mô hình cho cả ba vai trò: người thực thi, người tối ưu và người đánh giá. Bộ tối ưu trước tiên tìm kiếm quy trình làm việc nhóm tốt nhất dựa trên phản hồi từ bộ đánh giá, sau đó huấn luyện người thực thi trên các lần chạy của nhóm được tự đánh giá là tốt nhất. Mô hình cập nhật lại tiếp tục đảm nhận cả ba vai trò, và vòng lặp tiếp diễn.
Khung này vận hành theo hai vòng lặp lồng nhau:
- Vòng lặp trong: tối ưu quy trình làm việc của nhóm trong khi trọng số mô hình giữ nguyên. Chính mô hình tự đánh giá và phán xét quy trình nào là tối ưu.
- Vòng lặp ngoài: cập nhật trọng số bằng cách học từ các lần thực thi của quy trình đã được tối ưu.
Một quy trình làm việc (workflow) là bản kế hoạch bằng văn bản về cách một nhóm đa tác tử phối hợp với nhau. Nó gồm bốn thành phần: vai trò (roles), hướng dẫn (instructions), hợp đồng dữ liệu (contracts) và điểm bàn giao (hops). Kế hoạch này được thêm vào gợi ý nhiệm vụ, cho phép mô hình kiểm tra và sửa đổi cấu trúc tổ chức của nhóm.
 Biểu đồ token hiệu quả: điểm trên mỗi token đầu ra tăng qua các thế hệ
Ví dụ về một quy trình tài chính đã tiến hóa: nó sắp xếp các bước chuẩn bị dữ liệu, xây dựng đặc trưng, mô hình hóa và kiểm thử ngược (backtesting) thành một chuỗi, theo sau là bước kiểm toán. Hợp đồng dữ liệu yêu cầu chuyên gia dữ liệu phải kiểm tra lỗi rò rỉ thông tin tương lai (leakage) — một lỗi khiến kết quả kiểm thử trông thuyết phục nhưng thực chất vô nghĩa — và báo cáo xem các mốc thời gian có hợp lệ không.
Kết quả thực nghiệm
Nhóm nghiên cứu chạy hai vòng MASS hoàn chỉnh từ mô hình Qwen3.6-27B trong môi trường tác tử lập trình qwen-code. Bộ dữ liệu nghiên cứu tổng hợp gồm 12 nhiệm vụ thuộc ba lĩnh vực: tài chính, robot và dược phẩm — mỗi nhiệm vụ yêu cầu viết mã, kết quả định lượng và một báo cáo nghiên cứu.
Kết quả nổi bật:
- Trên ba nhiệm vụ kiểm tra tổng hợp, tỷ lệ thắng so với mô hình gốc tăng từ 53,9% sau một vòng lên 69,9% sau hai vòng.
- Mô hình vòng hai cũng thắng 60,8% số so sánh trước mô hình vòng một.
- Trên các chuẩn công khai như MLR-Bench, DSBench, ScienceAgentBench và AstaBench, điểm trên mỗi token đầu ra đạt 1,2–1,6 lần mức của mô hình gốc sau hai vòng.
Tuy nhiên, khả năng chuyển giao vẫn chưa đồng đều: trên Terminal-Bench 2.0 chỉ đạt 0,96 lần và trên SWE-bench Verified là 0,94 lần so với mô hình gốc. Nhóm nghiên cứu cho rằng có thể khắc phục bằng cách đưa các nhiệm vụ kỹ thuật phần mềm vào dữ liệu huấn luyện.
 Biểu đồ tỷ lệ bao phủ quy trình qua các thế hệ
Phát hiện đáng chú ý về vai trò và nút thắt
Một phát hiện quan trọng: MASS cho phép tổng quát hóa vai trò. Mô hình chỉ được huấn luyện trên các quỹ đạo giải nhiệm vụ, nhưng năng lực của cả bộ tối ưu quy trình lẫn bộ đánh giá workspace cũng được cải thiện theo. Điều này khiến vòng lặp RSI trở nên bền vững.
Cụ thể, mức độ đồng thuận của bộ đánh giá với các giám khảo bên ngoài mạnh (GPT-5.5 và Claude Opus 4.8) tăng từ 73% lên 93% qua ba chu kỳ.
Về phân tích quy trình tối ưu, nhóm nghiên cứu nhận thấy một xu hướng thú vị: qua quá trình tối ưu, quy trình đa tác tử có xu hướng mã hóa thông tin nhiệm vụ mạnh hơn vào hợp đồng và điểm bàn giao, và ít hơn vào vai trò và hướng dẫn. Các thành phần cũng trở nên ít phụ thuộc lẫn nhau hơn.
Nút thắt của RSI có thể nằm ở bộ tối ưu, không phải bộ đánh giá. Khi thay bộ đánh giá bằng mô hình mạnh bên ngoài, cải thiện chỉ ở mức nhỏ; nhưng khi nâng cấp cả bộ tối ưu, kết quả cải thiện rõ rệt. Cách diễn giải: bộ đánh giá mạnh có thể cung cấp phản hồi chất lượng cao, nhưng bộ tối ưu yếu không đủ khả năng "tiêu hóa" phản hồi đó.
Bài toán an toàn và khoảng mù chung
Tennyson viết trong Ulysses về hành trình vươn tới tri thức "vượt ngoài biên giới tư duy con người". Với AI, nhóm nghiên cứu hình dung một khoảnh khắc Odysseus khi việc học tiếp diễn mà không có giám sát viên mạnh hơn.
Ở vòng lặp đồng nhất, một khoảng mù chung có thể cho phép một kết quả sai lệch được tạo ra, được chấp nhận như một cải tiến, và được đưa vào mô hình kế tiếp. Nếu con người cũng gặp khó khăn trong việc nhận ra sai lệch đó, các cập nhật liên tiếp có thể củng cố nó. Điểm đáng lo là cùng một điểm yếu có thể làm suy yếu cả hành vi của hệ thống lẫn cơ chế được thiết kế để sửa chữa nó.
Theo một nghĩa nào đó, khoảng mù chung có thể là "gót chân Achilles" của quá trình tự cải thiện đệ quy.
Nghiên cứu của OpenAI về khả năng giám sát chuỗi suy luận (chain-of-thought monitorability) minh họa một phần thách thức này: các dấu vết lý luận có thể giúp phát hiện hành vi sai, nhưng chỉ cung cấp bằng chứng không đầy đủ. Đây là câu hỏi an toàn trung tâm cho khoảnh khắc Odysseus của AI: làm sao duy trì sự giám sát có ý nghĩa khi không còn giám sát viên mạnh hơn nào khả dụng.
Ý nghĩa với cộng đồng AI tại Việt Nam
Nghiên cứu này đáng chú ý với các nhóm nghiên cứu và kỹ sư AI trong nước ở vài điểm:
- Hiệu quả token: đạt điểm cao hơn với ít token giám sát hơn 31% cho thấy tiềm năng tiết kiệm chi phí huấn luyện đáng kể — điều đặc biệt quan trọng với các nhóm có ngân sách hạn chế.
- Tín hiệu từ đa tác tử: các quỹ đạo từ hệ đa tác tử có thể mang tín hiệu học tập dày đặc hơn so với quỹ đạo đơn tác tử — một hướng đi đáng thử cho các bài toán nghiên cứu mở.
- Ưu tiên bộ tối ưu: nếu nguồn lực có hạn, nên tập trung nâng cấp năng lực tối ưu hơn là chỉ nâng cấp bộ đánh giá.
Dù vậy, giới nghiên cứu vẫn cần thận trọng. Tự cải thiện đệ quy đồng nhất đặt ra những câu hỏi an toàn chưa có lời giải trọn vẹn, và việc duy trì khả năng sửa chữa các phán đoán của chính hệ thống sẽ là điều kiện tiên quyết trước khi triển khai ở quy mô lớn.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
BraiNOTES: Ghi chú viết tay trên PDF bài giảng ngay trong trình duyệt, không cần tài khoản
11 tháng 10, 2026