
Word Embeddings: Cách máy tính học mối quan hệ giữa các từ
Word embeddings là kỹ thuật biểu diễn từ ngữ dưới dạng vector số, giúp máy tính hiểu được quan hệ ngữ nghĩa giữa các từ dựa trên ngữ cảnh. Bài viết giải thích chi tiết cách mô hình Word2Vec với kiến trúc Skip-gram học các mối quan hệ này, từ việc chuyển từ thành vector, tính điểm dot product, đến sử dụng hàm Softmax để dự đoán từ ngữ cảnh.
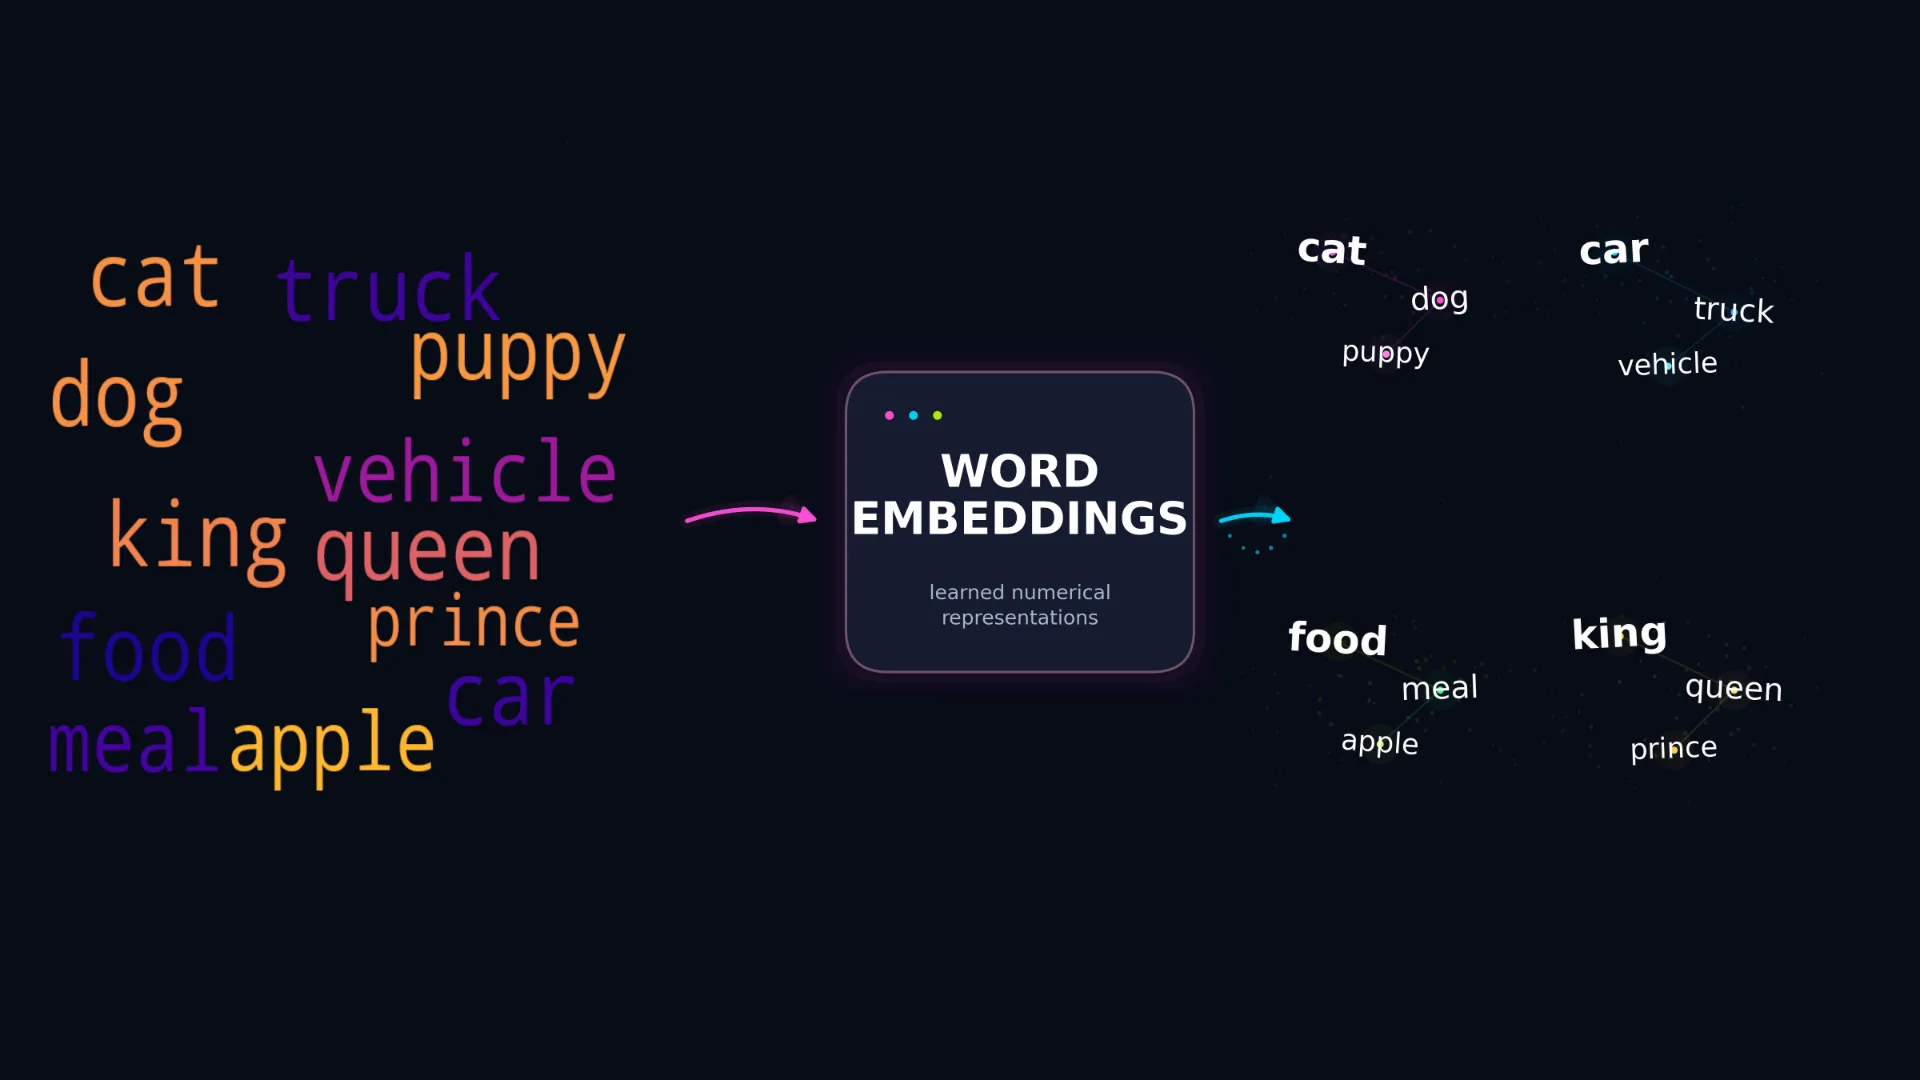
Word Embeddings: Cách máy tính học mối quan hệ giữa các từ
Bạn có bao giờ thắc mắc tại sao khi tìm kiếm "giày chạy bộ" trên ứng dụng mua sắm, hệ thống vẫn hiển thị cả những sản phẩm được mô tả là "giày thể thao" hay "sneakers" không? Đằng sau khả năng này là một khái niệm quan trọng trong trí tuệ nhân tạo: word embeddings — kỹ thuật biểu diễn từ ngữ dưới dạng vector số, giúp máy tính hiểu được mối quan hệ ngữ nghĩa giữa các từ.
 Minh họa word embeddings trong không gian vector
Tại sao cần biểu diễn từ ngữ bằng số?
Máy tính không thể hiểu trực tiếp ngôn ngữ tự nhiên như con người. Để xử lý văn bản, chúng ta cần chuyển đổi từ ngữ thành dạng số mà máy có thể tính toán được.
Trước đây, các phương pháp thống kê như TF-IDF đã được sử dụng để biểu diễn văn bản. Tuy nhiên, TF-IDF chỉ dựa trên tần suất xuất hiện của từ trong tài liệu, chứ không học được mối quan hệ ngữ nghĩa giữa các từ.
Word embeddings ra đời để giải quyết hạn chế này. Thay vì chỉ đếm tần suất, word embeddings học cách biểu diễn mỗi từ dựa trên ngữ cảnh mà từ đó xuất hiện. Kết quả là những từ có ý nghĩa tương tự nhau hoặc thường xuất hiện trong ngữ cảnh giống nhau sẽ có vector gần nhau trong không gian đa chiều.
Ứng dụng của embeddings trong AI hiện đại
Embeddings không chỉ giới hạn ở việc tìm kiếm sản phẩm. Chúng là nền tảng của nhiều ứng dụng AI hiện đại:
- Mô hình ngôn ngữ lớn (LLM) như GPT sử dụng embeddings để xử lý input từ người dùng
- Retrieval-Augmented Generation (RAG) — kỹ thuật giúp AI truy xuất thông tin liên quan từ web hoặc cơ sở dữ liệu để tạo câu trả lời chính xác hơn
- Hệ thống tìm kiếm hiện đại kết hợp nhiều phương pháp: so khớp từ khóa, embeddings, và mô hình xếp hạng để tìm kiếm theo ngữ nghĩa thay vì chỉ khớp chính xác từng ký tự
Word2Vec: Học mối quan hệ từ ngữ cảnh
Word2Vec là một trong những kỹ thuật phổ biến nhất để học word embeddings. Nó có hai kiến trúc chính:
- Skip-gram: Dùng từ mục tiêu để dự đoán các từ ngữ cảnh xung quanh
- CBOW (Continuous Bag of Words): Dùng các từ ngữ cảnh để dự đoán từ mục tiêu
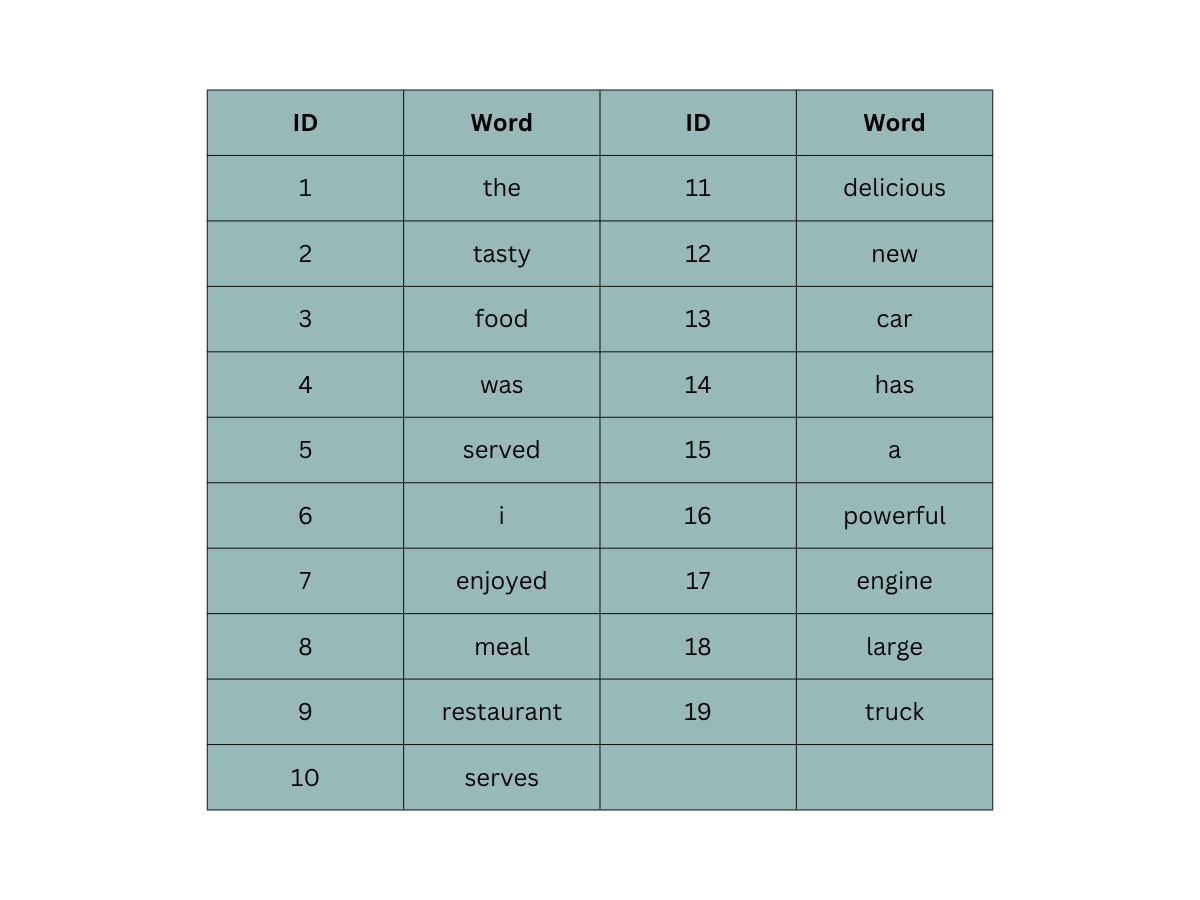
Hãy cùng tìm hiểu cách Skip-gram hoạt động qua một ví dụ đơn giản. Giả sử ta có câu: "The tasty food was served" (Món ăn ngon đã được phục vụ).
Nếu chọn "food" làm từ mục tiêu và đặt cửa sổ ngữ cảnh bằng 1, ta sẽ có hai từ ngữ cảnh là "tasty" và "was". Từ đó tạo ra hai cặp huấn luyện: (food, tasty) và (food, was).
Skip-gram sẽ nhận từ mục tiêu "food" và cố gắng dự đoán từ ngữ cảnh "tasty". Qua nhiều lần lặp, mô hình học được những từ nào thường xuất hiện gần nhau trong văn bản.
Biểu diễn từ dưới dạng vector
Mỗi từ trong từ điển được biểu diễn bằng một vector số. Ví dụ, với embedding dimension là 2, từ "food" có thể được biểu diễn là [0.2, 0.7].
Ban đầu, các giá trị này được khởi tạo ngẫu nhiên và sẽ được cập nhật dần trong quá trình huấn luyện. Với 19 từ duy nhất trong từ điển và embedding dimension là 2, ta có ma trận embedding kích thước 19×2.
Trong thực tế, embedding dimension thường lớn hơn nhiều — có thể là 100, 300, 512, 768, 1024, 1536 hoặc lớn hơn, tùy thuộc vào mô hình và ứng dụng. Dimension càng lớn thì khả năng biểu diễn càng phong phú, nhưng cũng đòi hỏi nhiều tài nguyên tính toán và bộ nhớ hơn.
Điều thú vị là các chiều trong embedding không có ý nghĩa rõ ràng với con người. Không có chiều nào là "liên quan đến thức ăn" hay "cảm xúc". Thông tin về ngữ pháp, ngữ nghĩa, chủ đề được phân tán khắp các chiều, và mô hình tự học các giá trị số từ dữ liệu huấn luyện.
Hai bộ vector trong Word2Vec
Một điểm đặc biệt của Word2Vec là nó sử dụng hai bộ vector riêng biệt:
- Target/input vectors (v): Biểu diễn từ khi nó là từ mục tiêu
- Context/output vectors (u): Biểu diễn từ khi nó là từ ngữ cảnh
Với 19 từ trong từ điển, ta có tổng cộng 38 vector. Cách tiếp cận này giúp mô hình linh hoạt hơn trong việc học các mối quan hệ phức tạp.
 Minh họa quá trình tính điểm dot product
Tính điểm bằng Dot Product
Để đo mức độ phù hợp giữa từ mục tiêu và từ ngữ cảnh, mô hình sử dụng dot product (tích vô hướng). Hai vector cùng hướng sẽ có dot product lớn, ngược hướng sẽ có giá trị nhỏ hoặc âm.
Ví dụ với cặp (food, tasty):
v_food = [0.2, 0.7]u_tasty = [0.4, 0.8]- Dot product = 0.2×0.4 + 0.7×0.8 = 0.64
Tuy nhiên, điểm số này cần được so sánh với tất cả các từ khác trong từ điển. Với 19 từ, ta tính được 19 điểm số — một cho mỗi từ có thể làm ngữ cảnh.
Chuyển điểm số thành xác suất với Softmax
Điểm dot product chưa đủ để mô hình đưa ra quyết định. Ta cần chuyển chúng thành xác suất bằng hàm Softmax. Hàm này đảm bảo tất cả xác suất nằm trong khoảng 0 đến 1 và tổng bằng 1.
Công thức Softmax cho bài toán Skip-gram:
P(w_O | w_I) = exp(u_wO^T · v_wI) / Σ exp(u_w^T · v_wI)
Trong đó:
w_Ilà từ mục tiêu (input)w_Olà từ ngữ cảnh cần dự đoánv_wIlà target vector của từ mục tiêuu_wOlà context vector của từ ứng viên- Tổng ở mẫu số chạy qua tất cả từ trong từ điển
Với ví dụ trên, xác suất của "tasty" khi biết "food" xấp xỉ 6.74% dựa trên các vector khởi tạo ngẫu nhiên. Con số này sẽ thay đổi khi mô hình học được các mối quan hệ thực sự từ dữ liệu.
Softmax xem xét tất cả các từ trong từ điển khi tính xác suất. Ngay cả khi dot product của "tasty" không đổi, xác suất của nó vẫn có thể thay đổi nếu điểm số của các từ khác thay đổi — vì mẫu số bao gồm điểm của cả 19 từ.
 Minh họa hàm Softmax trong Word2Vec
Quá trình học diễn ra như thế nào?
Mục tiêu của huấn luyện là điều chỉnh các vector sao cho xác suất của từ ngữ cảnh đúng được tăng lên. Mô hình không chỉ cần tăng điểm cho từ đúng, mà còn phải phân biệt từ đúng với các từ khác trong từ điển.
Qua nhiều vòng lặp với hàng triệu cặp target-context từ dữ liệu văn bản lớn, các vector dần được tinh chỉnh. Kết quả là những từ có ngữ cảnh sử dụng tương tự nhau sẽ có vector gần nhau trong không gian embedding — đây chính là cơ sở để máy tính "hiểu" được mối quan hệ ngữ nghĩa giữa các từ.
Ý nghĩa với người dùng Việt Nam
Với sự phát triển mạnh mẽ của các ứng dụng AI tại Việt Nam — từ trợ lý ảo, chatbot chăm sóc khách hàng, đến hệ thống tìm kiếm thương mại điện tử — hiểu về word embeddings giúp các kỹ sư và nhà phát triển sản phẩm xây dựng hệ thống xử lý ngôn ngữ tự nhiên hiệu quả hơn. Đặc biệt với tiếng Việt, việc huấn luyện embeddings chất lượng cao đòi hỏi dữ liệu lớn và xử lý đặc thù về từ ghép, dấu thanh — một thách thức nhưng cũng là cơ hội lớn cho cộng đồng AI trong nước.
Word embeddings chỉ là bước khởi đầu. Từ đây, chúng ta có thể khám phá những chủ đề nâng cao hơn như cách tối ưu quá trình huấn luyện, các kiến trúc tiên tiến như Transformer, và cách áp dụng embeddings trong các bài toán thực tế.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Điều khiển Siri Remote mới của Apple tương thích ngược với cả Apple TV cũ
14 tháng 10, 2026