
AI suy luận đụng trần bộ nhớ: Huawei tung OceanStor M900 để gỡ nút thắt
Khi các mô hình AI chuyển sang hội thoại dài, suy luận phức tạp và tác tử tự hành, bộ nhớ đệm KV cache phình to gây nghẽn cổ chai nghiêm trọng. Huawei giới thiệu OceanStor M900, nền tảng lưu trữ bộ nhớ ngữ cảnh hứa hẹn giảm độ trễ xuống 60 micro giây và tăng gấp đôi thông lượng token.
AI suy luận đụng trần bộ nhớ: Huawei tung OceanStor M900 để gỡ nút thắt
Khi các doanh nghiệp chuyển từ những tương tác AI đơn giản sang hội thoại dài, suy luận phức tạp và tác tử tự hành (agentic AI), áp lực lên hạ tầng công nghệ ngày càng lớn. Lượng ngữ cảnh khổng lồ đang bào mòn dung lượng bộ nhớ, trong khi việc cấp dữ liệu liên tục cho các bộ tăng tốc trở nên quan trọng chẳng kém sức mạnh tính toán thô.
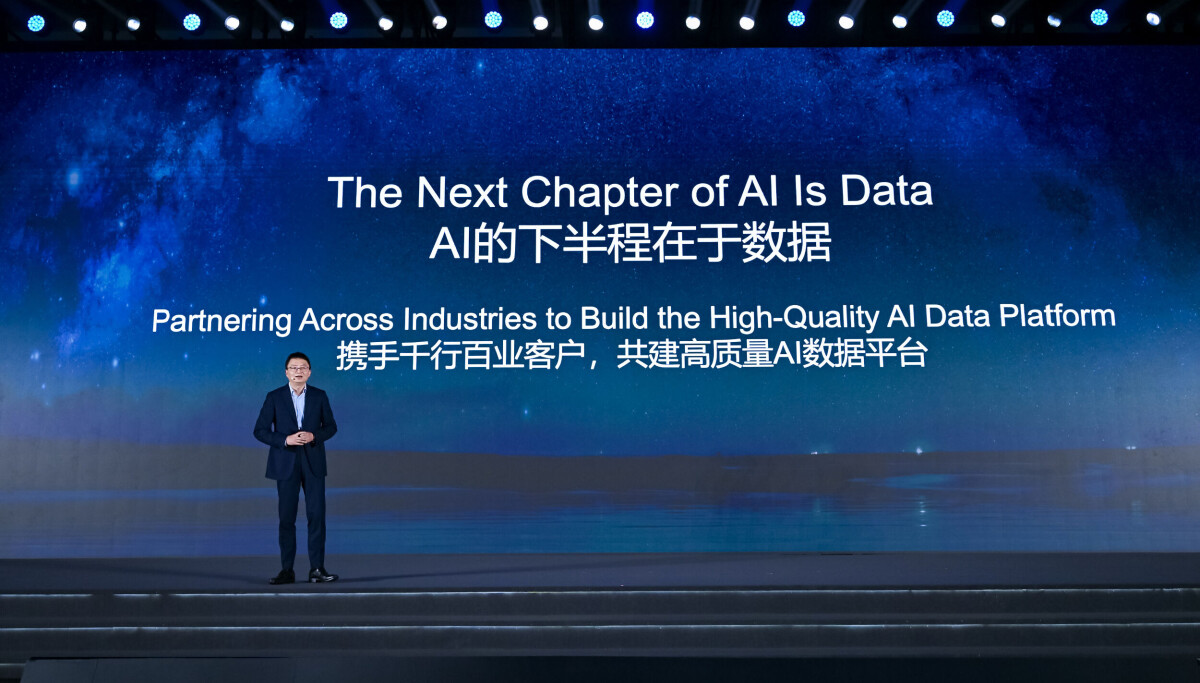
Tại sự kiện HUAWEI CONNECT 2026 diễn ra ở Thượng Hải, Huawei đã giới thiệu OceanStor M900 Context Memory Storage – nền tảng lưu trữ bộ nhớ ngữ cảnh được thiết kế riêng cho AI suy luận, hướng tới các trung tâm dữ liệu siêu quy mô và hạ tầng Ascend SuperPoD của hãng.
KV cache – nút thắt thầm lặng của AI suy luận
Điểm nghẽn đáng chú ý nhất nằm ở KV cache (key-value cache) – nơi lưu thông tin sinh ra trong quá trình suy luận để mô hình tái sử dụng các phép tính cũ thay vì xử lý lại cùng một ngữ cảnh.
Khi cửa sổ ngữ cảnh mở rộng và các tương tác nhiều lượt trở nên phức tạp hơn, các bộ đệm này phình to đáng kể, tạo ra bài toán nan giải:
- Bộ nhớ GPU và bộ nhớ hệ thống cho tốc độ truy cập nhanh nhưng đắt đỏ và dung lượng có hạn.
- Lưu trữ truyền thống có dung lượng lớn hơn, nhưng đường truyền dữ liệu dài qua CPU lại gây độ trễ, khiến tài nguyên tăng tốc đắt tiền phải ngồi chờ dữ liệu.
Huawei cho rằng cần một cách tiếp cận lưu trữ hoàn toàn khác để lấp khoảng trống này.
Đưa bộ nhớ ngữ cảnh lại gần nơi tính toán
OceanStor M900 giới thiệu khái niệm lớp lưu trữ bộ nhớ ngữ cảnh chuyên dụng, mở rộng KV cache vượt ra ngoài bộ nhớ tăng tốc và bộ nhớ hệ thống, đưa vào một bể lưu trữ dùng chung nhiều tầng.
Nhờ kết nối tốc độ cao UnifiedBus của Huawei, các tài nguyên KV cache có thể được chia sẻ trong toàn cụm, với dung lượng công bố lên tới 64PB và lượng ngữ cảnh khả dụng trên mỗi NPU lớn hơn đáng kể.
Điểm đáng chú ý là ổ đĩa ASU tích hợp chức năng CPU, mạng và bộ điều khiển lưu trữ. Kết hợp với ngữ nghĩa KV gốc, NPU có thể truy cập dữ liệu đệm chỉ trong một bước nhảy, loại bỏ việc chuyển đổi giao thức và chuyển tiếp qua CPU như cách thông thường.
Theo Huawei, cách tiếp cận này giảm độ trễ truy cập xuống còn 60 micro giây, có thể tăng gấp đôi thông lượng token và giảm một nửa thời gian phản hồi token đầu tiên trong các tác vụ lập trình AI điển hình.
Bài toán chi phí và độ bền
Ngoài hiệu năng, Huawei cũng nhắm tới hai yếu tố then chốt với các doanh nghiệp vận hành AI quy mô lớn:
- Công nghệ lưu trữ thích ứng theo ngữ nghĩa KV quản lý vị trí dữ liệu dựa trên vòng đời của cache.
- Độ bền công bố lên tới 24 lần ghi mỗi ổ mỗi ngày, gấp 16 lần SSD thông thường – hứa hẹn giảm chi phí thay thế và bảo trì theo thời gian.
Ý nghĩa lớn hơn với hạ tầng AI
Tầm quan trọng của OceanStor M900 nằm ở cách Huawei định vị lưu trữ trong tổng thể hạ tầng AI. Thay vì coi lưu trữ là thành phần phụ trợ tách biệt, hãng đang xem bộ nhớ, mạng và tính toán là những mảnh ghép ngày càng gắn kết, cùng quyết định hiệu năng suy luận.
Với người dùng Việt Nam, xu hướng này đáng chú ý khi các doanh nghiệp trong nước bắt đầu triển khai mô hình ngôn ngữ lớn cho chăm sóc khách hàng, phân tích dữ liệu hay trợ lý nội bộ. Chi phí hạ tầng – đặc biệt là bộ nhớ và lưu trữ phục vụ suy luận – đang trở thành yếu tố then chốt quyết định bài toán kinh tế của các dự án AI.
Khi các tác vụ agentic AI ngày càng phổ biến, việc hạ tầng lưu giữ, chia sẻ và truy xuất ngữ cảnh hiệu quả đến đâu có thể sẽ quan trọng chẳng kém tốc độ xử lý của các bộ tăng tốc.
Bài viết được thực hiện dựa trên thông tin từ Huawei.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Linux 7.3 chính thức phát hành: kỷ lục với gần 19.000 commit từ hơn 3.000 lập trình viên
19 tháng 10, 2026