
AI viết 613.318 dòng Lean mô hình hóa CPython, tìm 418 lỗi
Hai nhà nghiên cứu dùng AI tái tạo hàng nghìn hàm của CPython 3.15.2 bằng ngôn ngữ Lean có kiểm chứng bằng máy, phát hiện 418 báo cáo lỗi trong đó khoảng 55 lỗi có thể làm sập trình thông dịch hoặc hỏng bộ nhớ.
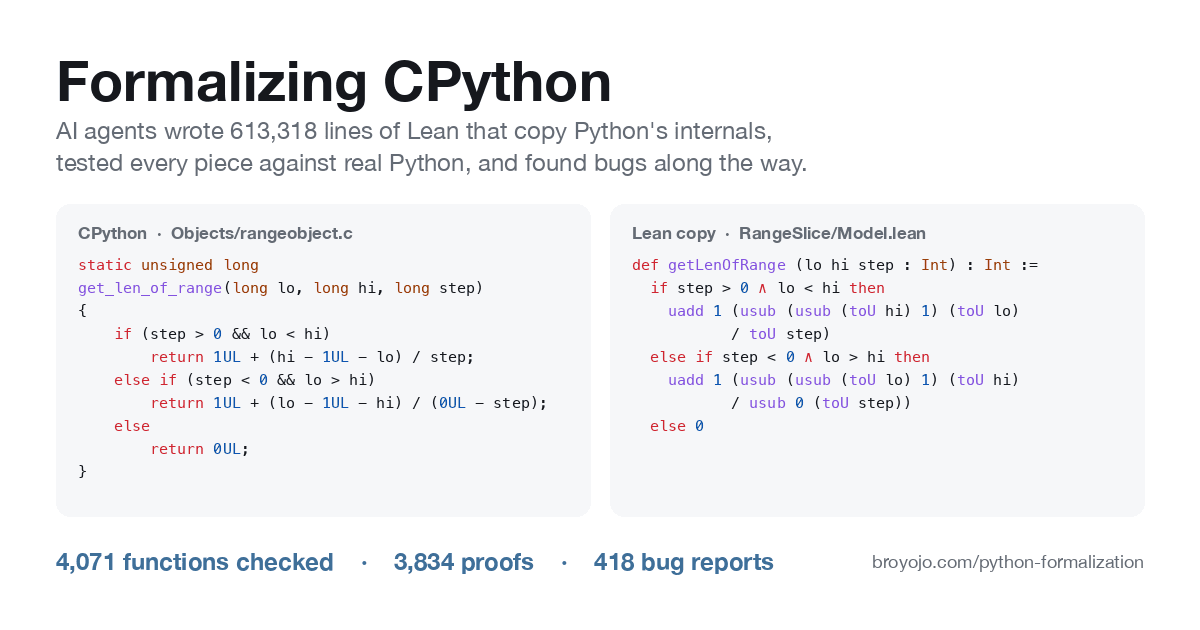
Dự án biến mã nguồn CPython thành mô hình có kiểm chứng bằng máy
David Andrews và Chao Zhang đã công bố một dự án đáng chú ý: dùng AI để viết lại từng hàm của CPython 3.15.2 — bản cài đặt tham chiếu của Python — sang Lean, ngôn ngữ lập trình cho phép viết các chứng minh toán học được máy tính kiểm tra. Kết quả là 613.318 dòng Lean trải trên 1.539 tệp, chứa 18.898 định lý và bổ đề, tất cả đều được trình kiểm chứng của Lean xác nhận ở mỗi lần biên dịch.
Điều khiến dự án gây chú ý không chỉ nằm ở khối lượng công việc, mà ở kết quả phụ: quá trình chứng minh đã làm lộ ra 418 báo cáo lỗi trong Python. Phần lớn là lỗi nhỏ, nhưng khoảng 55 lỗi có thể làm sập trình thông dịch hoặc làm hỏng bộ nhớ chỉ bằng mã Python thông thường.
Quy trình bốn bước
Mỗi hàm trải qua cùng một quy trình:
- Sao chép: viết lại hàm bằng Lean, bám sát từng dòng mã gốc, kể cả thông báo lỗi và các trường hợp biên kỳ quặc.
- Kiểm thử: chạy bản sao và Python thật song song trên ít nhất 50.000 đầu vào khó. Bất kỳ sai lệch nào cũng đồng nghĩa bản sao sai.
- Chứng minh: phát biểu một điều đáng lẽ luôn đúng và để máy kiểm tra chứng minh; nếu điều đó thực sự sai thì chứng minh điều ngược lại.
- Thẩm định: một tác nhân AI thứ hai, không tham gia viết, đối chiếu với mã gốc và cố tình phá thử. Chỉ những gì sống sót mới được tính.
Tính đến nay, 4.071 trong số 26.004 hàm đáng kiểm tra (15,7%) đã hoàn tất cả bốn bước. Đây là con số đáng kể nhưng vẫn còn phần lớn CPython ở phía trước, đặc biệt là thư viện chuẩn viết bằng chính Python. Lập trình đa luồng hiện nằm ngoài phạm vi.
Vấn đề khó nhất: chứng minh vô nghĩa
Theo nhóm nghiên cứu, phần khó nhất không phải là dạy AI viết chứng minh, mà là có được những chứng minh thực sự có ý nghĩa. Ở lần thử đầu tiên, họ yêu cầu các tác nhân sao chép mọi hàm và chứng minh ít nhất một điều gì đó. Chúng làm được — nhưng khi thẩm định độc lập, chưa đến một nửa số hàm đứng vững, có tệp chỉ đạt 21%.
Lý do: các chứng minh đúng về mặt kỹ thuật nhưng vô dụng. Chẳng hạn, "nếu hàm này trả về một số thì số đó không âm" là đúng, nhưng một hàm luôn bị sập cũng thỏa mãn điều kiện này. Tiêu chí mới được đặt ra cho người thẩm định: một phiên bản hỏng của hàm liệu có vượt qua được chứng minh này không? Nếu có, chứng minh đó không được tính.
Khi chứng minh đúng vẫn sai
Một chứng minh đã được kiểm tra chỉ đảm bảo phát biểu đúng với bản sao — không đảm bảo bản sao khớp với Python thật. Vì vậy, mọi phát biểu được chấp nhận còn được đối chiếu với Python thật. Cách này bắt được nhiều trường hợp chứng minh hợp lệ nhưng vẫn sai:
- Chuỗi 16 terabyte: bản sao bộ mã hóa JSON cho rằng mọi yêu cầu cấp phát bộ nhớ luôn thành công, nên "chứng minh" được rằng nó có thể tạo chuỗi thụt lề cho mọi độ sâu lồng nhau — kể cả trường hợp cần 16 TB bộ nhớ. Python thật sẽ hết bộ nhớ.
- Chín bước đệ quy phát sinh một lần: chứng minh cho rằng module pickle không bao giờ vượt quá một độ sâu lồng nhau nhất định, đúng ở mọi trường hợp trừ tiến trình Python vừa khởi động, khi lần đầu mã hóa chuỗi sẽ âm thầm nạp một text codec và tốn thêm chín bước.
- Họ lỗi có phân cấp: trong Python, bắt
TypeErrorcũng bắt được các lỗi cụ thể hơn kế thừa từ nó. Ba bản sao riêng biệt lại kiểm tra tên lỗi chính xác, khiến kiểu lỗi tùy chỉnh có thể phá vỡ chứng minh. - Bộ nhớ được tái sử dụng: bản sao của kiểu
setgiả định địa chỉ bộ nhớ đã giải phóng sẽ không quay lại. Bộ cấp phát thật tái sử dụng địa chỉ liên tục, khiến cơ chế kiểm tra "địa chỉ có đổi không" của CPython bị đánh lừa.
418 lỗi được phân loại
Các báo cáo lỗi được chia theo nhóm: 129 trường hợp bản C và bản Python của cùng module cho kết quả khác nhau, 122 lỗi khác, 56 kết quả sai, 28 lỗi sập, 27 lỗi hỏng bộ nhớ, 26 không khớp tài liệu, 18 sai loại hoặc nội dung thông báo lỗi, 12 thiếu kiểm tra đầu vào.
Ví dụ về lỗi sập: gọi setdefault trên từ điển thuộc tính của một đối tượng với khóa kiểu StrEnum, khi một đối tượng khác cùng lớp đã có thuộc tính đó còn đối tượng này chưa có, sẽ gây segmentation fault. Một ví dụ khác thuộc nhóm hỏng bộ nhớ: gán vào một lát cắt ngược của phần tử ElementTree đáng lẽ phải chèn như với list, nhưng lại nhân đôi một phần tử con mà không giữ tham chiếu và làm mất một phần tử khác.
Nhóm nghiên cứu lưu ý Python không coi việc chạy mã Python độc hại là ranh giới bảo mật, nên đây là các lỗi thông thường chứ không phải lỗ hổng theo nghĩa bảo mật. Những báo cáo chưa có trên trình theo dõi của CPython đang được gửi tới dự án, bắt đầu từ bài viết này. Toàn bộ mã và kịch bản tái hiện nằm trong kho lưu trữ công khai.
Bài học áp dụng cho dự án khác
Theo tác giả, phương pháp này không dành riêng cho Python mà áp dụng được với bất kỳ phần mềm nào có mã nguồn đọc được và phiên bản chạy được — một ngôn ngữ khác, một thư viện, một định dạng tệp hay một trình biên dịch. Những nguyên tắc chính:
- Chọn một phiên bản chính xác và bám chặt lấy nó.
- Liệt kê mọi thứ trước, đo tiến độ so với danh sách đầy đủ.
- Sao chép mã, không sao chép tài liệu — lỗi nằm ở chỗ mã và tài liệu mâu thuẫn.
- Cho phép mã người dùng hành xử sai, mô phỏng callback ném lỗi hoặc thay đổi trạng thái giữa chừng.
- Kiểm thử trước khi chứng minh; khi một điều là sai, giữ lại phản ví dụ thay vì làm nhạt phát biểu cho dễ chứng minh.
Góc nhìn
Với lập trình viên và kỹ sư Việt Nam, dự án này là một minh chứng thực tế cho thấy AI có thể tham gia vào công việc kỹ thuật đòi hỏi độ chính xác cao, miễn là có quy trình kiểm chứng nghiêm ngặt phía sau. Bài học quan trọng nhất không phải là "để AI viết code", mà là cơ chế thẩm định độc lập: một tác nhân thứ hai không tham gia viết, cùng câu hỏi "phiên bản hỏng liệu có vượt qua được không". Mô hình này có thể áp dụng ngay cho các nhóm đang dùng AI sinh mã trong môi trường doanh nghiệp.
Về phía kỹ thuật, danh sách 418 lỗi là tài liệu tham khảo hữu ích cho những ai viết thư viện hoặc module mở rộng bằng C cho Python, đặc biệt các trường hợp mã C đang giữ con trỏ tới cấu trúc dữ liệu mà mã Python có thể thay đổi giữa chừng. Việc theo dõi và cập nhật các bản vá từ CPython khi chúng được xử lý là cách thiết thực nhất để hưởng lợi từ công trình này.
Nguồn: broyojo.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Đừng "thuê ngoài" quá trình học hỏi: Cạm bẫy của việc phụ thuộc quá mức vào AI khi viết code
17 tháng 5, 2026
Công nghệ
Lập trình viên cảm thấy nhanh hơn 20% nhờ AI, nhưng thực tế lại chậm đi 19%
27 tháng 10, 2026
Phần mềm
Mặt trái của AI lập trình: Viết code xuất sắc nhưng "lạc trôi" trong môi trường thực tế
06 tháng 4, 2026