Azure Maia 300: Kiến trúc chip AI tối ưu suy luận quy mô đám mây
Microsoft công bố chi tiết kiến trúc Azure Maia 300, thế hệ chip AI thứ ba được thiết kế chuyên biệt cho suy luận LLM. Maia 300 mang lại hiệu năng trên mỗi watt cao gấp 2,5 lần và thông lượng token cấp rack gấp 7 lần so với Maia 200, nhờ kiến trúc đa chiplet, bộ nhớ HBM4 và mạng scale-up hai tầng kết nối tới 12.288 bộ tăng tốc.
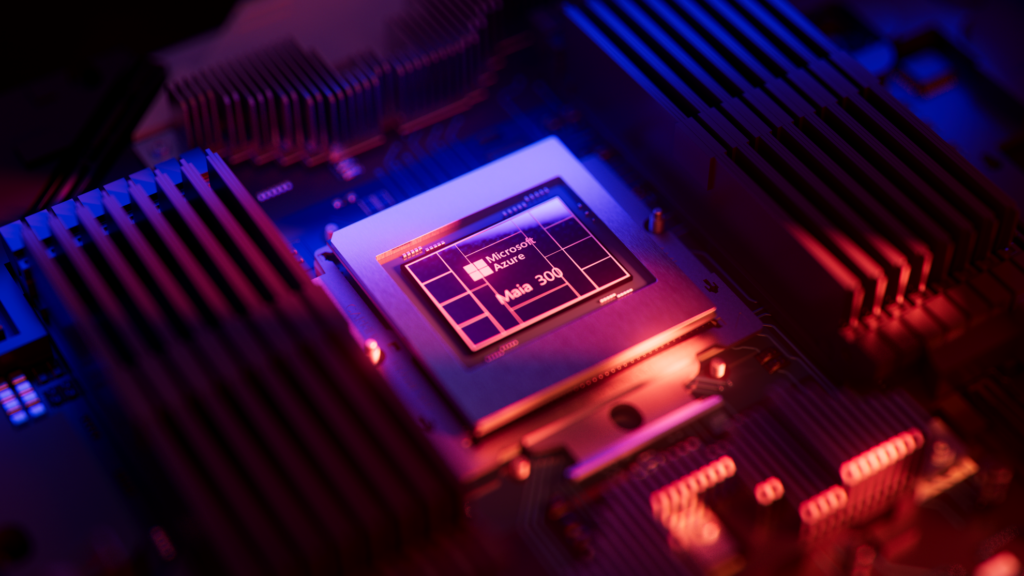
Microsoft vừa công bố chi tiết kiến trúc của Azure Maia 300, thế hệ chip tăng tốc AI thứ ba của hãng. Đây là một hệ thống hoàn chỉnh được đồng thiết kế từ phần mềm, silicon, hạ tầng rack, mạng cho đến trung tâm dữ liệu, nhằm phục vụ các tác vụ suy luận AI tác tử (agentic inference) ở quy mô đám mây. Theo Microsoft, Maia 300 đạt hiệu năng trên mỗi watt cao hơn 2,5 lần và thông lượng token cấp rack cao gấp 7 lần so với Maia 200.
Triết lý thiết kế: tối ưu từng watt cho suy luận LLM
Ngay từ khi ra đời, dòng Azure Maia đã theo đuổi một triết lý kiến trúc duy nhất: tối ưu toàn bộ hệ thống cho suy luận mô hình ngôn ngữ lớn (LLM), để mỗi watt điện và mỗi đô la bỏ ra đều tạo ra nhiều "trí tuệ" hơn. Maia 300 là hiện thân đầy đủ nhất của triết lý đó.
 Chip Azure Maia 300
Cách tiếp cận cấp hệ thống này ngày càng trở nên cần thiết khi các khối lượng công việc tác tử — bao gồm thực thi đa bước, giải mã ngữ cảnh dài và sử dụng công cụ — đã thay đổi hồ sơ tính toán cũng như cường độ số học của suy luận.
Để đáp ứng những yêu cầu này, hệ thống phải duy trì tính cục bộ của dữ liệu, cấp đủ dung lượng và băng thông bộ nhớ cho tính toán, giảm thiểu việc di chuyển dữ liệu, mở rộng giao tiếp hiệu quả và nhồi nhét nhiều năng lực nhất vào trong giới hạn điện năng, làm mát cố định của trung tâm dữ liệu.
Tại Microsoft, đội ngũ kỹ sư quan sát trực tiếp sự chuyển dịch này qua các sản phẩm như Microsoft Copilot, GitHub Copilot và Microsoft Foundry. Maia 300 được thiết kế để tối đa hóa số token hữu ích trên mỗi watt và trên mỗi đô la.
Kiến trúc dataflow định nghĩa bằng phần mềm
Maia 200 từng giới thiệu một lớp kiến trúc tăng tốc mới gọi là SDLA (Software Defined Locally Accessed Dataflow Architecture — Kiến trúc luồng dữ liệu truy cập cục bộ định nghĩa bằng phần mềm). Ý tưởng cốt lõi là quản lý dữ liệu hiệu quả — lưu trữ, di chuyển và chuyển đổi — chính là một trong những thách thức trung tâm của hệ thống AI hiện đại.
Kiến trúc dataflow lập trình được của Maia tách biệt lập trình đường điều khiển khỏi thực thi đường dữ liệu, cho phép phần mềm phối hợp tường minh việc đặt chỗ, di chuyển, chuyển đổi và đồng bộ dữ liệu trên các bộ nhớ cục bộ chuyên dụng, bộ máy DMA, bộ máy tính toán và mạng.
Maia 300 phát triển kiến trúc này cho các tác vụ suy luận ngữ cảnh dài, thiên về lý luận và giải mã nặng, với ba thay đổi lớn:
- Bộ nhớ chuyển từ UMA sang NUMA trên các chiplet, cho phép phần mềm đặt dữ liệu gần nơi tính toán sử dụng nó.
- Các định dạng độ chính xác hẹp mới với chuyển đổi kiểu dữ liệu tăng tốc bằng phần cứng, giúp giảm số byte phải di chuyển cho mỗi token.
- Rack tăng lên 96 bộ tăng tốc và miền scale-up mở rộng thành superpod 12.288 bộ tăng tốc, cho phép nhiều bộ tăng tốc cùng hoạt động hiệu quả như một hệ thống duy nhất.
Các đổi mới kiến trúc giúp tăng hiệu năng trên mỗi watt
Thay vì chỉ mở rộng hiệu năng bằng cách tăng điện năng và diện tích silicon, Maia 300 cải thiện hiệu năng trên mỗi watt qua một loạt đổi mới tối ưu di chuyển dữ liệu, tính cục bộ, độ chính xác và hiệu quả bộ nhớ.
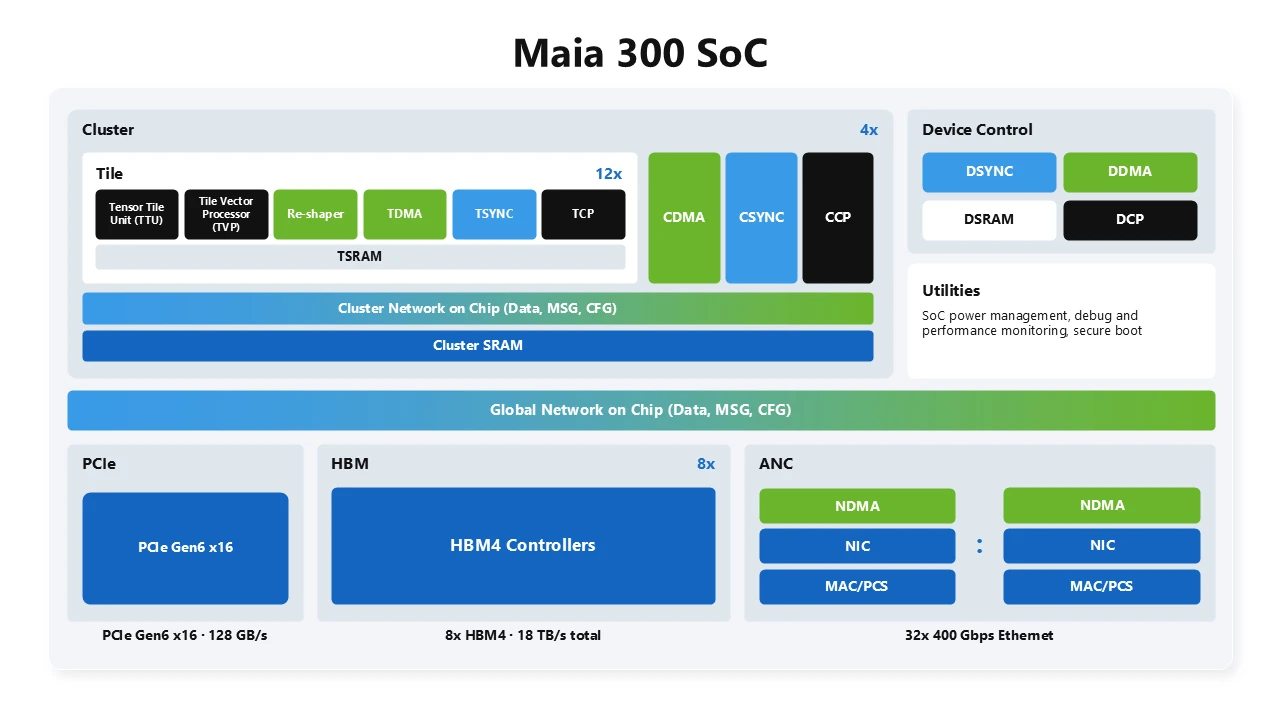
Kiến trúc đa chiplet: Maia 300 đặt phần tính toán trên tiến trình TSMC N2P — nơi mang lại lợi ích hiệu năng trên mỗi watt lớn nhất — trong khi tách các chức năng điều khiển bộ nhớ và I/O sang những die được tối ưu cho băng thông, kết nối và chi phí. Chiến lược này tăng số FLOP tính toán của hệ thống lên 36%, thêm 2,5 lần băng thông HBM và cung cấp thêm 14% băng thông scale-up.
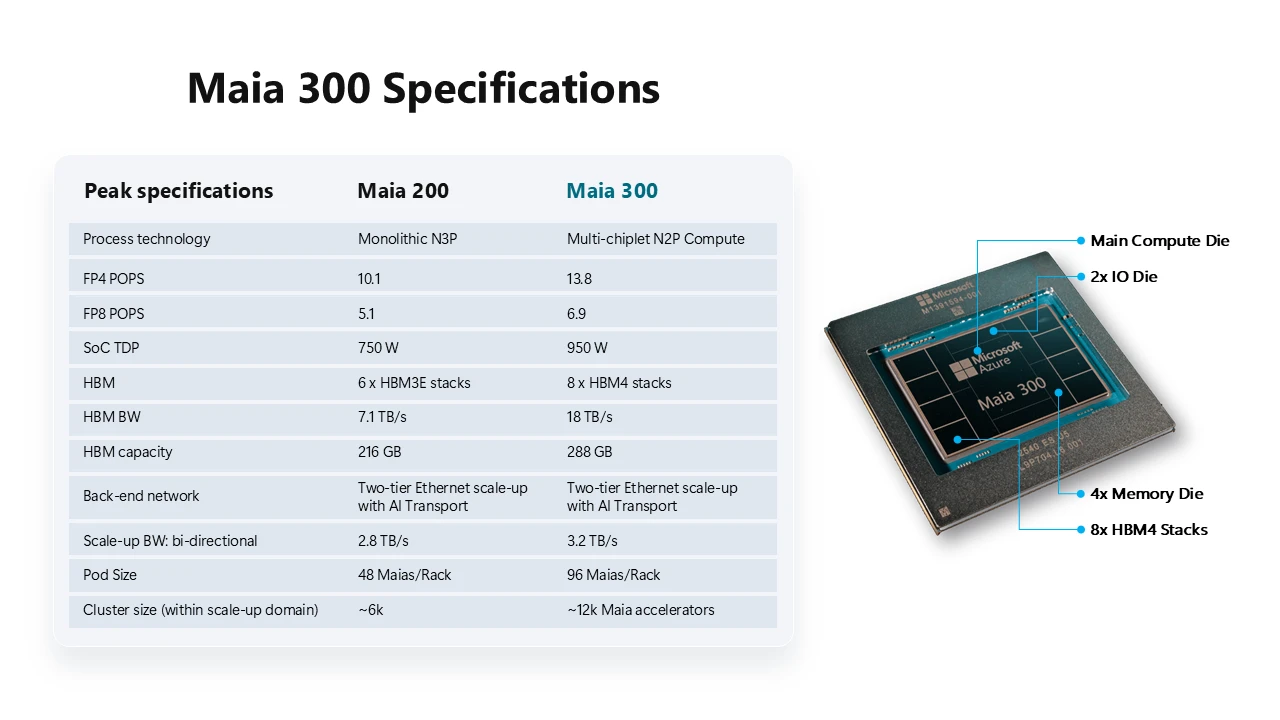 Thông số kỹ thuật Maia 300
Suy luận độ chính xác thấp được tối ưu: Hệ thống giới thiệu các định dạng MXFP4 cải tiến và lưu trữ dưới 3 bit. Biểu diễn hẹp hơn giúp giảm dấu chân bộ nhớ và di chuyển dữ liệu, cho phép hệ thống hỗ trợ mô hình lớn hơn, ngữ cảnh dài hơn và nhiều phiên đồng thời hơn trong cùng một giới hạn điện năng.
Tối ưu nhân suy luận qua nâng cấp ISA: Bộ máy vector bổ sung tối ưu cho các nhân suy luận then chốt như softmax, ép kiểu dữ liệu độ chính xác thấp và các phép toán khác.
Di chuyển dữ liệu trên die hiệu quả: Bộ nhớ chuyển từ tổ chức đồng nhất sang NUMA trên các chiplet. Mỗi vùng tính toán có bộ nhớ ở gần, và SDLA kiểm soát tường minh các bộ máy DMA, SRAM cục bộ, HBM cùng mạng trên chip để đặt dữ liệu sát nơi sử dụng. Dữ liệu đi quãng đường ngắn hơn, nhờ đó giảm năng lượng tiêu tốn cho việc di chuyển.
Hệ thống phân cấp bộ nhớ tối ưu băng thông trên watt: Kết hợp SRAM trên die do phần mềm quản lý với tám stack HBM4 cung cấp 288 GB dung lượng và 18 TB/s băng thông cho mỗi bộ tăng tốc. So với Maia 200, con số này mang lại băng thông bộ nhớ gấp 2,5 lần, dung lượng nhiều hơn 33% và băng thông HBM trên mỗi watt cao gấp khoảng 2 lần.
Một kết cấu scale-up duy nhất: từ pod đến superpod
Maia 300 biến mạng lưới thành phần mở rộng tự nhiên của kiến trúc dataflow định nghĩa bằng phần mềm. Bộ điều khiển mạng AI của Maia triển khai vận chuyển AI tùy chỉnh dựa trên Ethernet. Một mạng hai tầng xây dựng nên superpod hiệu năng cao với tối đa 12.288 bộ tăng tốc.
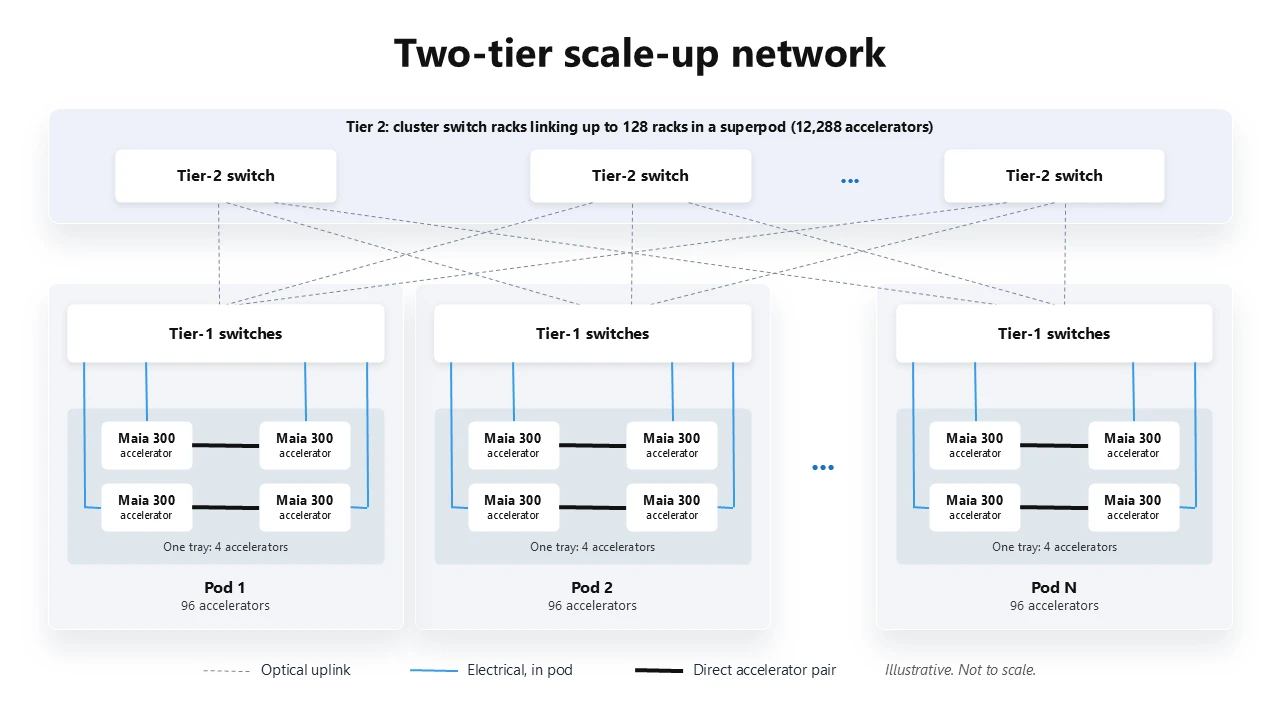 Mạng scale-up hai tầng
- Cấu trúc bán chuyển mạch trong rack: Mỗi bộ tăng tốc chia kết nối scale-up giữa liên kết trực tiếp và đường chuyển mạch. Liên kết trực tiếp nối hai bộ tăng tốc trong một khay, còn kết cấu chuyển mạch kết nối toàn bộ 96 bộ tăng tốc trong rack thành một pod. Mọi kết nối trong rack dùng liên kết điện để giảm điện năng và chi phí.
- Tầng quang học thứ hai xuyên rack: Các switch tầng hai kết nối tối đa 128 rack thành một superpod. Quang học cung cấp tầm với cần thiết để mở rộng mạng scale-up qua các pod.
- Một kết cấu thay vì hai miền riêng biệt: Bộ điều khiển mạng tích hợp và vận chuyển AI chuyên dụng dùng cùng ngữ nghĩa giao tiếp bên trong pod lẫn xuyên superpod. Bộ tăng tốc Maia có thể khởi tạo giao tiếp trực tiếp tới bất kỳ bộ tăng tốc nào trong superpod mà không cần đến máy chủ hay NIC scale-out rời.
- Đường giao tiếp ít chặng: Có ba miền độ trễ — cặp bộ tăng tốc nối trực tiếp là thấp nhất, bộ tăng tốc trong cùng pod cách một chặng switch, và bất kỳ bộ tăng tốc xuyên pod cách ba chặng switch.
- Băng thông phân bổ theo khối lượng công việc: Tỷ lệ băng thông trong rack và xuyên rack trên mỗi bộ tăng tốc không cố định lúc thiết kế mà là tham số đặt theo cách đóng gói công việc. Một bộ tăng tốc có thể truyền tới 750 GB/s tới bất kỳ đối tác nào trong superpod khi chỉ một phần nhỏ bộ tăng tốc đi xuyên rack.
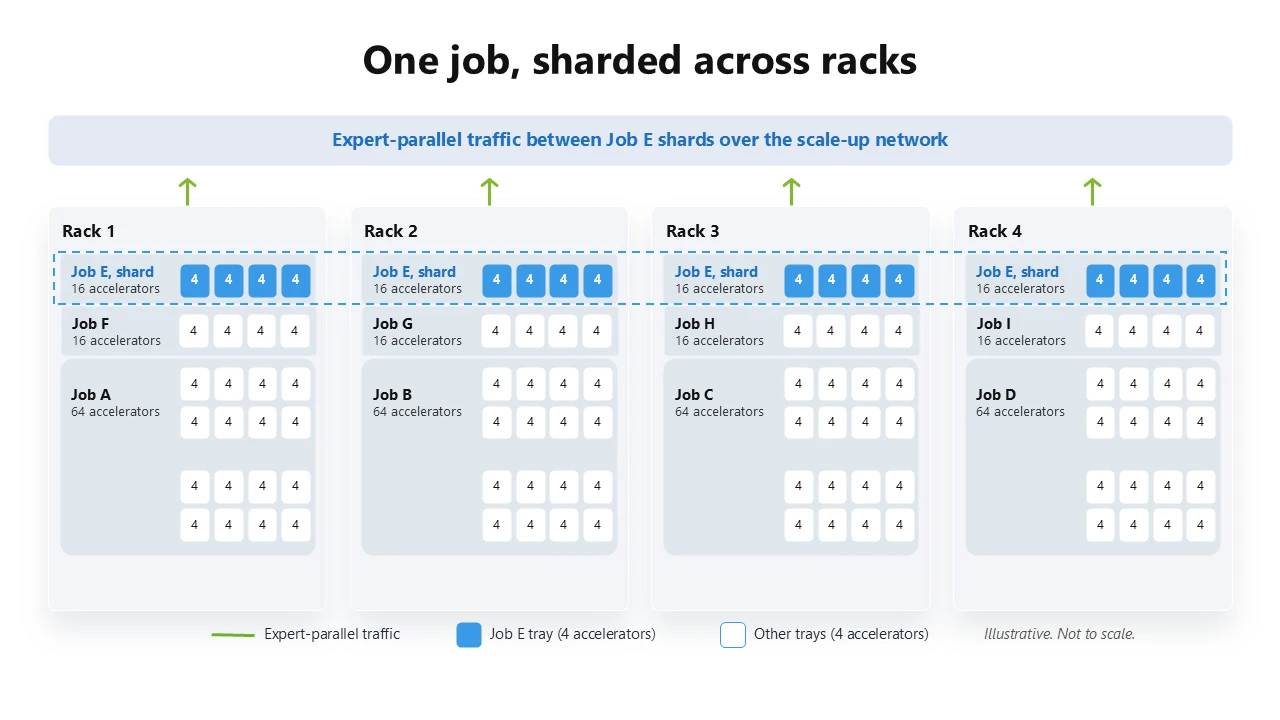
- Đặt công việc linh hoạt: Song song tensor có thể nằm gọn trong rack 96 bộ tăng tốc, trong khi song song chuyên gia và pipeline rộng hơn trải qua nhiều rack.
- Suy luận tách rời trong miền scale-up: Các worker prefill và decode có thể được định cỡ và đặt độc lập. Sau khi tính toán prefill xong, trạng thái KV di chuyển trực tiếp tới các worker decode đã chọn qua cùng kết cấu scale-up.
- Khả năng phục hồi xuyên rack: Khi bộ tăng tốc không khả dụng, bộ lập lịch có thể dùng năng lực dự phòng nóng ở rack khác trong superpod một cách trong suốt với nhân phần mềm.
Kiến trúc cấp rack cho hiệu quả triển khai
Ở quy mô trung tâm dữ liệu, hiệu quả được quyết định bởi lượng hạ tầng hữu ích có thể triển khai và vận hành trong giới hạn điện năng, làm mát cố định. Maia 300 đồng thiết kế bố trí và mật độ máy chủ, cấu trúc liệu và chuyển mạch mạng, thiết kế điện năng và làm mát, cùng đo lường từ xa tiên tiến để đạt hiệu năng trên mỗi watt cao gấp tới 2,5 lần so với Maia 200.
 Rack Maia 300
- 96 bộ tăng tốc trong 167 kW: Maia 300 tích hợp 96 bộ tăng tốc trên 24 khay, mỗi khay bốn bộ tăng tốc, trong một rack 167 kW — gấp đôi mật độ so với Maia 200. Mỗi khay gồm bốn bộ tăng tốc cùng bộ xử lý chủ, bộ nhớ, lưu trữ và làm mát.
- Kiến trúc chuyển mạch hợp nhất: Sáu ASIC switch bán kính cao tích hợp vào ba khay switch làm mát bằng chất lỏng, cung cấp kết nối cục bộ trong rack cho toàn bộ 96 bộ tăng tốc.
- Cấp điện cấp rack: Hai nguồn cấp điện, các giá đỡ nguồn công suất cao và kiến trúc busbar 50 V phân phối điện hiệu quả với dự phòng vận hành.
- Kiến trúc làm mát linh hoạt: Làm mát bằng chất lỏng loại bỏ hơn 80% tải nhiệt của rack từ bộ tăng tốc, bộ điều chỉnh điện áp và ASIC switch, trong khi làm mát bằng không khí hỗ trợ bộ nhớ, lưu trữ và linh kiện phụ trợ.
- Đo lường từ xa tích hợp trung tâm dữ liệu: Dữ liệu đo lường điện năng cấp rack và cấp hàng kết nối với vận hành trung tâm dữ liệu, cho phép quản lý điểm vận hành theo năng lực điện năng và làm mát sẵn có.
Maia 300 mang lại điều gì
Maia 300 là bước tiếp theo trong chương trình đa thế hệ nhằm triển khai hệ thống AI hiệu quả ở quy mô lớn. Thiết kế được tối ưu đầu-cuối xuyên suốt phần mềm, silicon, hạ tầng rack, mạng và trung tâm dữ liệu.
So với Maia 200, Maia 300 mang lại thông lượng token cấp rack cao gấp tới 7 lần ở cấu hình đầy đủ 96 bộ tăng tốc, cùng hiệu năng trên mỗi watt cao hơn 2,5 lần. Hệ thống cung cấp nhiều băng thông bộ nhớ trên mỗi watt hơn và gấp đôi số bộ tăng tốc mỗi rack, đồng thời kế thừa SDLA cùng mạng scale-up hai tầng để hỗ trợ một mô hình lập trình duy nhất trải từ nhân đến quy mô trung tâm dữ liệu.
Cơ hội phía trước không chỉ là xây thêm nhiều compute. Đó là làm cho các năng lực AI tiên tiến trở nên dễ tiếp cận, phải chăng và hữu ích hơn. Maia 300 là một bước quan trọng hướng tới mục tiêu đó.
Đối với người dùng và doanh nghiệp Việt Nam đang ngày càng phụ thuộc vào các dịch vụ AI đám mây như Microsoft Copilot hay GitHub Copilot, những cải tiến về hiệu quả điện năng và chi phí trên mỗi token từ các chip như Maia 300 có thể gián tiếp tác động tới giá thành và tốc độ của các dịch vụ AI trong tương lai gần.
Tháng tới, tại Microsoft Ignite 2026 ở San Francisco và trực tuyến, Microsoft dự kiến chia sẻ thêm về chiến lược AI, xu hướng ứng dụng công nghệ và những thành tựu trong chuyển đổi tiên phong.