Cerebras triển khai mô hình AI nghìn tỷ tham số trên chip wafer-scale
Cerebras vừa công bố cách họ triển khai các mô hình AI frontier nghìn tỷ tham số trên chip wafer-scale WSE-3T, chia mô hình lớn ra nhiều wafer và đạt tốc độ 1000-2000+ token/giây. Bài viết lấy mô hình mã nguồn mở Kimi K3 với ~3.000 tỷ tham số làm ví dụ minh họa cho kiến trúc pipeline độc đáo này.
Cerebras vừa chia sẻ chi tiết cách họ đưa các mô hình AI frontier (mô hình tiên tiến nhất) quy mô nghìn tỷ tham số lên chip wafer-scale WSE-3T. Đây là câu hỏi mà đội ngũ công ty nhận được nhiều nhất: làm sao một mô hình cần hàng terabyte chỉ riêng cho trọng số lại có thể chạy trên những con chip có dung lượng bộ nhớ on-chip khiêm tốn?
 Minh họa kiến trúc chip wafer-scale của Cerebras
Bài toán bộ nhớ và lời giải wafer-scale
Mỗi wafer WSE-3T của Cerebras chỉ có 44 GB bộ nhớ on-chip (SRAM), trong khi một mô hình nghìn tỷ tham số cần tới hàng terabyte cho trọng số. Thay vì tìm cách nén hay đẩy dữ liệu ra bộ nhớ ngoài, Cerebras chọn hướng chia mô hình ra nhiều wafer và nối chúng thành một pipeline hoàn chỉnh.
Mục tiêu của họ rất rõ ràng: chạy các mô hình đa nghìn tỷ tham số với tốc độ 1000-2000+ token mỗi giây, cao hơn nhiều so với các hệ thống GPU truyền thống. Điểm mấu chốt là mỗi wafer có đủ SRAM để chứa trọn vẹn một lớp của mô hình, nhờ đó trọng số gần như không bao giờ phải di chuyển.
Ví dụ cụ thể với Kimi K3
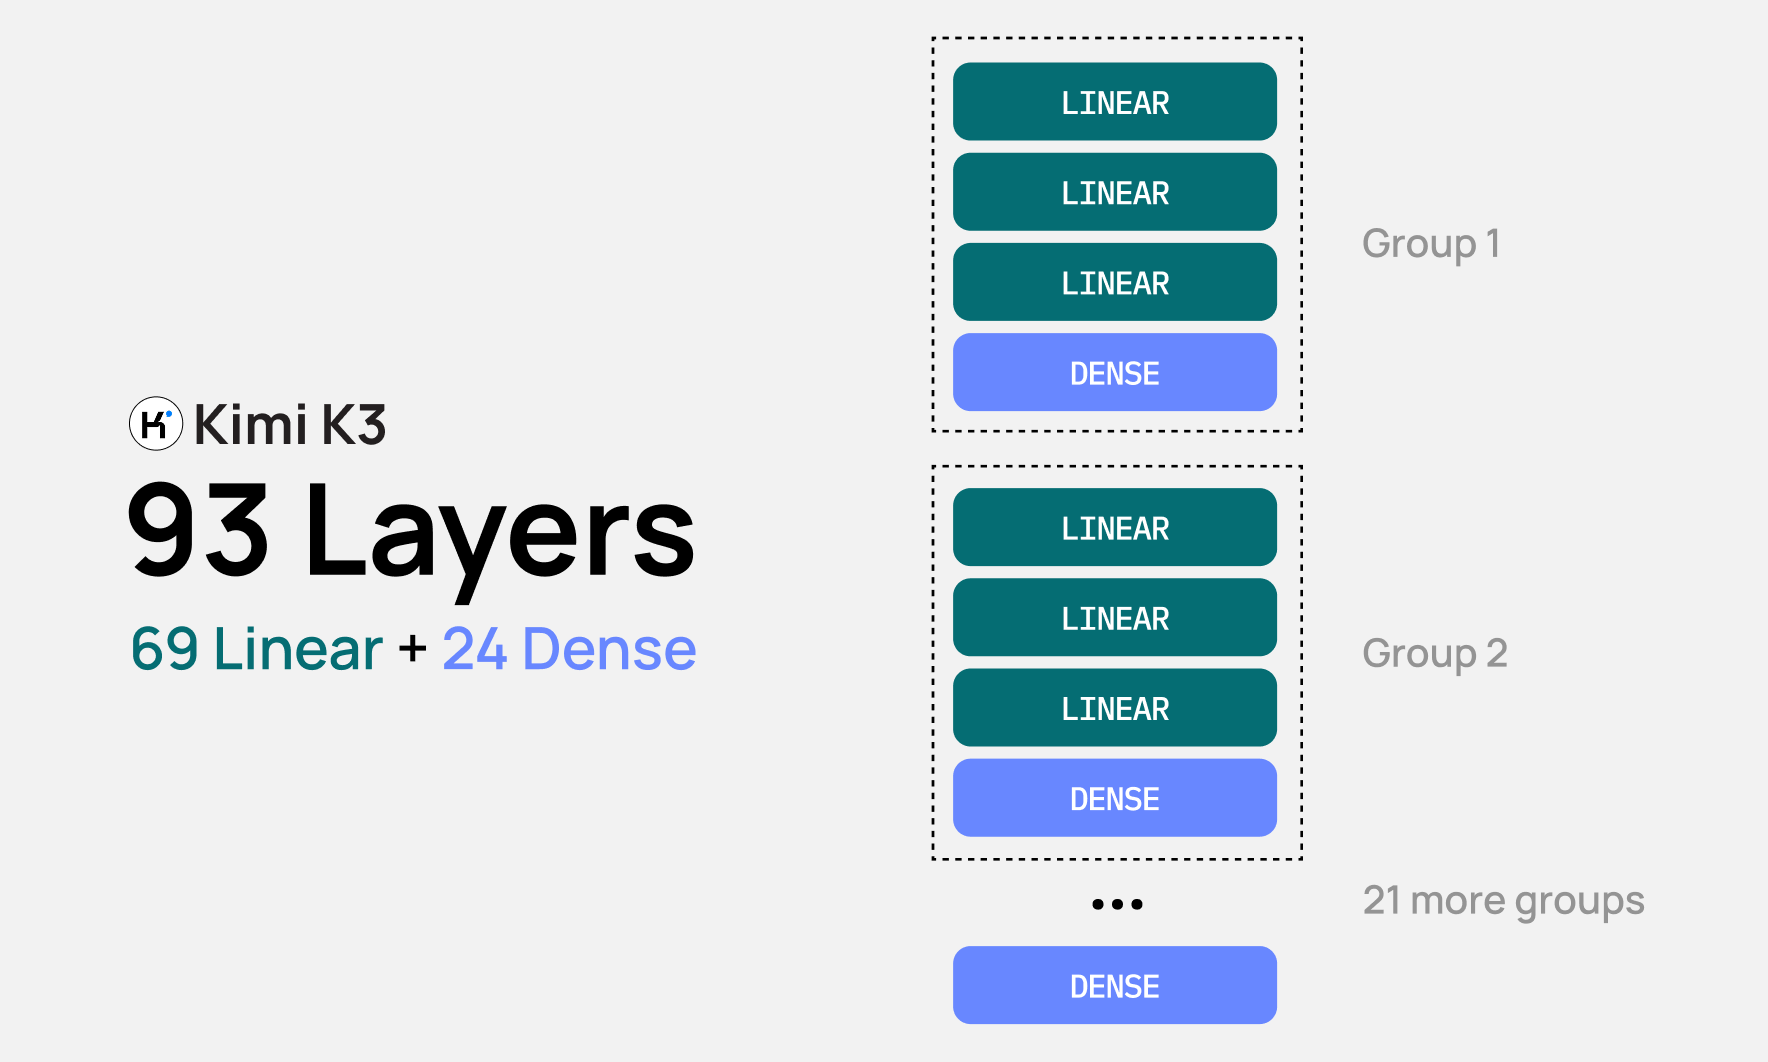
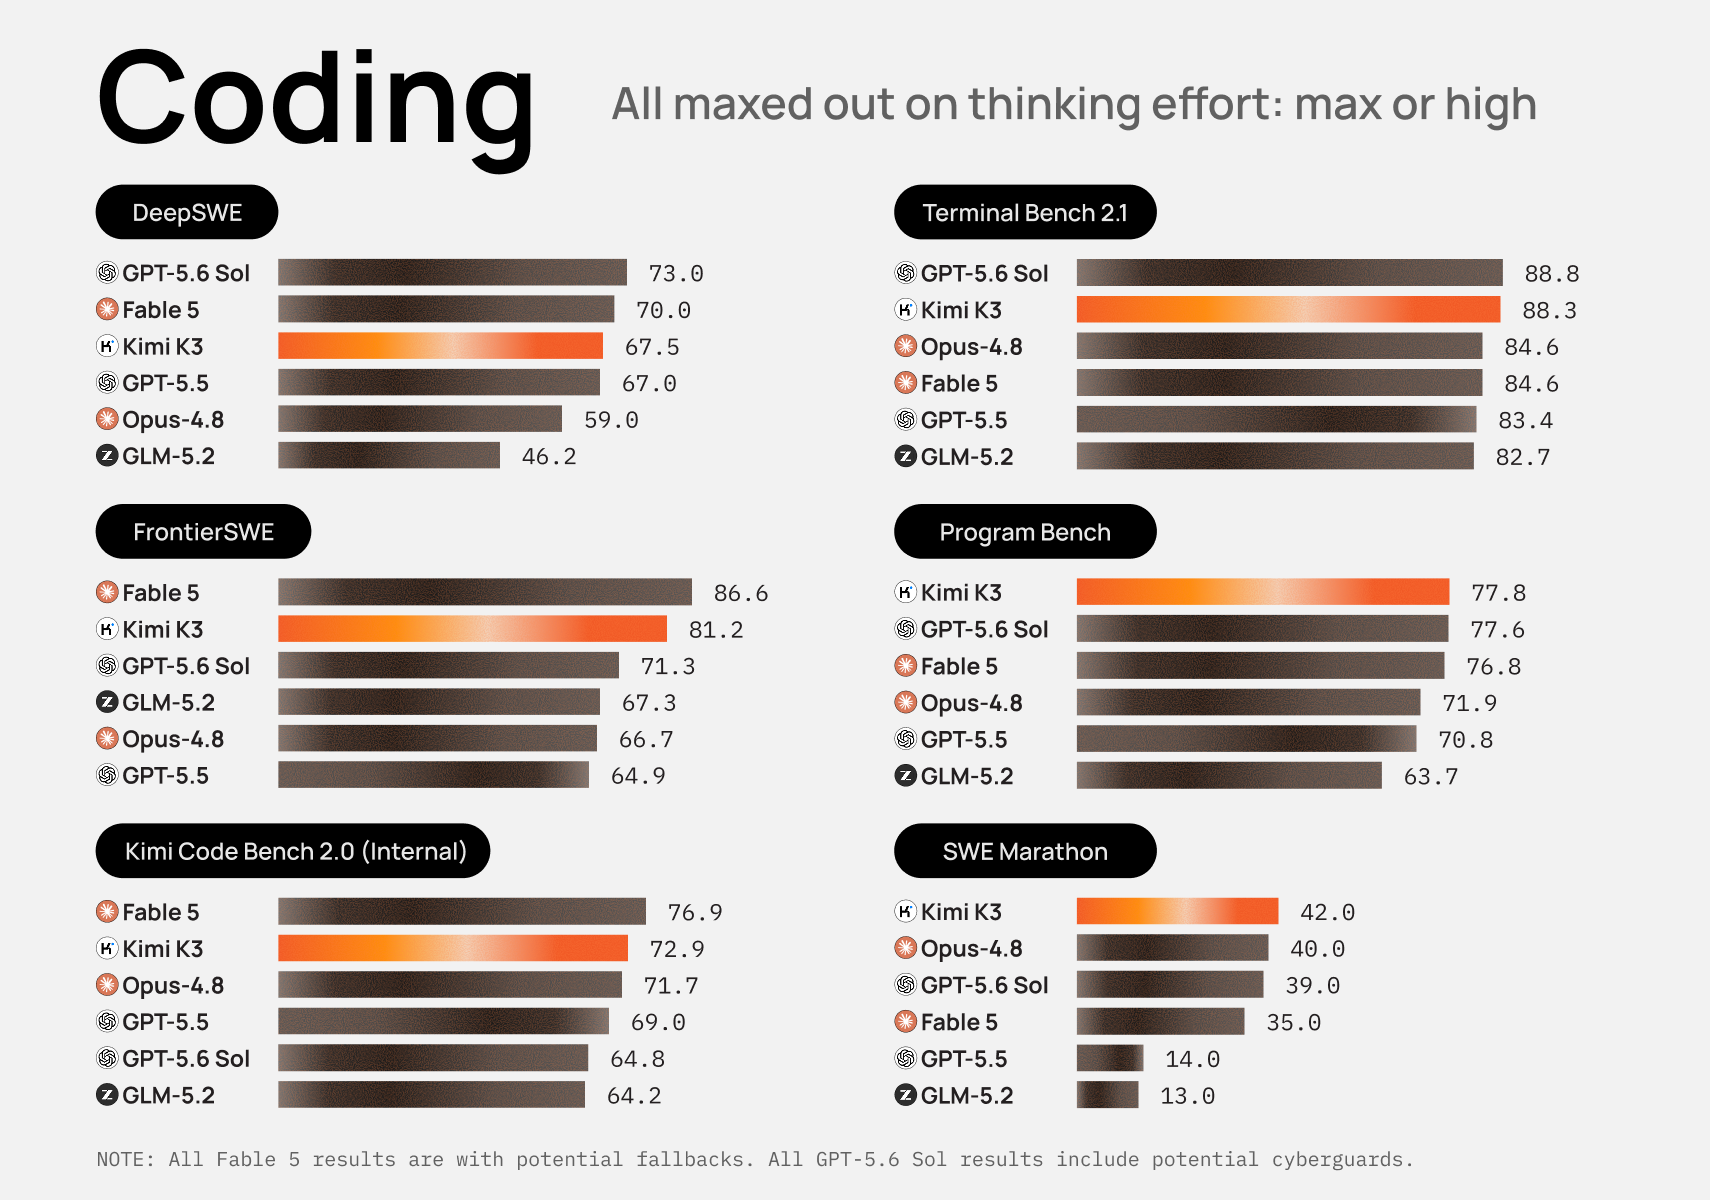
Để minh họa, Cerebras chọn Kimi K3 — mô hình mã nguồn mở khoảng 3.000 tỷ tham số, gồm 69 lớp linear-attention và 24 lớp dense. Mô hình này đạt 88,3% trên Terminal-Bench 2.1 và 91,2% trên BrowseComp, cho thấy năng lực lập trình và tác tử (agentic) ở mức frontier, thậm chí vượt một số mô hình độc quyền hàng đầu ở vài bài kiểm tra.
Cấu hình giả định gồm: kích thước yêu cầu trung bình 256k token, lượng tử hóa trọng số 4-bit và KV cache 8-bit.
Bước 1: Kích thước mỗi lớp
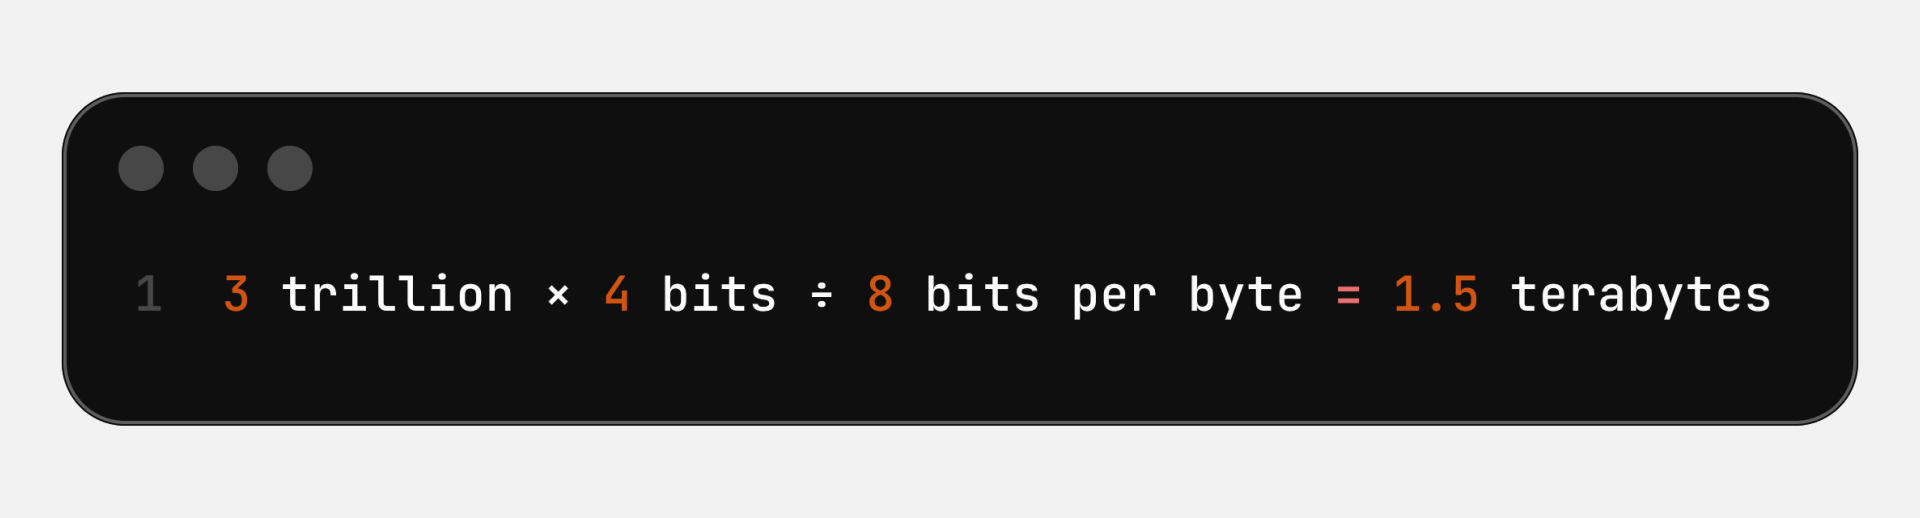
Với 3.000 tỷ tham số ở 4 bit, tổng dung lượng trọng số thô chia cho 93 lớp cho ra khoảng 16 GB mỗi lớp. Đây là con số then chốt định hình toàn bộ cách bố trí.
Bước 2: Số wafer cần dùng
Mỗi wafer 44 GB có thể chứa số lớp khác nhau tùy loại:
- Lớp dense cần thêm chỗ cho KV cache vì phải lưu key/value của mọi token trong mọi yêu cầu đang chạy. Do đó mỗi wafer chỉ chứa một lớp dense, phần SRAM còn lại dành cho cache.
- Lớp linear-attention không cần KV cache phình to, chỉ giữ một trạng thái nhỏ cố định cho mỗi yêu cầu. Vì vậy một wafer chứa được hai lớp linear (2 × 16 GB = 32 GB).
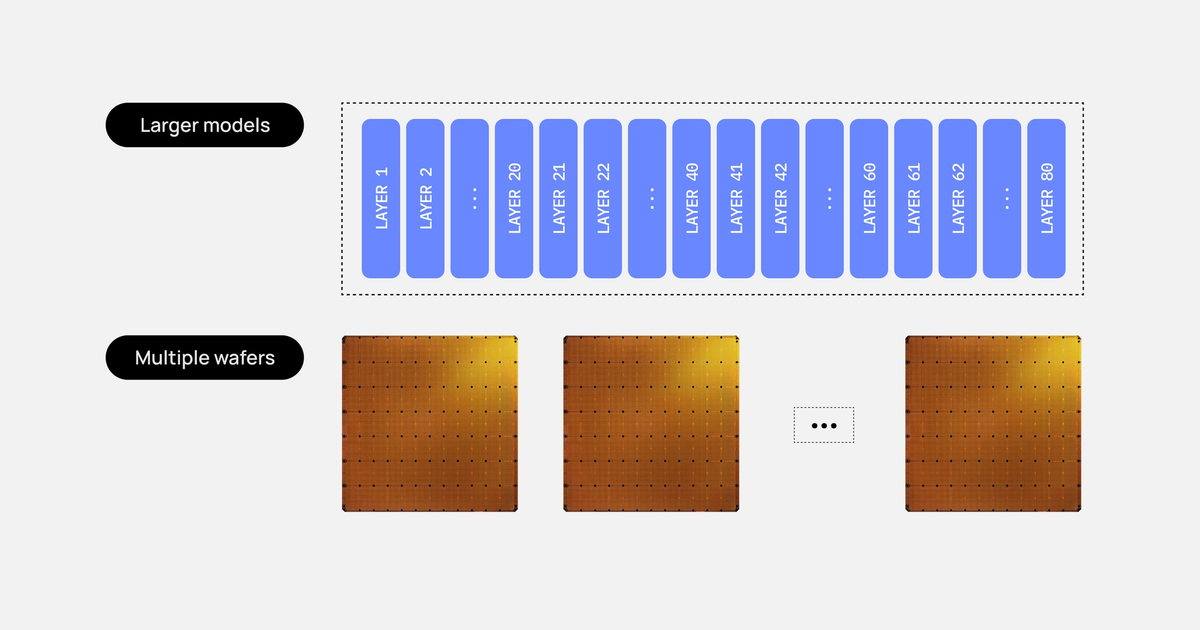
Kết quả: 69 lớp linear chia đôi thành 35 wafer, cộng 24 lớp dense thành 24 wafer, tổng cộng 59 wafer cho Kimi K3.
 Sơ đồ phân bổ lớp mô hình trên các wafer
Bước 3: Kết nối các wafer
Sau khi trình biên dịch của Cerebras ánh xạ các lớp lên các vùng wafer, runtime sẽ thiết lập đường đi cho token giữa các wafer. Để độ trễ cực thấp, chỉ activation được truyền giữa các wafer, thực hiện qua RDMA trên Ethernet với chi phí khoảng 2 microsecond mỗi hop.
Điểm quan trọng: vì mỗi lớp chỉ chiếm 16 GB trên wafer 44 GB, mô hình thường được đặt trọn lớp lên chip. Trọng số không phải di chuyển, các lớp cũng không bị chia nhỏ giữa các wafer — chỉ có activation di chuyển.
Phục vụ một yêu cầu và nhiều yêu cầu
Với mô hình đã bố trí xong, mỗi wafer giống như một trạm trên dây chuyền lắp ráp: trọng số đứng yên tại chỗ, còn kết quả trung gian của yêu cầu di chuyển qua từng trạm. Wafer 1 chạy lớp 1-2 rồi gửi activation sang wafer 2, wafer 2 chạy lớp 3-4 rồi chuyển tiếp, cứ thế cho đến wafer cuối tạo ra token tiếp theo.
Nhiều người lầm tưởng rằng nếu token phải đi tuần tự qua từng wafer thì mỗi wafer sẽ ngồi chờ, tương đương chạy batch size bằng 1. Cerebras khẳng định không phải vậy: toàn bộ pipeline luôn được lấp đầy bởi các yêu cầu khác nhau. Trong khi trạm 3 xử lý token cho yêu cầu A, trạm 2 xử lý cho yêu cầu B, trạm 1 xử lý cho yêu cầu C.
Mỗi trạm còn xử lý một micro-batch — nhóm nhỏ yêu cầu — thay vì một yêu cầu đơn lẻ. Số yêu cầu đang chạy xấp xỉ bằng số trạm nhân với kích thước micro-batch. Micro-batch nhỏ giúp từng yêu cầu nhanh hơn, còn micro-batch lớn tăng tổng thông lượng.
 Mô hình pipeline xử lý nhiều yêu cầu đồng thời
Giới hạn số yêu cầu đồng thời
Dung lượng SRAM dành cho KV cache chính là yếu tố quyết định số yêu cầu chạy song song tối đa, vì mỗi yêu cầu cần KV cache riêng trên từng wafer lớp dense. Với wafer 44 GB đã chứa một lớp dense 16 GB, phần còn lại khoảng 28 GB dành cho cache.
Từ đó, Cerebras tính được một yêu cầu 256k token chiếm bao nhiêu cache và chia phần dung lượng còn lại để ra số yêu cầu đồng thời. Điểm khác biệt so với batch trên GPU: các yêu cầu này không chờ nhau hoàn thành mà chảy liên tục qua pipeline.
Theo Cerebras, cả mức đồng thời lẫn batch size đều không phản ánh chính xác hiệu quả của một hệ thống suy luận. Thước đo có ý nghĩa hơn là tổng thông lượng token trên mỗi đơn vị năng lượng (token/giây/megawatt), đo ở cùng tốc độ sinh đầu ra.
Mở rộng cho mô hình lớn hơn 3.000 tỷ tham số
Cách tiếp cận này áp dụng được cho cả các mô hình lớn hơn: tính bộ nhớ cần cho trọng số và trạng thái yêu cầu, phân bổ mô hình lên các wafer rồi nối thành pipeline. Mỗi wafer thêm vào đóng góp cả năng lực tính toán lẫn bộ nhớ on-chip, cho phép xử lý những mô hình vượt xa khả năng của bất kỳ con chip đơn lẻ nào.
Với người quan tâm đến hạ tầng AI tại Việt Nam, hướng tiếp cận wafer-scale cho thấy một lựa chọn thay thế đáng chú ý bên cạnh các cụm GPU — đặc biệt khi nhu cầu chạy mô hình mã nguồn mở quy mô lớn ngày càng tăng mà chi phí năng lượng lại là bài toán nóng. Cerebras hiện cho phép truy cập miễn phí qua API cloud.cerebras.ai để cộng đồng thử nghiệm.