
Binning hay chọn lọc đặc trưng: Đâu mới là yếu tố giúp chúng tôi vô địch hackathon bảo hiểm?
Một năm sau khi giành quán quân tại hackathon bảo hiểm của Crédit Agricole Assurances, nhóm tác giả kiểm toán lại kết quả và phát hiện điều bất ngờ: binning có giúp ích thật, nhưng thứ tạo ra khác biệt không phải bản thân thư viện mà là bước chọn lọc đặc trưng đi kèm. Yếu tố duy nhất thắng áp đảo là tốc độ: thời gian binning giảm từ 126 phút xuống còn 4,3 phút.
Binning hay chọn lọc đặc trưng: Đâu mới là yếu tố giúp chúng tôi vô địch hackathon bảo hiểm?
Năm 2025, nhóm của chúng tôi giành vị trí thứ nhất tại hackathon của Crédit Agricole Assurances Data Science Academy, với hơn 500 người tham gia. Một năm sau, chúng tôi chạy lại toàn bộ quy trình để kiểm chứng niềm tin cốt lõi đằng sau chiến thắng — và kết quả đã đảo ngược chính niềm tin đó. Binning có thực sự giúp ích, nhưng không phải theo cách chúng tôi từng nghĩ.
 Minh họa quy trình phân tích dữ liệu bảo hiểm
Bối cảnh: bài toán định giá bảo hiểm cháy cho nông trại
Thử thách AssurPrime (ENS Challenge Data #161) yêu cầu người tham gia dự đoán chi phí bồi thường cháy của các hợp đồng bảo hiểm nông nghiệp từ dữ liệu đã được ẩn danh. Đây là dữ liệu các nông trại Pháp, được Pacifica — công ty bảo hiểm tài sản của Crédit Agricole Assurances — bảo hiểm rủi ro hỏa hoạn.
Bài toán khó ở hai điểm. Thứ nhất, khiếu nại rất hiếm gặp: gần như mọi hợp đồng đều có số vụ khiếu nại bằng không, nên một mô hình dự đoán toàn số 0 trông có vẻ chính xác nhưng hoàn toàn vô dụng. Thứ hai, mục tiêu cần dự đoán có hai thành phần hành xử rất khác nhau:
E[chi phí] = E[số vụ khiếu nại] × E[số tiền mỗi vụ]
Đây chính là cách các chuyên gia tính toán bảo hiểm (actuary) vẫn làm suốt nhiều thập kỷ: tách thành tần suất (frequency) và mức độ nghiêm trọng (severity). Tần suất là một số đếm nhỏ, còn mức độ là một khoản tiền có đuôi phân phối nặng. Dùng chung một mô hình cho cả hai sẽ làm mờ cả hai mục tiêu — vì vậy nhóm đã xây dựng hai mô hình riêng.
Công thức chiến thắng năm 2025
Giải pháp của nhóm không dùng mô hình khổng lồ hay tổ hợp các tổ hợp. Nó dựa trên ba quyết định: tách bài toán thành tần suất × mức độ, bin mọi đặc trưng theo mục tiêu bằng thư viện mã nguồn mở AutoCarver, và gán trọng số cho tín hiệu hiếm.
Với binning có giám sát, mỗi đặc trưng được gom lại thành các nhóm có ý nghĩa thống kê mạnh nhất với mục tiêu, đồng thời phải thỏa ba ràng buộc: tần suất tối thiểu mỗi nhóm, số nhóm tối đa, và kiểm chứng trên tập dev độc lập. Ràng buộc cuối cùng là quan trọng nhất — một cách gom nhóm chỉ hiệu quả trên dữ liệu huấn luyện sẽ bị loại bỏ.
 Biểu đồ so sánh kết quả giữa các phương pháp
Phát hiện gây bất ngờ: thứ tạo ra khác biệt không phải binning
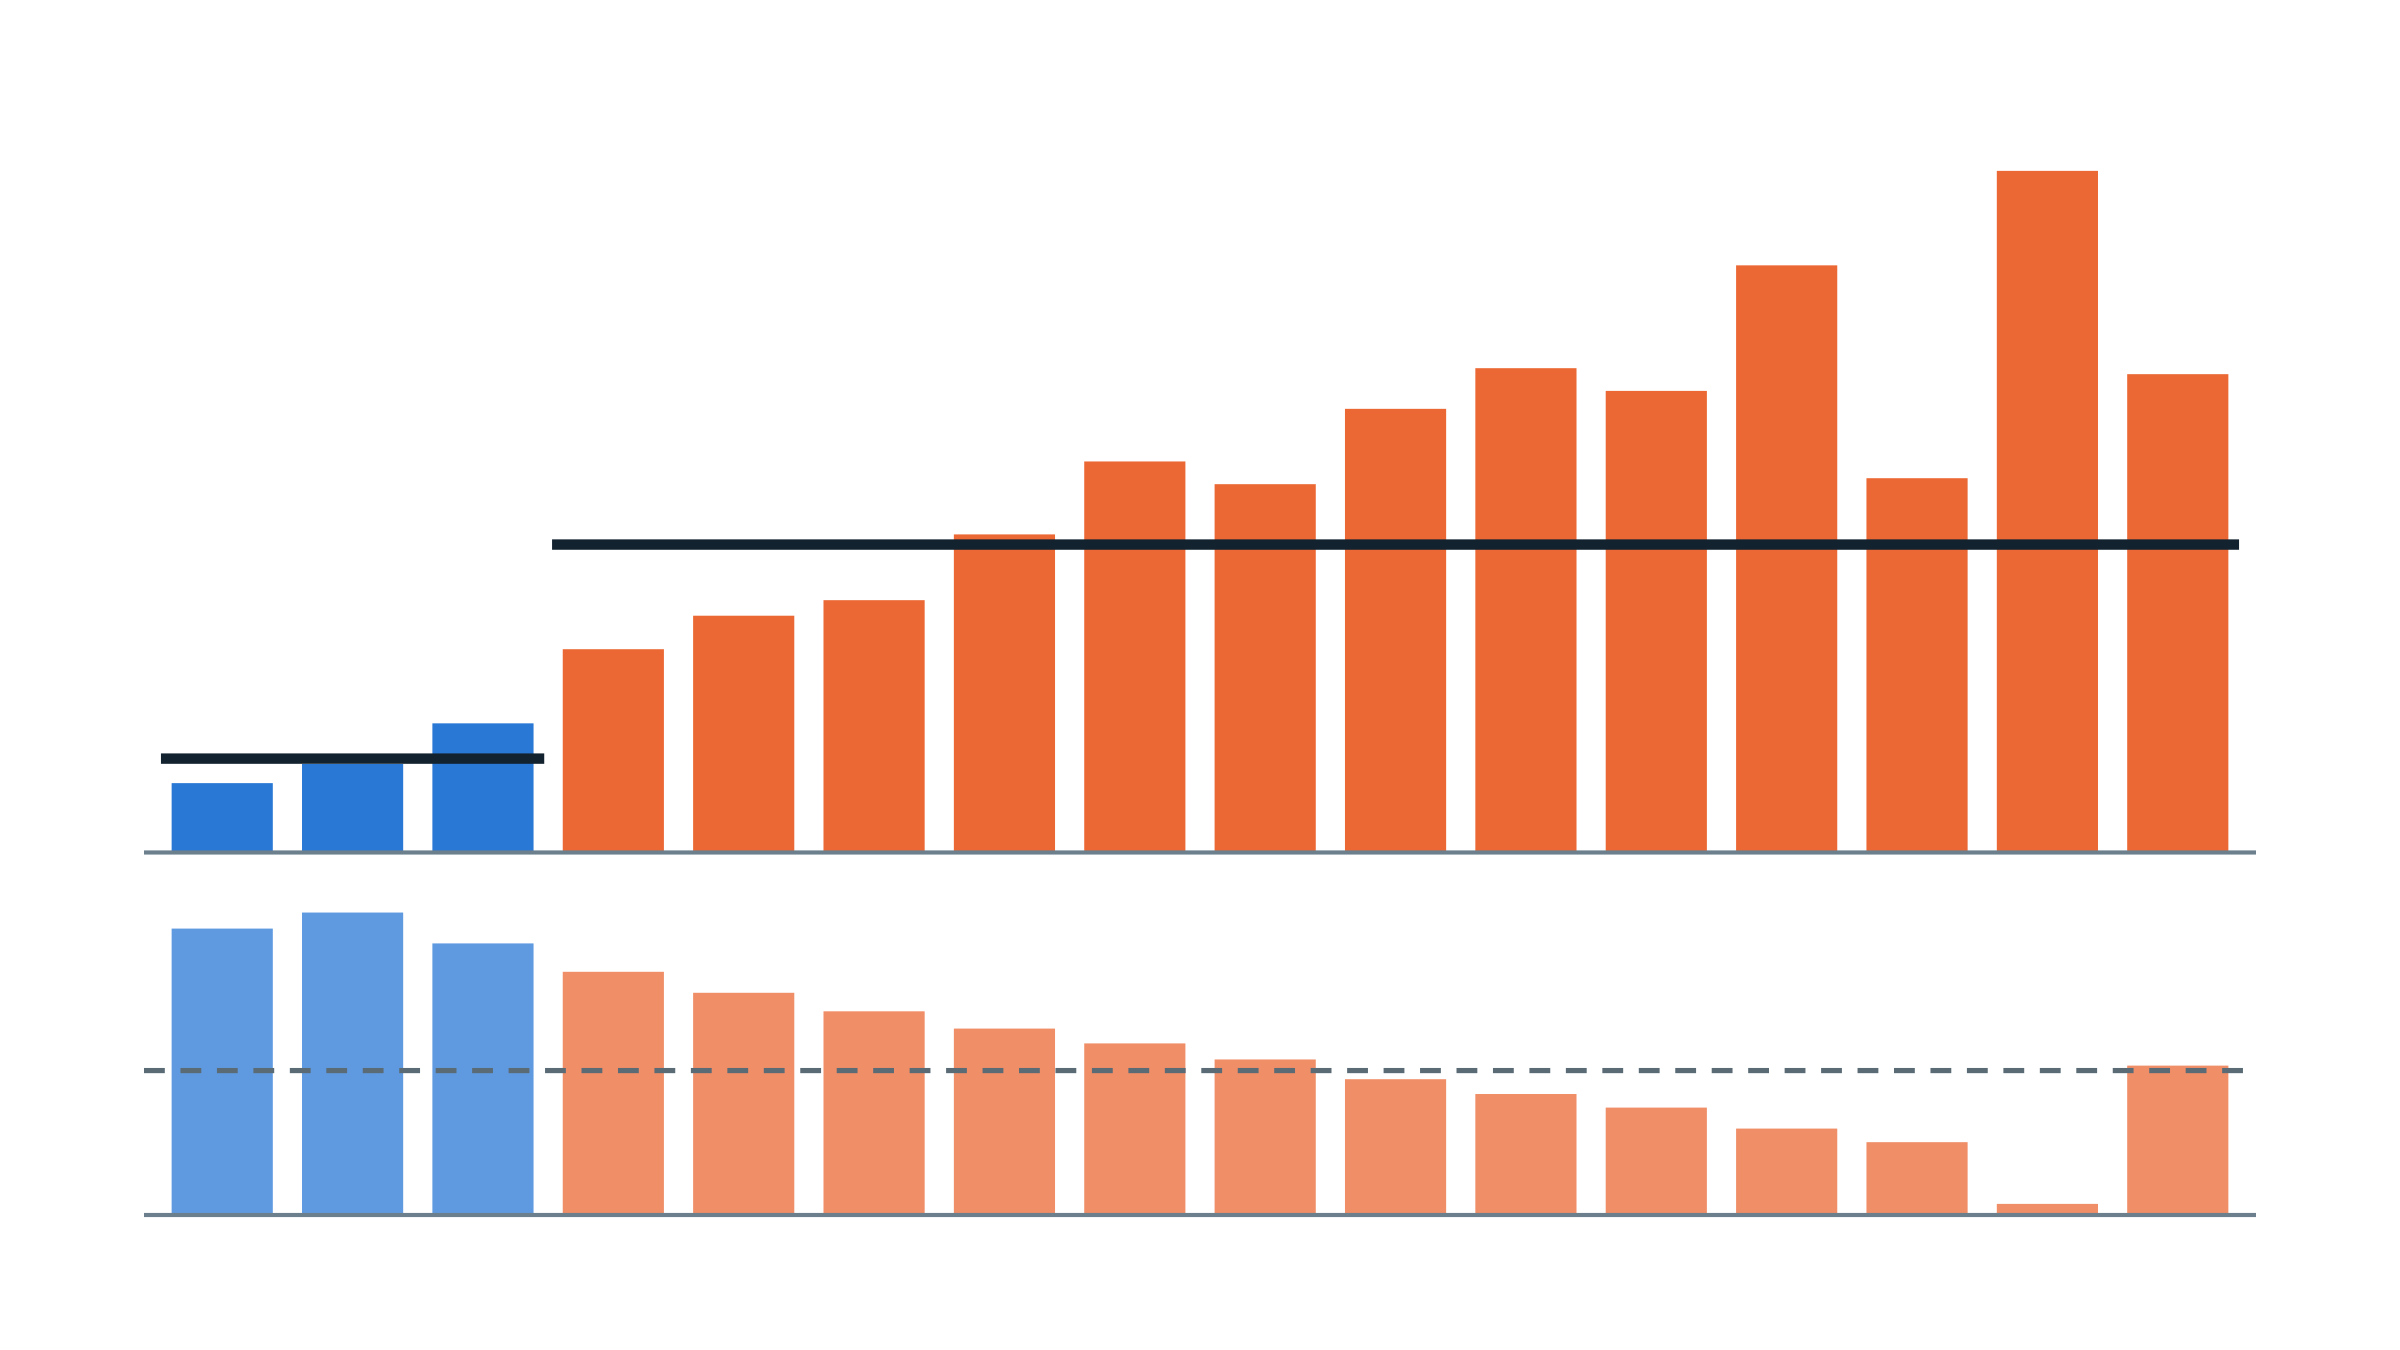
Nhóm đã chạy lại quy trình với bốn hạt giống (seed) cho mỗi nhánh thí nghiệm và giữ nguyên một tập đặc trưng chung, nhằm tách biệt hai bước mà trước đây vẫn luôn chạy cùng nhau. Kết quả gồm hai phần.
Thứ nhất, binning thực sự xứng đáng. Cả hai thư viện binning đều vượt nhánh không binning với biên độ bằng 1,59 lần độ tản của seed, không có vùng chồng lấp, và thắng trên cả bốn seed riêng lẻ. Niềm tin suốt một năm qua, hóa ra, là đúng.
Thứ hai, hai thư viện binning không thể phân biệt được. Trên cùng một tập đặc trưng, khoảng cách giữa chúng chỉ là 0,0063 log loss — bằng 0,45 lần độ tản tổng hợp, với các dải giá trị chồng lên nhau. Khi cân bằng bước chọn lọc, chiến thắng tưởng chừng 3,50 lần của pipeline gần như biến mất và thậm chí đảo dấu.
Thứ tách biệt hai thư viện ở đây không phải cách chúng cắt đặc trưng, mà là tập đặc trưng mà bộ chọn lọc của chúng giữ lại.
Tốc độ: chiến thắng duy nhất không phải chuyện sít sao
Điểm khác biệt thực sự rõ ràng nằm ở hiệu năng. Binning 680 MB dữ liệu huấn luyện từng là bước chậm nhất trong vòng lặp năm 2025.
- Với tần suất (đặc trưng định tính): từ 2842 giây xuống còn 120 giây — nhanh hơn 23,7 lần
- Với mức độ nghiêm trọng: từ 4725 giây xuống còn 140 giây — nhanh hơn 33,8 lần
- Tổng thời gian carving: từ 126 phút xuống còn 4,3 phút
Phần lớn mức tăng này đến từ xử lý đa tiến trình (6 luồng thay vì 1) và thuật toán tìm kiếm top-k quy hoạch động thay cho liệt kê vét cạn. Khác với các kết quả về độ chính xác, đây không phải phép so sánh sít sao: cùng một lần carving chạy lại cho kết quả 120,0; 126,8 và 129,4 giây — độ tản 7,8%, cách rất xa khoảng cách 24 lần.
Bài học về số liệu mức độ nghiêm trọng
Với mục tiêu mức độ nghiêm trọng, chỉ số RMSE trên tập dev không thể phân biệt bất kỳ nhánh nào với việc dự đoán bằng giá trị trung bình. Một mô hình dự đoán hằng số đạt 6617,6 — chỉ cách 47 đơn vị so với mọi mô hình khác.
Tệ hơn, RMSE còn khuyến khích overfitting: một mô hình không binning đạt RMSE huấn luyện thấp hơn ba lần so với RMSE dev (1994 so với 6530), tức là học thuộc dữ liệu, mà vẫn có RMSE dev tốt nhất trong nhánh của nó.
Chỉ số top-decile lift mới nhìn ra khác biệt thật. Binning đóng vai trò như một bộ điều chuẩn (regulariser): không có binning, bộ tìm kiếm chọn độ sâu cây 2 trên ba seed và độ sâu 9 trên seed thứ tư; có binning, cây dừng ở độ sâu 1 trên bảy trong tám seed.
 Minh họa cấu trúc dữ liệu và mô hình
Năm bài học rút ra
- Tách bài toán: mỗi nửa nhận một mô hình phù hợp với mục tiêu của nó.
- Bin đặc trưng, nhưng kiểm tra xem bước nào thực sự mang lại giá trị: khoảng cách giữa các pipeline lớn gấp bảy lần khoảng cách giữa các thư viện binning.
- Kiểm tra xem chỉ số có nhìn ra khác biệt không: RMSE dev đã thất bại, còn top-decile lift thì thành công.
- So sánh với baseline đơn giản nhất trước tiên: suốt một năm, RMSE dev 6613,8 trông như mô hình đang hoạt động tốt, trong khi trung bình huấn luyện đạt 6617,6.
- Đo độ tản của seed trước khi đọc một biên độ: bốn lần chạy bổ sung đã biến hai chiến thắng tưởng chừng thành kết quả hòa.
Góc nhìn cho cộng đồng AI Việt Nam
Câu chuyện này mang thông điệp thiết thực cho các nhóm làm khoa học dữ liệu, đặc biệt trong lĩnh vực fintech và bảo hiểm (insurtech) đang phát triển mạnh tại Việt Nam. Khi tham gia các cuộc thi hoặc xây dựng mô hình thực tế, việc tách bạch rõ ràng đóng góp của từng bước trong pipeline — thay vì gộp chung rồi quy công cho bước phức tạp nhất — là điều quyết định để rút ra bài học đúng.
Toàn bộ mã nguồn, notebook và dữ liệu của nhóm đều được công khai theo giấy phép MIT, cho phép bất kỳ ai cũng có thể chạy lại và kiểm chứng từng con số.
Bài viết liên quan

Công nghệ
Geist Serif: Vercel bổ sung font chữ serif mang hơi hướng tạp chí cho bộ nhận diện Geist
30 tháng 10, 2026

Công nghệ
AlpineBSD ra mắt: Hệ điều hành mã nguồn mở nói không với AI
30 tháng 10, 2026

Công nghệ
Anthropic âm thầm chặn Claude Code tái tạo game có sẵn: Cú đánh vào cộng đồng modding?
30 tháng 10, 2026