Bỏ phiếu chọn đặc trưng trong học liên bang: chọn lọc đặc trưng mà không chia sẻ dữ liệu
Các bệnh viện, ngân hàng và thiết bị biên có thể cùng thống nhất đặc trưng nào quan trọng bằng cách chia sẻ phiếu bầu thay vì chia sẻ dữ liệu thô. Phương pháp Feature Election cho phép mỗi nơi giữ bộ chọn đặc trưng riêng, gửi lá phiếu về máy chủ và chạy được trên cả NVIDIA FLARE lẫn Flower.
Bỏ phiếu chọn đặc trưng trong học liên bang: chọn lọc đặc trưng mà không chia sẻ dữ liệu
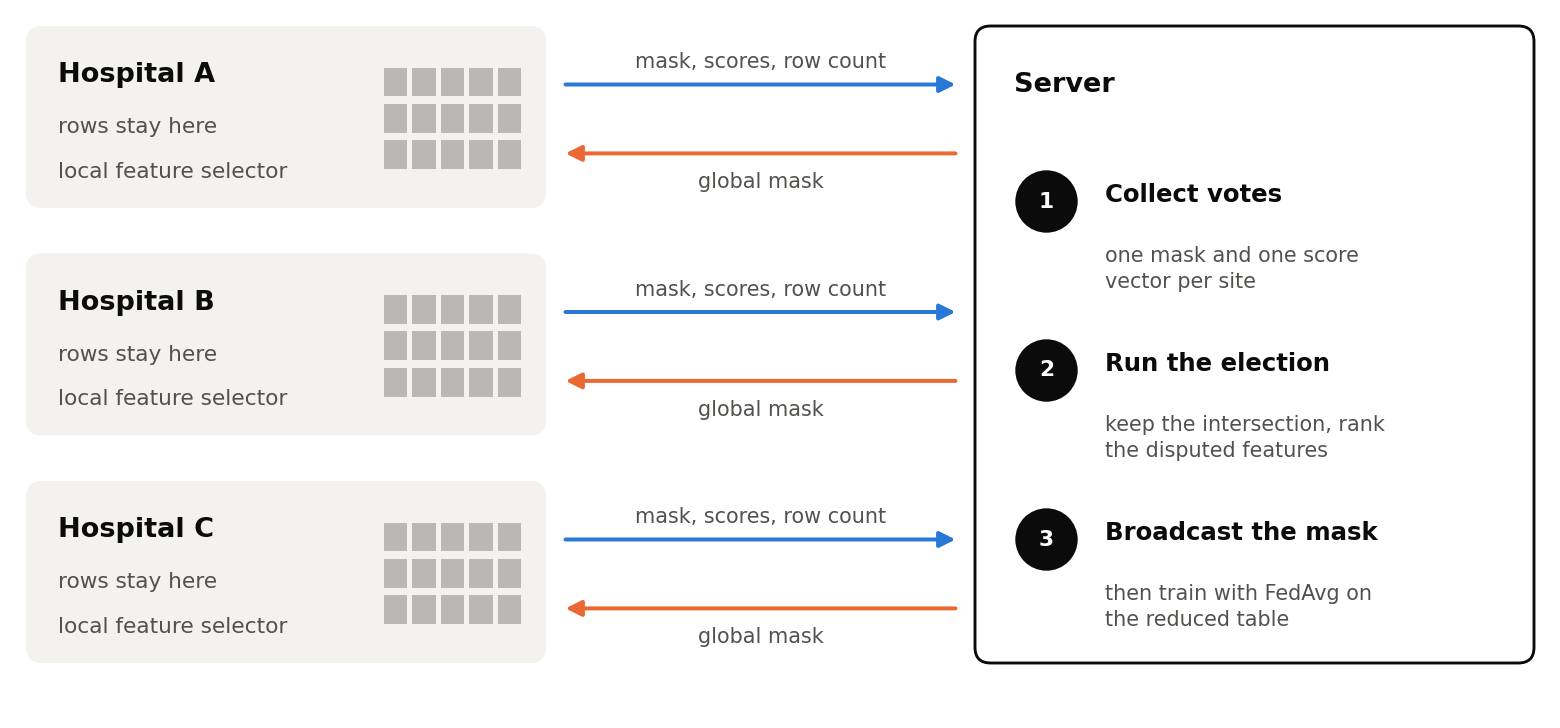
Hãy hình dung ba bệnh viện muốn cùng huấn luyện một mô hình. Bảng dữ liệu của họ có cùng cấu trúc cột, nhưng mỗi nơi nắm giữ bệnh nhân khác nhau và không nơi nào được phép gửi dữ liệu thô cho nơi khác. Đây chính là bài toán học liên bang theo chiều ngang (horizontal federated learning): các đặc trưng được chia sẻ, các hàng dữ liệu nằm rải rác ở nhiều điểm, và mô hình được huấn luyện ngay tại nơi dữ liệu tồn tại. Công thức chuẩn cho bài toán này là FedAvg, trong đó mỗi điểm tự huấn luyện cục bộ, gửi trọng số về máy chủ, và máy chủ lấy trung bình có trọng số theo số lượng mẫu của từng điểm.
 Minh họa quy trình học liên bang phân tán dữ liệu
Trên một bảng dữ liệu gộp chung, việc chọn lọc đặc trưng là chuyện thường ngày. Ta chỉ cần chạy Lasso, kiểm tra độ quan trọng của rừng ngẫu nhiên (random forest) hoặc gọi SelectKBest, rồi loại bỏ những cột không cần thiết. Nhưng trong học liên bang thì không có bảng gộp nào để chạy những công cụ đó, và FedAvg cũng chưa bao giờ hỏi đặc trưng nào nên nằm trong mô hình. Nó chỉ lấy trung bình bất kỳ trọng số nào nhận được, khiến mọi đặc trưng vô nghĩa vẫn theo chân mỗi vòng cập nhật và tạo ra nhiễu — thứ mà các điểm có ít dữ liệu cảm nhận rõ nhất.
Bài viết này giới thiệu Feature Election, một phương pháp được phát triển để lấp khoảng trống đó. Thay vì buộc phải chuyển sang một thuật toán chuyên dụng mới, Feature Election yêu cầu rất ít: mỗi điểm giữ nguyên bộ chọn đặc trưng quen thuộc, chạy nó trên dữ liệu của mình rồi gửi một lá phiếu, còn máy chủ phân xử bất đồng bằng đúng một tham số có thể điều chỉnh.
Ý tưởng cốt lõi
Mỗi điểm chạy một bộ chọn đặc trưng tùy ý trên dữ liệu cục bộ. Với mỗi đặc trưng, nó tạo ra một quyết định "có" hoặc "không" (hợp thành mặt nạ) và một con số thể hiện mức độ ưu tiên đặc trưng đó (điểm số), rồi gửi cả hai về máy chủ kèm số lượng mẫu của mình.
- Những đặc trưng mà mọi điểm đều chọn sẽ được giữ lại.
- Những đặc trưng mà không điểm nào chọn sẽ bị loại bỏ, bất kể điểm số ra sao.
- Những đặc trưng tranh chấp sẽ được đưa ra bỏ phiếu có trọng số theo quy mô của từng điểm, và một tham số duy nhất gọi là độ tự do (freedom degree) quyết định bao nhiêu trong số đó được nhận vào.
Sau đó mỗi điểm áp dụng mặt nạ toàn cục lên các cột của mình, và quá trình huấn luyện liên bang thông thường như FedAvg sẽ chạy trên bảng dữ liệu đã thu gọn. Không có hàng dữ liệu hay gradient nào rời khỏi điểm dữ liệu trong suốt quá trình bầu chọn.
Cơ chế bầu chọn diễn ra như thế nào
Với một bảng có d đặc trưng, mỗi khách hàng i gửi lên ba thứ:
- M_i: một mặt nạ nhị phân độ dài d, trong đó giá trị 1 nghĩa là "bộ chọn của tôi giữ đặc trưng này".
- S_i: một vector gồm d điểm số ưu tiên (ví dụ hệ số Lasso tuyệt đối, độ quan trọng của rừng ngẫu nhiên, hay giá trị thông tin tương hỗ).
- n_i: số lượng mẫu huấn luyện của nó.
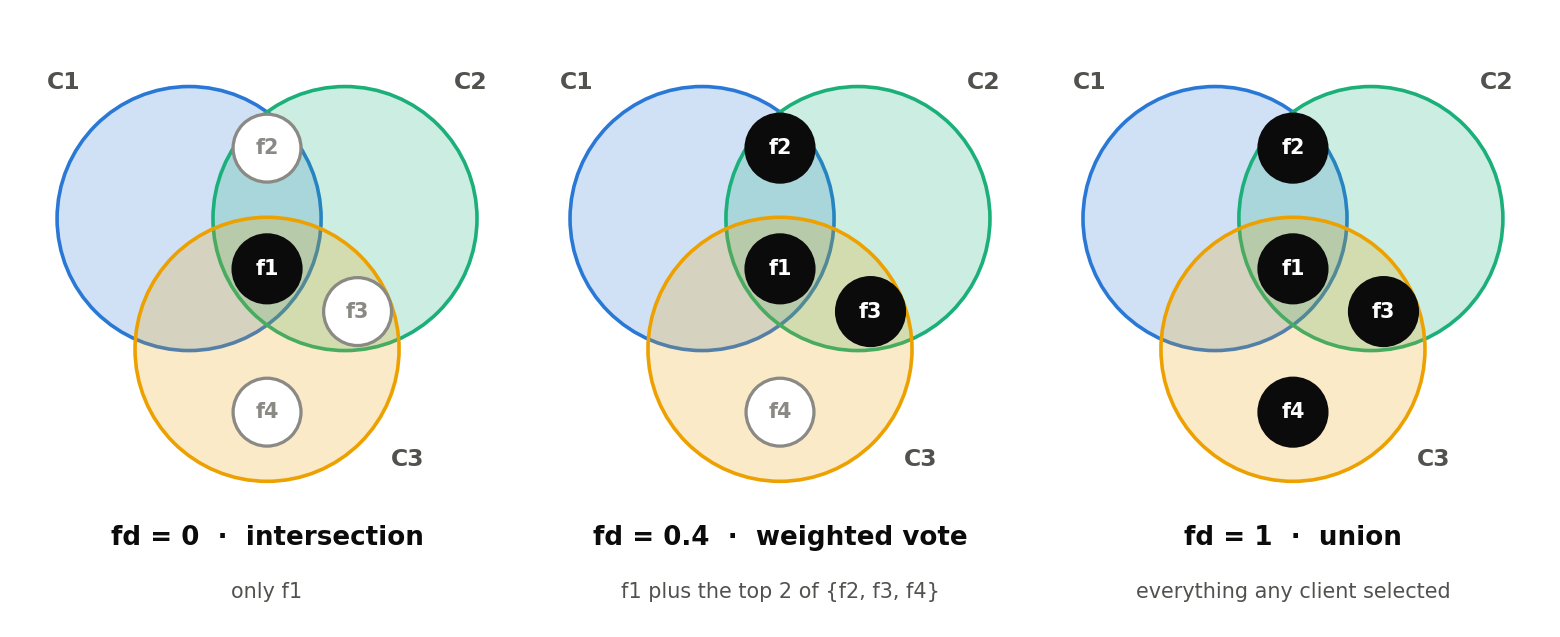
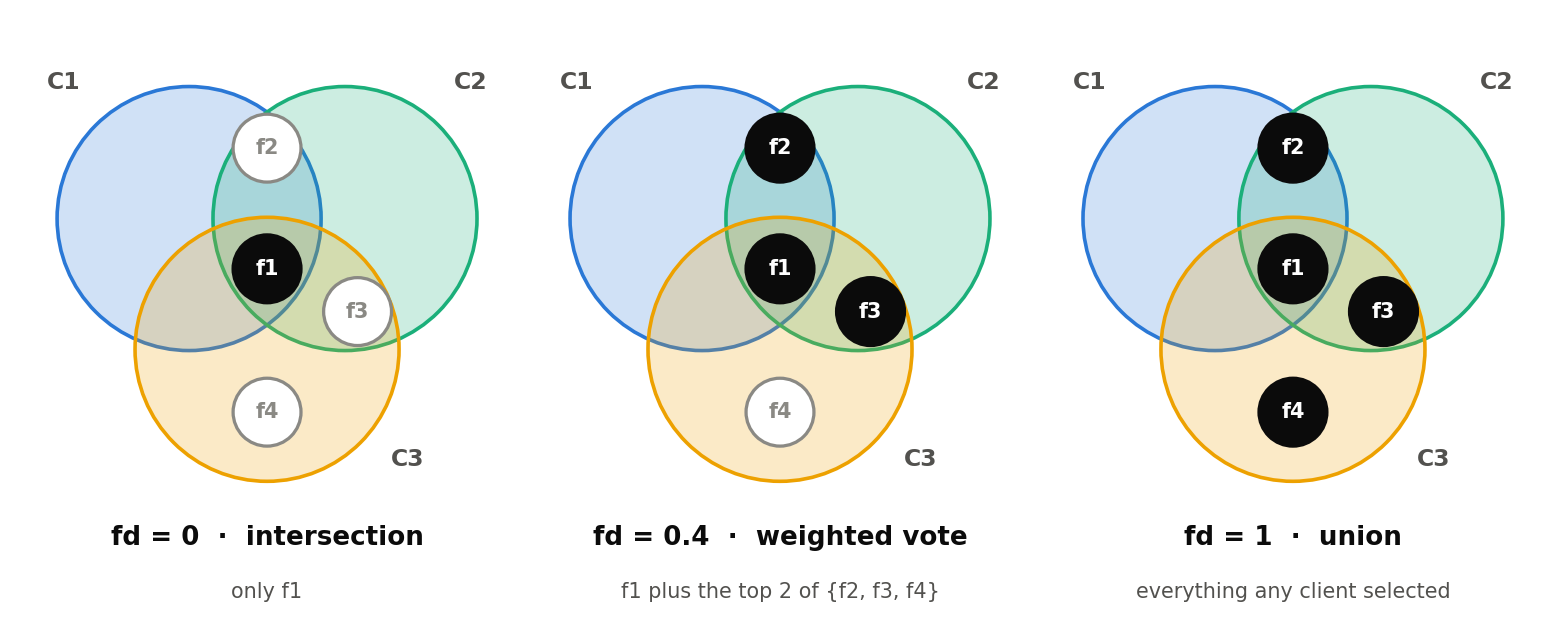
Máy chủ chia các đặc trưng thành ba nhóm. Phần giao gồm những đặc trưng mọi khách hàng đều chọn — luôn được giữ. Những đặc trưng không khách hàng nào chọn — luôn bị loại. Tập tranh chấp là phần hợp của tất cả các lựa chọn trừ đi phần giao: tức những đặc trưng mà ít nhất một điểm muốn giữ và ít nhất một điểm từ chối.
Độ tự do fd, một số trong khoảng [0, 1], quy định bao nhiêu phần trăm của tập tranh chấp được chấp nhận. Khi fd = 0, mặt nạ toàn cục chính là phần giao; khi fd = 1, nó là toàn bộ phần hợp. Ở khoảng giữa, máy chủ chuẩn hóa min-max điểm số của từng khách hàng riêng biệt để hệ số Lasso và giá trị thông tin tương hỗ cùng nằm trên thang 0 đến 1. Nó tính trọng số khách hàng w_i = n_i / tổng(n) và lá phiếu tổng hợp cho mỗi đặc trưng V = tổng_i w_i × M_i trên các điểm số đã chuẩn hóa, rồi giữ lại ceil(fd × |tập tranh chấp|) đặc trưng có V cao nhất, cộng thêm phần giao.
Độ tự do giúp cân bằng giữa hai kiểu thất bại. Ở fd = 0, mọi điểm đều có quyền phủ quyết, nên chỉ cần một điểm có bộ chọn quá khắt khe là mô hình bị thu nhỏ cho tất cả. Ở fd = 1, mọi điểm đều có thể làm ô nhiễm mặt nạ, nên nhiễu từ một bộ chọn quá dễ dãi sẽ lan tới toàn bộ hệ thống.
Một ví dụ nhỏ cho dễ hình dung
Ba khách hàng nắm giữ lần lượt 50%, 30% và 20% dữ liệu, tương ứng trọng số 0.5, 0.3 và 0.2. Đặc trưng f1 được cả ba chọn. Đặc trưng f2 được C1 (điểm 0.9) và C2 (0.6) chọn; f3 được C2 (0.8) và C3 (0.6) chọn; f4 chỉ được C3 (0.4) chọn.
| Đặc trưng | C1 (w=0.5) | C2 (w=0.3) | C3 (w=0.2) | Phiếu V | Kết quả tại fd = 0.4 |
|---|---|---|---|---|---|
| f1 | được chọn | được chọn | được chọn | n/a (đồng thuận) | giữ (phần giao) |
| f2 | 0.9 | 0.6 | 0.3 | 0.69 | giữ (hạng 1) |
| f3 | 0.2 | 0.8 | 0.6 | 0.46 | giữ (hạng 2) |
| f4 | 0.1 | 0.2 | 0.4 | 0.19 | loại (hạng 3) |
Tập tranh chấp là {f2, f3, f4}, và ở fd = 0.4 máy chủ nhận ceil(0.4 × 3) = 2 đặc trưng, gồm f2 và f3, cho ra mặt nạ toàn cục {f1, f2, f3}. Lưu ý rằng điểm số của một khách hàng vẫn được tính vào lá phiếu dù nó không chọn đặc trưng đó — mức độ C1 ưa thích f3 có thể giúp hoặc hại f3 dù chỉ C2 và C3 đưa nó vào mặt nạ của mình.
Cài đặt thuật toán bằng NumPy
Quy tắc này ngắn đến mức có thể viết trọn vẹn. Hàm nhận vào danh sách mặt nạ, vector điểm số và số lượng mẫu, rồi trả về mặt nạ toàn cục kèm vài con số thống kê. Điểm số được lấy giá trị tuyệt đối để hệ số Lasso âm cũng bỏ phiếu giống như hệ số dương.
import math
import numpy as np

def feature_election(masks, scores, n_samples, freedom_degree):
    masks = np.asarray(masks, dtype=bool)
    scores = np.abs(np.asarray(scores, dtype=float))
    n = np.asarray(n_samples, dtype=float)

    intersection = masks.all(axis=0)
    union = masks.any(axis=0)
    disputed = np.flatnonzero(union & ~intersection)

    # chuẩn hóa min-max điểm số từng khách hàng để các bộ chọn khác nhau so sánh được
    lo = scores.min(axis=1, keepdims=True)
    span = scores.max(axis=1, keepdims=True) - lo
    norm = np.divide(scores - lo, span, out=np.zeros_like(scores), where=span > 0)

    weights = n / n.sum()
    votes = weights @ norm

    k = math.ceil(freedom_degree * len(disputed))
    winners = disputed[np.argsort(-votes[disputed], kind="stable")[:k]]

    global_mask = intersection.copy()
    global_mask[winners] = True

    stats = {
        "intersection": int(intersection.sum()),
        "union": int(union.sum()),
        "disputed": len(disputed),
        "kept": int(global_mask.sum()),
    }
    return global_mask, stats
Điểm mấu chốt là mặt nạ chỉ quyết định đặc trưng nào nằm trong phần giao, tập tranh chấp hay bị loại. Bản thân lá phiếu dùng điểm số của mọi khách hàng cho một đặc trưng tranh chấp, kể cả những khách hàng đã bỏ nó ra khỏi mặt nạ. Một đặc trưng chỉ được điểm nhỏ nhất chọn vẫn có thể thắng một suất nếu các điểm lớn hơn cho nó điểm số ngay dưới ngưỡng cắt của chúng, và nó sẽ thua nếu chúng cho điểm gần bằng không.
Chạy thử như một tác vụ NVIDIA FLARE
Để có số liệu thực tế, ta chạy bản cài đặt chính thức dưới dạng một tác vụ FLARE: một FeatureElectionController trên máy chủ và một FeatureElectionExecutor trên mỗi điểm trong ba điểm, trao đổi các tác vụ FLARE với nhau. Có thể khởi chạy bằng trình mô phỏng của FLARE, vốn chạy máy chủ và ba khách hàng trên cùng một máy.
Bảng dữ liệu thử nghiệm có 100 đặc trưng: 12 đặc trưng mang thông tin, 8 đặc trưng dư thừa (là tổ hợp tuyến tính của nhóm mang thông tin nên cũng chứa tín hiệu) và 80 đặc trưng nhiễu. Với shuffle=False, scikit-learn xếp 20 đặc trưng tín hiệu vào 20 cột đầu tiên, rất thuận tiện để kiểm tra xem cuộc bầu chọn giữ lại được gì.
Mỗi điểm chỉ cần người dùng cung cấp một thứ: cách nạp dữ liệu của chính nó.
# job.py
import argparse, glob, json, os
from site_executor import SiteExecutor
from nvflare.app_opt.feature_election import FeatureElectionController
from nvflare.job_config.api import FedJob

# mỗi điểm giữ nguyên bộ chọn mà nó đang dùng
SELECTORS = {"site-1": "lasso", "site-2": "random_forest", "site-3": "mutual_info"}

parser = argparse.ArgumentParser()
parser.add_argument("--freedom-degree", type=float, default=0.5)
parser.add_argument("--auto-tune", action="store_true")
parser.add_argument("--workspace", default="/tmp/nvflare/feature_election_demo")
args = parser.parse_args()

job = FedJob(name="feature_election_demo")
job.to_server(FeatureElectionController(
    freedom_degree=args.freedom_degree, aggregation_mode="weighted",
    min_clients=3, num_rounds=5, auto_tune=args.auto_tune, tuning_rounds=5,
    wait_time_after_min_received=0))
for site, method in SELECTORS.items():
    job.to(SiteExecutor(data_dir=os.path.abspath("data"), fs_method=method), site)
job.simulator_run(args.workspace)
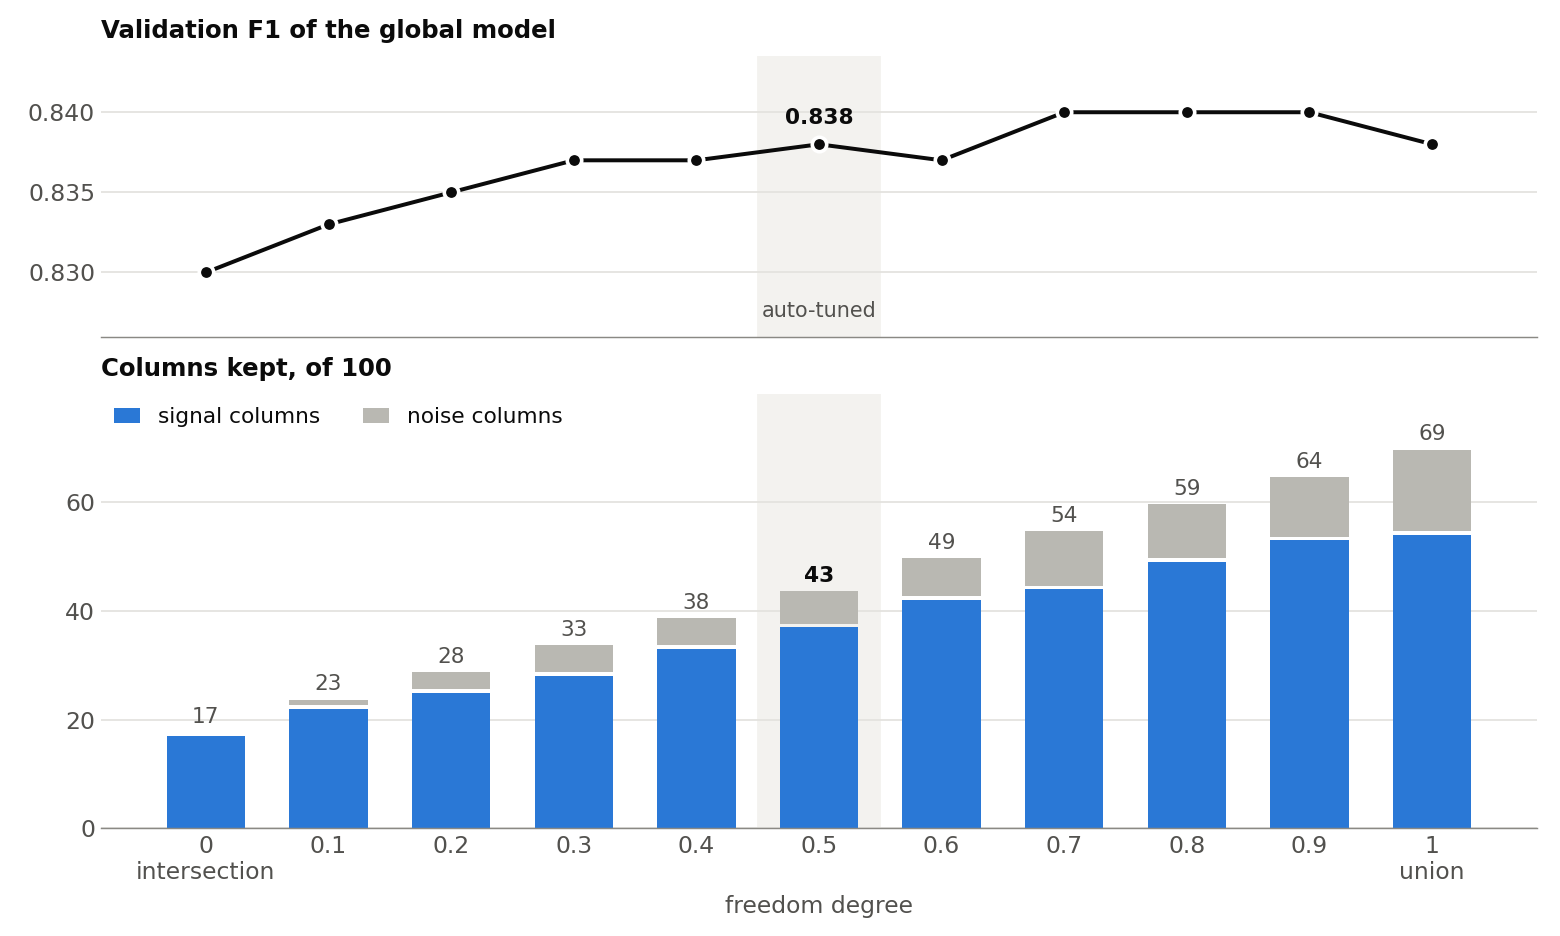
Kết quả chạy thử ở năm mức độ tự do khác nhau cho thấy rõ hai kiểu thất bại đã phân tích ở trên. Trên dữ liệu của chính mình, điểm chạy Lasso chọn 35 đặc trưng (trong đó có 12 trong số 20 đặc trưng tín hiệu), điểm rừng ngẫu nhiên chọn 50 (đủ cả 20), điểm thông tin tương hỗ chọn 50 (có 15).
- Ở độ tự do 0, bộ chọn khắt khe nhất nắm quyền phủ quyết, mặt nạ chỉ giữ được 10 đặc trưng tín hiệu.
- Ở độ tự do 1, nhiễu của mọi điểm đều lọt vào, mặt nạ mang theo tới 61 đặc trưng nhiễu.
- Ở độ tự do 0.5, lá phiếu khôi phục đủ cả 20 đặc trưng tín hiệu với 28 đặc trưng nhiễu — chưa bằng một nửa lượng nhiễu so với trường hợp hợp nhất.
Cơ chế tự động tinh chỉnh có một hạn chế đáng lưu ý. Nó thử các độ tự do trong khoảng 0.5 đến 0.7, thấy F1 kiểm định dao động từ 0.776 đến 0.781 rồi chọn fd = 0.6 với 55 đặc trưng. Vì thuật toán leo đồi chỉ tối ưu F1, khi F1 phẳng như vậy nó không có lý do gì để ưu tiên mặt nạ nhỏ hơn — trong khi fd = 0.5 cho cùng mức tín hiệu nhưng ít hơn 7 đặc trưng nhiễu. Nếu kích thước mô hình là mối quan tâm, hãy tự kiểm tra các giá trị lân cận.
 Biểu đồ so sánh số lượng đặc trưng giữ lại theo độ tự do
Kết quả đạt được
Trong bài báo FLASH, Feature Election được đánh giá với ba khách hàng trên các tập chia theo tỷ lệ 50/30/20, huấn luyện bằng FedAvg. Nhóm nghiên cứu dùng ba mô hình (Gaussian Naive Bayes, bộ phân loại SGD tuyến tính và MLP), bốn bộ dữ liệu (Mushroom, Adult Income, Heart Disease, Wisconsin Breast Cancer) và ba bộ chọn cục bộ: Lasso, Sequential Attention và PyImpetus.
Hiệu ứng nhất quán nằm ở kích thước mô hình. Số lượng tham số, kéo theo đó là lưu lượng gửi đi mỗi vòng, giảm trung bình 49%. Mức cắt lớn nhất là 88.8% (bộ phân loại SGD, Adult Income, Sequential Attention); Gaussian Naive Bayes trên Breast Cancer với Lasso giảm 81.0%; mức cắt nhỏ nhất là 6.7%.
Tác động lên F1, khi đo mà không tinh chỉnh siêu tham số, rất lớn ở một số cấu hình nhưng lại bằng không hoặc âm ở những cấu hình khác:
| Mô hình | Bộ dữ liệu | Bộ chọn | F1 không chọn lọc | F1 có Feature Election |
|---|---|---|---|---|
| MLP | Breast Cancer | PyImpetus | 0.41 | 0.94 |
| SGD | Adult Income | PyImpetus | 0.02 | 0.35 |
| Gaussian NB | Mushroom | PyImpetus | 0.81 | 0.88 |
| Gaussian NB | Breast Cancer | Lasso | 0.93 | 0.85 |
Ở hai dòng đầu, mô hình chưa tinh chỉnh trên toàn bộ đặc trưng gần như không hoạt động, và tập đặc trưng được bầu chọn đã giúp nó dùng được — dù 0.35 vẫn còn yếu. Ở dòng thứ ba, việc chọn lọc cộng thêm 7 điểm phần trăm cho một mô hình vốn đã chạy tốt; ở dòng cuối, nó làm mất 8 điểm.
So với mức cơ sở Flower FedAvg thuần không chọn lọc và không tinh chỉnh, cấu hình FLASH tốt nhất đã ngang bằng hoặc vượt qua trong 9 trên 12 cặp mô hình – bộ dữ liệu, và thua nhẹ ở 3 cặp còn lại. Lợi ích đáng tin cậy nhất là ít tham số phải truyền đi hơn mỗi vòng; độ chính xác thường được giữ nguyên, đôi khi cải thiện mạnh, tùy vào bộ dữ liệu, mô hình và bộ chọn.
Một thử nghiệm đánh giá độc lập
Một bài báo của Sharma và cộng sự từ VTT và Đại học Đông Phần Lan, được nhận cho kỷ yếu hội thảo MICCAI 2026, đưa ra góc nhìn từ bên ngoài. Nhóm này giới thiệu LAFFS, một phương pháp LASSO liên bang của riêng họ, và phương pháp chọn lọc đặc trưng liên bang duy nhất mà họ đem ra so sánh chính là Feature Election.
Điều kiện thử nghiệm khắc nghiệt hơn nhiều so với bài báo FLASH: bốn bộ dữ liệu chuẩn có từ 5.966 đến 19.993 đặc trưng nhưng chỉ vỏn vẹn 72 đến 187 mẫu, chia trên 5 đến 18 điểm dữ liệu.
| Phương pháp | ALLAML (5 điểm) | Prostate_GE (10 điểm) | SMK_CAN_187 (18 điểm) | Leukemia (5 điểm) |
|---|---|---|---|---|
| Mỗi điểm tự chạy | 0.747 | 0.582 | 0.529 | 0.663 |
| Hồi quy logistic L1 trong FLARE | 0.968 | 0.925 | 0.669 | 0.983 |
| Feature Election (Lasso, tự tinh chỉnh) | 0.985 | 0.922 | 0.710 | 0.934 |
| LAFFS | 0.987 | 0.947 | 0.702 | 0.996 |
| Tập trung trên dữ liệu gộp | 0.987 | 0.964 | 0.711 | 0.974 |
LAFFS đạt điểm liên bang cao nhất trên ba trong bốn bộ dữ liệu. Feature Election dẫn đầu trên SMK_CAN_187 — cấu hình lớn nhất với 18 điểm và gần 20.000 đặc trưng — nơi nó đạt 0.710 so với 0.711 khi huấn luyện tập trung, tức gần như ngang bằng với mô hình gộp dữ liệu. Đáng chú ý là mọi phương pháp liên bang đều vượt xa các điểm chạy đơn lẻ.
Bài báo cũng chỉ ra một điểm yếu: trên bảng tổng hợp với 20 đặc trưng mang thông tin trong tổng số 200, LAFFS chỉ chọn toàn đặc trưng có ích, còn Feature Election với Lasso để lọt một số đặc trưng vô nghĩa. Đó là lập luận của nhóm tác giả cho việc tối ưu một mô hình thưa duy nhất.
Đánh giá của tôi là một sơ đồ bỏ phiếu tổng quát, khi được một nhóm độc lập chạy thử, vẫn bám sát được một phương pháp chuyên dụng và cả mô hình huấn luyện tập trung, ở số điểm nhiều gấp sáu lần những gì tôi từng thử nghiệm. Điểm khác biệt nằm ở giả định: LAFFS gắn chặt với hồi quy logistic LASSO và nhóm tác giả có công bố đơn xin cấp bằng sáng chế cho thuật toán; còn Feature Election hoạt động với bất kỳ bộ chọn và mô hình cục bộ nào, và là mã nguồn mở theo giấy phép Apache 2.0.
Dùng ngay hôm nay
Có hai bản chuyển thể của cùng một quy tắc bầu chọn, mỗi bản cho một framework. Bản Flower là một ứng dụng trên Flower Hub; bản NVIDIA FLARE là mô-đun nvflare.app_opt.feature_election, đi kèm ví dụ chạy được trong kho NVFlare từ phiên bản 2.8.0 trở đi. Cả hai đều là mã nguồn mở theo giấy phép Apache 2.0.
Những hạn chế cần lưu tâm
Đánh giá đã công bố chỉ dùng ba khách hàng và huấn luyện thuần bằng FedAvg. Thử nghiệm độc lập nói trên đã lên tới 18 điểm, nhưng việc mở rộng hơn nữa và dữ liệu không đồng nhất mạnh vẫn chưa được kiểm chứng. Trong thử nghiệm độc lập đó, một phương pháp được tối ưu chung cũng chọn được ít đặc trưng nhiễu hơn so với bầu chọn.
Về mặt lý thuyết, chưa có chứng minh hình thức nào cho thuật toán, ví dụ về việc mặt nạ được bầu chọn gần với lựa chọn của một bộ chọn trên bảng gộp đến mức nào. Về quyền riêng tư, mặt nạ và điểm số tiết lộ ít hơn nhiều so với dữ liệu thô, nhưng chúng vẫn tiết lộ điều gì đó về dữ liệu của mỗi điểm — và khác với quyền riêng tư vi phân, đây không phải là một bảo đảm hình thức.
Kết luận
Feature Election giải quyết một khoảng trống rất thực tế trong học liên bang: làm sao để nhiều tổ chức thống nhất được đặc trưng nào quan trọng mà không phải chia sẻ dữ liệu. Thay vì phải thay cả thuật toán, nó chỉ thêm một lớp bỏ phiếu mỏng trên nền tảng sẵn có, giữ nguyên bộ chọn mà mỗi nơi đang tin dùng. Lợi ích chắc chắn nhất là mô hình nhỏ hơn đáng kể và lưu lượng truyền tải giữa các vòng giảm mạnh, trong khi độ chính xác thường được giữ nguyên và đôi khi cải thiện rõ rệt.
 Minh họa mạng lưới các nút học liên bang cùng bỏ phiếu chọn đặc trưng
Nếu bạn đang có một bài toán dữ liệu dạng bảng bị chia cắt giữa nhiều nơi, hoặc chỉ là một bảng duy nhất có thể tự chia ra để mô phỏng, hãy thử chạy bầu chọn đặc trưng trên đó và so sánh mặt nạ được bầu với mặt nạ mà bộ chọn quen thuộc của bạn chọn trên bảng gộp. Sự khác biệt giữa hai kết quả sẽ cho bạn biết mình đang đánh đổi điều gì.