
Huấn luyện mô hình bằng dữ liệu tổng hợp với DINOv3 đóng băng: Bài học từ bài toán nhận diện thẻ bài
Một thử nghiệm thực tế cho thấy có thể dùng đặc trưng DINOv3 đóng băng của Meta để huấn luyện hoàn toàn trên dữ liệu tổng hợp do máy tính tạo ra, rồi chuyển giao sang ảnh thật với độ chính xác cao. Bài viết phân tích cách sinh dữ liệu bằng OpenCV, các loại đầu ra khác nhau và những thách thức riêng của từng hướng tiếp cận.
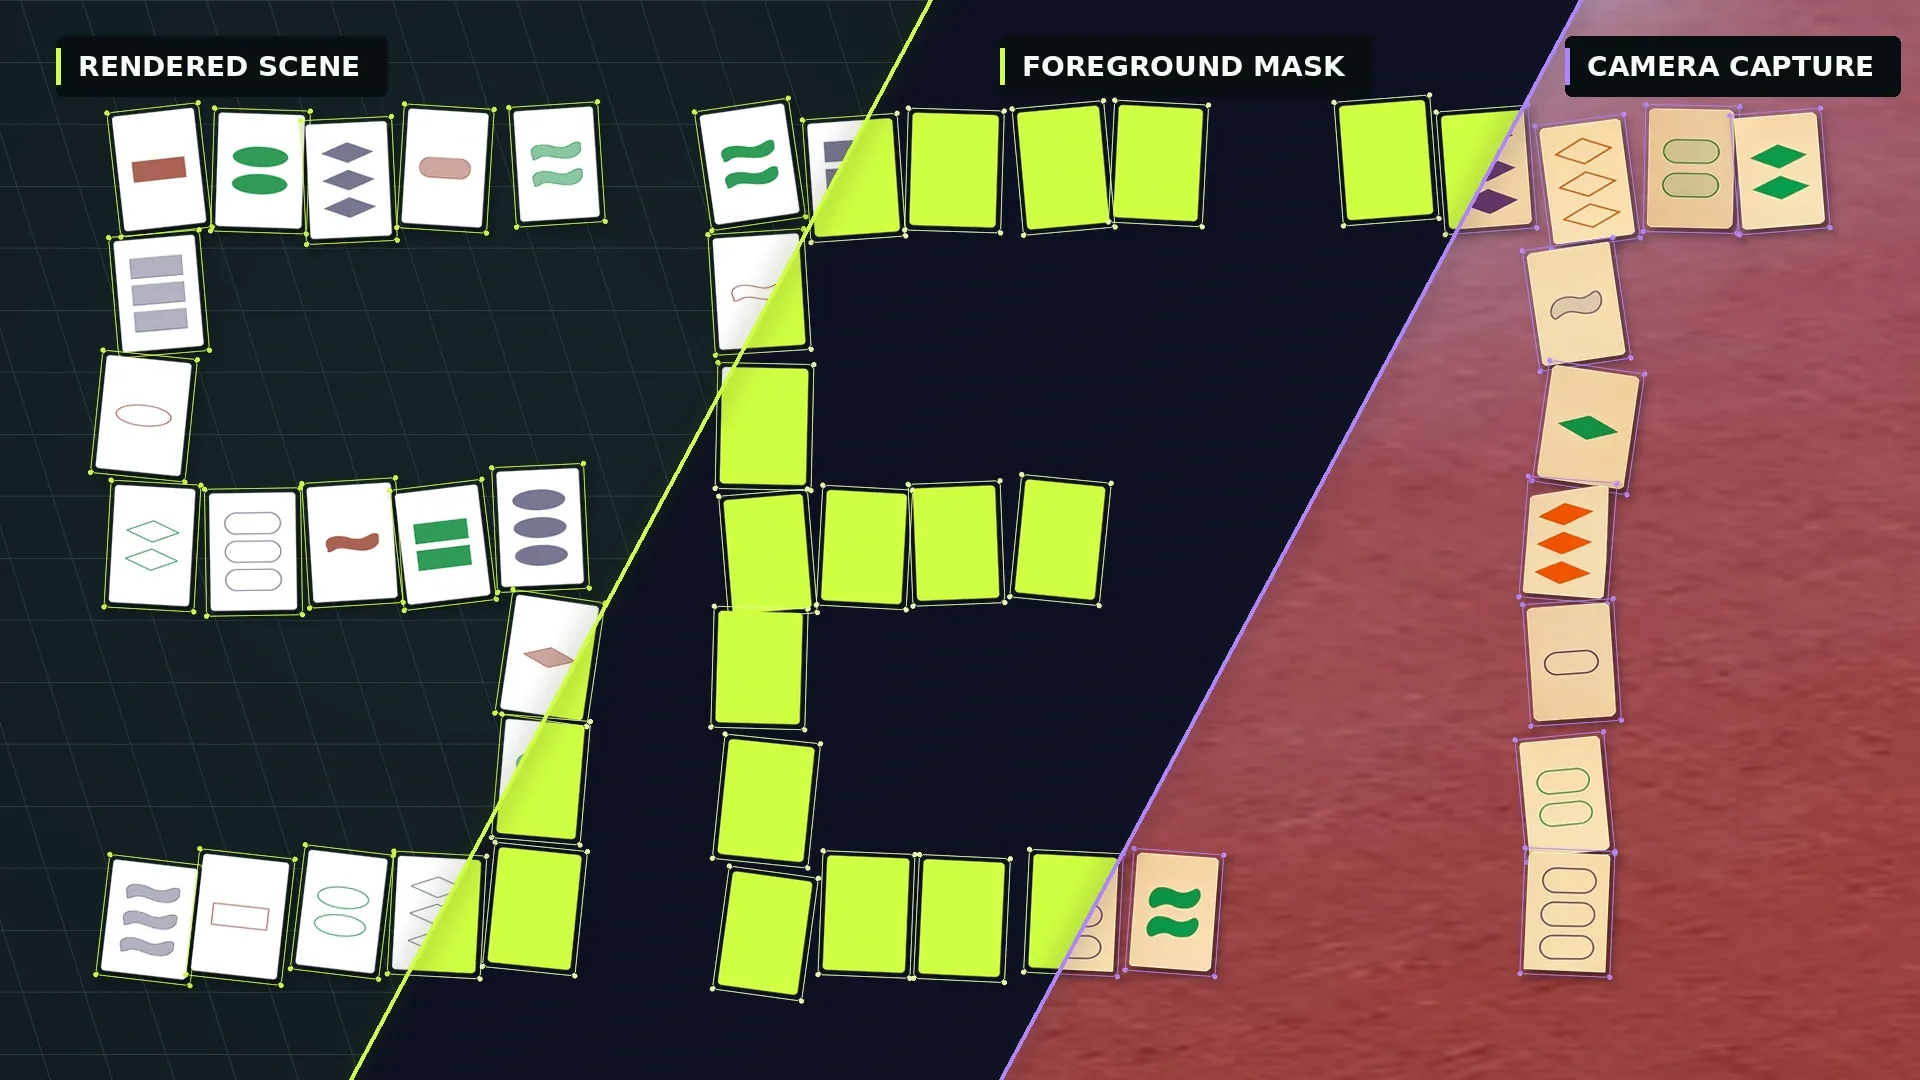
Dữ liệu là phần giá trị nhất của mọi hệ thống học máy. Càng có nhiều dữ liệu đa dạng và đúng với bài toán, mô hình càng dễ đạt kết quả tốt. Thế nhưng việc thu thập và gán nhãn dữ liệu chưa bao giờ là chuyện dễ: bạn phải tự chụp ảnh mà không để lọt thiên lệch vào tập dữ liệu, hoặc phải kiểm tra lại nhãn do bên thứ ba gán, hoặc ngày nay là kiểm tra nhãn do một mô hình ngôn ngữ - thị giác (VLM) tự động sinh ra.
Một cách hiệu quả để có lượng lớn dữ liệu với nhãn hoàn hảo là tự sinh dữ liệu tổng hợp. Khi dùng cách này, nhãn thực tế (ground truth) đã có sẵn ngay từ khâu thiết kế. Thách thức lớn của hướng tiếp cận này trong thị giác máy tính là liệu dữ liệu tổng hợp có đủ tốt để mô hình học được những đặc trưng khái quát hóa ra ảnh thật hay không.
Bài viết này trình bày một thử nghiệm thực tế: dùng bộ trích xuất đặc trưng tiên tiến DINOv3 của Meta, giữ nguyên (đóng băng) phần lõi và chỉ huấn luyện các lớp đầu ra nhỏ trên dữ liệu tổng hợp, sau đó kiểm tra khả năng chuyển giao sang ảnh thật.
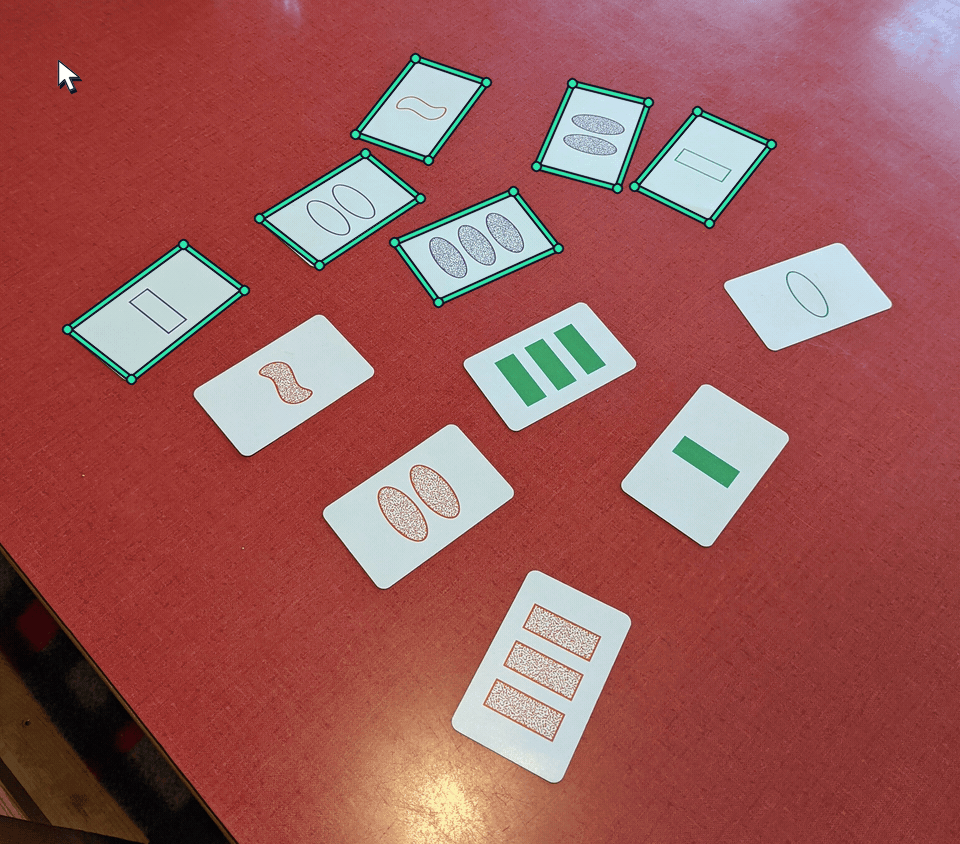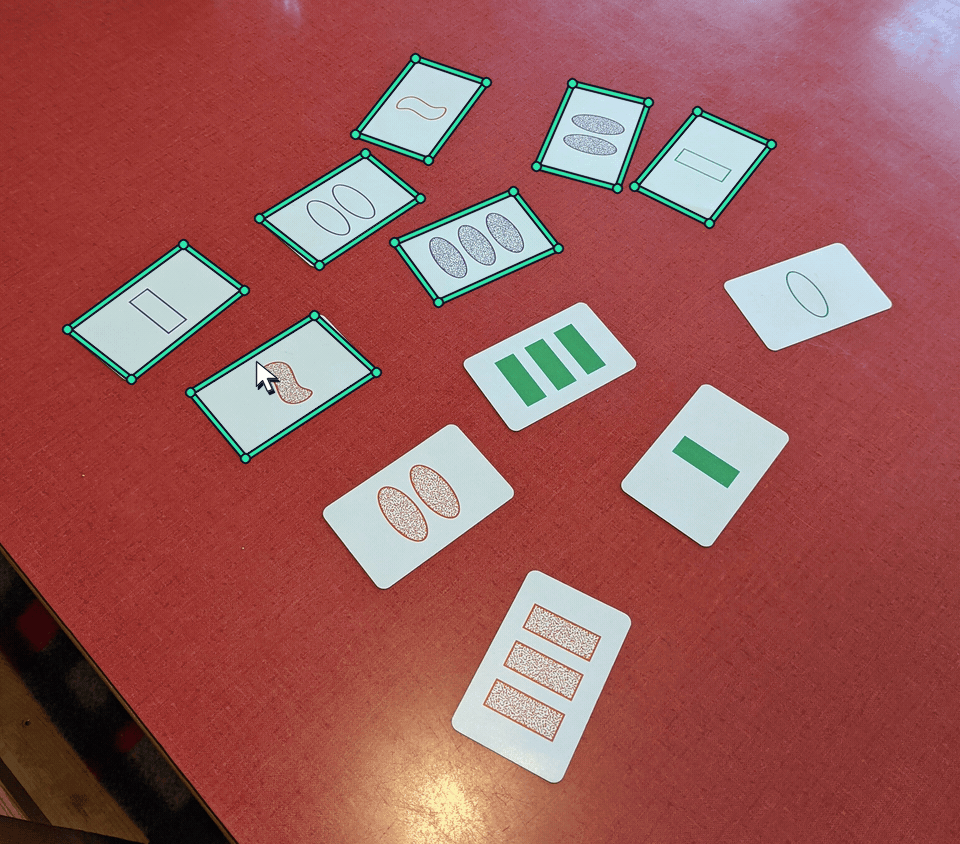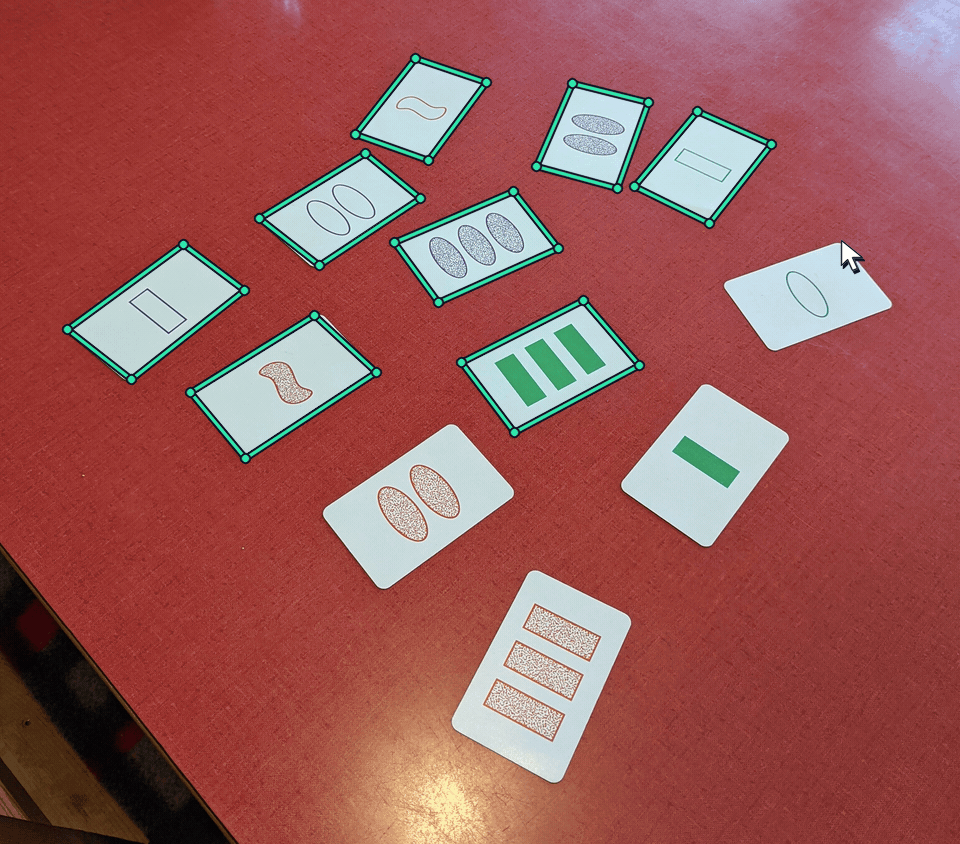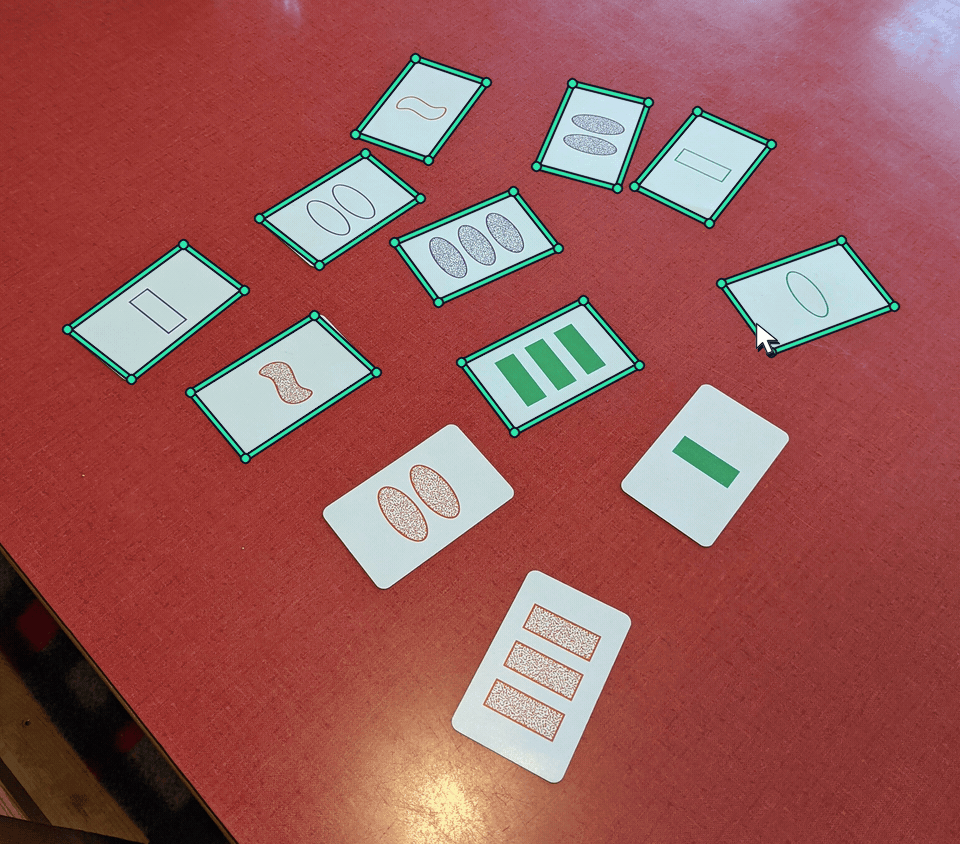 Minh họa quy trình huấn luyện và đánh giá mô hình
Bài toán: Nhận diện thẻ bài của trò chơi SET
Tác giả chọn một lĩnh vực đủ đơn giản để sinh dữ liệu nhưng vẫn thú vị: các thẻ bài của trò chơi SET. Trong trò chơi này, người chơi phải tìm các bộ ba thẻ (gọi là "set") trên một bàn bài 4x3, trong đó mỗi thuộc tính — hình dạng, màu sắc, kiểu tô và số lượng — phải hoàn toàn giống nhau ở cả ba thẻ hoặc hoàn toàn khác nhau.
Mục tiêu giai đoạn đầu chưa phải là nhận diện loại thẻ, mà chỉ định vị vị trí các thẻ trong ảnh.
Kiến trúc mô hình: DINOv3 đóng băng kết hợp các đầu ra riêng
Để huấn luyện được trên GPU cá nhân, tác giả chọn phiên bản nhỏ nhất của dòng DINOv3 là ConvNeXt Tiny (khoảng 29 triệu tham số). Dù là phiên bản "tí hon" được chưng cất từ mô hình transformer lớn, nó vẫn giữ được khả năng trích xuất đặc trưng cục bộ rất mạnh.
Kiến trúc gồm hai phần:
- Phần lõi DINOv3 đóng băng: tải trọng số đã huấn luyện sẵn và khóa toàn bộ tham số, không cập nhật trong quá trình huấn luyện.
- Mạng kim tự tháp đặc trưng (FPN) và các lớp đầu ra riêng cho từng tác vụ: đây là phần duy nhất được huấn luyện, có nhiệm vụ chuyển đặc trưng sẵn có thành kết quả cụ thể như hộp bao, điểm góc hay mặt nạ phân đoạn.
Cách làm này cho phép tận dụng đặc trưng đã học được mà vẫn giữ chi phí huấn luyện thấp. Với tác vụ phát hiện vật thể, tác giả sử dụng Faster R-CNN với các tham số mặc định, không tinh chỉnh nhiều, vì mục tiêu là kiểm chứng khả năng chuyển giao chứ không phải đạt điểm số cao nhất.
Sinh dữ liệu tổng hợp bằng OpenCV
Dữ liệu được tạo hoàn toàn bằng OpenCV, bắt đầu từ những hình khối cơ bản. Ví dụ, một thẻ bài trắng bo góc được vẽ từ hai hình chữ nhật chồng nhau cộng bốn hình elip ở bốn góc. Vì là dữ liệu sinh bằng mã, tác giả có toàn quyền điều khiển hình dáng, màu sắc, kích thước và cách bố trí thẻ.
Điểm mấu chốt là nhãn thực tế có sẵn miễn phí: biết chính xác vị trí từng thẻ nên có thể áp dụng cùng một phép biến đổi phối cảnh lên tọa độ các góc, từ đó sinh ra hộp bao thường, hộp bao xoay, điểm góc, hay mặt nạ phân đoạn theo cả hai kiểu ngữ nghĩa và thể hiện. Cùng một tập dữ liệu có thể dùng cho nhiều tác vụ khác nhau mà không phải gán nhãn lại.
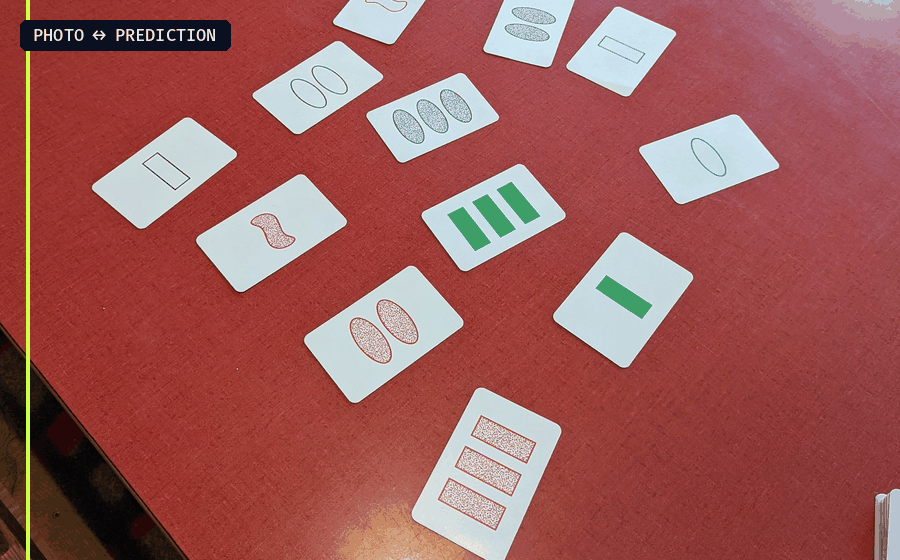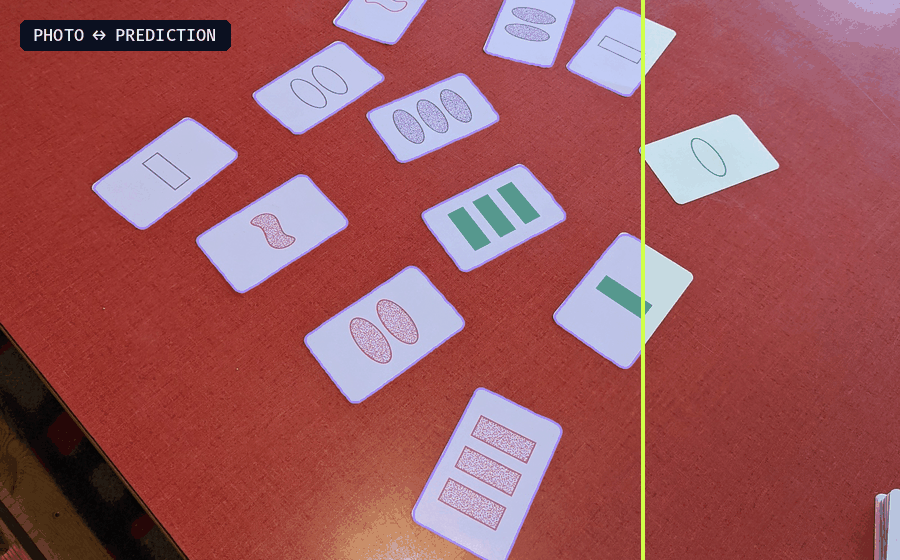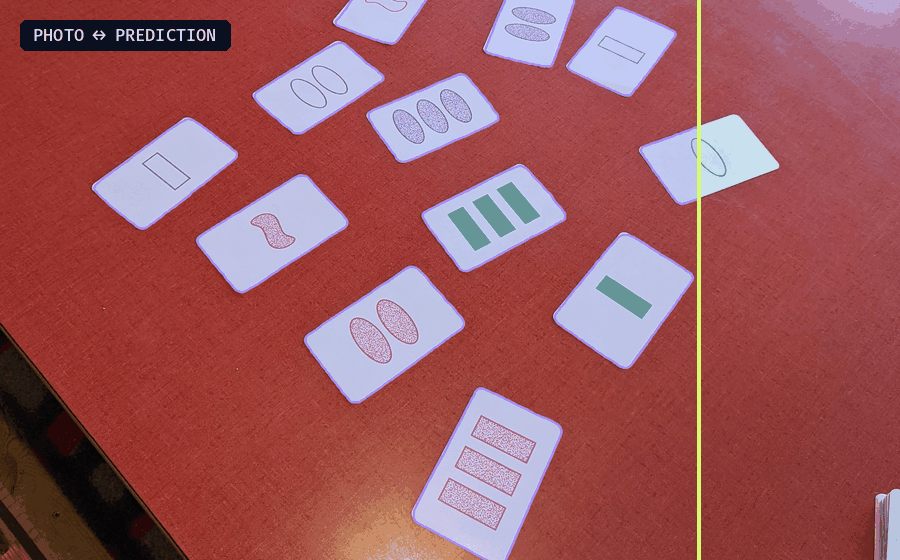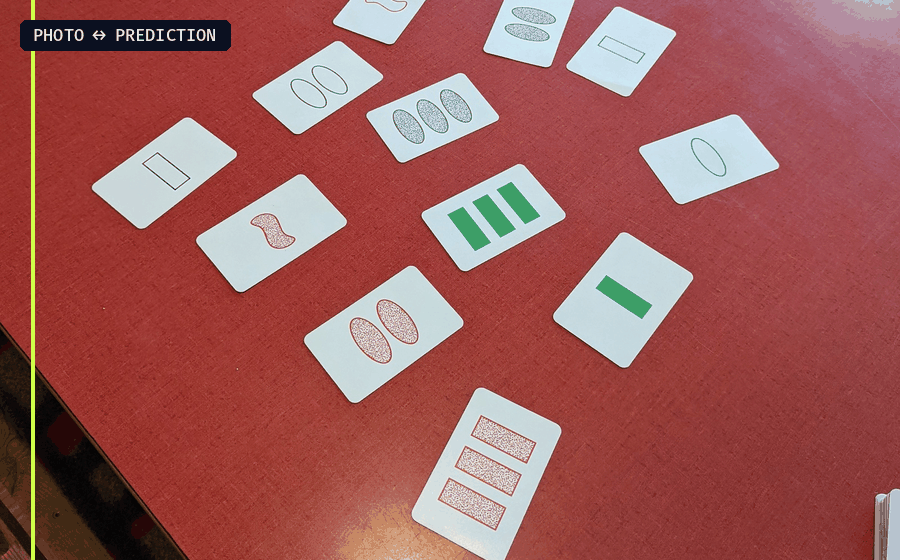 Minh họa dữ liệu ảnh tổng hợp được sinh tự động
Để ảnh trông thực tế hơn, tác giả bổ sung:
- Nền có kết cấu lấy từ thư viện ảnh miễn phí Poly Haven (giấy phép CC0).
- Độ nghiêng phối cảnh nhẹ, bóng đổ mềm và vệt sáng tinh tế để thẻ trông như đang đặt trên mặt bàn.
- Thay đổi ngẫu nhiên về vị trí, góc xoay và khoảng cách để phá vỡ sự đều đặn của lưới.
Dữ liệu thật và kết quả chuyển giao
Tập kiểm tra là 40 ảnh thật do tác giả chụp bằng điện thoại, gồm 11 bối cảnh khác nhau với tổng cộng 480 thẻ, nhằm đánh giá định tính chứ không phải một bộ benchmark toàn diện.
Mô hình chỉ được huấn luyện trên 2.000 ảnh tổng hợp và kiểm định trên 200 ảnh tổng hợp, chạy 10 epoch. Kết quả trên ảnh thật — dữ liệu mà mô hình chưa từng thấy lần nào:
| Tác vụ | Độ chính xác (Precision) | Độ phủ (Recall) | F1 |
|---|---|---|---|
| Phát hiện vật thể | 0,950 | 0,998 | 0,974 |
| Hộp bao xoay | 0,973 | 0,683 | 0,803 |
| Điểm góc | 0,978 | 0,925 | 0,951 |
| Phân đoạn ngữ nghĩa | 0,881 | 0,944 | 0,911 |
Kết quả tốt nhất thuộc về phát hiện vật thể, với F1 gần 0,97 dù không hề dùng ảnh thật nào để huấn luyện.
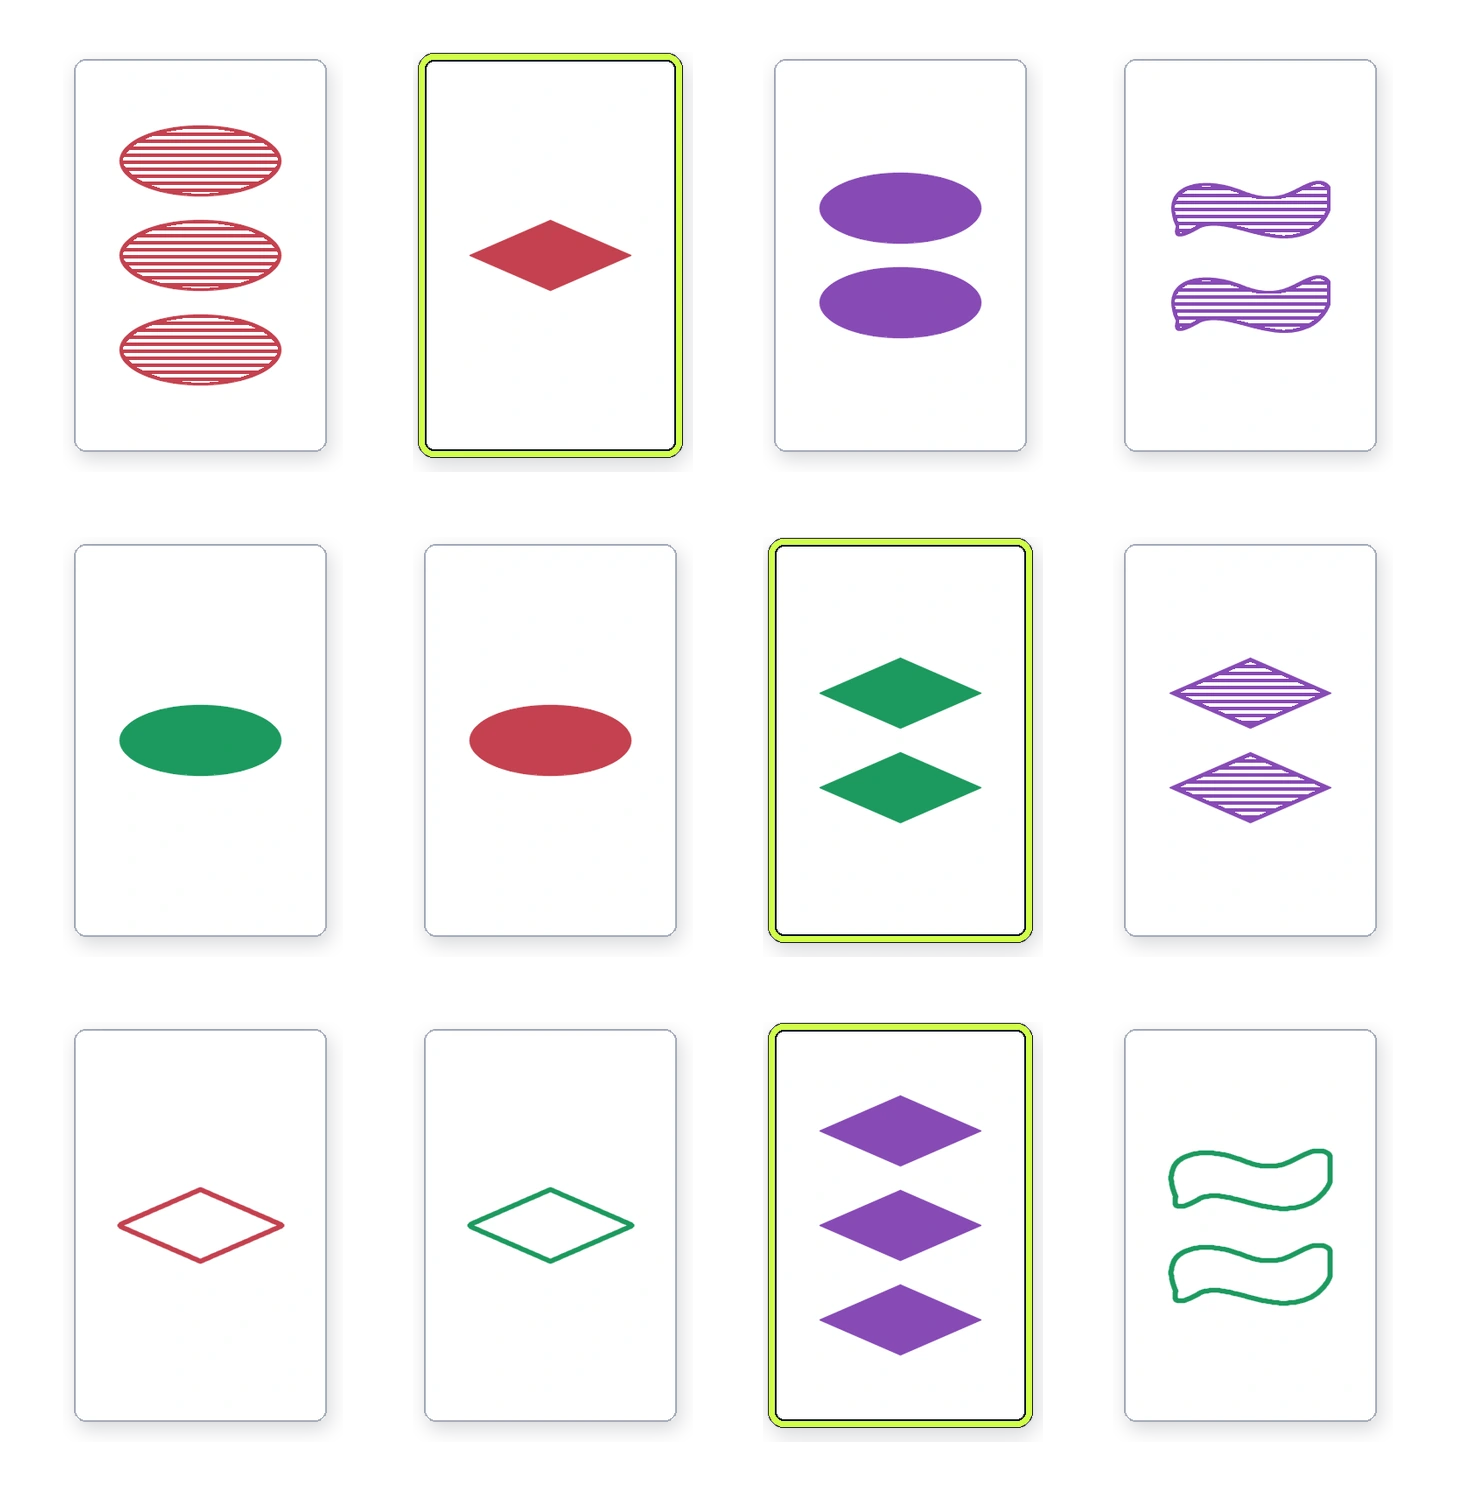 So sánh kết quả dự đoán trên ảnh thật
Những thách thức riêng của từng tác vụ
Mỗi loại đầu ra đều có vấn đề riêng, và đây là phần đáng học hỏi nhất của thử nghiệm.
Phát hiện vật thể: mô hình đôi khi nhận nhầm các vật thể ở nền — chẳng hạn chiếc ghế có lò sưởi trắng phía sau — thành thẻ bài, vì dữ liệu huấn luyện chỉ có nền phẳng. Hộp bao vuông góc cũng không ôm khít được thẻ bị xoay hoặc nghiêng.
Hộp bao xoay: tín hiệu học cho góc xoay tỏ ra chưa đủ tốt, có sự nhập nhằng giữa góc +180 và −180 độ, khiến mô hình kém tự tin hơn và bỏ sót thẻ.
Điểm góc: vấn đề lớn nhất là thứ tự sắp xếp các điểm. Có trường hợp dự đoán khá sát góc thật nhưng nối theo thứ tự dự đoán lại tạo ra các cạnh chéo nhau; trường hợp khác, hai điểm cùng dồn về một góc khiến đa giác bị bẹp. Chỉ một phép xoay nhỏ cũng có thể đảo thứ tự góc dù thẻ gần như không đổi.
Phân đoạn ngữ nghĩa: tránh được vấn đề thứ tự góc và hoạt động bất ngờ tốt trên ảnh thật, nhưng vẫn nhầm một phần chiếc ghế thành tiền cảnh. Hạn chế cố hữu là mọi thẻ chung một lớp, nên hai thẻ chạm nhau sẽ dính thành một vùng liền — muốn tách riêng cần đến phân đoạn thể hiện.
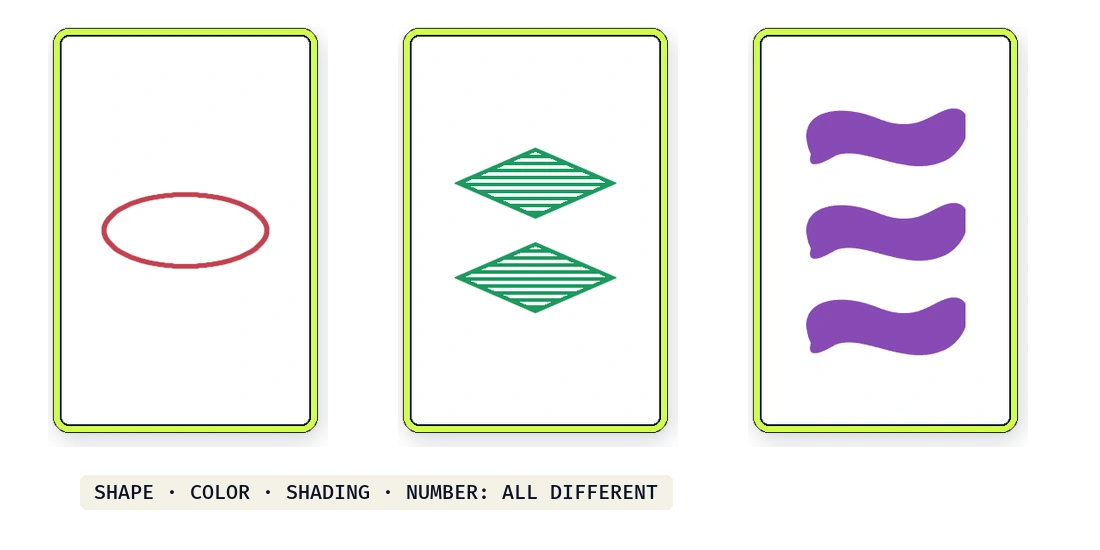 Minh họa các dạng nhãn và mặt nạ phân đoạn
Ý nghĩa và hướng phát triển
Kết quả cho thấy một điều đáng chú ý: đặc trưng DINOv3 đóng băng có khả năng khái quát hóa rất mạnh, đủ để các lớp đầu ra nhỏ học từ dữ liệu tổng hợp rồi áp dụng tốt lên ảnh thật. Đây là hướng tiếp cận hấp dẫn cho các dự án thiếu dữ liệu gán nhãn — đặc biệt hữu ích với các nhóm phát triển tại Việt Nam, nơi việc thu thập và gán nhãn dữ liệu chuyên ngành thường tốn kém và mất thời gian.
Điểm mấu chốt không nằm ở việc huấn luyện mô hình tốt nhất, mà ở việc chứng minh dữ liệu tổng hợp có thể chuyển giao sang thế giới thật khi dùng đúng nền tảng đặc trưng.
Các hướng mở rộng tự nhiên gồm: xử lý trường hợp thẻ bị che khuất một phần (hiện dữ liệu sinh ra cố ý không cho thẻ chồng lên nhau), và tiến xa hơn là nhận diện thuộc tính của thẻ để máy tính thực sự "chơi" được trò chơi.
Toàn bộ mã nguồn gồm sinh dữ liệu, tăng cường ảnh, huấn luyện và đánh giá được tác giả công bố trên GitHub.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Cây cối biết "nói" bằng tín hiệu điện, startup này xây dựng mô hình AI để giải mã ngôn ngữ của chúng
20 tháng 10, 2026