
Sửa hình ảnh, không phải câu lệnh: Bài học từ nghiên cứu về mô hình thị giác - ngôn ngữ
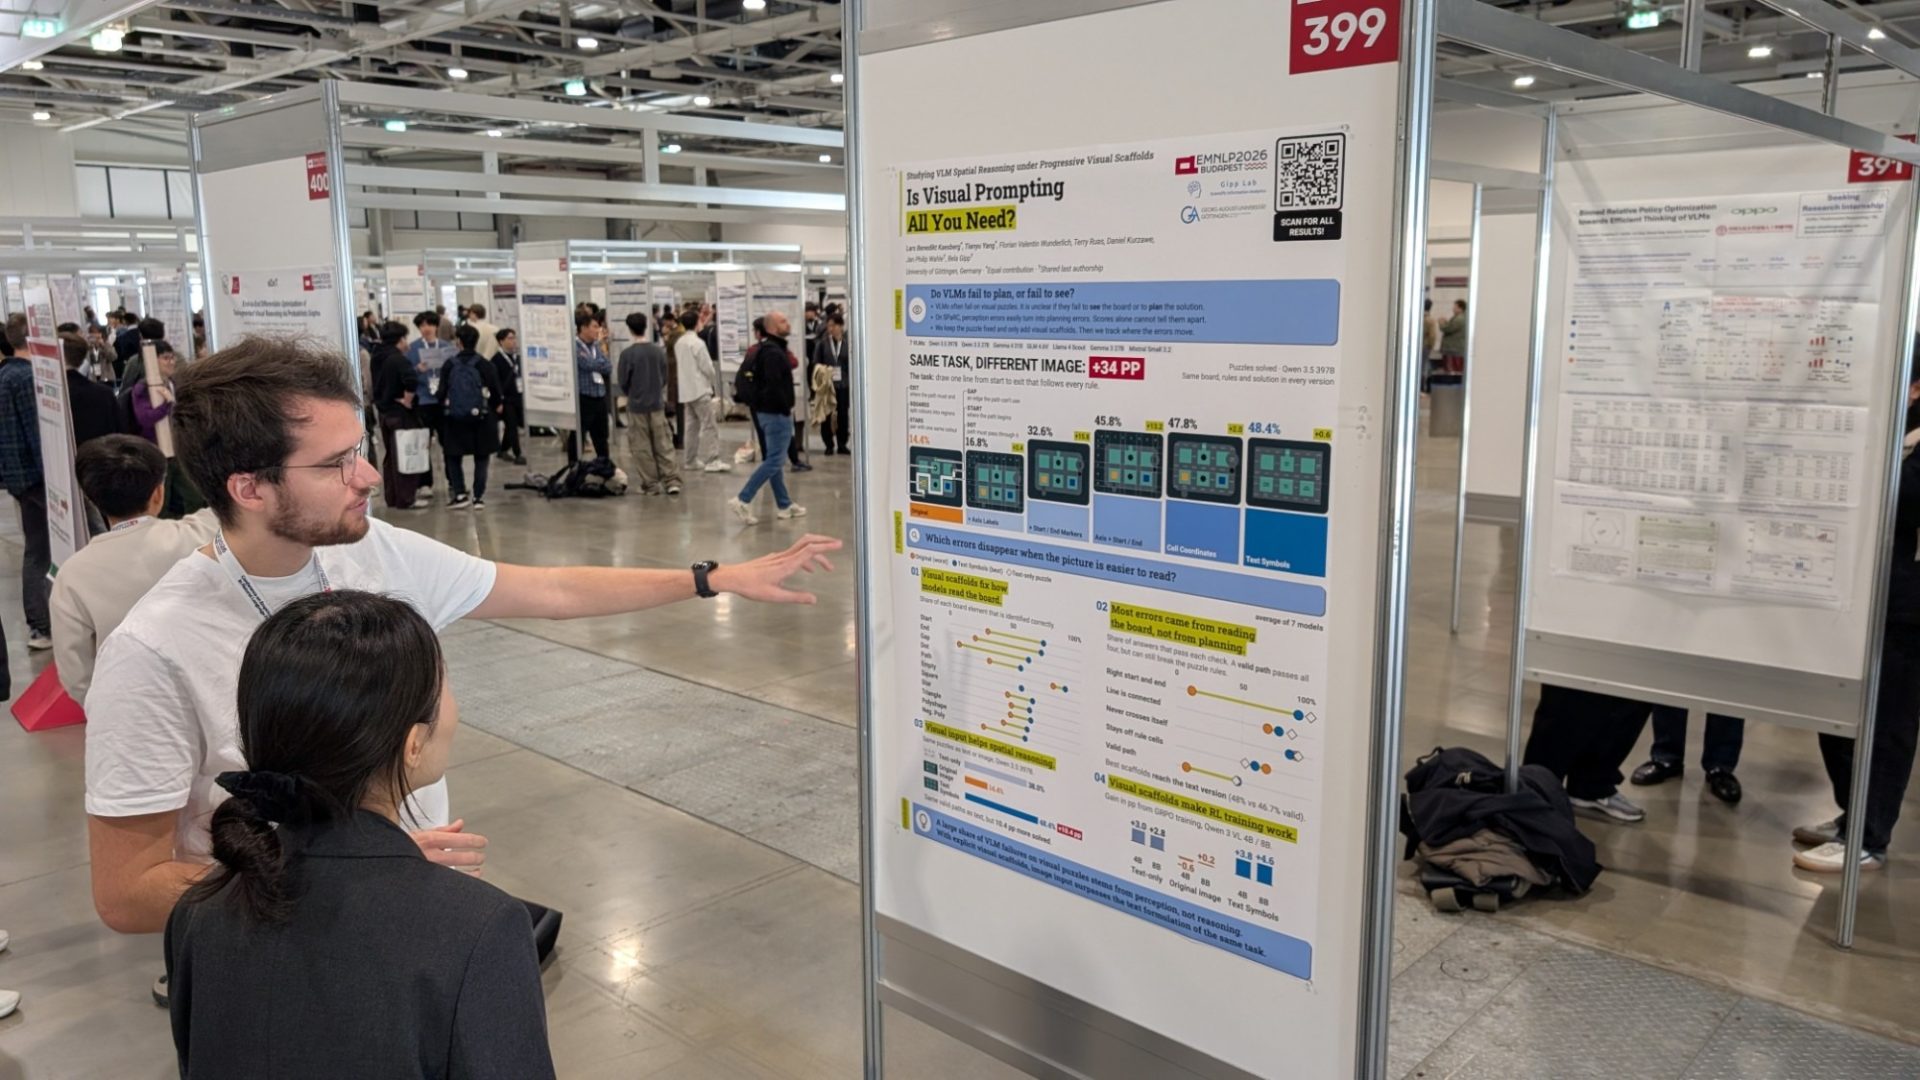
Nghiên cứu tại EMNLP 2026 cho thấy các mô hình thị giác - ngôn ngữ thường thất bại ngay từ bước nhìn thấy hình ảnh trước khi bắt đầu suy luận. Thay vì tinh chỉnh câu lệnh, việc gắn nhãn đúng những gì mô hình không đọc được trên hình ảnh có thể cải thiện độ chính xác lên tới 34 điểm phần trăm.
Sửa hình ảnh, không phải câu lệnh: Khi mô hình AI "nhìn sai" trước khi "suy luận sai"
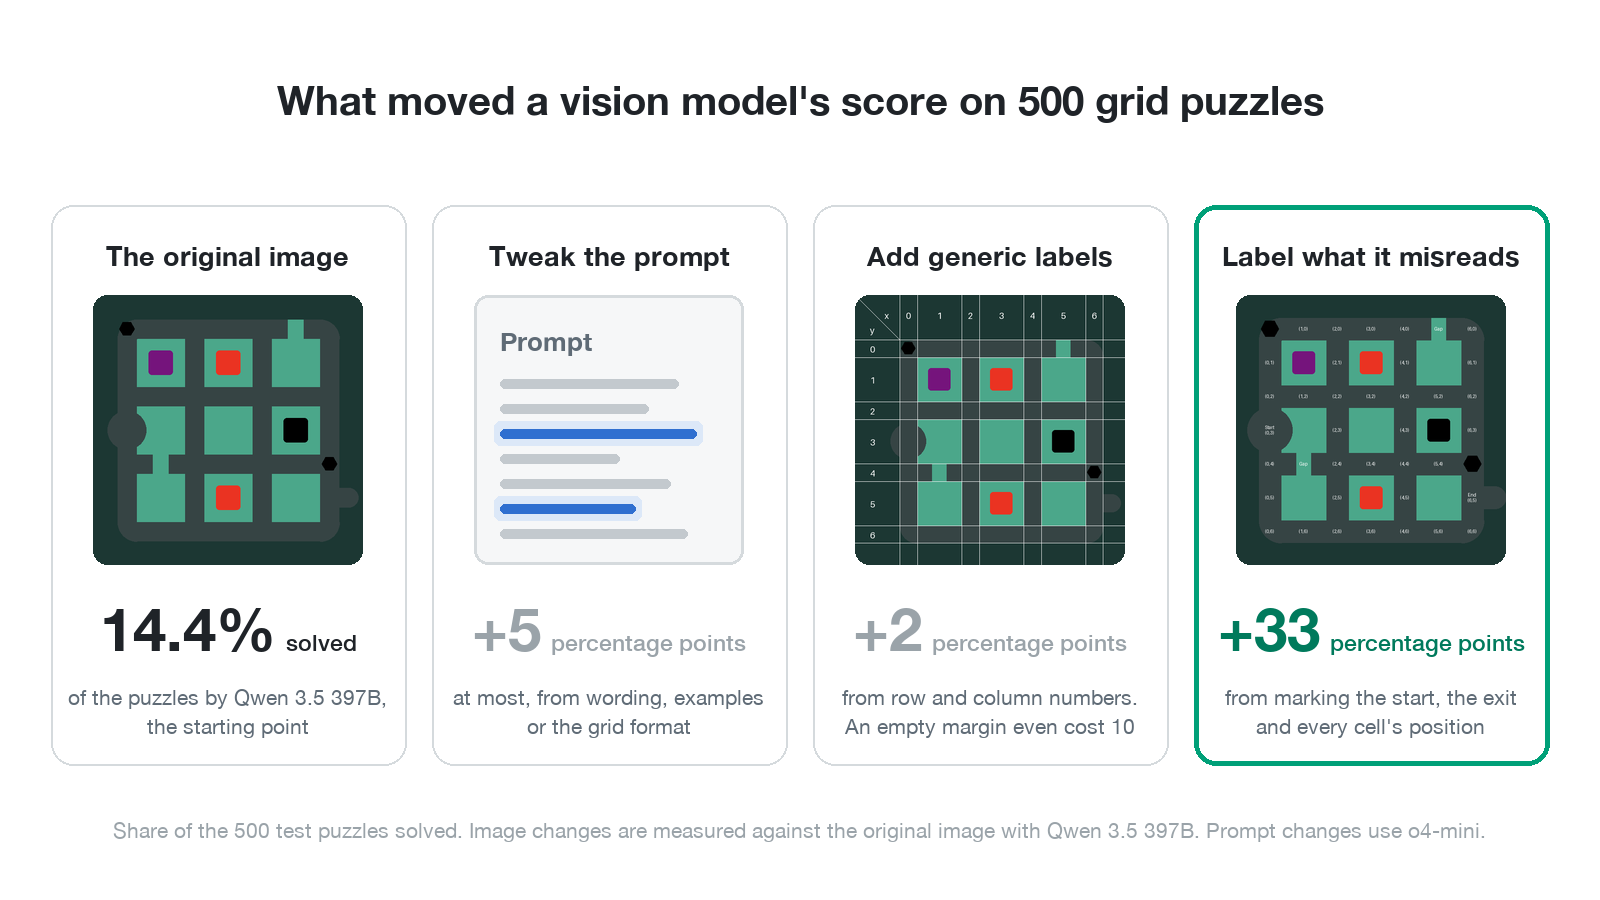
Tóm tắt: Tại hội nghị EMNLP 2026 ở Budapest, một nghiên cứu về mô hình thị giác - ngôn ngữ (VLM) đặt ra câu hỏi: khi mô hình thất bại với một bài toán hình ảnh, liệu nó đã suy luận sai hay chỉ đơn giản là không nhìn thấy đúng? Kết quả cho thấy thay đổi cách vẽ hình ảnh có thể cải thiện độ chính xác lên tới 34 điểm phần trăm, trong khi tinh chỉnh câu lệnh chỉ tạo ra khác biệt tối đa khoảng 5 điểm phần trăm.
 Minh họa mô hình thị giác - ngôn ngữ
Vấn đề: Câu lệnh hay hình ảnh?
Phản xạ quen thuộc khi một mô hình AI làm sai bài toán hình ảnh là viết lại câu lệnh. Bạn thay đổi cách diễn đạt, thêm ví dụ mẫu, hoặc điều chỉnh định dạng đầu ra. Nhưng kết quả nghiên cứu từ nhóm tác giả tại Đại học Göttingen (Đức) cho thấy với dữ liệu đầu vào là hình ảnh, đây thường là hướng đi sai.
Điều thực sự hiệu quả là gắn nhãn đúng những chi tiết mà mô hình không nhìn thấy được, và diễn đạt chúng bằng chính ngôn ngữ mà bài toán sử dụng. Tuy nhiên, việc chất thêm thật nhiều văn bản lên ảnh cũng không giúp ích gì.
"Khi mô hình thất bại, câu hỏi thực tế không phải là 'nên sửa câu lệnh thế nào', mà là 'mô hình đã nhìn thấy gì?'" — nhận định từ nghiên cứu.
Bối cảnh: Bộ dữ liệu SPaRC
Nhóm nghiên cứu sử dụng SPaRC — bộ chuẩn gồm 1.000 câu đố lưới lấy cảm hứng từ trò chơi điện tử The Witness. Nhiệm vụ của mô hình là vẽ một đường đi từ điểm xuất phát đến lối ra, tuân thủ mọi quy tắc trên bảng, và viết đáp án dưới dạng danh sách tọa độ (x, y). Các con số dưới đây đều được tính trên 500 câu đố kiểm thử.
Nghiên cứu gồm hai giai đoạn: bài báo đầu tiên (EMNLP 2025) đưa câu đố cho mô hình o4-mini dưới dạng văn bản và thử nhiều biến thể câu lệnh. Nghiên cứu tiếp theo (Findings of EMNLP 2026) giữ nguyên câu đố nhưng chỉ thay đổi cách vẽ hình, thử nghiệm trên bảy mô hình VLM mã nguồn mở.
Thay đổi văn bản: Khác biệt không đáng kể
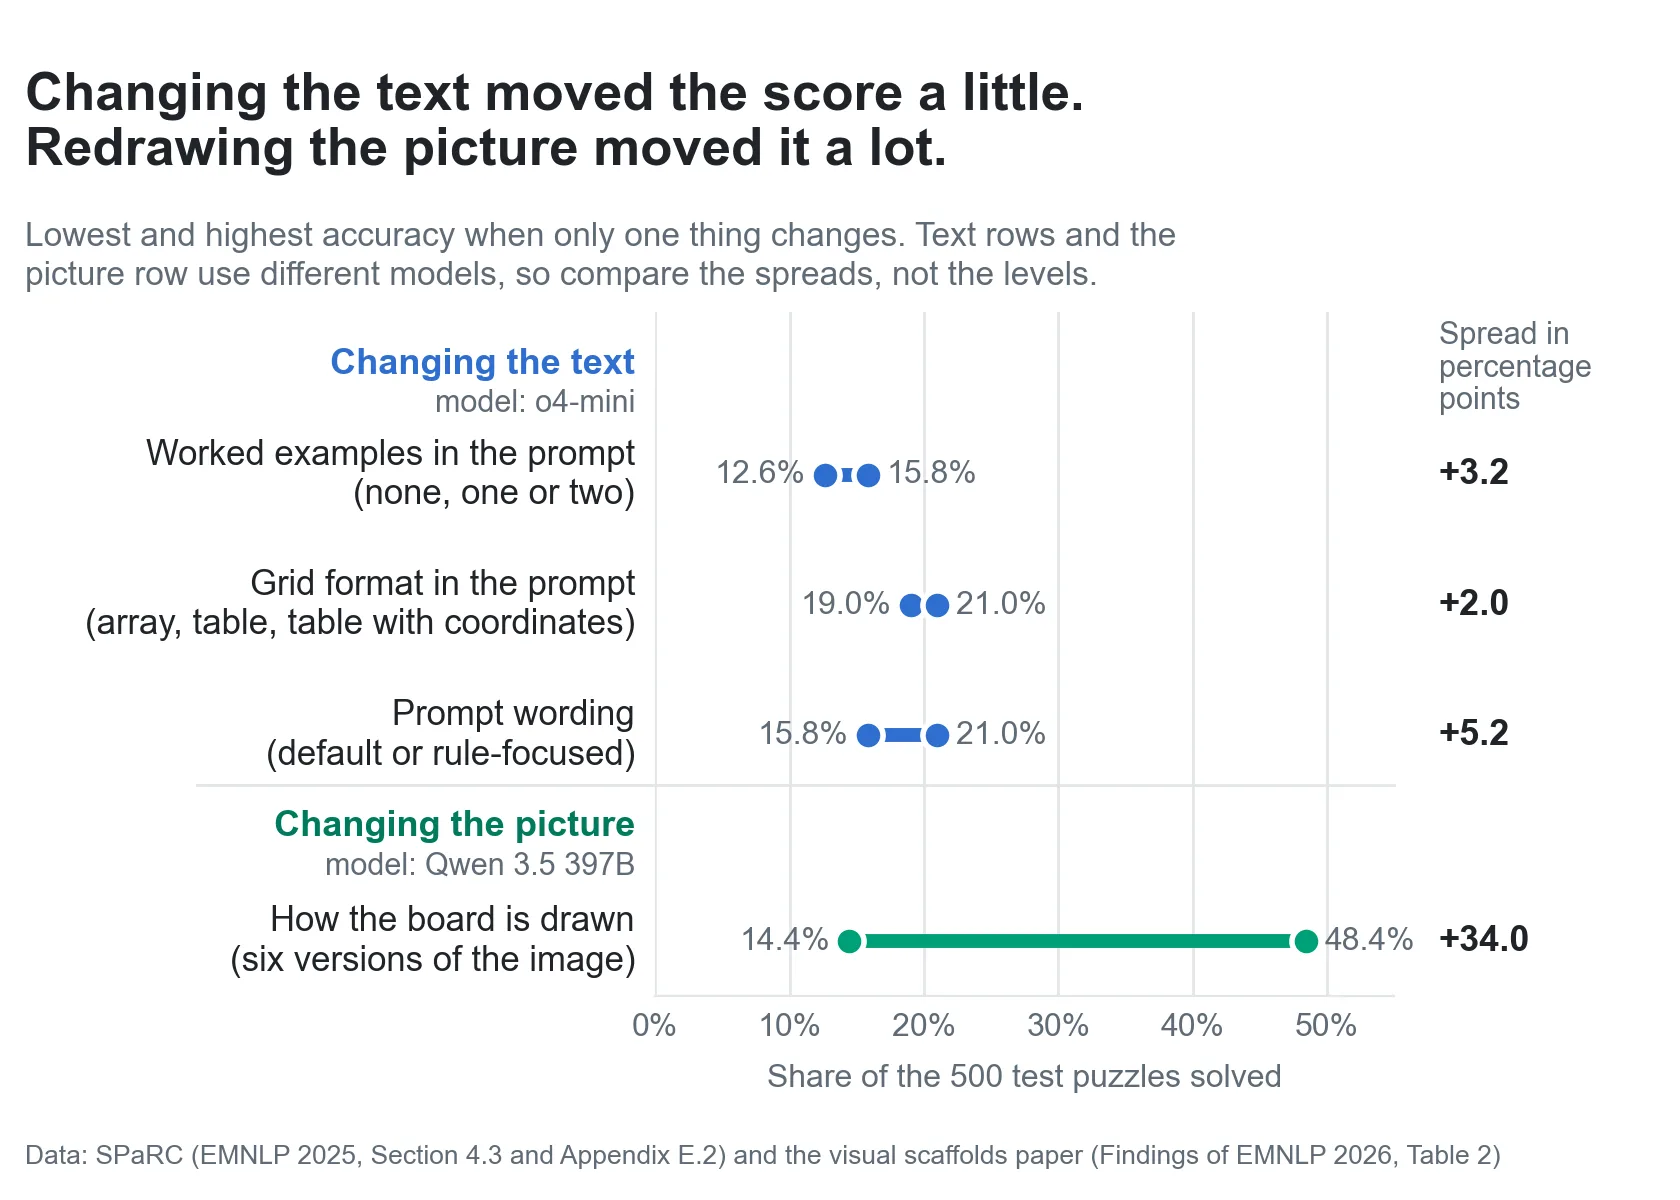
Khi nhóm nghiên cứu thay đổi câu lệnh văn bản theo ba cách, độ chính xác của o4-mini chỉ dao động trong khoảng hẹp:
- Ví dụ mẫu: Không có ví dụ, một ví dụ và hai ví dụ lần lượt cho kết quả 12,6%, 15,8% và 14,8%.
- Định dạng lưới: Viết dưới dạng mảng, dạng bảng, hoặc bảng có tọa độ cho kết quả 21,0%, 19,0% và 20,8%.
- Từ ngữ câu lệnh: Một câu lệnh nhấn mạnh các quy tắc đường đi đã nâng độ chính xác từ 15,8% lên 21,0%.
Mức thay đổi lớn nhất chỉ là 5,2 điểm phần trăm. Kết luận khi đó là điểm số thấp đến từ năng lực suy luận không gian còn hạn chế, chứ không phải từ câu lệnh hay định dạng.
Thay đổi hình ảnh: Khác biệt lớn
Câu chuyện hoàn toàn khác khi thay đổi hình ảnh. Khi cho o4-mini xem ảnh chụp màn hình câu đố thay vì lưới văn bản, độ chính xác giảm từ 12,6% xuống còn 5,6%. Chỉ riêng việc chuyển sang hình ảnh đã làm mất hơn một nửa điểm số.
Trong nghiên cứu tiếp theo, câu đố, quy tắc và đáp án không đổi — chỉ cách vẽ thay đổi:
- Qwen 3.5 397B: Từ 14,4% (ảnh gốc) lên 48,4% (phiên bản tốt nhất).
- Qwen 3.5 27B: Từ 8,2% lên 40,0%.
- Gemma 4 31B: Từ 2,2% lên 26,2%.
 So sánh độ chính xác khi thay đổi hình ảnh
Không phải cứ thêm nhãn là tốt hơn
Kết quả cho thấy một số chú thích giúp ích rất nhiều, một số gần như vô tác dụng, và một số còn làm mọi thứ tệ đi. Khác biệt nằm ở chỗ liệu chú thích đó có khắc phục đúng lỗi mô hình mắc phải hay không.
Khi yêu cầu các mô hình đọc bảng từng ô một (không cần giải), trên ảnh gốc, Qwen 3.5 397B chỉ xác định đúng lối ra 48% số lần và điểm xuất phát 69% số lần — trong khi nhiệm vụ chính là vẽ đường đi từ điểm xuất phát đến lối ra.
Cụ thể các phương án chú thích:
- Hai chữ cái S và E trên điểm xuất phát và lối ra: nâng Qwen 3.5 397B từ 14,4% lên 32,6% — hơn gấp đôi điểm số chỉ nhờ hai nhãn nhỏ.
- Số hàng và số cột dọc theo mép bảng (như bảng tính): chỉ đạt 16,8%, và với năm trong bảy mô hình còn kém hiệu quả hơn cả hai chữ cái. Với Qwen 3.5 27B, độ chính xác khi đọc ký hiệu trên bảng thậm chí giảm từ 58,3% xuống 42,0%.
- Chỉ vẽ đường kẻ lưới: Thay đổi độ chính xác từ 0,2 đến 2,6 điểm phần trăm.
- Đường kẻ lưới kèm lề trống: Khiến mọi mô hình được thử đều tệ hơn — Qwen 3.5 397B giảm từ 14,4% xuống 4,4%.
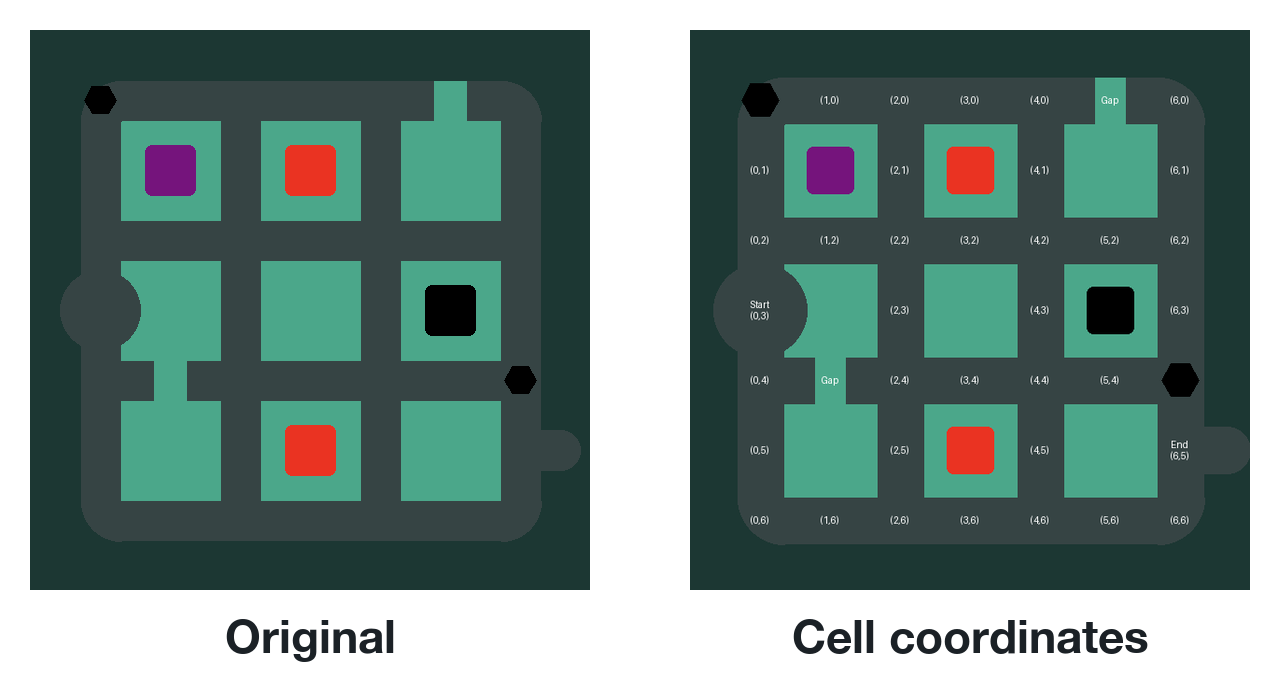
- Tọa độ in trong mỗi ô: Đạt 47,8% — mỗi ô hiển thị vị trí của nó đúng theo định dạng mà đáp án yêu cầu.
- Thay mọi ký hiệu bằng từ ngữ kèm tọa độ: đạt 48,4%, gần như không cải thiện thêm.
Vì sao việc gắn hình với nhiệm vụ lại quan trọng
Đáp án là một danh sách tọa độ, trong khi ảnh gốc không hề hiển thị tọa độ nào. Trước khi lập kế hoạch, mô hình phải tự đếm hàng và cột — và chính bước này là nguồn gốc của phần lớn vấn đề.
Nhìn vào chỗ đáp án sai có thể thấy rõ điều này. Trung bình trên cả bảy mô hình, chỉ 11,8% đáp án trên ảnh gốc bắt đầu và kết thúc đúng ô. Khi in tọa độ hoặc nhãn từ ngữ lên bảng, con số này tăng lên khoảng 90%.
Điều này cho thấy hình ảnh cần "nói cùng ngôn ngữ" với câu lệnh và đáp án. Trong phiên bản văn bản, mỗi ô đã tự động có vị trí vì nó nằm ở hàng và cột cố định — có thể đó là lý do định dạng gần như không quan trọng. Còn ảnh thông thường đánh mất thông tin này và buộc mô hình phải tái tạo lại từ điểm ảnh.
 Hai cách vẽ cùng một câu đố
Gợi ý áp dụng thực tế
Nếu bạn đang làm việc với mô hình thị giác cho nhiệm vụ tương tự, đây là thứ tự nên thử:
- Yêu cầu mô hình mô tả hình ảnh trước. Kiểm tra xem nó đọc sai ở đâu trước khi cố gắng sửa bất cứ điều gì.
- Gắn nhãn đúng những phần đó, bằng chính từ ngữ mà câu lệnh sử dụng (điểm xuất phát, lối ra, tọa độ).
- Đừng gắn nhãn mọi thứ. Chú thích thừa có thể làm hình rối và khó đọc hơn.
- Tinh chỉnh câu lệnh sau cùng. Trong nghiên cứu này, đây là đòn bẩy nhỏ nhất.
- Khi xây dựng bộ chuẩn hình ảnh, hãy báo cáo thêm một phiên bản có nhãn bên cạnh phiên bản gốc để biết điểm số đang đo khả năng "nhìn" hay "nghĩ".
Những giới hạn cần lưu ý
Đây chỉ là một nhiệm vụ. Câu đố lưới có cấu trúc xác định, và các chú thích trong nghiên cứu dựa trên cấu trúc đó — vì vậy chúng hoạt động như công cụ chẩn đoán, không phải mẹo đặt câu lệnh phổ quát.
Các thử nghiệm văn bản và hình ảnh dùng mô hình khác nhau (o4-mini và các mô hình mở), nên nhóm nghiên cứu so sánh mức độ dịch chuyển của điểm số chứ không so sánh điểm tuyệt đối. Ngoài ra, định dạng văn bản có thể tác động rất lớn ở các nhiệm vụ khác — nghiên cứu của Sclar và cộng sự (ICLR 2024) ghi nhận chênh lệch tới 76 điểm phần trăm chỉ từ thay đổi định dạng với LLaMA-2-13B.
Quan trọng hơn, một hình vẽ tốt hơn không khắc phục được suy luận yếu. Kết quả cao nhất là 48,4%, trong khi con người giải được 98% câu đố từ phiên bản văn bản. Việc vi phạm quy tắc câu đố vẫn là lỗi phổ biến dưới mọi cách vẽ được thử.
Kết luận
Ba điểm chính từ nghiên cứu:
- Trên SPaRC, thay đổi câu lệnh văn bản chỉ làm o4-mini dịch chuyển tối đa 5,2 điểm phần trăm.
- Thay đổi cách vẽ hình làm Qwen 3.5 397B dịch chuyển 34,0 điểm phần trăm, dù câu đố và đáp án không đổi.
- Nhiều nhãn hơn không đồng nghĩa với kết quả tốt hơn. Hai chữ cái đúng chỗ giúp tăng hơn gấp đôi điểm, trong khi số hàng cột hầu như không giúp gì và lề trống còn làm giảm hai phần ba điểm số.
Với các nhiệm vụ hình ảnh, hãy kiểm tra xem mô hình thực sự nhìn thấy gì trước khi tinh chỉnh câu lệnh. Bạn có thể tự thử các câu đố tại sparc.gipplab.org.


