
Cách hoạt động của các probe trong Kubernetes
Bài viết của ngrok giải thích chi tiết ba loại probe trong Kubernetes (startup, readiness, liveness), cách chúng phối hợp để tránh vòng lặp khởi động lại và mất request khi triển khai. Tác giả còn tìm ra một lỗi thực tế trong Kubernetes v1.35.0 khiến liveness probe chạy quá sớm.
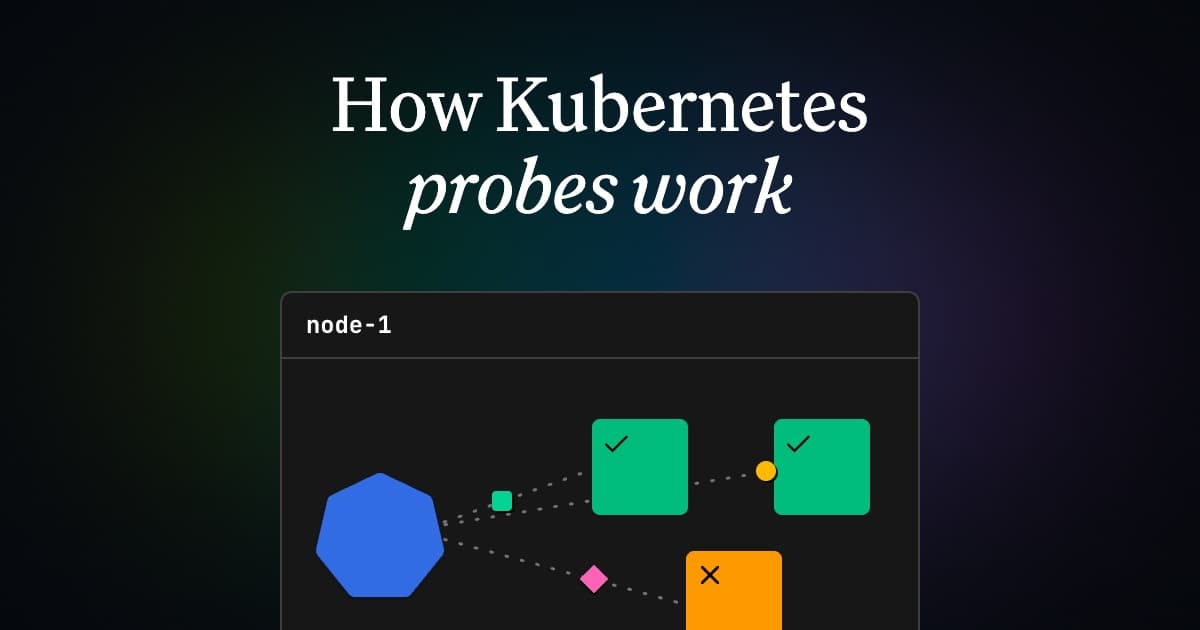
Kubernetes cung cấp ba loại probe để kiểm tra sức khỏe container. Dùng sai cách, chúng gây ra vòng lặp khởi động lại hoặc làm rơi request khi triển khai phiên bản mới.
Bài viết của ngrok dựng lại toàn bộ cơ chế này bằng một cụm giả lập chạy trong trình duyệt, tên là webernetes, một bản chuyển một phần mã Go của Kubernetes sang TypeScript với hơn 100.000 dòng. Tác giả đã đối chiếu hành vi với k3s và phát hiện một lỗi trong Kubernetes.
Ba loại probe
- Startup probe: xác định ứng dụng trong container đã khởi động xong chưa.
- Readiness probe: xác định ứng dụng đã sẵn sàng nhận lưu lượng chưa.
- Liveness probe: xác định container có cần khởi động lại không.
Khi chưa có probe, Kubernetes coi container là Ready ngay khi nó vừa chạy. Nhưng ứng dụng cần vài giây khởi tạo trước khi lắng nghe trên cổng 8080, nên mọi request trong khoảng thời gian đó đều thất bại.
Sau lần crash đầu, container được khởi động lại ngay. Từ lần thứ hai, Kubernetes áp CrashLoopBackOff, mặc định chờ 10 giây và tăng gấp đôi sau mỗi lần crash, tối đa 5 phút.
Startup probe
Một startup probe dạng httpGet gửi request GET /startup tới cổng 8080. Mã trạng thái 200 đến 399 được tính là thành công. Probe chạy mỗi periodSeconds giây và được phép thất bại failureThreshold lần liên tiếp trước khi kubelet giết container.
Ngoài httpGet, Kubernetes còn hỗ trợ tcpSocket, exec và grpc.
Probe do kubelet gửi đi. Mỗi node trong cụm có một kubelet riêng, chịu trách nhiệm đảm bảo đúng pod đang chạy và được kiểm tra trên node đó.
Khi có startup probe, pod ở trạng thái NotReady cho tới khi probe đầu tiên thành công. Tuy nhiên nếu client gửi request thẳng vào IP của pod, readiness không có tác dụng.
Để khắc phục, cần một ReplicaSet chạy 2 bản sao của pod và một Service cân bằng tải giữa chúng. Kubernetes dựa vào điều kiện Ready của pod để đưa pod vào hoặc loại khỏi danh sách cân bằng tải.
Xóa pod thay vì crash
Nếu container bị crash đột ngột, request đang xử lý dở sẽ thất bại. Cách tốt hơn là xóa pod và để ReplicaSet tạo pod mới, vì hai lý do:
- Pod bị xóa được coi là đang kết thúc, bị gỡ khỏi mọi Service và không nhận request mới. Mặc định Kubernetes cho pod 30 giây ân hạn để kết thúc.
- ReplicaSet không tính pod đang kết thúc vào số bản sao đang hoạt động, nên tạo pod thay thế ngay lập tức.
Khi xóa pod, kubelet gửi tín hiệu SIGTERM cho container trước, rồi gửi SIGKILL sau khi hết thời gian ân hạn.
Cấu hình sai startup probe
Nếu đặt failureThreshold quá thấp, container không kịp khởi động và rơi vào CrashLoopBackOff. Cần chọn giá trị đủ cho thời gian khởi động trong trường hợp xấu nhất.
Readiness probe
Readiness probe chạy suốt vòng đời container sau khi startup probe thành công. Khi thất bại, container bị đánh dấu NotReady và rời khỏi mọi Service.
Mặc định successThreshold là 1 và failureThreshold là 3. Tác giả khuyên không đổi trừ khi có lý do rõ ràng.
Khi container ở trạng thái NotReady, readiness probe có thể được gửi ngoài chu kỳ periodSeconds để pod nhanh sẵn sàng hơn. Tài liệu Kubernetes mô tả điều này khá mơ hồ, còn tác giả ghi nhận nhiều thay đổi trạng thái hoặc chú thích trên pod đều có thể kích hoạt probe ngoài chu kỳ.
Vì sao cần cả startup và readiness probe?
Readiness probe một mình có thể thay thế startup probe trong nhiều trường hợp. Nhưng startup probe có lợi thế riêng:
- Hoãn cả readiness và liveness cho tới khi quá trình khởi tạo xong.
- Cho phép đặt chu kỳ và ngưỡng thất bại riêng, nên có thể kiểm tra dày hơn khi khởi động và thưa hơn khi ổn định.
- Thất bại nhiều lần sẽ giết container và áp dụng chính sách khởi động lại, điều mà readiness probe không làm được.
Có thể dùng nhiều probe cùng lúc, ví dụ startup probe mỗi 1 giây và readiness probe mỗi 5 giây.
Liveness probe
Liveness probe hoạt động giống readiness probe, nhưng khi đạt ngưỡng thất bại thì giết container thay vì chỉ đánh dấu NotReady. Kubernetes sau đó áp dụng restartPolicy, mặc định là "Always".
Probe này hữu ích khi container không thể tự phục hồi, chẳng hạn luồng chính bị deadlock hoặc một luồng nền quan trọng đã chết.
Lỗi trong Kubernetes
Tác giả phát hiện một lỗi thực tế khi làm bài viết. Khi endpoint /live trả về 503, trình tự xảy ra như sau:
- Liveness probe thất bại.
- Kubelet khởi động lại container.
- Trước khi startup probe kịp chạy, một liveness probe được gửi và thất bại vì container còn đang khởi tạo.
- Kubelet khởi động lại container lần nữa, trước khi nó kịp vượt qua startup probe.
Liveness probe không nên chạy trước khi startup probe thành công. Tác giả tái hiện lỗi trên k3s, minikube và kind với Kubernetes v1.36.2. Lỗi có vẻ xuất hiện từ v1.35.0. Một issue đã được mở và nhóm SIG Node chấp nhận, đánh dấu priority/important-soon.
Cấu hình sai liveness probe
Không nên để liveness probe kiểm tra sức khỏe cơ sở dữ liệu. Chỉ cần cơ sở dữ liệu chập chờn đủ lâu, toàn bộ container sẽ rơi vào CrashLoopBackOff.
Vấn đề tệ hơn khi client thử lại nhiều lần. Nếu container chỉ chịu được 3 request mỗi giây, lượng thử lại dồn dập tạo ra thundering herd, gây lỗi dây chuyền. Container vừa hồi phục đã bị dòng lưu lượng đánh sập trở lại.
Probe không giải quyết được tình huống này. Cần cơ chế chỉ cho một phần nhỏ lưu lượng đi qua để container hồi phục, rồi tăng dần. Hoặc nếu kiểm soát được client, thêm độ trễ lùi cho các lần thử lại.
Cách tốt nhất là tránh sai lầm ngay từ đầu: chỉ cho liveness probe thất bại khi lỗi cục bộ ở một container và khởi động lại có khả năng khắc phục.
Probe và Deployment
Phần lớn thông số của pod là bất biến. Muốn thay đổi, phải tạo pod mới và xóa pod cũ, gọi là rollout.
Với maxUnavailable: "25%" và maxSurge: "25%" trên Deployment 3 bản sao, rollout phải giữ đủ 3 pod Ready và được phép có thêm 1 pod, tức tối đa 4 pod.
Rollout chỉ tạo thêm 1 pod và phải chờ pod đó Ready trước khi xóa pod cũ. Vì vậy probe ảnh hưởng trực tiếp tới tốc độ triển khai. Với periodSeconds: 1, rollout mất khoảng 11 giây. Đổi sang periodSeconds: 5, thời gian tăng lên khoảng 19 đến 20 giây.
Nếu không có probe, rollout diễn ra rất nhanh nhưng một số request sẽ thất bại vì container chưa khởi tạo xong.
Lời khuyên thiết kế endpoint probe
Startup: dùng khi quá trình khởi động chậm hoặc thay đổi, hoặc có bước khởi tạo có thể bị treo và cần khởi động lại. Đặt periodSeconds thấp thì phải tăng failureThreshold để giữ tổng thời gian chờ.
Readiness: giữ probe rẻ và thận trọng. Không nên cho thất bại dựa trên trạng thái của các phụ thuộc dùng chung như cơ sở dữ liệu hay API bên thứ ba. Cũng không nên thất bại khi CPU hoặc bộ nhớ cao, vì gỡ một bản sao lúc hệ thống gần đầy tải có thể gây lỗi dây chuyền.
Liveness: chỉ cho thất bại khi chắc chắn container bị treo và khởi động lại sẽ giúp ích. Nếu không chắc, trả về thành công.
Chung: probe phải có giới hạn và rẻ. failureThreshold mặc định là 3, chỉ hạ thấp khi việc can thiệp ngay đáng để chấp nhận rủi ro phản ứng với một lỗi tạm thời.
Góc nhìn
Với các nhóm kỹ sư vận hành Kubernetes tại Việt Nam, bài viết là lời nhắc rằng probe không phải thủ tục cho có. Một container chưa có probe sẽ nhận lưu lượng ngay khi khởi động, và một rollout không probe có thể làm rơi request của người dùng thật.
Lỗi liveness probe chạy trước startup probe cho thấy các bản Kubernetes mới có thể có hành vi chưa đúng. Nhóm nào đang chạy v1.35 hoặc mới hơn nên kiểm tra lại cấu hình liveness, nhất là khi kết hợp với startup probe.
Nguyên tắc thực dụng: giữ readiness probe rẻ và không phụ thuộc vào dịch vụ dùng chung, chỉ dùng liveness probe cho lỗi cục bộ ở một container. Chỉnh periodSeconds và failureThreshold theo thời gian khởi động thực tế sẽ giúp rollout nhanh hơn mà không mất request.
Nguồn: ngrok.com (bài gốc ngày 19 tháng 8, 2026) · Quy trình biên tập
Bài viết liên quan
Cloud & DevOps
Phân biệt Liveness, Readiness và Startup Probes trong kiểm tra sức khỏe dịch vụ
07 tháng 4, 2026
Công nghệ
Những bài học từ các buổi phỏng vấn về sự thống trị của Kubernetes
16 tháng 6, 2026
Phần mềm
Xử lý Node.js Cluster Một Cách An Toàn: Tắt Nhóm Graceful, Khắc Phục Vấn Đề Windows và Kiểm Thử Black-Box
07 tháng 4, 2026