
DeepSeek V3 viết lại bằng 190 dòng JAX thuần
Một lập trình viên đã tái hiện kiến trúc DeepSeek-V3 chỉ trong 190 dòng JAX thuần, không dùng Flax, Equinox hay PyTorch, và huấn luyện từ đầu trên một chiếc MacBook Air. Bản thử nghiệm 36,2 triệu tham số cho thấy các ý tưởng cốt lõi của mô hình khổng lồ 671 tỷ tham số có thể chạy được trên phần cứng phổ thông.
Một dự án mã nguồn mở trên GitHub vừa đưa toàn bộ kiến trúc trong báo cáo kỹ thuật DeepSeek-V3 vào 190 dòng JAX thuần — không Flax, không Equinox, không PyTorch — và huấn luyện từ đầu trên một chiếc MacBook Air.
Điểm đáng chú ý không nằm ở chất lượng mô hình mà ở cách nó được viết: tham số là các dict thường chứa mảng, còn mỗi thành phần của mô hình là một hàm có thể đọc từ trên xuống dưới trong file deepseek_v3.py.
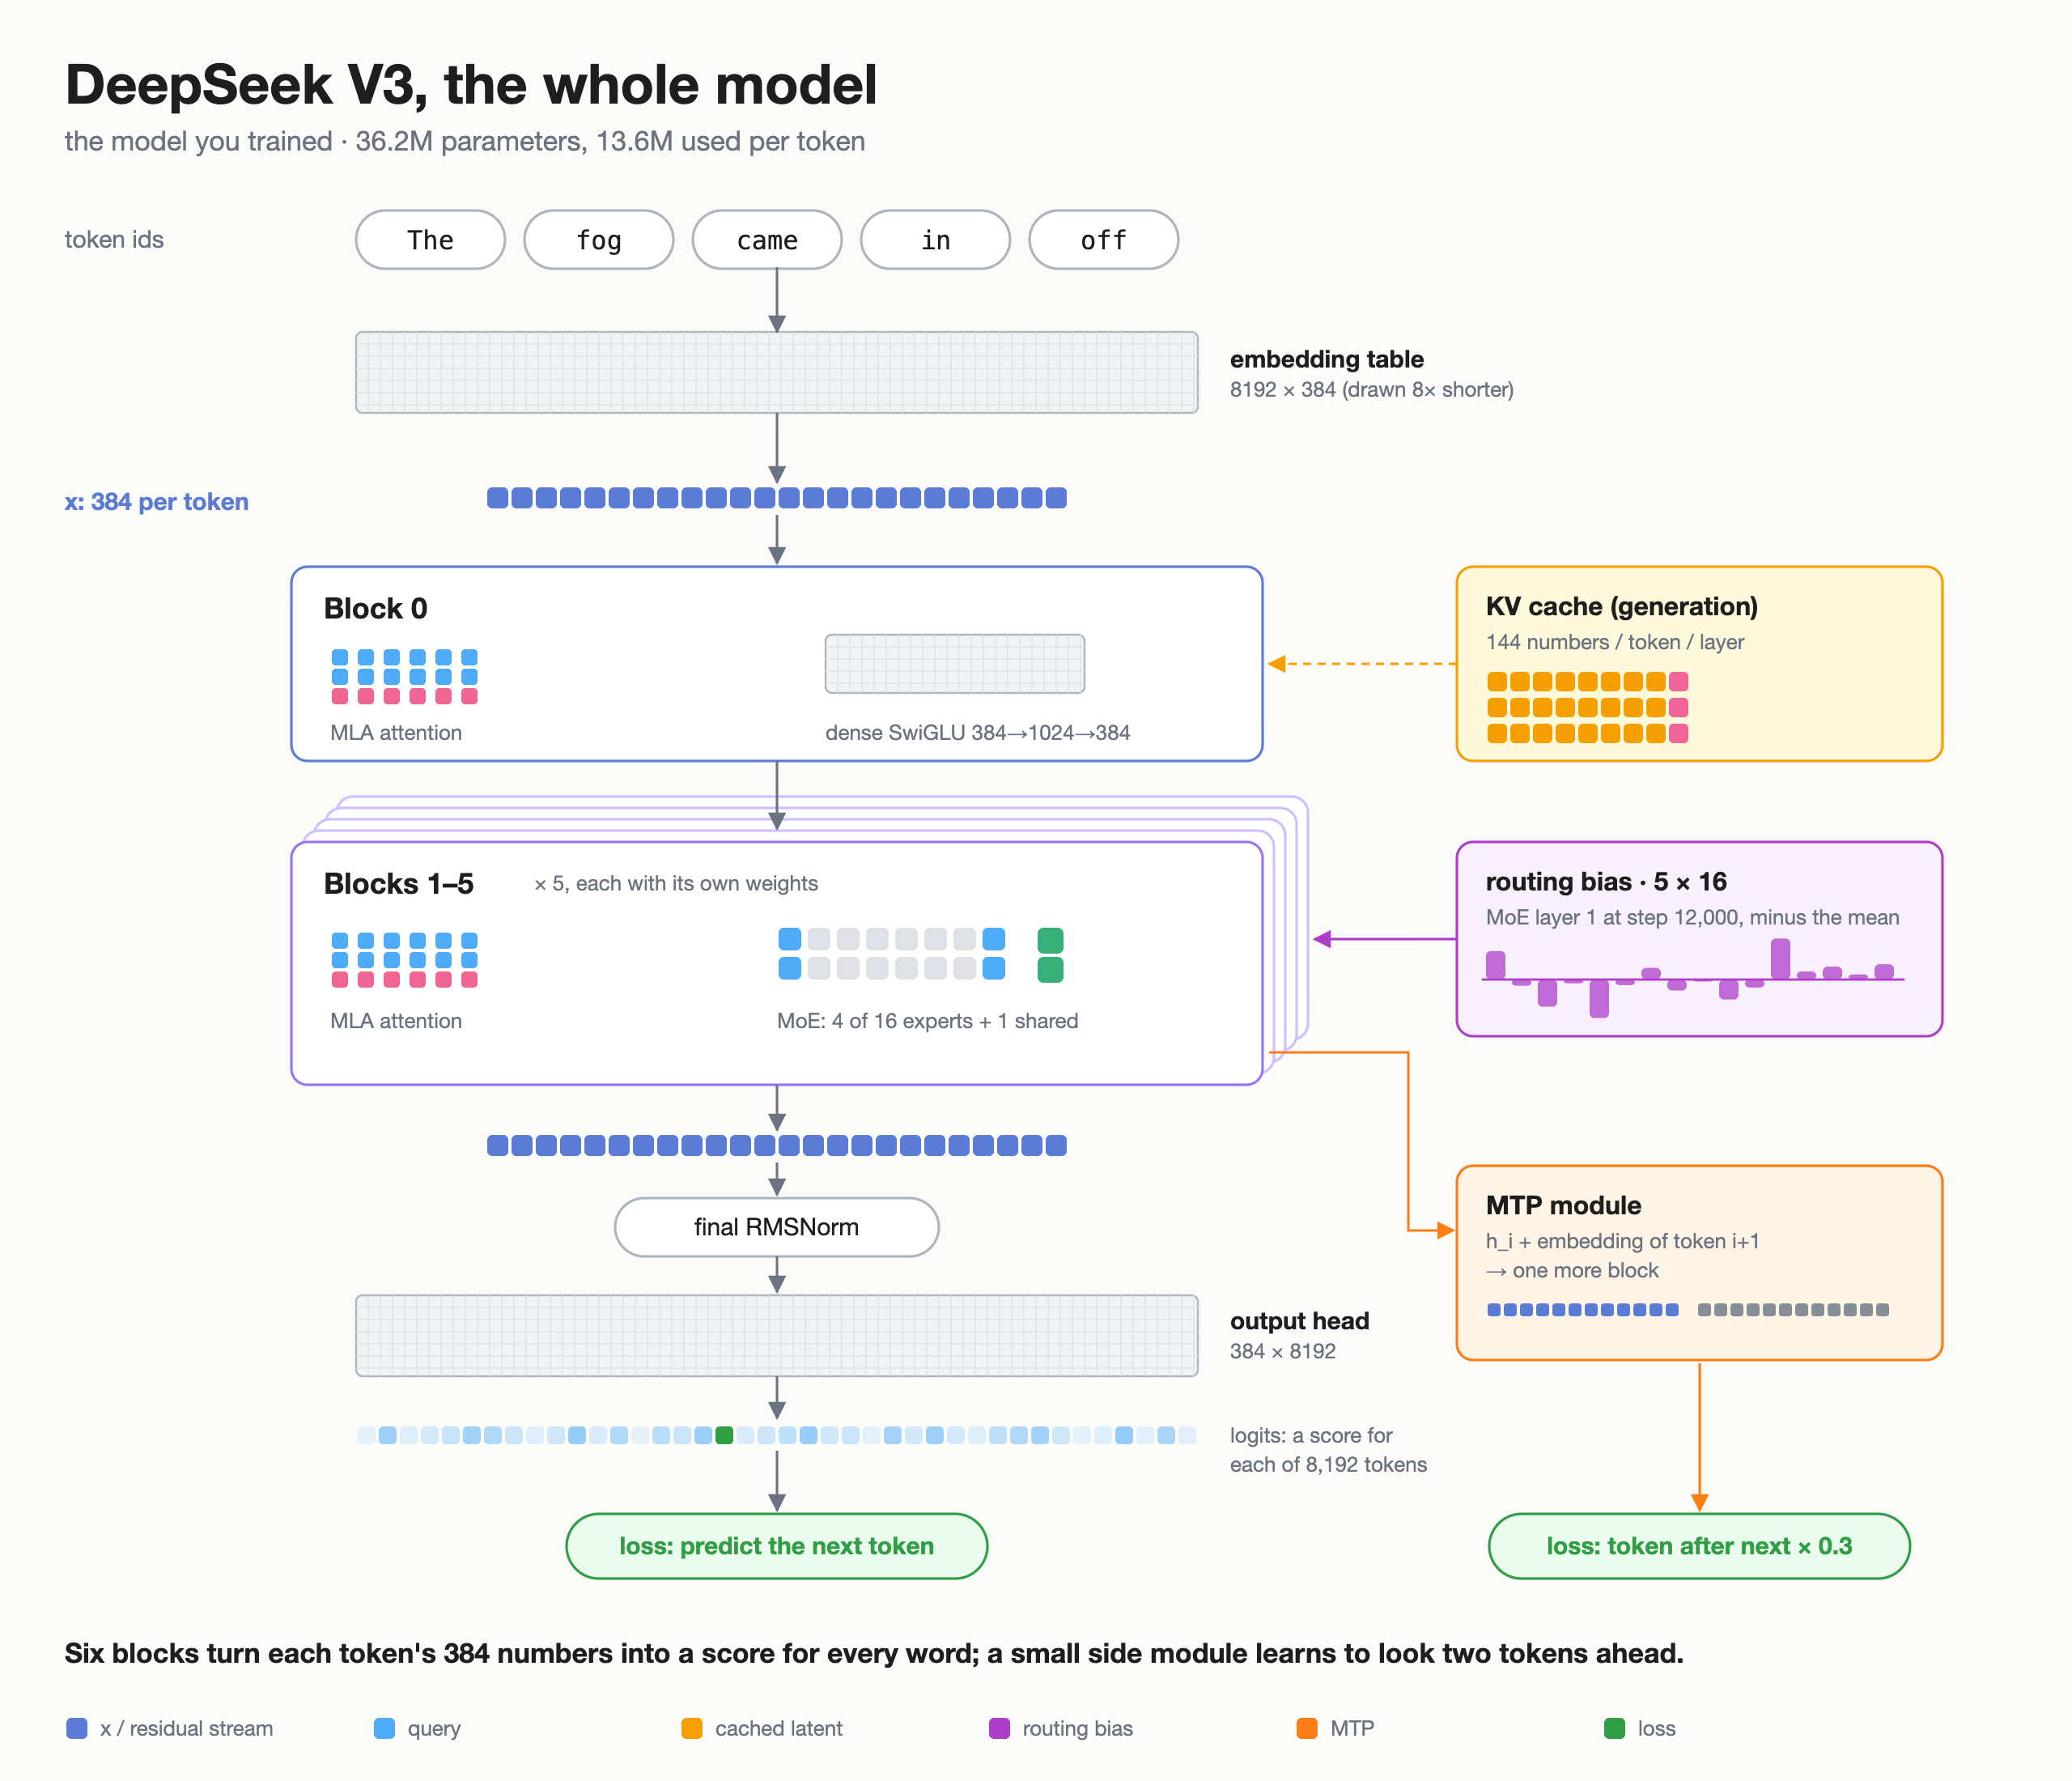 Sơ đồ tổng thể kiến trúc mô hình
Những gì có trong 190 dòng code
Bản tái hiện giữ lại các thành phần then chốt của kiến trúc DeepSeek-V3:
- Multi-head Latent Attention (MLA): thay vì lưu toàn bộ key và value, mỗi token chỉ cache một latent nhỏ — ở cấu hình này là từ 480 xuống còn 144 số mỗi token mỗi lớp.
- Decoupled RoPE: một key rotary dùng chung cho mọi head, được giữ bên ngoài latent đã nén.
- DeepSeekMoE: 1 expert chia sẻ luôn chạy cộng với 16 expert được định tuyến, mỗi token chọn top-4.
- Cân bằng không cần hàm phụ (auxiliary-loss-free balancing): một độ lệch (bias) riêng cho từng expert đẩy định tuyến về phía các expert đang rảnh; nó thay đổi expert nào được chọn chứ không đổi trọng số của expert.
- Sequence-wise balance loss: hàm loss bổ trợ nhỏ lấy từ báo cáo gốc, với α = 1e-4.
- Multi-token prediction (MTP): một module phụ dự đoán cả token kế tiếp của token kế tiếp, đóng góp với trọng số λ = 0.3 trong loss.
Phần huấn luyện và sinh văn bản tính toán bằng bf16 trên trọng số gốc f32, kèm chế độ prefill và decode dựa trên cache của MLA.
Kết quả chạy thử
Một lần chạy cấu hình mặc định trên MacBook Air M5 (24 GB) cho ra:
- Mô hình: 36,2 triệu tham số, 13,6 triệu tham số hoạt động mỗi token
- Dữ liệu: 207 cuốn sách, 21,7 triệu token huấn luyện (riêng Hammett lặp 3 lần); tập kiểm định là truyện trinh thám tách riêng
- Huấn luyện: 12.000 bước, khoảng 98 triệu token (~4,5 epoch), ~2,6 giờ
- Tốc độ: ~10,7 nghìn token/giây (trung vị)
- Validation loss: từ 5,02 (bước 250) xuống 3,51
Ở bước 2000, khi bật cơ chế cân bằng, tải của mỗi expert nằm trong khoảng 5,7–6,9% (mức đều lý tưởng là 6,25%); khi tắt, con số dao động từ 0,09% đến 18,6%. Đáng chú ý, validation loss ở bước 2000 gần như giống hệt nhau giữa hai trường hợp (3,921 so với 3,923) — đúng như tuyên bố trong báo cáo gốc: cơ chế bias san đều các expert mà không phải trả giá bằng chất lượng.
 Tải của các expert qua quá trình huấn luyện
Với prompt "The fog came in off the", mô hình tự sinh ra: "The fog came in off the bay, and the great trees were spreading and the stars were shining."
Tác giả nói rõ đây là bản demo kiến trúc, không phải một mô hình ngôn ngữ mạnh.
Cách chạy và tái lập
Bản phát hành v1.0 có sẵn checkpoint và dữ liệu của lần chạy đã công bố. Sau khi cài đặt, có thể tải checkpoint 138 MB và tokenizer rồi sinh văn bản bằng sample.py.
Để huấn luyện lại, cần một máy Mac chip Apple Silicon, Python 3.12 và uv. Lưu ý quan trọng: mọi phiên bản trong requirements.txt đều được ghim cố định, vì jax-metal 0.1.1 chỉ chạy với jax==0.4.34 — không nên nâng cấp JAX.
Quy trình gồm: chạy bộ test (pytest tests.py, 39 test), dựng dataset bằng prepare_data.py (tải 207 cuốn sách public domain, làm sạch, huấn luyện tokenizer BPE 8.192 token), huấn luyện với train.py, sinh văn bản với sample.py.
Một chi tiết thực tế: mã băm (hash) của dữ liệu khi bạn tự dựng sẽ khác với lần chạy đã công bố. Sách của Hammett được ghim vào đúng commit của Standard Ebooks nên giống hệt nhau, nhưng file từ Project Gutenberg không ghim được, và Gutenberg đã phát hành lại 28 trong số 203 cuốn với chỉnh sửa nhỏ (chủ yếu bỏ dấu, ví dụ "José" thành "Jose"). Số token vẫn như cũ nên quá trình huấn luyện được cho là vẫn tương đương. Muốn chạy trên đúng byte gốc thì tải thẳng dữ liệu từ bản phát hành v1.0.
Với máy không có GPU Apple, mọi thứ vẫn chạy trên CPU nhưng chậm hơn nhiều, nên cần dùng cấu hình nhỏ (--config small: 4 lớp, 8 expert, top-2, ngữ cảnh 128 token), phù hợp cả với máy Mac 8–16 GB.
Lưu ý an toàn: checkpoint là file pickle của Python và có thể thực thi mã khi nạp — chỉ nên tải từ nguồn tin cậy.
Những gì đã được đơn giản hóa
Tác giả liệt kê thẳng các điểm lược bớt:
- Tính toán MoE dạng dense: mọi expert đều chạy trên mọi token, các expert không được chọn thì bị đưa về 0. Phần toán định tuyến là chính xác, nhưng không có sparse dispatch hay expert parallelism.
- Không dùng weight absorption trong MLA: latent được giải nén tường minh, dễ đọc hơn nhưng chậm hơn khi suy luận.
- Không có: huấn luyện FP8, DualPipe, định tuyến giới hạn theo node, mở rộng ngữ cảnh YaRN và mọi bước hậu huấn luyện.
- Quy mô: 36,2 triệu tham số so với 671 tỷ, 6 lớp so với 61, ngữ cảnh 256 token so với 128K.
Toàn bộ văn bản huấn luyện đều thuộc phạm vi công cộng tại Mỹ, gồm các tác phẩm của Dashiell Hammett và khoảng 200 tiểu thuyết trinh thám từ Project Gutenberg; mọi nguồn đều được liệt kê trong sources.txt. Code phát hành theo giấy phép MIT.
Góc nhìn
Giá trị lớn nhất của dự án này nằm ở khía cạnh học tập và kiểm chứng. Một kiến trúc phức tạp như DeepSeek-V3 thường bị che khuất sau nhiều tầng framework, nên việc đưa nó về vài trăm dòng mã đọc được từ đầu đến cuối giúp kỹ sư Việt Nam hiểu rõ MLA, MoE và cơ chế cân bằng tải thực sự hoạt động ra sao — điều mà tài liệu API của các framework lớn hiếm khi làm được.
Về mặt thực dụng, đây không phải mô hình để thay thế các API lớn, nhưng là bộ khung để thử nghiệm ý tưởng kiến trúc với chi phí gần như bằng không: một chiếc laptop, vài giờ huấn luyện và dữ liệu công cộng. Với các nhóm đang nghiên cứu tối ưu suy luận hoặc tự xây mô hình nhỏ chuyên biệt, việc có một bản tham chiếu tối giản, kèm test và log đầy đủ, là điểm khởi đầu tiết kiệm hơn nhiều so với việc đọc báo cáo kỹ thuật rồi tự dựng lại từ đầu.
Nguồn: github.com (bài gốc ngày 14 tháng 11, 2026) · Quy trình biên tập
Bài viết liên quan
Phần mềm
DeepSeek V4.1 Flash 1017: Mô hình AI tiết kiệm chi phí cho tác tử và lập trình
17 tháng 10, 2026
Phần mềm
PROMETHEVS chạy DeepSeek-V4.1-Flash 510 GB trên PC 12 GB VRAM
06 tháng 11, 2026
Công nghệ
DeepSeek V4.1 Flash 1017 đạt 45 điểm trên Artificial Analysis: mô hình mở mạnh nhất phân khúc?
19 tháng 10, 2026