
Dự án smolmaxxing chạy LLM 16B trên TV box 2GB và iPad Air 2013
Dự án smolmaxxing của hyperionaidev đưa các mô hình ngôn ngữ lớn lên thiết bị cũ và yếu: Xiaomi TV Box S 2GB chạy mô hình 16B ở 5,1 tok/s, iPad Air 2013 chạy mô hình 1,7B ở 24-26 tok/s. Thành quả đến từ kernel NEON tùy chỉnh, nén 1-bit/ternary và cơ chế streaming trọng số từ bộ nhớ flash.
Một dự án mã nguồn mở có tên smolmaxxing đang chứng minh rằng những thiết bị tưởng như quá yếu vẫn có thể chạy mô hình ngôn ngữ lớn (LLM) ở tốc độ dùng được. Tác giả đo đạc trực tiếp trên hai thiết bị: một chiếc Xiaomi TV Box S (thế hệ 3) chỉ có 1,9 GB RAM và một chiếc iPad Air thế hệ đầu (2013) với 1 GB RAM.
Điểm đáng chú ý là mọi con số đều được đo trên chính phần cứng đó, không phải ước lượng lý thuyết. Trên TV box, mô hình hỗn hợp chuyên gia (MoE) 16B chạy được 5,1 tok/s, còn trên chiếc iPad 13 năm tuổi, mô hình 1,7B đạt 24-26 tok/s.
 Ảnh bìa dự án smolmaxxing
Hai thiết bị, hai giới hạn khác nhau
Thiết bị thứ nhất là Xiaomi TV Box S (thế hệ 3): chip Amlogic S7D với 4 lõi Cortex-A55 @ 2,5 GHz, 1,9 GB RAM (chỉ khoảng 1 GB dùng được), bộ nhớ eMMC, Android 14, không root. Trên chiếc hộp này, dự án chạy được các mô hình từ 260K đến 16B tham số:
- Qwen3.5-0.8B: 16,8 tok/s, gấp 2,2 lần mức 7,5 tok/s ban đầu.
- Qwen3.5-2B: 7,7 tok/s trong chat thực tế, được xem là lựa chọn cân bằng nhất giữa tốc độ và chất lượng.
- Moon-Beam-8B-A1B (MoE 8B): 7,2 tok/s, các chuyên gia được nạp từ flash theo nhu cầu và prefetch trước một lớp.
- Bonsai-8B (1-bit, dense): 5,2 tok/s, tăng từ 1,2 tok/s nhờ chế độ "headless" và kernel bảng tra cứu.
- Ling-mini-2.0 (MoE 16B): 5,1 tok/s, trả lời mạch lạc tới 600 từ.
Thiết bị thứ hai là iPad Air thế hệ đầu (2013): chip Apple A7, 2 lõi, NEON không có dotprod, 1 GB RAM, iOS 12.5.7, đã jailbreak, chỉ dùng CPU. Kết quả: Bonsai-1.7B (1-bit) đạt 24-26 tok/s, Bonsai-4B khoảng 10 tok/s, Moon-Beam-8B-A1B khoảng 3,5 tok/s và Ling-mini-2.0 (16B MoE) đạt 2,6-4,5 tok/s.
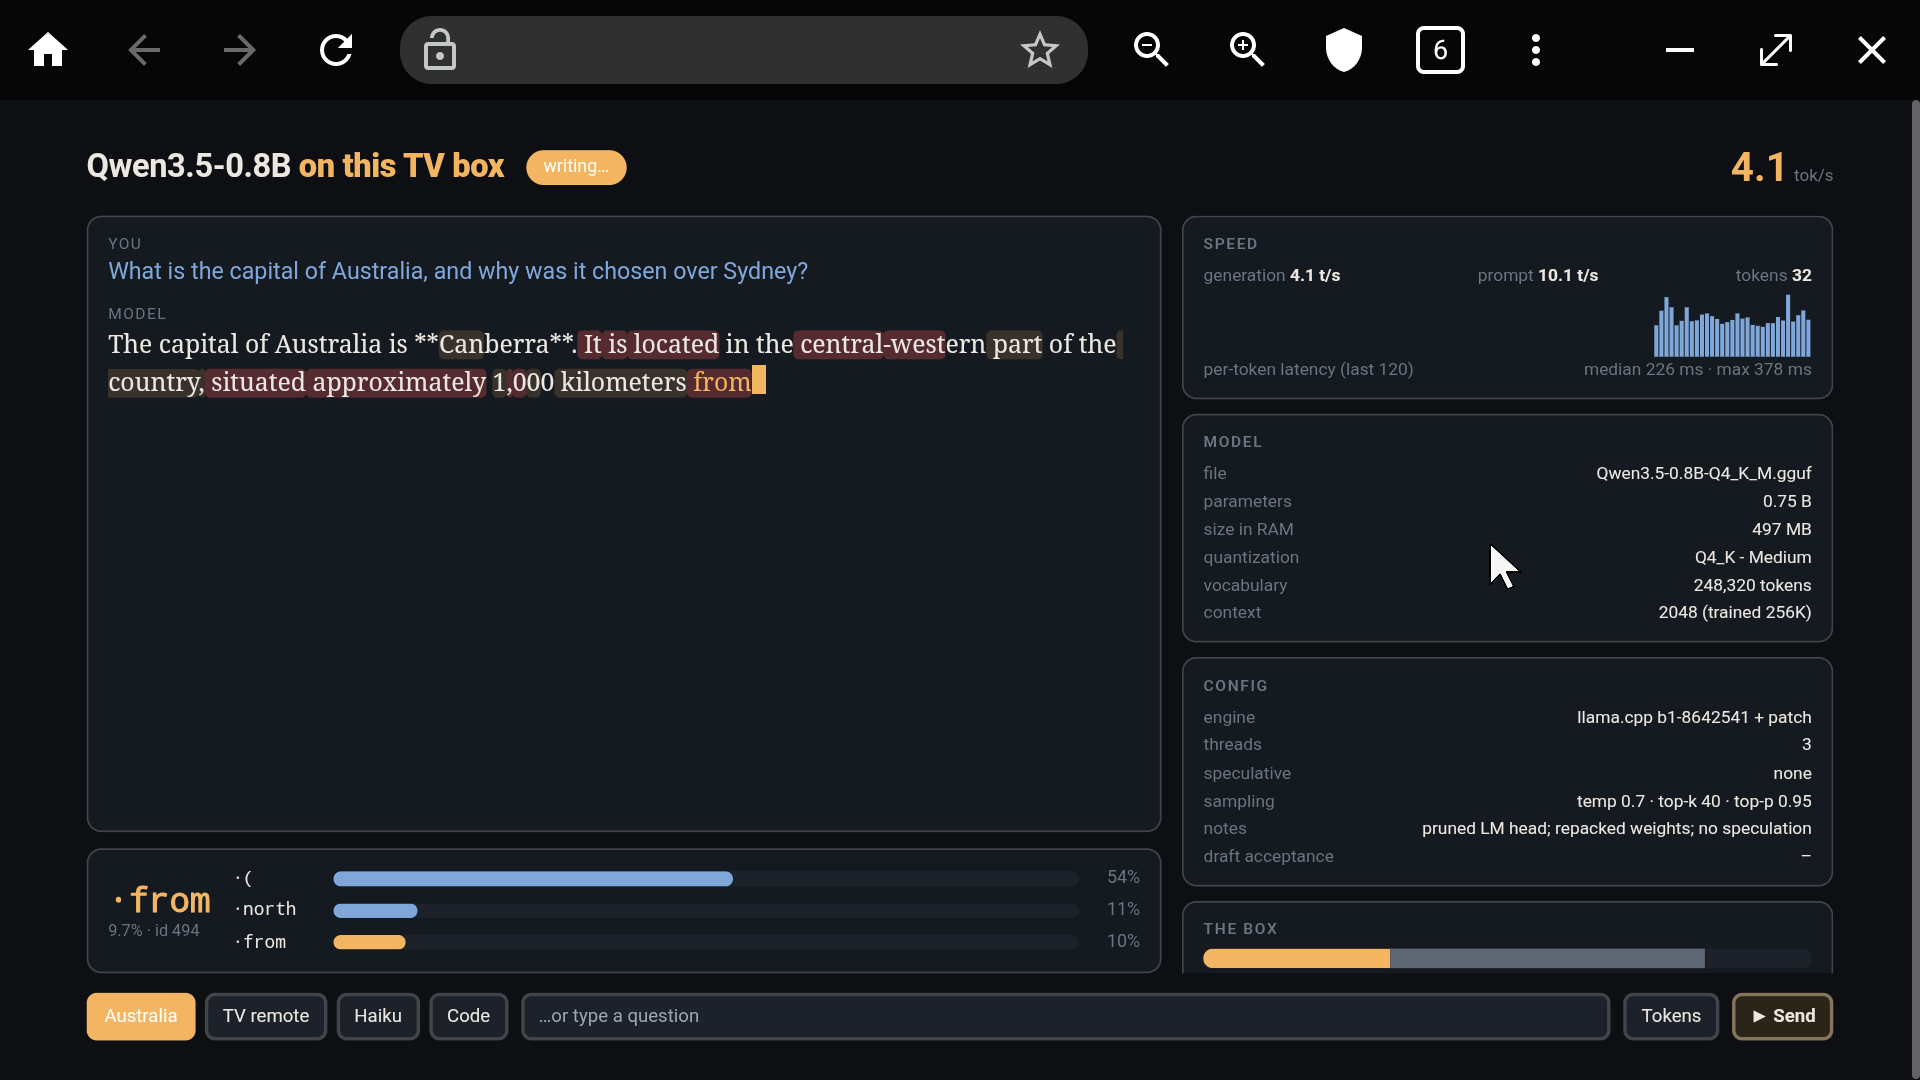 Giao diện chat chạy trên thiết bị
Nút thắt thật sự không phải CPU
Tác giả chỉ ra rằng giới hạn vật lý của TV box rất rõ ràng: một tiến trình chỉ giữ được khoảng 0,96 GB trước khi Android bắt đầu kill (khoảng 1,15 GB ở chế độ headless), và tốc độ đọc flash tối đa 278 MB/s, mỗi lần đọc ngẫu nhiên 1 MB tốn khoảng 6 ms.
Điều này dẫn tới một hệ quả: một mô hình phải stream X MB mỗi token thì không bao giờ vượt quá 278/X tok/s. Đó chính là lý do các mô hình trên 2B bị giới hạn, và vì sao mô hình MoE chỉ chạm tới khoảng 1 B trong tổng 8 B trọng số mỗi token lại là hướng đi hiệu quả.
Ba nhóm giải pháp được nhóm phát triển đưa ra, mỗi nhóm nhắm vào một nút thắt:
- Tính toán: các kernel Q2_K và ternary được đóng gói lại cho lệnh
vdotq_laneq, kernel bảng tra cứu 1-bit, attention Q8_0 có ngưỡng bỏ qua, hợp nhất bước Gated-DeltaNet. - RAM: cắt tỉa LM head (giữ lại phần từ vựng hữu ích nhất), nén ternary không mất mát 1,875 bit, chế độ headless, bộ nhớ đệm repack trên flash.
- Flash: streaming trọng số với
O_DIRECT, expert pager cho mô hình MoE, định tuyến nhận biết cache, prefetch trước cổng.
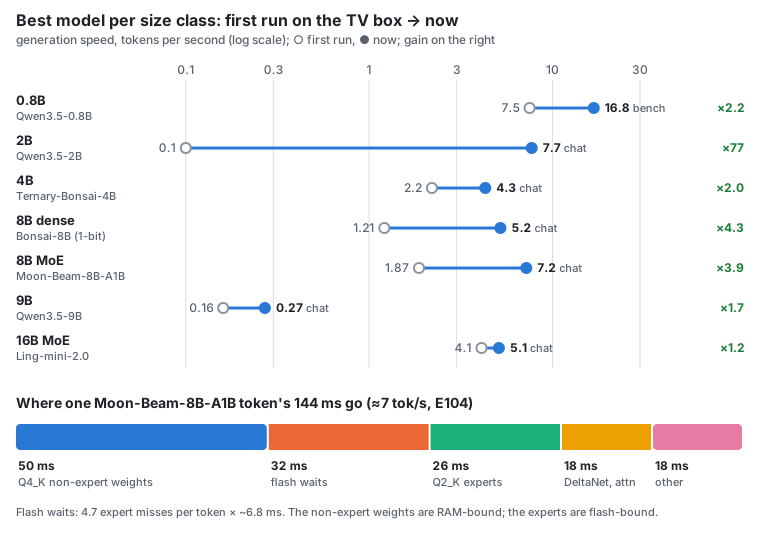 Bảng điểm hiệu năng các mô hình
Bài học kỹ thuật đáng giá
Tài liệu dự án tổng hợp nhiều bài học thực chiến, trong đó có vài điểm đáng chú ý với người làm kỹ thuật:
- Đo rồi kiểm chứng: hai lỗi streaming từng cho tốc độ trông hợp lý nhưng số liệu sai; chỉ có so sánh tensor với file gốc và perplexity với bản tham chiếu trên Mac mới phát hiện được.
- Model nhỏ chủ yếu là từ vựng: head 248K dòng của Qwen3.5-0.8B chiếm một phần ba trọng số; cắt xuống 65K dòng kết hợp lượng tử hóa all-Q4_K đưa tốc độ từ 7,5 lên 12,1 tok/s.
- Kiểm tra xem mọi ma trận lớn có đi qua kernel nhanh không: head của mô hình 2B từng chạy ngầm trên kernel chung suốt nhiều tuần vì ggml chỉ repack số dòng chia hết cho 8.
- Perplexity không nhìn thấy vòng lặp: mô hình 2-bit đạt điểm perplexity tốt nhưng vẫn rơi vào vòng lặp ở 12/13 câu trả lời dài; bộ lọc phạt lặp 1,15 trên 256 token kéo con số này xuống còn 1/13.
- Trên lõi in-order, phải đếm cả số lệnh NEON chứ không chỉ byte: đóng gói chặt hơn tiết kiệm 20% byte nhưng tốn gấp 2,5 lần số lệnh, khiến mô hình 4B chậm đi cho tới khi hoàn tác.
Dự án phát hành theo giấy phép MIT, bản vá dựa trên llama.cpp v0.8.0, kèm hướng dẫn build, script tái tạo mô hình và các bản GGUF đã tối ưu sẵn trên Hugging Face. Toàn bộ nhật ký thí nghiệm E1-E160 được ghi chép trong file EXPERIMENT.md.
Góc nhìn
Với lập trình viên và kỹ sư ở Việt Nam, dự án này là tài liệu tham khảo thực tế cho bài toán tối ưu suy luận trên phần cứng hạn chế — kỹ năng ngày càng cần thiết khi triển khai AI tại biên (edge) hoặc trên thiết bị người dùng thay vì phụ thuộc hoàn toàn vào API đám mây. Những kỹ thuật như kernel NEON tùy chỉnh, streaming trọng số từ flash và expert pager có thể áp dụng cho các thiết bị ARM phổ biến khác.
Điểm đáng học nhất có lẽ là phương pháp: mỗi thay đổi đều được đo, kiểm chứng tính đúng đắn và ghi lại thành một thí nghiệm có số hiệu. Cách làm này giúp tránh những tối ưu "cảm tính" — vốn là cái bẫy phổ biến khi làm việc với mô hình lớn trên phần cứng yếu.
Nguồn: github.com · Quy trình biên tập
Bài viết liên quan
Phần mềm
llama-modchip v2.4.0: chạy DeepSeek 284B trên RAM 64GB
08 tháng 11, 2026
Chạy mô hình 104GB Qwen3.8-Flash-Next trên Mac chỉ với 48GB RAM: Thành tựu từ slotstream
01 tháng 9, 2026
Phần mềm
Chạy LLM cục bộ trên Mac: máy nào phù hợp, công cụ nào miễn phí và đâu là điều không cần thiết
25 tháng 9, 2026