
Dùng AI và GLM 5.3 để dịch ngược ứng dụng TikTok với chi phí dưới 20 USD
Một kỹ sư đã dùng tác nhân AI Hermes, bộ công cụ Reverse Engineer Anything (REA) và mô hình GLM 5.3 để dịch ngược ứng dụng TikTok, từ đó thu thập siêu dữ liệu video với chi phí chưa đến 20 USD. Thay vì mua tài liệu hướng dẫn giá 1.699 USD, ông tự tái hiện phương pháp bằng cách vượt qua các lớp ký số, ghim chứng chỉ và nhận dạng thiết bị của TikTok.
Dùng AI và GLM 5.3 để dịch ngược ứng dụng TikTok với chi phí dưới 20 USD
Một kỹ sư đã dùng tác nhân AI Hermes, bộ công cụ Reverse Engineer Anything và mô hình GLM 5.3 để dịch ngược ứng dụng TikTok, thu thập siêu dữ liệu video với chi phí chưa đến 20 USD. Thay vì bỏ 1.699 USD mua tài liệu hướng dẫn, ông tự tái hiện phương pháp bằng cách vượt qua hệ thống ký số, ghim chứng chỉ và nhận dạng thiết bị của nền tảng.
 Minh họa quá trình dịch ngược ứng dụng bằng AI
Xuất phát điểm: một bộ dữ liệu khổng lồ và một bức tường trả phí
Câu chuyện bắt đầu khi tác giả Pierluigi Vinciguerra bắt gặp trên Hugging Face một bộ dữ liệu chứa siêu dữ liệu của 5,6 tỷ video TikTok. Điều khiến ông chú ý không phải bản thân dữ liệu, mà là cách người ta thu thập được nó.
Bài viết gốc của DataSocial mô tả phương pháp ở mức tổng quát: hoàn toàn headless, không dùng trình duyệt hay trình giả lập. Nhưng phần cốt lõi thì nằm sau paywall với giá 1.699 USD. Thay vì bỏ tiền, tác giả quyết định tự tìm câu trả lời với bộ công cụ sẵn có của mình.
Phần lớn công việc do GLM thực hiện; tôi chỉ định hướng và kiểm tra kết quả.
Bộ ba công cụ: mô hình, tác nhân và công cụ hỗ trợ
Tác giả có ít kinh nghiệm về dịch ngược, nên gần như phó mặc công việc cho các mô hình ngôn ngữ lớn. Ông chọn GLM 5.3 chạy qua OpenRouter thay vì các mô hình phương Tây như ChatGPT hay Claude, bởi chúng có rào chắn bảo mật rất chặt và từ chối mọi yêu cầu mang tính chất an ninh mạng.
Bộ công cụ gồm ba phần chính:
- Hermes Agent: tác nhân điều phối, gọi các công cụ khác.
- Reverse Engineer Anything (REA): dự án mã nguồn mở chạy dưới dạng MCP server, biến một tác nhân thông thường thành kỹ sư dịch ngược. Bạn cài bằng lệnh
npx rea-agents setup, chọn tác nhân, phê duyệt thay đổi và khởi động lại. - GLM 5.3: mô hình đảm nhận phần lớn tư duy phân tích.
REA tự động điều khiển các công cụ quen thuộc trong lĩnh vực này: Ghidra, Hopper hoặc IDA cho mã máy gốc, jadx cho Android, adb để giao tiếp với thiết bị, TShark để phân tích gói tin. Thay vì tự chọn công cụ rồi ghép kết quả, tác nhân chỉ cần hỏi REA mã giả của một hàm hoặc danh sách chuỗi trong thư viện; REA sẽ chạy chương trình phù hợp và trả về câu trả lời gọn gàng kèm bằng chứng.
Ngoài ra còn có hai công cụ kinh điển: Frida để quan sát ứng dụng đang chạy và mitmproxy để đọc lưu lượng mạng.
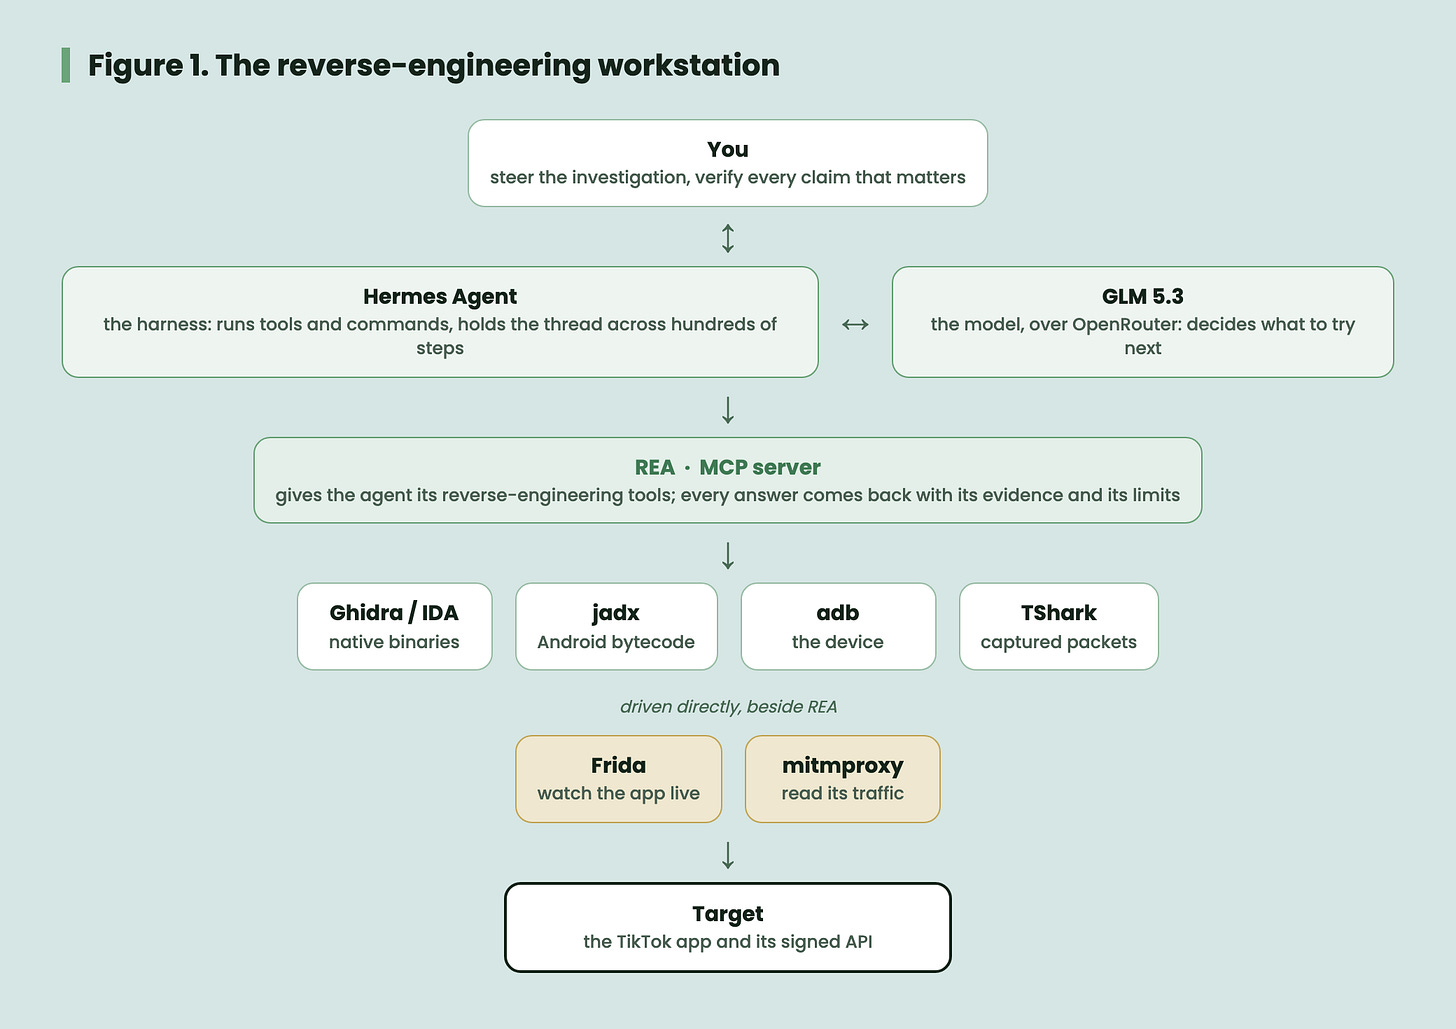 Sơ đồ kiến trúc công cụ dịch ngược
Vì sao TikTok khó hơn các ứng dụng khác
Với phần lớn ứng dụng, khi tìm ra API nội bộ thì phần khó nhất đã qua: chặn lưu lượng, đọc yêu cầu, phát lại từ Python là xong. TikTok thì không như vậy.
Mọi yêu cầu tới API riêng của TikTok đều mang chữ ký số do ứng dụng tính toán. Nếu chữ ký sai, máy chủ không báo lỗi mà trả về HTTP 200 với thân rỗng. Không mã lỗi, không thông báo, không gợi ý. Ứng dụng kiểm tra đồng thời bốn thứ, và cả bốn phải đúng trên cùng một yêu cầu:
- Danh tính thiết bị do TikTok cấp, để yêu cầu trông như đến từ thiết bị đã biết.
- Chữ ký yêu cầu, được tính bởi thư viện gốc nhúng trong ứng dụng.
- Endpoint khu vực phù hợp, vì API được chia theo vùng và tuyến.
- Dấu vân tay mạng trông giống điện thoại chứ không phải script.
Sai bất kỳ mục nào cũng nhận cùng một phản hồi rỗng. Vì vậy, việc đầu tiên cần làm là một bộ phán xét nhỏ dựa trên nội dung phản hồi thay vì mã trạng thái:
def classify(http_status: int, body: bytes) -> Outcome:
    if http_status != 200:
        return Outcome(False, f"upstream HTTP {http_status}",
            retry_would_help=(http_status == 429))
    if len(body) < MIN_BODY_BYTES:
        return Outcome(False, f"empty upstream body ({len(body)} bytes)",
            retry_would_help=True)
    ...
Đọc ứng dụng trước khi chạy nó
Tác nhân AI bắt đầu bằng việc đọc ứng dụng mà không cần chạy: mã bytecode Android được dịch ngược về dạng gần giống Java, còn các thư viện gốc đã biên dịch thì không dịch ngược được thành thứ dễ đọc.
Bước đầu tiên là dùng jadx để lập bản đồ: tên thư viện ký số, các header mà chữ ký mang theo, app ID xuất hiện khắp nơi.
Sau đó, ứng dụng được chạy trên một trình giả lập đã root, gắn Frida để quan sát mã ký số từ bên trong. Frida hoạt động bằng cách móc các hàm trong ứng dụng đang chạy và đọc dữ liệu vào ra, nên vị trí tự nhiên để gắn là ranh giới giữa mã Java và thư viện gốc.
Phát hiện đầu tiên khá bất ngờ: phần ký số cần tái hiện không hề đi qua ranh giới đó. Chữ ký trên một yêu cầu dữ liệu thực tế được tạo ở phía bên kia, bởi chính tầng mạng của ứng dụng gọi thẳng vào thư viện ký số, tất cả nằm trong mã gốc. Móc ở giữa không bao giờ nhìn thấy nó.
Vượt qua ghim chứng chỉ nhờ hiểu đúng bản chất
Để đọc lưu lượng mã hóa, cách thông thường là đặt proxy ở giữa và khiến ứng dụng tin chứng chỉ của proxy. TikTok từ chối: ứng dụng ghim chứng chỉ của chính nó và loại bỏ mọi thứ khác trước khi một yêu cầu nào được gửi đi.
Nỗ lực đầu tiên của tác nhân AI là thay thế hàm kiểm tra chứng chỉ bằng một hàm luôn trả về "đồng ý". Ứng dụng sập ngay lập tức, và tác nhân mất cả buổi chiều xử lý như thể đây là vấn đề phát hiện can thiệp. Nhưng không phải vậy: qua bộ dịch ngược, giải pháp thật là giữ nguyên phép kiểm tra và chỉ lật kết luận cuối cùng từ từ chối sang chấp nhận. Phép kiểm tra vẫn hoàn thành phần việc của nó, ngăn xếp vẫn vui vẻ, và việc ghim chứng chỉ bị vượt qua.
Sau đó, tác nhân AI thu được một loạt yêu cầu có chữ ký thật.
Tại sao không thể ký một lần rồi dùng mãi
Sau khi xem lưu lượng, nhóm nghiên cứu tự hỏi liệu các chữ ký thu được có thể tái sử dụng không. Câu trả lời là không.
Chữ ký được tính trên đúng các byte của yêu cầu, nên chỉ cần đổi một byte — ví dụ để lấy trang tiếp theo — là yêu cầu bị từ chối. Không thể ký một lần rồi phân trang. Mỗi yêu cầu đều cần chữ ký mới.
Điều này để lại hai lựa chọn:
- Tự cài lại thuật toán ký số của ứng dụng, đúng phần mà tài liệu trả phí bán, phụ thuộc vào các khóa không công khai.
- Lấy chính thư viện ký số của ứng dụng và chạy nó bên ngoài, dùng công cụ unidbg để nạp thư viện gốc và chạy các hàm của nó trên một server thường, không cần điện thoại.
Nhóm chọn cách thứ hai. Chữ ký tạo ra giống hệt ứng dụng, đơn giản vì chúng đến từ chính mã của ứng dụng. Từ đây, một yêu cầu lắp ráp bằng script và được thư viện "mượn" ký sẽ trả về đầy đủ dữ liệu. Ứng dụng chính thức bị loại khỏi vòng lặp.
Bài toán danh tính thiết bị
Mảnh ghép cuối cùng là danh tính. Chữ ký phải được tạo cho một thiết bị cụ thể mà TikTok biết, và danh tính lấy từ trình giả lập sẽ hết hạn theo thời gian.
Tác nhân AI học cách đăng ký danh tính mới giống như ứng dụng làm trong lần khởi chạy đầu tiên, làm nóng chúng, rồi kiểm chứng từng danh tính hoạt động trước khi tin dùng.
Từ đó trở đi là những công việc kỹ thuật thông thường:
- Duy trì một nhóm danh tính đang hoạt động.
- Dùng bộ phán xét nội dung để đọc mọi phản hồi.
- Xoay IP dân cư để yêu cầu bị chặn được thử lại từ địa chỉ sạch.
 Minh họa quy trình thu thập dữ liệu tự động
Quy mô nhỏ nhưng mô hình mới là điểm mấu chốt
Các con số từ lần chạy thực tế khá khiêm tốn, nhưng hình dạng của giải pháp mới là điều đáng chú ý: một máy duy nhất, không điện thoại, thu thập cùng loại dữ liệu công khai mà ứng dụng hiển thị, với tốc độ ổn định và mở rộng bằng cách chạy thêm nhiều bộ ký số song song.
Về phần mã nguồn, tác giả chỉ công bố nhóm module không chạm trực tiếp vào TikTok. Phần mã thực sự tương tác với nền tảng được giữ kín có chủ đích, nhằm tránh các yêu cầu gỡ bài hoặc nguy cơ bị deindex.
Góc nhìn cho độc giả Việt Nam
Câu chuyện này phản ánh một xu hướng đáng chú ý: các mô hình AI ngày càng trở thành công cụ hạ thấp rào cản kỹ thuật trong những lĩnh vực trước đây đòi hỏi chuyên gia nhiều năm kinh nghiệm như dịch ngược phần mềm.
Dù vậy, ranh giới pháp lý và đạo đức vẫn rất rõ ràng. Việc vượt qua hệ thống bảo vệ của một nền tảng để thu thập dữ liệu có thể vi phạm điều khoản sử dụng, thậm chí vi phạm pháp luật về an ninh mạng ở nhiều quốc gia, trong đó có Việt Nam. Đối với các đội ngũ phát triển tại Việt Nam, giá trị lớn nhất ở đây nằm ở bài học về bảo mật ứng dụng: ghim chứng chỉ, ký số theo từng yêu cầu và nhận dạng thiết bị đang trở thành tiêu chuẩn tối thiểu, chứ không còn là tính năng nâng cao.
Mô hình AI giúp người không chuyên làm được việc của chuyên gia — điều đó cũng có nghĩa các lớp phòng vệ của ứng dụng cần được thiết kế lại cho đúng tầm.
Bài viết liên quan
Công nghệ
ElementaryUI: Viết giao diện web bằng Swift, chạy trực tiếp trên trình duyệt qua WebAssembly
29 tháng 10, 2026
Công nghệ
Sylphide OS: Hệ điều hành đa dụng cho các máy tính dựa trên vi điều khiển
29 tháng 10, 2026
Công nghệ
Archive of Our Own có thể ngừng hoạt động tới 4 tuần sau sự cố bảo trì
29 tháng 10, 2026