Google Gemini 4 Argon: Cửa sổ đầu ra một triệu token và những điểm yếu cần lưu ý
Gemini 4 Argon mở rộng cửa sổ đầu ra lên tới 1 triệu token, mở ra khả năng xử lý các tác vụ quy mô lớn trong một lần gọi. Tuy nhiên, mô hình này lại tỏ ra kém cạnh ở các tác vụ terminal tương tác, đi kèm mức giá có thể lên tới 10-20 USD cho một lần sinh văn bản dài.
Google vừa giới thiệu Gemini 4 Argon, một mô hình ngôn ngữ lớn thế hệ mới với điểm nhấn đáng chú ý nhất: cửa sổ đầu ra lên tới 1 triệu token. Thông tin này nhanh chóng thu hút sự quan tâm của giới phát triển, bởi nó thay đổi cách chúng ta giao việc cho mô hình AI.
 Gemini 4 Argon và cửa sổ một triệu token
Điều gì đã ra mắt và cách truy cập
Google công bố Argon vào ngày 30/9/2026, nhưng trong hai tuần đầu, chỉ những chuyên gia bảo mật được thẩm định mới có thể sử dụng thông qua Fairwind Program, cùng với một số đơn vị thử nghiệm sớm như Wiz. Đến ngày 13/10, mô hình chính thức đến tay các nhà phát triển thông qua gói trả phí của Gemini API và AI Studio.
Mã định danh của mô hình là gemini-4-argon. Bên cạnh đó còn có một biến thể thứ hai là gemini-4-argon-cyber-permissive, hướng đến các chuyên gia phòng thủ được cấp phép, nên phần lớn người dùng có thể bỏ qua.
Đây là một transformer mixture-of-experts thưa với dữ liệu huấn luyện kéo dài đến tháng 3/2026. Mô hình nhận đầu vào gồm văn bản, mã nguồn, hình ảnh, âm thanh, video và tệp PDF, nhưng chỉ trả ra văn bản và mã nguồn. Điều này có nghĩa Argon không thể vẽ biểu đồ cho bạn.
Một bể chứa một triệu token
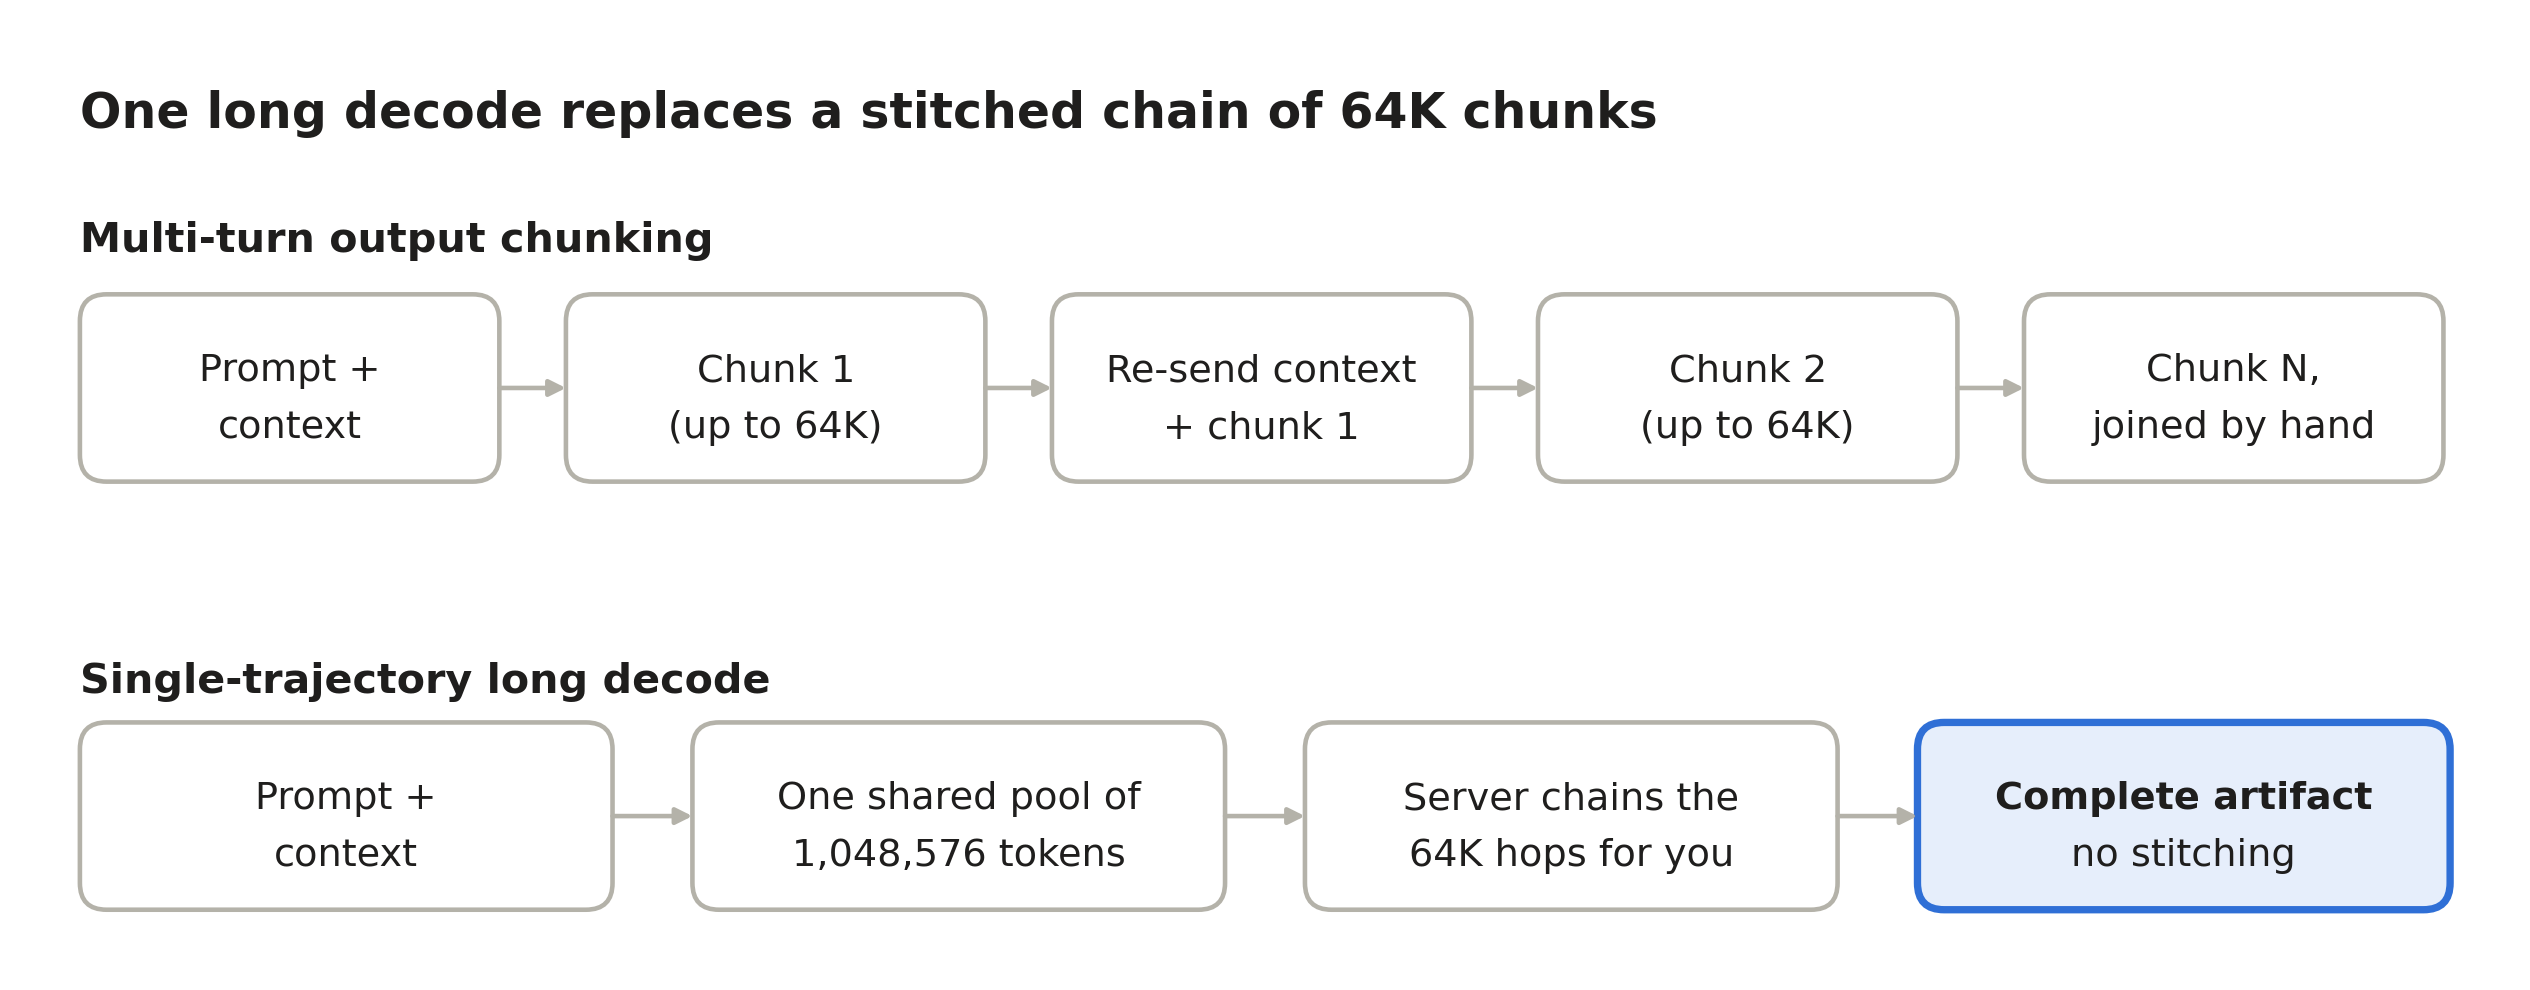
Thay đổi khiến nhiều người quan tâm nhất chính là cửa sổ đầu ra. Các mô hình Gemini trước đây nhận khoảng một triệu token đầu vào nhưng chỉ trả về tối đa 64K. Argon nâng giới hạn đầu ra lên 1 triệu token, với một cửa sổ thống nhất gồm 1.048.576 token chia sẻ cho cả đầu vào, quá trình suy luận (thinking) và đầu ra.
Nếu bạn đưa vào một prompt 100K token, mô hình vẫn còn gần 950K token để trả lời.
Giới hạn đầu ra mặc định vẫn giữ ở mức 65.536 token, chủ yếu để tránh những hóa đơn bất ngờ. Muốn vượt qua, bạn phải tăng max_output_tokens (tối đa bằng 1.048.576 trừ số token đầu vào) và sử dụng cơ chế long decode. Trên Interactions API, bạn cần đặt background=True, còn trên GenerateContent API thì phải tự xử lý việc nối tiếp. Nếu yêu cầu vượt quá bể chứa, bạn sẽ nhận lỗi HTTP 400.
Lợi ích rõ ràng nhất: trước đây, một lần sinh văn bản khổng lồ buộc phải chia nhỏ công việc thành nhiều phần, đưa từng kết quả trở lại và hy vọng mô hình vẫn nhớ những gì đã cam kết ở phần đầu. Long decode loại bỏ hoàn toàn quy trình thủ công đó.
Mức suy luận và một thay đổi gây lỗi
Tham số thinking_level nhận ba giá trị: "LOW", "MEDIUM" và "HIGH". Mức thấp dành cho phân loại, tóm tắt và trích xuất siêu dữ liệu; mức trung bình (mặc định) phù hợp với lập trình hàng ngày, sử dụng công cụ và hỏi đáp tài liệu; mức cao dành cho kỹ thuật đa tệp, chứng minh toán học và săn lỗ hổng bảo mật.
Điểm cần lưu ý khi nâng cấp: tham số thinking_budget dạng số nguyên cũ và thiết lập MINIMAL giờ đây sẽ trả về lỗi HTTP 400. Cơ chế caching cũng thay đổi, khi Argon chỉ hỗ trợ implicit caching với mức giảm giá 95% cho đầu vào được cache, còn các endpoint explicit caching đã bị loại bỏ.
Giá cả và bài toán độ dài
Mức giá giới thiệu (tính đến giữa tháng 10/2026) là 2 USD cho mỗi triệu token đầu vào và 10 USD cho mỗi triệu token đầu ra, với token suy luận được tính như đầu ra. Ưu đãi này kết thúc vào ngày 30/11, và từ 1/12 sẽ áp dụng mức giá tiêu chuẩn 4 USD và 20 USD.
Tuy nhiên, có một điểm trừ đáng chú ý. Theo Artificial Analysis, Argon tiêu thụ tới 110 triệu token trên bộ đánh giá của họ, so với mức trung bình 82 triệu của các đối thủ. Điều này có nghĩa mô hình nói nhiều hơn đối thủ. Dù vậy, xét theo chi phí mỗi tác vụ, Argon vẫn rẻ hơn, ở mức 1,99 USD so với 3,26 USD của GPT-6 Astra và 5,98 USD của Claude Opus 5.5.
Argon mạnh ở đâu, yếu ở đâu
Điểm yếu đáng lo ngại nhất của Argon nằm ở các tác vụ terminal tương tác. Trên Terminal-Bench 4.0, mô hình đạt 57,4%, trong khi Claude Opus đạt 66,4% và Sonnet đạt 70,6%. Trên FrontierSWE v2, Argon chỉ đạt 55,0% so với 65,5% của GPT-6 Astra. Mô hình cũng kém hơn ở OSWorld 2.0 và Agents' Last Exam.
Ngược lại, Argon tỏa sáng ở những công việc có cấu trúc lớn. Mô hình đứng đầu trên DeepSWE v1.1 với 77,9%, dẫn đầu chỉ số Vals tổng thể, đạt 84,2% trên GraphWalks BFS trong khoảng 256K đến 1M token, và dẫn đầu LVBench cho video dài với 91,7%.
Nói cách khác, Argon phù hợp với một bài toán lớn mà bạn có thể giao phó rồi rời đi, nhưng ít hấp dẫn khi bạn muốn điều khiển từng bước.
Những gì Google tuyên bố Argon đã làm được
Các nghiên cứu điển hình cho thấy tiềm năng của cửa sổ lớn. Google cho biết các tác nhân Argon đang chuyển đổi mã C và C++ sang Rust, từ quy mô nhỏ như re2 cho đến hơn 800.000 dòng trong nhân Fuchsia Zircon. Trong bộ giải mã video libgav1, họ thay thế 32.000 dòng SIMD bằng Rust an toàn, tạo ra bộ giải mã chạy nhanh gấp 2,7 lần so với bản Rust trước đó.
Một nhóm tác nhân đọc dữ liệu profiling được kỳ vọng sẽ giải phóng từ 500 TiB đến 1 PiB bộ nhớ trên các trung tâm dữ liệu của Google. Wiz cũng sử dụng mô hình này để tìm ra một lỗ hổng nghiêm trọng trong phần mềm bệnh viện mà các mô hình tiên tiến trước đó đã bỏ sót.
Tất cả đều là số liệu do chính Google công bố, nên cần được xem là tín hiệu mạnh cho đến khi có bên thứ ba kiểm chứng độc lập.
Có nên chuyển sang Argon?
Câu trả lời ngắn gọn: chưa cần chuyển hoàn toàn. Hãy giao cho Argon những công việc có "hình dạng lớn" như tái cấu trúc ở quy mô kho mã nguồn, xử lý tài liệu dài, phân tích pháp lý và tài chính, hoặc đánh giá video. Trong khi đó, các tác nhân terminal tương tác nên tiếp tục dùng Sonnet hoặc Opus, nơi chúng đang dẫn đầu.
Chiến lược hợp lý là định tuyến theo khối lượng công việc, đặt max_output_tokens một cách có chủ đích, và ghi nhớ rằng ưu đãi giá sẽ kết thúc vào 30/11. Độ dài văn bản mà mô hình sinh ra sẽ xuất hiện trên hóa đơn của bạn trước khi các con số benchmark kịp phản ánh điều gì.