Google mã nguồn mở AQuA để chẩn đoán lỗi AI agent trên production
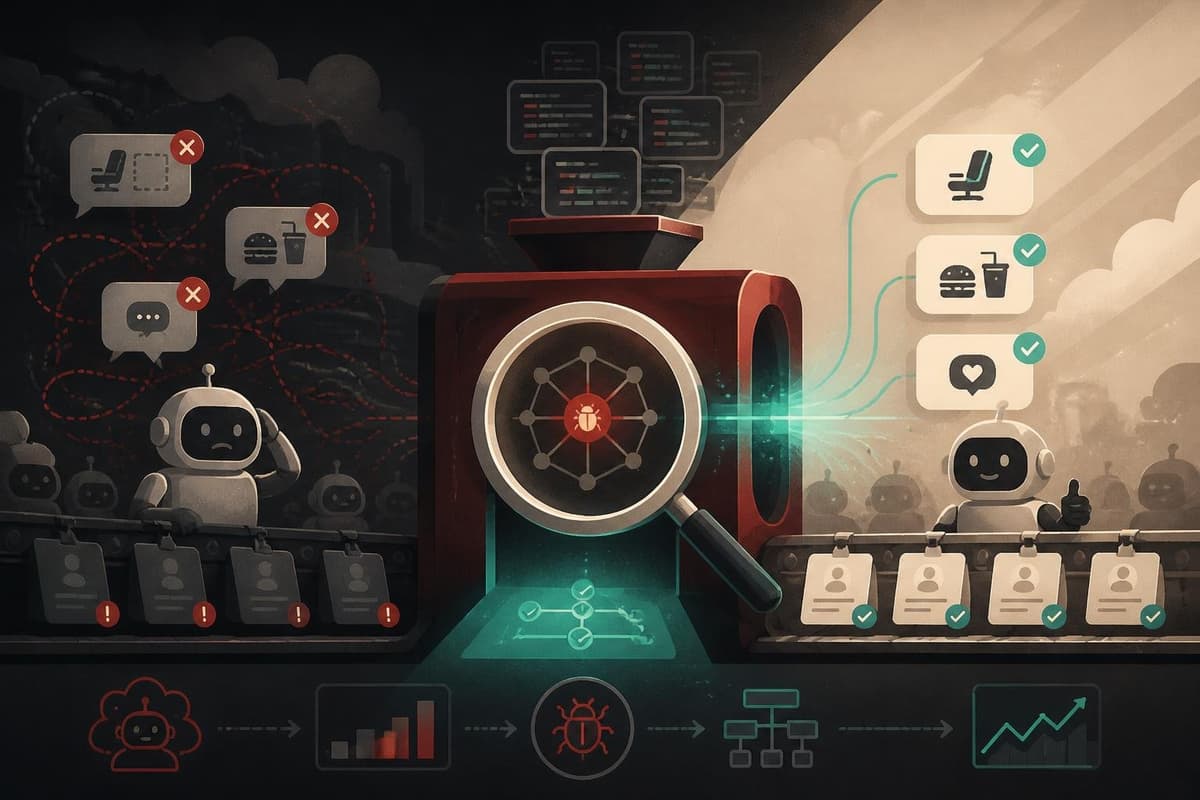
Google vừa mã nguồn mở AQuA, một bản triển khai tham chiếu giúp phân tích các phiên chạy của AI agent trên môi trường production, xác minh các mẫu lỗi lặp lại và truy tìm nguyên nhân gốc dựa trên ảnh chụp mã nguồn đang triển khai. Trong một thử nghiệm phát lại 32 phiên, nhóm phát triển đã giảm số phiên bỏ qua bước chọn ghế từ 15 xuống còn hai, và số lần thiếu sở thích ăn uống từ bảy xuống không, sau khi điều chỉnh prompt.
Google vừa công bố mã nguồn mở AQuA (Ambient Quality Agent, tạm dịch: agent đánh giá chất lượng chạy nền), một bản triển khai tham chiếu giúp phân tích các phiên chạy của AI agent trên môi trường production, xác minh những mẫu lỗi lặp lại và truy tìm nguyên nhân gốc dựa trên ảnh chụp mã nguồn đang được triển khai. Động thái này nhắm vào một điểm đau lớn của các đội ngũ đang đưa agent vào vận hành thực tế: lỗi xuất hiện rải rác trong hàng nghìn phiên hội thoại nhưng rất khó tái lập và định vị.
AQuA giải quyết bài toán gì?
Với các hệ thống AI agent, lỗi thường không biểu hiện dưới dạng crash hay exception rõ ràng. Agent vẫn trả lời trơn tru, nhưng có thể bỏ qua một bước trong quy trình, quên một ràng buộc hay hiểu sai yêu cầu của người dùng. Những sai lệch này chỉ lộ ra khi đối chiếu với kỳ vọng nghiệp vụ, và chúng thường lặp lại theo cùng một mẫu.
AQuA được thiết kế để:
- Phân tích các phiên chạy (session) của agent trên production, thay vì chỉ dựa vào bộ kiểm thử tổng hợp.
- Xác minh các mẫu lỗi lặp lại, tức là phân biệt sự cố ngẫu nhiên với lỗi có hệ thống.
- Truy nguyên nhân gốc bằng cách đối chiếu hành vi của agent với ảnh chụp mã nguồn (source snapshot) tại thời điểm triển khai.
Kết quả từ thử nghiệm phát lại 32 phiên
Điểm đáng chú ý nhất trong công bố của Google là kết quả từ một lần phát lại 32 phiên (replay) trên dữ liệu production. Sau khi điều chỉnh prompt, nhóm phát triển ghi nhận:
- Số phiên bỏ qua bước chọn ghế giảm từ 15 xuống còn hai.
- Số lần thiếu thông tin sở thích ăn uống giảm từ bảy xuống không.
Đây là những lỗi điển hình của agent trong các tác vụ đặt chỗ hoặc lên kế hoạch: agent vẫn hoàn thành được yêu cầu chính nhưng bỏ sót các ràng buộc phụ mà người dùng đã nêu. Việc phát lại đúng các phiên thật cho phép đội ngũ đo được hiệu quả của thay đổi một cách định lượng, thay vì sửa prompt theo cảm tính.
Ý nghĩa với quy trình vận hành agent
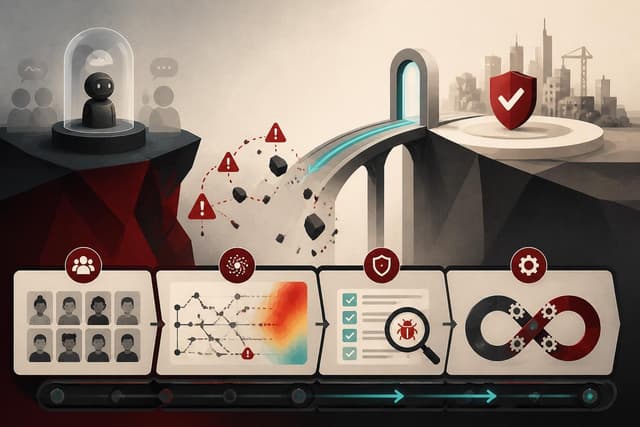
Cách tiếp cận của AQuA phản ánh một xu hướng đang hình thành trong ngành: chất lượng AI agent cần được theo dõi liên tục như một chỉ số vận hành, tương tự cách các đội SRE theo dõi độ trễ hay tỉ lệ lỗi của dịch vụ. Thay vì coi prompt và logic agent là thứ "triển khai một lần rồi quên", AQuA đặt chúng vào một vòng lặp quan sát – phân tích – sửa – đo lại.
Việc Google chọn phát hành dưới dạng bản triển khai tham chiếu cũng có nghĩa các đội ngũ có thể học kiến trúc và tự xây dựng công cụ tương tự, hoặc tùy biến cho hệ thống của mình. Tuy vậy, hiệu quả của mô hình này phụ thuộc khá nhiều vào chất lượng dữ liệu phiên chạy được ghi lại và khả năng liên kết chúng với đúng phiên bản mã nguồn.
Góc nhìn
Với các đội phát triển tại Việt Nam đang đưa chatbot hay agent hỗ trợ nghiệp vụ vào sản phẩm thật, bài học thực dụng từ AQuA là: hãy đầu tư vào hạ tầng ghi nhận phiên chạy ngay từ đầu. Nếu không lưu lại đủ ngữ cảnh — đầu vào, công cụ đã gọi, kết quả trả về, phiên bản mã nguồn — thì khi agent sai, đội ngũ gần như không có cách nào tái lập. Một kho log phiên chạy tốt cộng với khả năng phát lại sẽ biến việc sửa agent từ đánh đố thành quy trình có số liệu.
Bên cạnh đó, cách làm này cũng gợi ý rằng các thay đổi prompt nên đi kèm bộ phiên đánh giá hồi quy (regression set) trích từ dữ liệu thật. Khi đã có bộ đó, mỗi lần chỉnh prompt hay đổi mô hình đều có thể đo được tác động ngay, giống như chạy test tự động trước khi phát hành phần mềm thông thường.
Nguồn: infoq.com · Quy trình biên tập