
Hook khởi tạo phiên đưa tỷ lệ kích hoạt skill Claude Code từ 15% lên 62%
Một chuyên gia kiểm thử phần mềm đã chạy 1.872 lượt thử với 26 skill công khai trên Claude Haiku, Sonnet và Opus. Mô tả skill kiểu "pushy" chỉ tăng khoảng 5 điểm phần trăm, trong khi hook khởi tạo phiên của plugin superpowers nâng tỷ lệ kích hoạt trên yêu cầu diễn đạt lại từ 15% lên 62%.
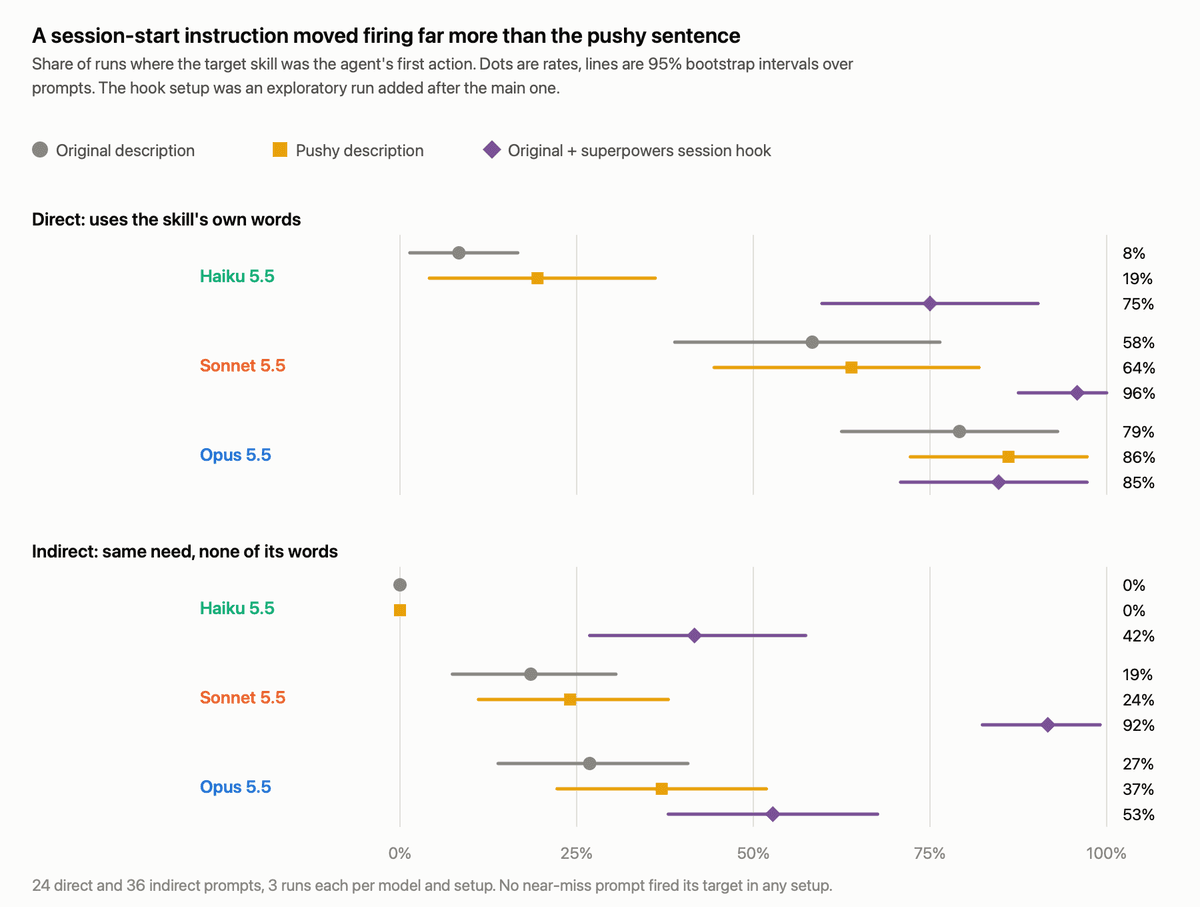
Một chuyên gia kiểm thử phần mềm đã thử nghiệm có kiểm soát cách Claude Code quyết định gọi các skill (kỹ năng đóng gói trong thư mục chứa file SKILL.md) và công bố kết quả đáng chú ý: với mô tả gốc, các yêu cầu diễn đạt lại chỉ kích hoạt đúng skill trong 15% số lượt chạy. Việc thêm một câu mô tả theo kiểu "pushy" – khuyên dùng skill ngay cả khi người dùng không nói rõ – chỉ nâng con số này lên khoảng 20%. Trong khi đó, hook chạy khi bắt đầu phiên của plugin superpowers đẩy tỷ lệ lên 62%.
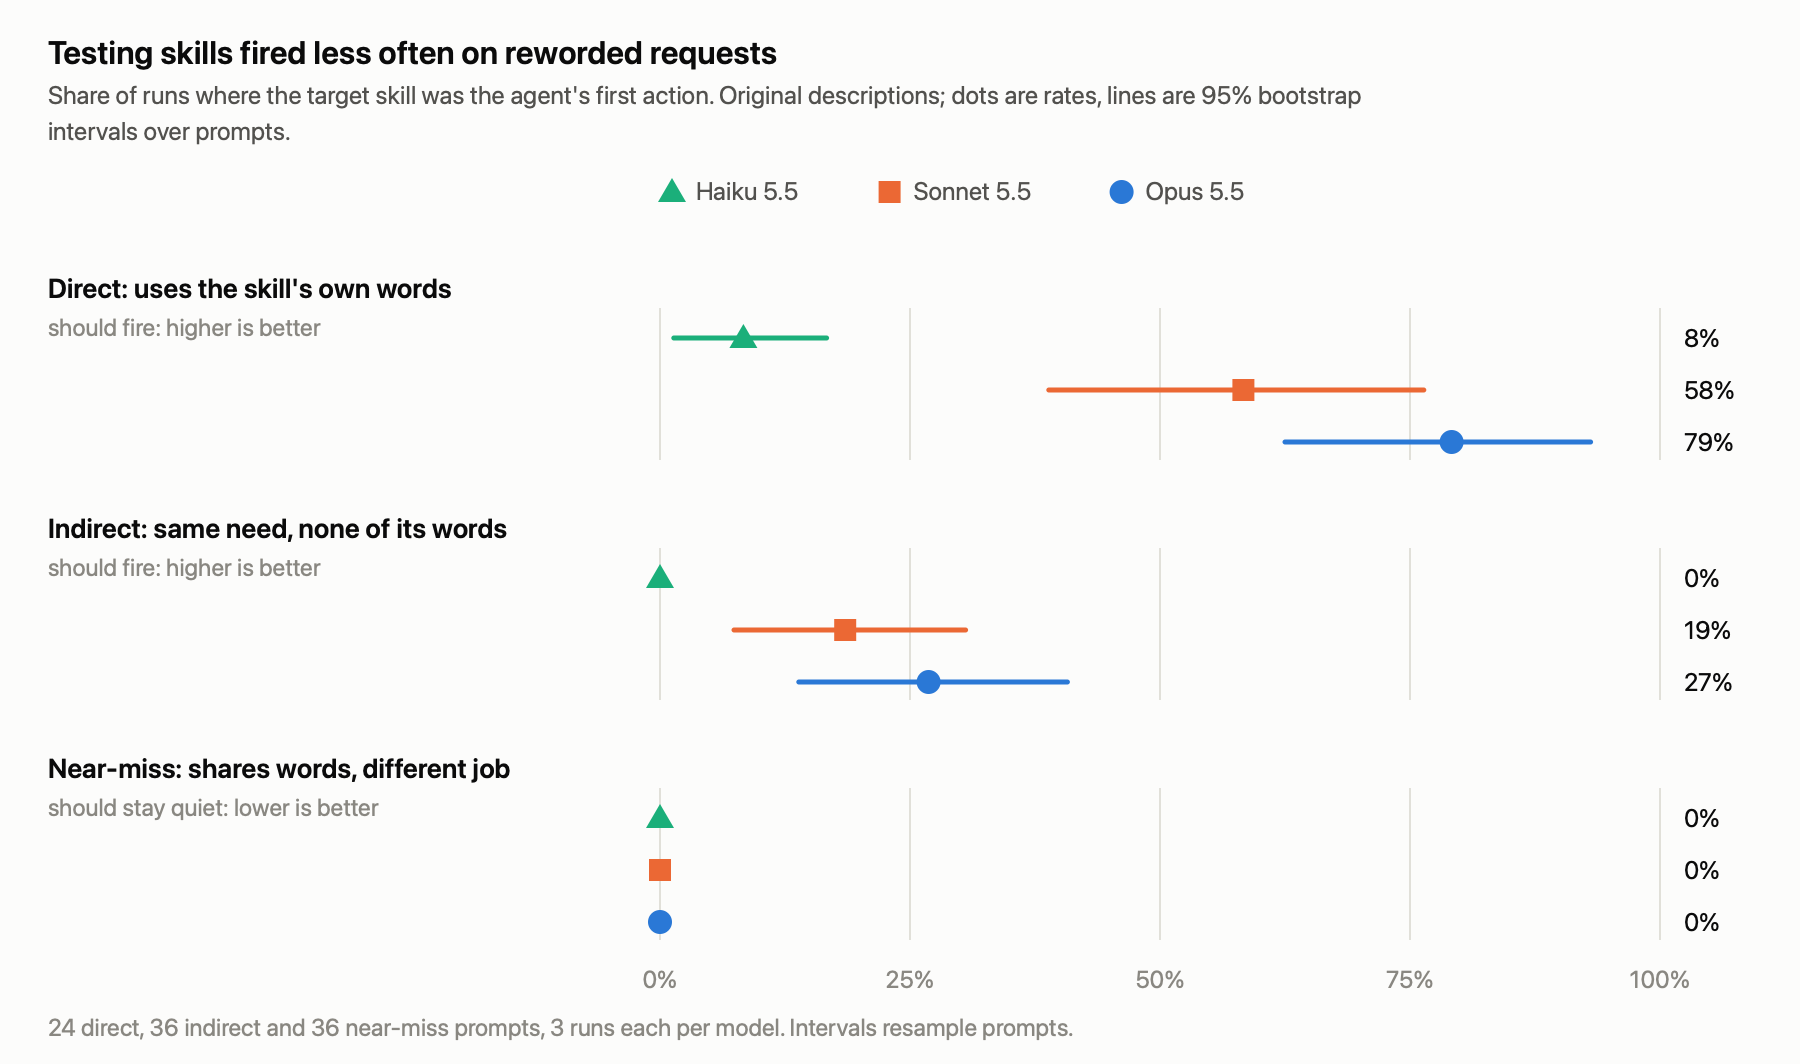 Biểu đồ tỷ lệ kích hoạt skill theo mô hình
Cách Claude Code quyết định dùng skill
Mỗi skill là một thư mục chứa file SKILL.md. Claude Code hiển thị cho mô hình tên và mô tả của từng skill đã cài, cắt ở 1.536 ký tự, và mô hình dựa vào danh sách đó để quyết định có nạp phần còn lại hay không. Khi cài nhiều skill, một số chỉ được liệt kê bằng tên để nằm trong ngân sách 1% cửa sổ ngữ cảnh (context window).
Việc nạp một skill là một lệnh gọi công cụ (tool call), nên hành động công cụ đầu tiên của tác nhân (agent) cho biết skill có được kích hoạt hay không. Điểm quan trọng: khi Claude Code bỏ sót skill, nó không báo gì cả – người dùng chỉ phát hiện bằng cách kiểm tra bản ghi phiên (transcript) xem có lệnh gọi Skill hay không.
Tài liệu skill-creator của Anthropic thừa nhận Claude có xu hướng "undertrigger" – kích hoạt skill quá ít – và khuyên viết mô tả hơi "pushy". Một nghiên cứu tại hội nghị EMNLP 2025 trên 17 mô hình (không gồm Claude) cho thấy công cụ có mô tả kết thúc bằng câu khẳng định mạnh nhất được dùng đúng trong 79,1% trường hợp, so với 11,9% khi không có câu đó. Tuy nhiên, ở đó lựa chọn chỉ nằm giữa hai công cụ, còn trong Claude Code, skill phải cạnh tranh với việc trả lời trực tiếp.
Thiết kế bài kiểm thử
Bài thử dùng 26 skill công khai về kiểm thử, gỡ lỗi và review mã nguồn, lấy từ năm kho GitHub. Sáu skill là mục tiêu, đại diện cho các tác vụ kiểm thử phổ biến: test-driven-development, systematic-debugging, python-testing-patterns, webapp-testing, api-testing và property-based-testing. Hai mươi skill còn lại được giữ làm "hàng xóm" gần gũi để tạo áp lực cạnh tranh.
Với mỗi skill mục tiêu, tác giả viết bốn loại câu lệnh, tổng cộng 104 câu:
- Trực tiếp: dùng từ ngữ của chính mô tả skill, phải kích hoạt.
- Gián tiếp: diễn đạt lại nhu cầu mà không dùng từ khóa nào của mô tả, vẫn phải kích hoạt.
- Near-miss: chia sẻ ít nhất một từ với skill nhưng cần việc khác, không được kích hoạt.
- Đối chứng không liên quan: không được nạp skill nào.
Mỗi câu chạy ba lần trên mỗi mô hình, vì hệ thống cần kiểm thử có tính không tất định (nondeterministic). Môi trường là Claude Code 2.1.316 với Claude Haiku 5.5, Sonnet 5.5 và Opus 5.5. Ma trận chính gồm 1.872 lượt chạy, tất cả hoàn thành ngay lần đầu, chạy song song bốn tiến trình mất 44 phút.
Kết quả với mô tả gốc: khoảng cách lớn giữa các mô hình
Với mô tả gốc, các yêu cầu trực tiếp kích hoạt đúng skill trong 8% số lượt chạy của Haiku, 58% của Sonnet và 79% của Opus. Nhưng các yêu cầu gián tiếp tụt mạnh: Haiku 0%, Sonnet 19%, Opus 27% – gộp lại 15%.
Các skill có sự chênh lệch lớn hơn cả mô hình. Ba skill là python-testing-patterns, systematic-debugging và test-driven-development không kích hoạt lần nào trên câu lệnh diễn đạt lại với mô tả gốc.
Các yêu cầu near-miss không kích hoạt skill mục tiêu trong bất kỳ lượt chạy nào, và tất cả 144 lượt chạy trên câu lệnh không liên quan đều kết thúc bằng câu trả lời văn bản.
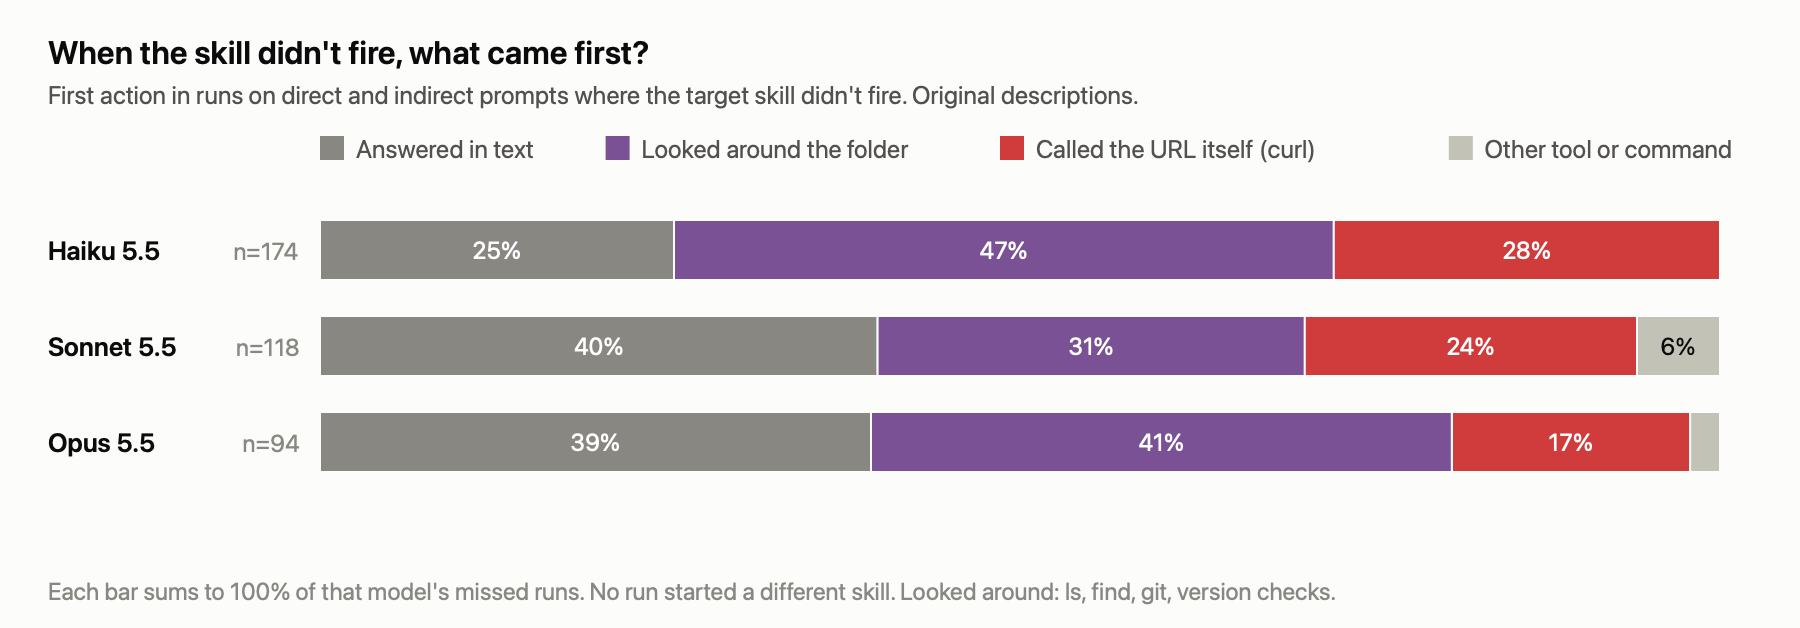
Khi skill không kích hoạt, tác nhân làm gì?
Phần lớn lượt bỏ sót bắt đầu bằng một câu trả lời văn bản, một vòng dò thư mục bằng ls, find hay git, hoặc một lệnh curl. 57 trong số 71 lượt bỏ sót của api-testing gọi thẳng endpoint, còn cả 35 lượt bỏ sót của webapp-testing kiểm tra xem máy chủ cục bộ có phản hồi không.
Tác giả thừa nhận nhóm "dò thư mục" là nhóm khó tin nhất: 44 trong 60 câu lệnh phải kích hoạt có nhắc tới mã nguồn "của chúng tôi", và trong một thư mục trống, tác nhân tất nhiên đi tìm mã nguồn đó.
 Tỷ lệ kích hoạt theo từng skill và mô hình
Mô tả "pushy" chỉ thêm 5 điểm
Phiên bản "pushy" nối thêm một câu vào mô tả của mỗi skill mục tiêu, theo mẫu skill-creator khuyên dùng. Mọi từ trong câu đó đều lấy từ tên hoặc mô tả skill, nên nó không cung cấp từ khóa mới cho câu lệnh gián tiếp, nhưng có lặp lại từ khóa – khiến hai mô tả ngắn nhất dài lên gấp ba.
Trên câu lệnh gián tiếp, câu pushy nâng tỷ lệ kích hoạt từ 15% lên 20%, chênh lệch 5,2 điểm phần trăm (khoảng tin cậy 95% từ 2,2 đến 8,3 nếu lấy câu lệnh làm đơn vị). Toàn bộ 17 lượt chạy thêm đều đến từ ba skill. Nếu lấy skill làm đơn vị, khoảng tin cậy là -1,1 đến 11,6.
Theo tiêu chí đặt ra trước khi chạy – tăng ít nhất 10 điểm – giả thuyết này không được chứng minh.
Hook khởi tạo phiên: bước nhảy 47 điểm
Khi cài dưới dạng plugin, superpowers thêm một hook chạy lúc phiên bắt đầu, đưa skill using-superpowers vào ngữ cảnh. Nội dung đó yêu cầu mô hình gọi skill bất cứ khi nào có dù chỉ một khả năng nhỏ là nó phù hợp, trước khi trả lời, hỏi lại hay xem mã nguồn.
Thiết lập thứ ba – mô tả gốc cộng hook, 936 lượt chạy – được thêm sau khi xem kết quả chính. Trên câu lệnh gián tiếp, tỷ lệ kích hoạt tăng từ 15% lên 62%, chênh lệch 47 điểm (khoảng tin cậy 39 đến 55). Sonnet biến động mạnh nhất, từ 19% lên 92%; Haiku từ 0 lên 42%, Opus từ 27% lên 53%.
Tuy vậy, hook cũng làm near-miss nạp nhầm skill "hàng xóm" trong 75 trên 324 lượt chạy, so với 43 lượt khi không có hook. Trong 19 lượt chạy trên các yêu cầu gỡ lỗi, Opus gọi skill theo tên plugin superpowers:systematic-debugging – thứ mà bản cài chỉ có thư mục không cung cấp.
Những gì bài thử chưa chứng minh
Tác giả liệt kê rõ các giới hạn: chỉ chấm điểm hành động đầu tiên nên skill nạp muộn vẫn tính là bỏ sót; đây là một bộ khung chạy trong một ngày với cấu hình cụ thể; 104 câu lệnh do chính tác giả viết; và người dán nhãn là Opus – một trong các mô hình đang được kiểm thử. Bài thử cũng không đo liệu kết quả có skill tốt hơn không có skill hay không.
Về cách tự kiểm thử, tác giả khuyên mỗi skill viết khoảng 16 câu lệnh (bốn trực tiếp, sáu diễn đạt lại, sáu near-miss), chạy ba lần trên mọi mô hình mà nhóm dùng. Với một skill, 144 lượt chạy mất ba đến bốn phút khi chạy song song và tốn khoảng 3 USD ở mức 2 cent mỗi lượt được ghi nhận trong bài.
Nếu một skill buộc phải chạy mọi lúc, có thể gọi trực tiếp bằng /skill-name hoặc thêm hook khởi tạo phiên như superpowers.
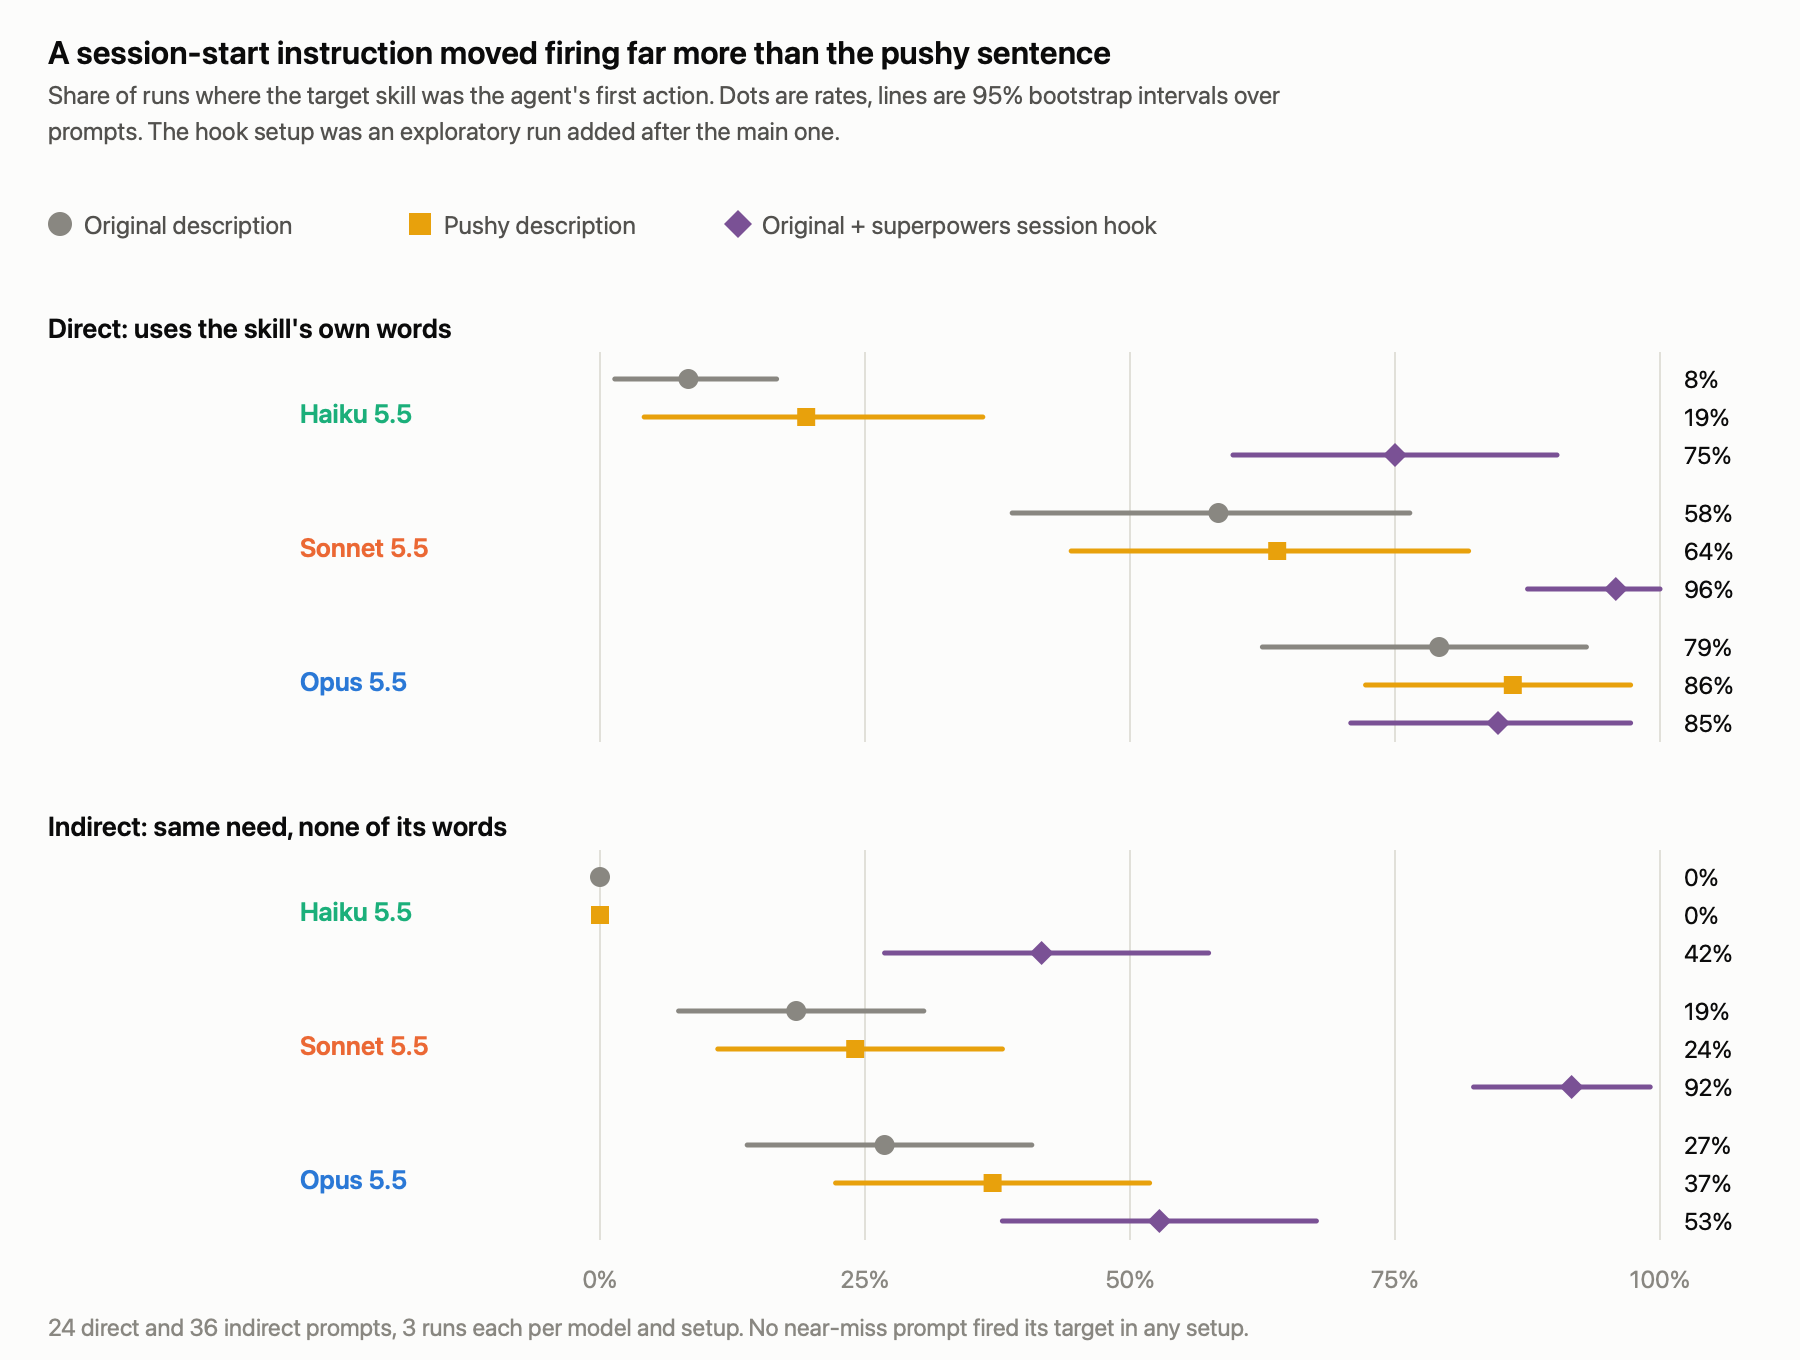 So sánh ba thiết lập: mô tả gốc, pushy và hook
Góc nhìn
Kết quả này đáng chú ý với các đội phát triển ở Việt Nam đang đưa Claude Code vào quy trình làm việc. Việc tin rằng "chỉ cần viết mô tả skill thật kỹ là mô hình sẽ dùng" tỏ ra quá lạc quan: ngay cả câu pushy theo đúng khuyến nghị của Anthropic cũng chỉ cải thiện vài điểm phần trăm. Với các skill mang tính bắt buộc – ví dụ quy ước kiểm thử, quy trình review mã nguồn nội bộ – cách đáng tin hơn là gọi tường minh hoặc dùng hook, chứ không phó mặc cho mô hình tự quyết.
Bài thử cũng cho thấy chi phí kiểm chứng khá thấp so với rủi ro: vài phút và vài USD để phát hiện một skill chưa bao giờ được kích hoạt. Các nhóm nên đo lại tỷ lệ kích hoạt mỗi khi đổi mô hình hoặc viết lại mô tả, và nhớ rằng hook tuy mạnh nhưng có thể kéo nhầm yêu cầu sang skill "hàng xóm" – nên cần kiểm tra cả các trường hợp near-miss, không chỉ đếm số lần kích hoạt thành công.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Claude Code Mods: Bốn tiện ích tùy chỉnh giúp lập trình viên kiểm soát AI tốt hơn
30 tháng 10, 2026
Phần mềm
Khám phá Claude Code: Những tính năng ẩn trong mã nguồn mà tài liệu chưa đề cập
29 tháng 5, 2026
Phần mềm
Claude Code: Hướng dẫn tối ưu hóa để biến AI thành "người đồng đội" lập trình thực thụ
27 tháng 5, 2026