Huawei phát hành MACaQ: lượng tử hóa model 122B trong 64 phút
Huawei công bố MACaQ, bộ lượng tử hóa (quantization) dùng nội bộ nay mở mã nguồn theo giấy phép Apache 2.0. Công cụ này có thể lượng tử hóa model 122 tỷ tham số chỉ trong 64 phút với 32,5 GB bộ nhớ thiết bị, hỗ trợ cả model văn bản, hình ảnh, video và âm thanh.
Huawei vừa công bố MACaQ, bộ lượng tử hóa (quantization — kỹ thuật nén trọng số và phép tính của model về độ chính xác thấp hơn để giảm dung lượng và tăng tốc suy luận) từng được dùng nội bộ, nay mở mã nguồn theo giấy phép Apache 2.0. Điểm đáng chú ý: MACaQ có thể lượng tử hóa một model 122 tỷ tham số chỉ trong 64 phút với 32,5 GB bộ nhớ thiết bị.
 Banner dự án MACaQ của Huawei
Công cụ hướng tới mục tiêu tạo ra các file GGUF chất lượng cao cho suy luận cục bộ (local inference), và theo Huawei, nó không giới hạn ở văn bản: MACaQ lượng tử hóa được cả model hình ảnh, video và âm thanh.
Hỗ trợ nhiều backend phổ biến
MACaQ cho phép lượng tử hóa và chạy model qua llama.cpp, vLLM, Diffusers và PyTorch. Huawei khuyến nghị dùng Python 3.12 và môi trường riêng cho từng backend; llama.cpp còn hỗ trợ chạy trên CPU.
- Diffusers: lượng tử hóa diffusion transformer, xuất checkpoint safetensors rồi tạo hình ảnh, video hoặc âm thanh. Với tác vụ image-to-video, ảnh điều kiện được dùng trong quá trình hiệu chỉnh (calibration). Các model được nêu gồm FLUX.2-klein-4B (tạo ảnh), Wan2.2-TI2V-5B (video và image-to-video) và stable-audio-1.0 (âm thanh).
- llama.cpp: lượng tử hóa model văn bản sang định dạng GGUF 2, 3 và 4 bit, kèm runtime để chạy. Danh sách ví dụ gồm Qwen3-4B, Qwen3.8-27B, Qwen3-30B-A3B, Qwen3-Coder-30B-A3B-Instruct, Qwen3.6-35B-A3B, OLMoE-1B-7B-0125-Instruct và Qwen3-Next-80B-A3B-Instruct.
- vLLM: lượng tử hóa model văn bản thành checkpoint gọn nhẹ, sau đó nạp để sinh văn bản hoặc phục vụ qua HTTP API. Chế độ suy luận mặc định là W4A4 (trọng số và activation đều 4 bit).
- PyTorch: lượng tử hóa các model sinh giọng nói sang W4A4, xuất file WAV; checkpoint đã lưu có thể nạp lại mà không cần hiệu chỉnh lần nữa.
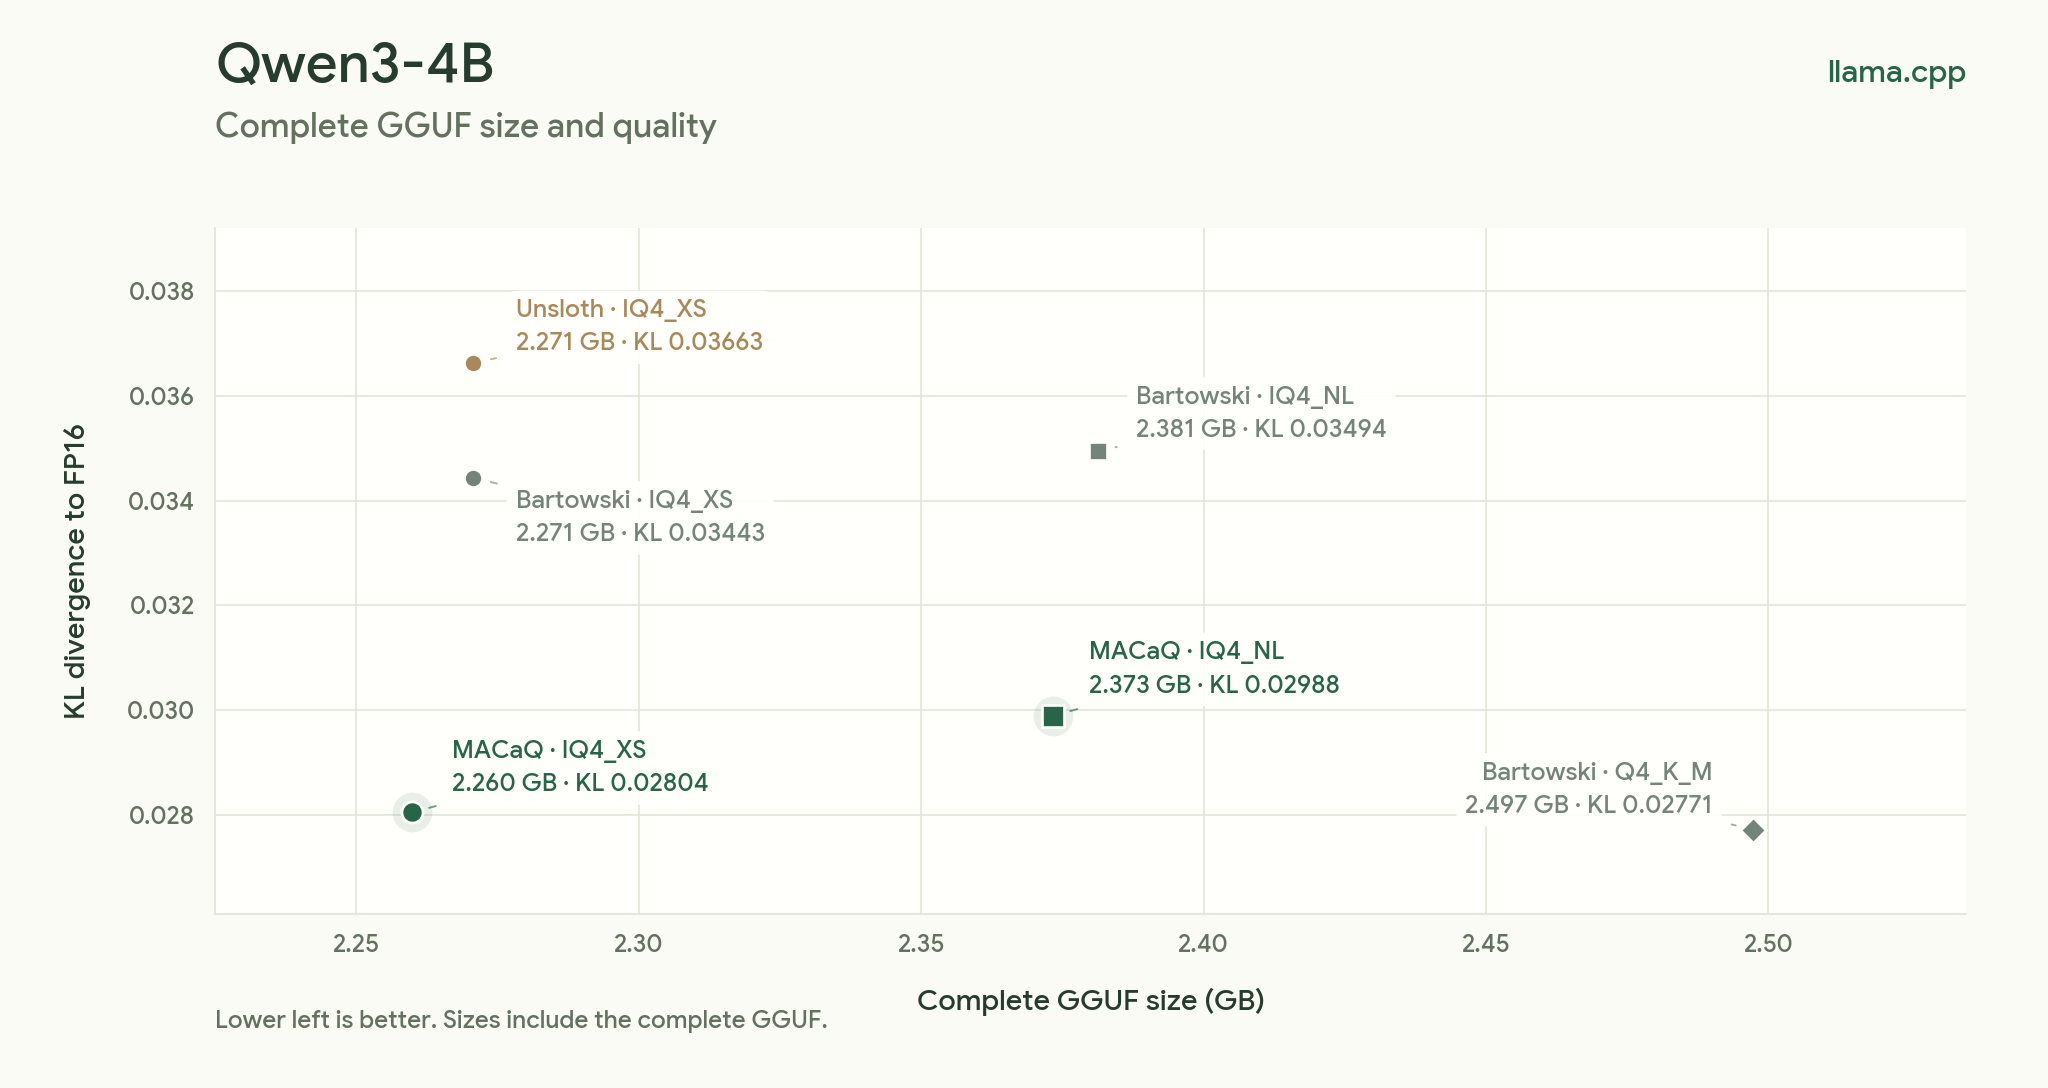 So sánh dung lượng và chất lượng của Qwen3-4B sau lượng tử hóa
Hiệu năng thực tế
Với Qwen3.8-27B chạy trên vLLM, Huawei công bố perplexity (độ "bối rối" — chỉ số càng thấp càng tốt) của bản gốc BF16 là 2,8463, còn bản MACaQ W4A4 là 2,8994. Đổi lại, tốc độ prefill đạt 2,33 lần và decode đạt 2,58 lần so với BF16 (quy ước BF16 = 1×).
Theo nhóm phát triển, MACaQ cho perplexity thấp hơn MR-GPTQ và DuQuant++, hoặc đạt perplexity tốt nhất của Llama-3-8B ngang bằng hai phương pháp trên nhưng với thời gian lượng tử hóa ít hơn 11 lần.
Huawei cũng cho biết các kernel matmul (phép nhân ma trận) W4A4 dạng dense và grouped của MACaQ đã có trong các pull request của CANN: ops-nn #12568 (kernel PTO-ISA qua ascend_ops_nn) và ops-tilelang #44 (kernel TileLang với backend CCE). Việc chạy toàn bộ model trên phần cứng Ascend vẫn cần tích hợp với một runtime suy luận của Ascend.
MACaQ được mô tả trong bài báo "MACaQ: Fast, Model Agnostic Calibrated Quantization for Low-Precision Weights and Activations" của Muller, Bich, Boretti, Chang, Zhuang và Cavigelli (2026, arXiv 2611.10649).
Góc nhìn
Với các nhóm kỹ sư đang tự host model, điểm hấp dẫn của MACaQ không nằm ở việc có thêm một công cụ lượng tử hóa, mà ở chỗ nó tách rời vấn đề "chất lượng sau nén" khỏi chi phí thời gian và bộ nhớ. Khả năng nén model 122 tỷ tham số trong khoảng một giờ với 32,5 GB VRAM cho thấy các nhóm không sở hữu cụm GPU lớn vẫn có thể thử nghiệm và tinh chỉnh bản nén cho riêng mình, thay vì phụ thuộc hoàn toàn vào các bản GGUF dựng sẵn.
Việc hỗ trợ sẵn llama.cpp và vLLM cũng giúp giảm rào cản chuyển đổi: đội ngũ có thể thử MACaQ trên pipeline hiện có, đo perplexity và tốc độ decode trước khi quyết định thay đổi. Tuy nhiên, con số hiệu năng trên là do Huawei công bố cho những model cụ thể, nên các nhóm nên tự đánh giá lại trên chính model và dữ liệu của mình trước khi đưa vào production.
Nguồn: github.com · Quy trình biên tập