Jev hỏi Opus khi thiếu tự tin: độ chính xác ngang Opus, chi phí rẻ hơn 4 lần
Hightouch thử nghiệm dùng mô hình quyết định (decision model) Jev và GPT-6 Luna để chấm điểm kết quả hợp nhất danh tính. Cách kết hợp Jev với Opus đạt độ chính xác gần bằng Opus chạy một mình nhưng rẻ hơn hơn 4 lần, nhờ Jev có độ tin cậy (calibration) tốt hơn Luna.
Hightouch vừa công bố kết quả thử nghiệm dùng mô hình ngôn ngữ để chấm điểm kết quả hợp nhất danh tính (identity resolution) — bài toán mà theo nhóm nghiên cứu, các đội dữ liệu thường mất hàng tháng chỉ để kiểm tra xem thuật toán của mình có chạy đúng hay không.
 Minh họa mô hình ngôn ngữ chấm điểm dữ liệu
Kết quả đáng chú ý nhất: một hệ thống kết hợp — Jev tự xử lý phần lớn trường hợp, chỉ chuyển các trường hợp thiếu chắc chắn sang Claude Opus 5.5 — đạt 98,8% độ chính xác với chi phí 0,88 USD cho 1.000 danh tính, trong khi Opus chạy một mình đạt 99,0% nhưng tốn 3,86 USD. Trên bộ dữ liệu khó hơn, khoảng cách còn rõ hơn: hệ thống lai dùng Jev đạt 95,3% so với 95,1% của Opus, với chi phí 2,94 USD thay vì 5,39 USD.
Bài toán: không có đáp án để đối chiếu
Hợp nhất danh tính là quá trình ánh xạ các bản ghi dữ liệu về đúng người thật. Ví dụ, một khách hàng có thể xuất hiện dưới nhiều bản ghi khác nhau — thẻ khách hàng thân thiết, giao dịch, địa chỉ giao hàng — với email hoặc địa chỉ lệch nhau, và hệ thống phải gộp chúng thành một danh tính duy nhất.
Vấn đề nan giải là gộp thừa (over-merging): một danh tính bị gán nhầm cho nhiều người khác nhau. Trên dữ liệu thực, không có "bảng đáp án" nào để đối chiếu — nếu có thì đã dùng luôn để so khớp. Các đội thường phải lấy mẫu thủ công, đạt tốc độ khoảng 50 danh tính mỗi giờ, và cần hơn 1.000 mẫu mới ước lượng được tỷ lệ gộp thừa với sai số dưới ±1%.
Nhóm Hightouch đặt giả thuyết: nếu mô hình ngôn ngữ chấm được danh tính với độ chính xác tương đương con người, có thể chạy song song hàng loạt mô hình để đánh giá 100.000 danh tính trong vài giây.
Thử nghiệm với dữ liệu giả lập
Nhóm dùng pseudopeople, công cụ của Viện Đo lường và Đánh giá Sức khỏe (IHME) thuộc Đại học Washington, để mô phỏng một thị trấn Mỹ hư cấu với dữ liệu từ nhiều nguồn: điều tra dân số, khảo sát hộ gia đình, chương trình trợ cấp WIC, an sinh xã hội và các biểu mẫu thuế W-2, 1040, giai đoạn 2020–2040.
Họ tạo 1.000 danh tính, một nửa là một người với dữ liệu nhiễu, một nửa là gộp thừa, rồi thêm các lỗi thực tế như gõ sai (Valentino → Valentinp), đọc nhầm ký tự (Sam → 5am), đảo ngày/tháng, biệt danh, tên giả hoặc trường để trống.
Kết quả ở mức cơ bản:
- Claude Opus 5.5: 99,0% độ chính xác, 2,2 giây và 3,86 USD cho mỗi 1.000 danh tính
- Gemini 3.1 Pro: 98,3%, 4,2 giây, 4,48 USD
- GPT-6 Sol: 98,3%, 2,1 giây, 2,50 USD
- GPT-6 Luna (Decisions API): 97,3%, 0,17 giây, 0,10 USD
- Jev: 95,7%, 0,15 giây, 0,05 USD
Các mô hình quyết định rẻ hơn tới 90 lần và nhanh hơn hơn 10 lần so với mô hình biên, nhưng kém Opus khoảng 6 điểm phần trăm trên các bài kiểm tra khó.
Điểm mấu chốt: độ tin cậy được hiệu chuẩn
Khi tăng độ khó — chỉ giữ các trường hợp đánh lừa như sinh đôi, cha con trùng tên, hoặc lỗi chính tả ở trường quan trọng — Luna tụt xuống ngang Jev. Nhưng điều đáng chú ý nằm ở cách hai mô hình thể hiện sự thiếu chắc chắn.
Phần lớn sai sót của Jev rơi vào vùng tin cậy gần 50% — đúng như kỳ vọng của một mô hình được hiệu chuẩn tốt. Luna thì ngược lại: tự tin quá mức, nhiều lỗi nằm trong khoảng 90–100%, và trên bộ dữ liệu khó, mức tự tin sai lệch này còn nghiêm trọng hơn.
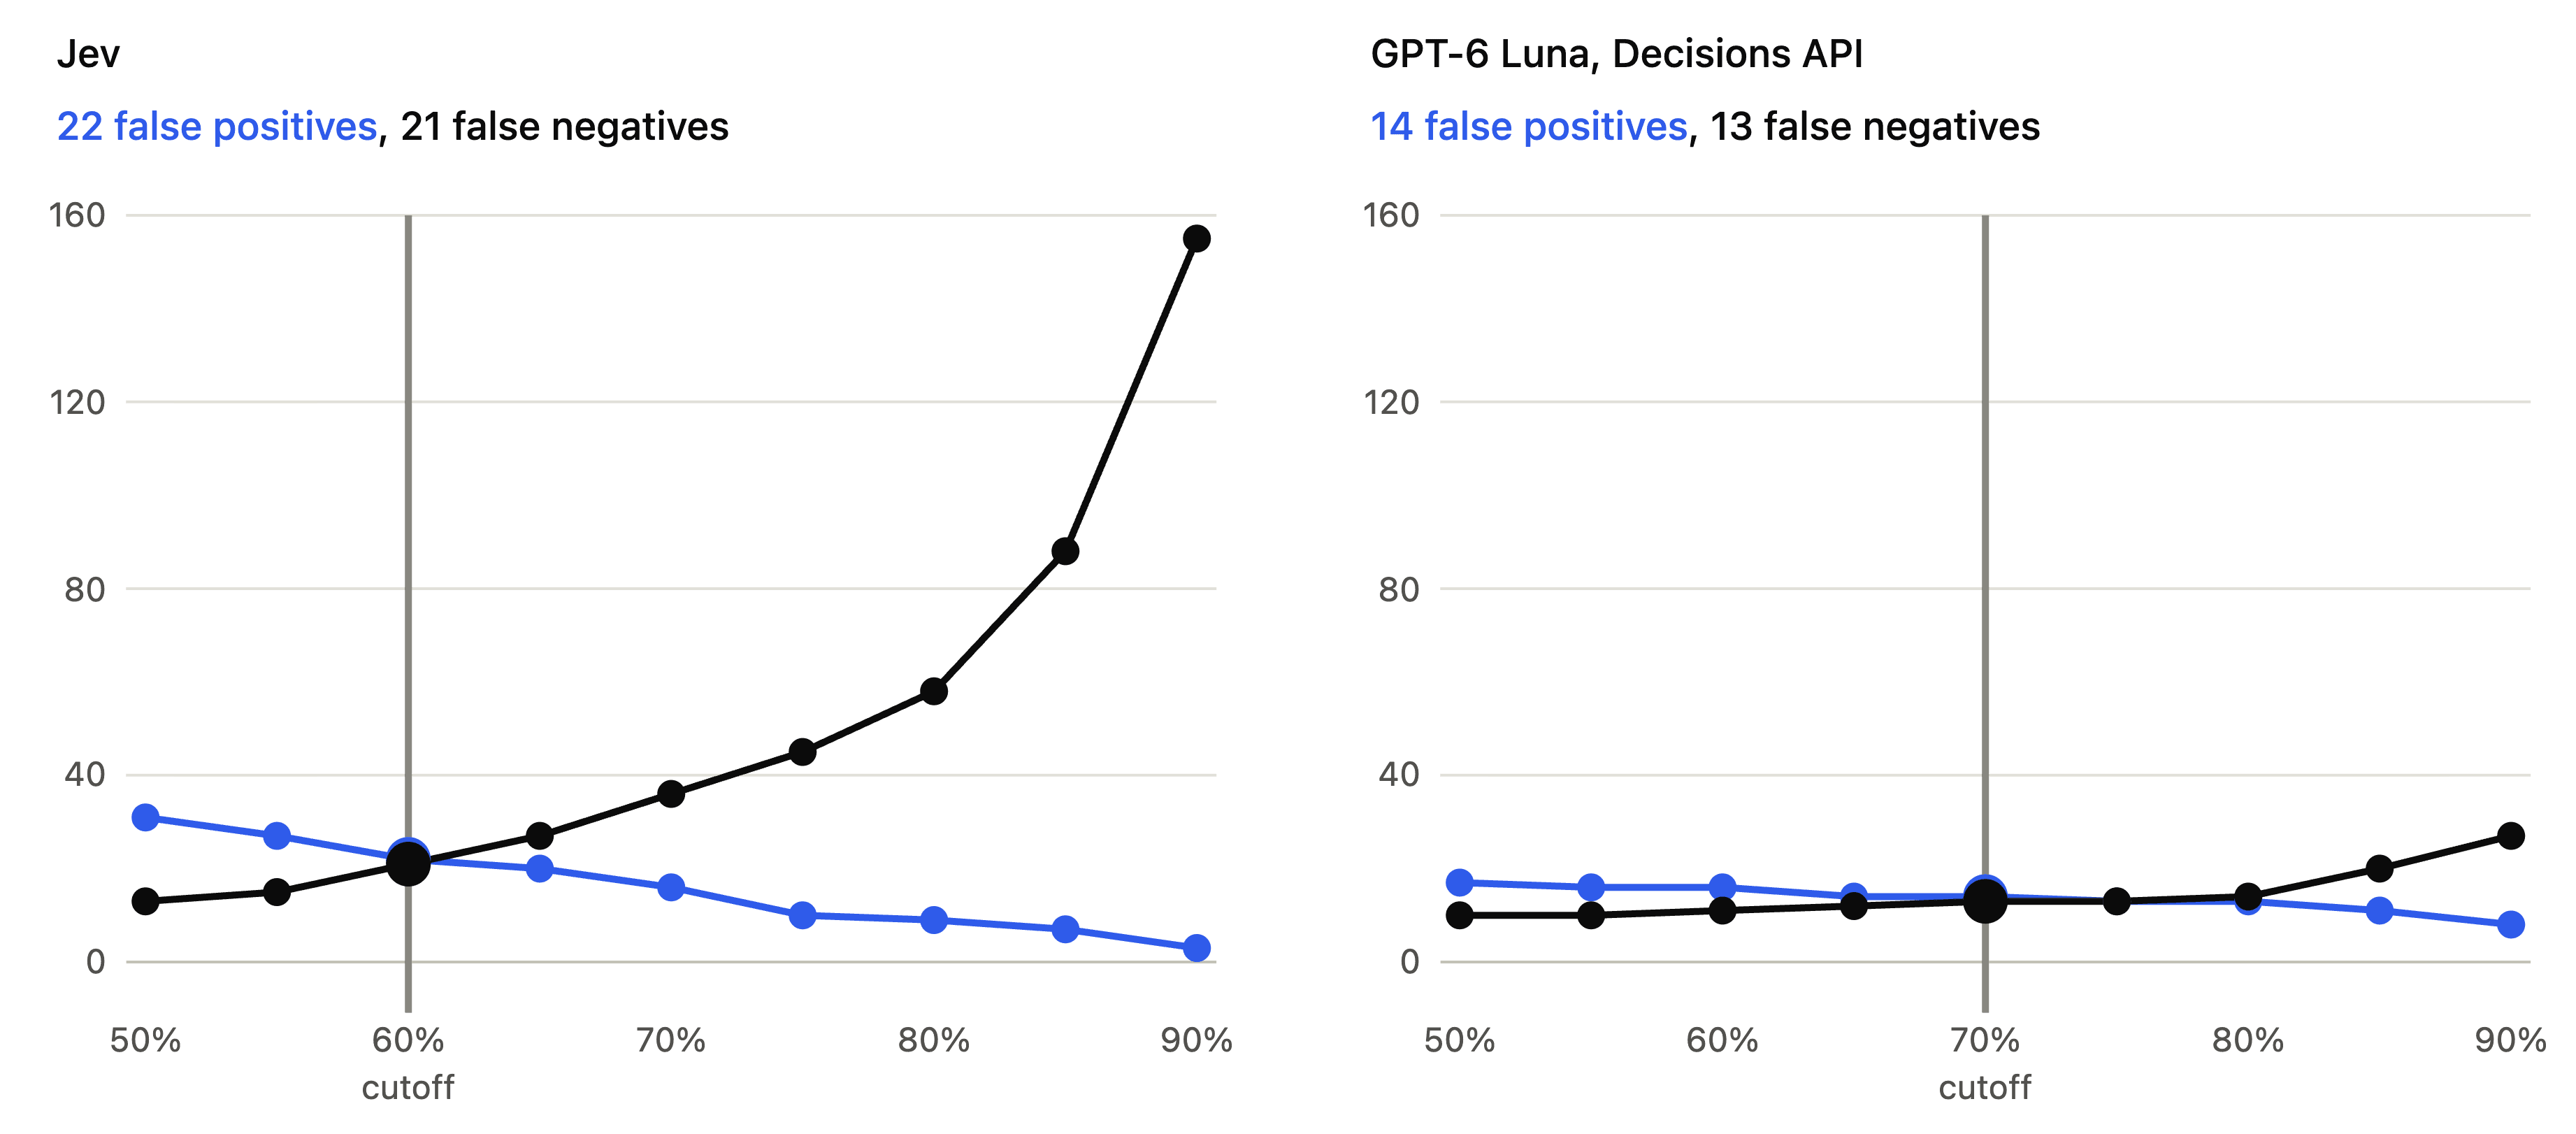 Biểu đồ phân bố độ tin cậy của các mô hình
Chính đặc điểm này quyết định hiệu quả của mô hình lai. Với Jev, chỉ cần chuyển các trường hợp có độ tin cậy 30–90% sang Opus (chiếm 22% tổng số) là đạt 98,8% độ chính xác với 0,88 USD. Với Luna, để đạt mức tương đương phải chuyển tới 54% trường hợp khi dùng ngưỡng 10–100%, tốn 2,19 USD.
Khi dữ liệu khó lên, hệ thống tự tăng chi
Trên bộ kiểm tra khó hơn, hệ thống lai dùng Jev tự động chuyển nhiều trường hợp hơn sang Opus mà không cần thay đổi lời nhắc hay cấu trúc nào — chi phí tăng lên 2,94 USD nhưng vẫn rẻ hơn đáng kể so với 5,39 USD khi dùng Opus một mình, và độ chính xác còn nhích hơn (95,3% so với 95,1%).
Ngược lại, hệ thống lai dùng Luna chỉ đạt 91,6% trên bộ khó, dù rẻ hơn (1,15 USD).
"Bạn không bao giờ biết trước dữ liệu thực tế sẽ khó đến mức nào, nên một hệ thống tự động tăng chi phí khi cần để giữ độ chính xác là điều rất giá trị."
Nhóm nghiên cứu cho biết sẽ tiếp tục công bố về bài toán gộp thiếu (under-merging) và mức suy giảm hiệu năng khi chuyển sang các mô hình quyết định mở thay vì API độc quyền.
Góc nhìn
Kết quả này đáng chú ý với các kỹ sư và đội dữ liệu Việt Nam đang xây dựng pipeline khách hàng thống nhất (customer data platform) hoặc làm sạch dữ liệu cho phân tích. Bài học lớn nhất không phải là chọn mô hình nào mạnh nhất, mà là đo độ tin cậy của mô hình rẻ trước khi ghép nó vào hệ thống. Một mô hình như Luna có vẻ tốt hơn khi chạy đơn lẻ lại kém hiệu quả trong kiến trúc lai vì tự tin sai — trong khi Jev, dù yếu hơn, lại là "người gác cổng" tốt hơn.
Về mặt chi phí, các mô hình quyết định ở mức 0,05 USD cho 1.000 danh tính đủ rẻ để chạy đánh giá liên tục ngay trong quy trình phát triển, thay vì lấy mẫu thủ công vài trăm bản ghi mỗi đợt. Tuy nhiên cần lưu ý: chi phí và độ trễ trong bài là số đo trên thiết lập riêng của Hightouch, sẽ thay đổi theo triển khai thực tế, và dữ liệu thử nghiệm là giả lập — hiệu năng trên dữ liệu khách hàng thật vẫn cần được kiểm chứng trước khi tin tưởng hoàn toàn.
Nguồn: hightouch.com (bài gốc ngày 07 tháng 11, 2026) · Quy trình biên tập