Kolmogorov–Arnold Networks: Khi mạng nơ-ron học hàm số thay vì trọng số
Kolmogorov–Arnold Networks (KAN) thay thế trọng số vô hướng bằng các hàm số có thể học được, mở ra khả năng truy ngược phương trình từ dữ liệu. Bài viết khám phá quá trình xây dựng KAN với các hàm bậc hai, B-spline và đa thức Chebyshev, cùng thử nghiệm tái tạo phương trình Lorenz từ dữ liệu tổng hợp.
Kolmogorov–Arnold Networks: Khi mạng nơ-ron học hàm số thay vì trọng số
Cách đây hai năm, những thảo luận về Kolmogorov–Arnold Networks (KAN) bắt đầu tràn ngập các bảng tin công nghệ. Điều khiến KAN trở nên đặc biệt là nó thay thế các trọng số vô hướng quen thuộc bằng những hàm số có thể học được, qua đó mở ra một câu hỏi hấp dẫn: liệu chúng ta có thể không chỉ kiểm tra độ chính xác dự phóng của mạng, mà còn khám phá chính những hàm mà nó học, và thậm chí chuyển mạng đã huấn luyện trở lại thành một phương trình?
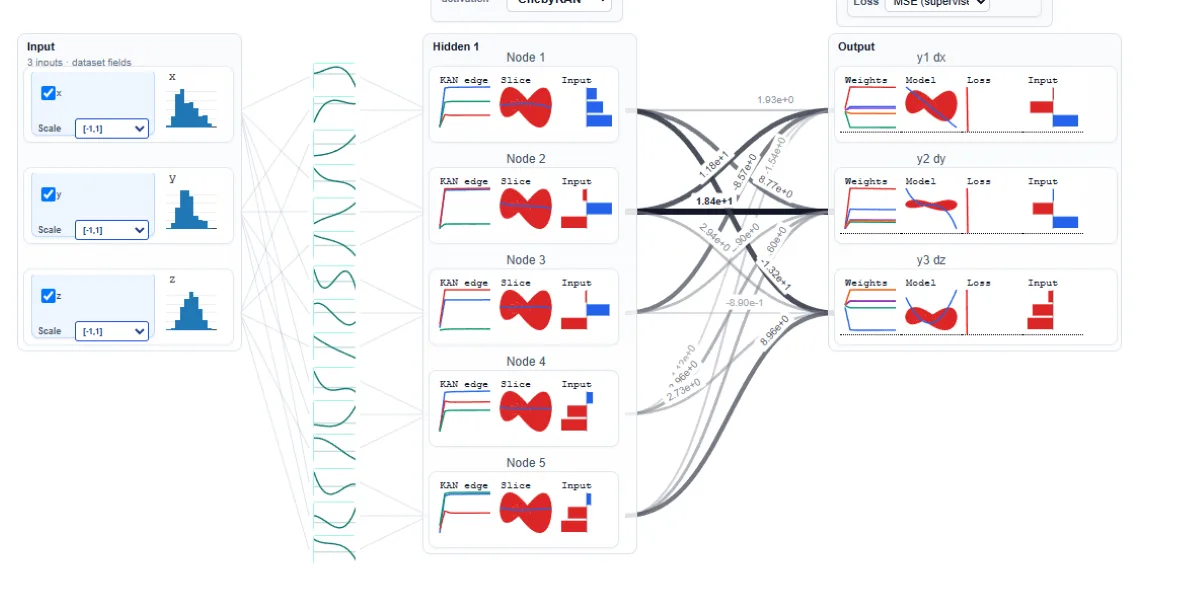
 Minh họa mạng nơ-ron và hàm số học được
KAN là gì và vì sao nó đáng quan tâm?
KAN được đề xuất năm 2024, lấy cảm hứng từ định lý biểu diễn Kolmogorov–Arnold. Hiểu đơn giản, định lý này phát biểu rằng một hàm liên tục nhiều biến trên một miền bị chặn có thể được biểu diễn thông qua phép hợp và phép cộng của các hàm liên tục một biến.
Điểm cốt lõi với KAN là: một hàm phức tạp nhiều biến có thể được xây dựng từ tập hợp các hàm một chiều đơn giản hơn. KAN hiện thực hóa ý tưởng này bằng cách thay mỗi trọng số vô hướng trên các kết nối giữa các nút bằng một hàm một biến có thể học được.
Trong mạng feed-forward truyền thống, mỗi kết nối đóng góp một số hạng dạng w·x, sau đó nút cộng các đầu vào và áp dụng hàm kích hoạt. Ở KAN, mỗi cạnh thay vào đó áp dụng một phép biến đổi đã học φ(x), rồi nút mới cộng các kết quả đã biến đổi lại.
Có thể hình dung đây là hai thay đổi: thứ nhất, chuyển phép biến đổi phi tuyến từ nút xuống từng cạnh; thứ hai, tham số hóa các hàm cạnh đó bằng B-spline hoặc một họ hàm phù hợp khác.
Từ trọng số đến hàm cạnh có thể học
Trong mạng thông thường, ta học các giá trị w và b, áp dụng chúng theo dạng tuyến tính wx + b, cộng tổng rồi mới áp dụng hàm kích hoạt σ như ReLU hay Tanh.
Để huấn luyện trên các cạnh, ta áp dụng phi tuyến lên từng đầu vào trước khi lấy tổng. Đây chưa phải KAN đầy đủ: để có KAN thực sự, ta cần thay cả trọng số vô hướng lẫn hàm kích hoạt cố định bằng một hàm cạnh đơn biến φᵢⱼ(xᵢ) có thể học.
Khác với mạng thông thường nơi mỗi cạnh có thể biểu diễn bằng một số vô hướng, ở KAN mỗi cạnh phải tự đánh giá hàm φᵢⱼ của riêng nó. Chi phí tính toán vì thế phụ thuộc cả vào số cạnh lẫn độ phức tạp của hàm được chọn — khiến cả lan truyền tiến lẫn huấn luyện đều đắt đỏ hơn đáng kể.
Thử nghiệm đầu tiên: hàm cạnh bậc hai
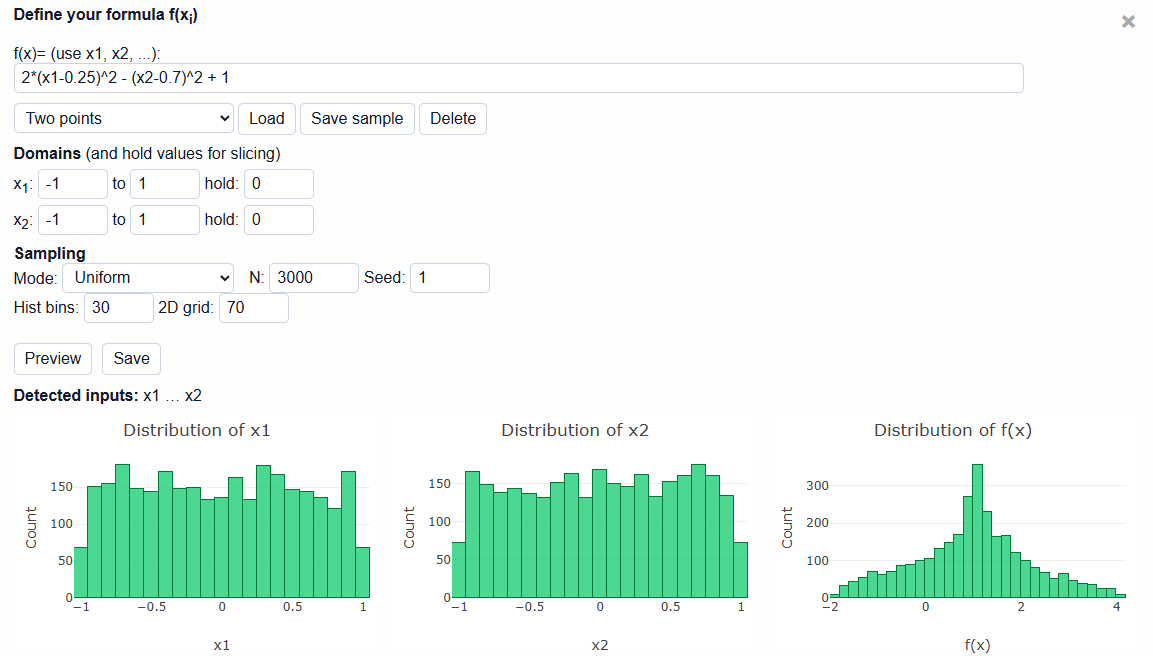
Tác giả bài viết gốc bắt đầu bằng một bộ dữ liệu tổng hợp rất đơn giản, chỉ hai đầu vào và một đầu ra, dựa trên hàm bậc hai:
2(x₁ − 0,25)² − (x₂ − 0,7)² + 1
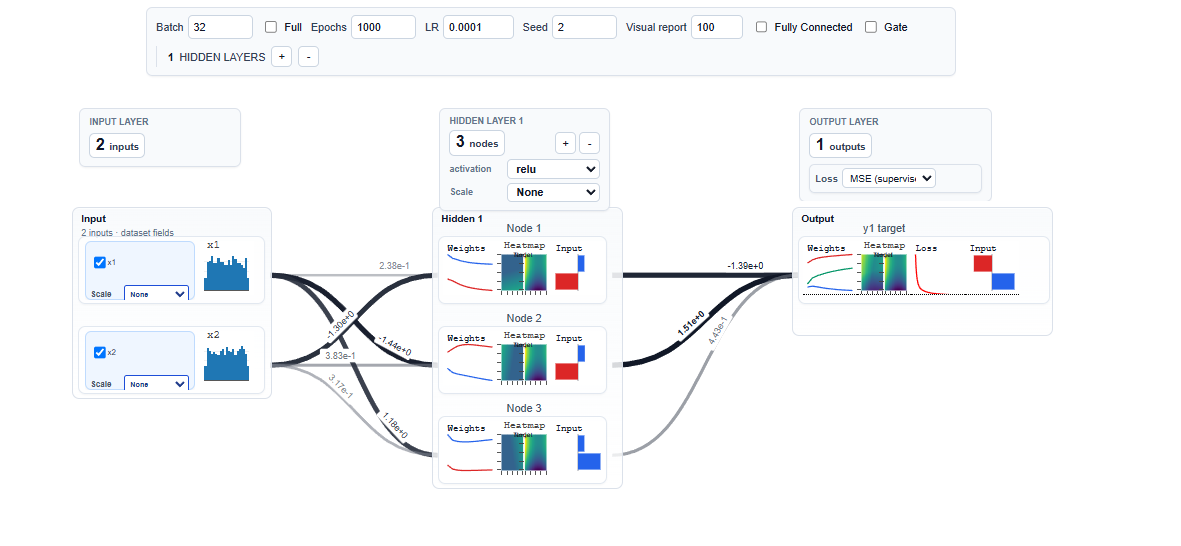
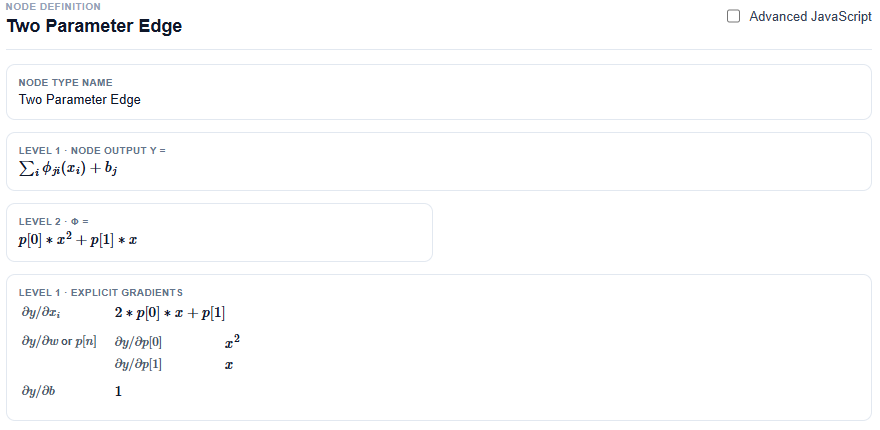
Hàm cạnh được thiết kế cũng là bậc hai với hai tham số có thể huấn luyện, cho phép quan sát trực quan các phép biến đổi mà mạng học được. Sau khi huấn luyện, điều thú vị là chỉ cần một nút là đủ, vì mỗi đầu vào được biến đổi độc lập.
Điểm mạnh của ví dụ này là có thể "thu gọn" toàn bộ kiến trúc thành một đa thức. Kết quả học được:
y = −0,991x₂² + 1,393x₂ + 2,053x₁² − 0,994x₁ + 0,613
gần như trùng khớp với hàm mục tiêu ban đầu. Đây là minh chứng rõ ràng: sau khi huấn luyện, không còn lý do gì phải dùng mạng dưới dạng feed-forward nữa — ta có thể đánh giá trực tiếp đa thức.
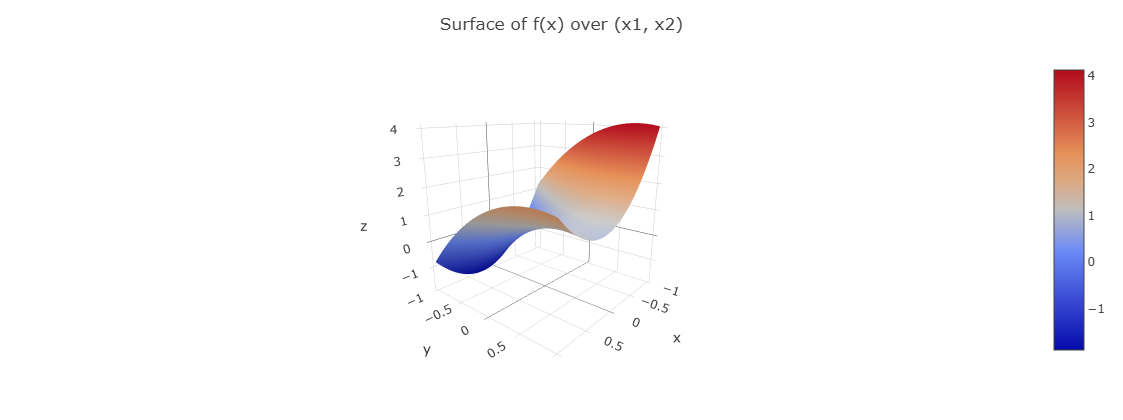 So sánh bề mặt hàm học được và hàm mục tiêu
Linh hoạt hóa các cạnh bằng B-spline
Câu hỏi tự nhiên là: điều gì xảy ra nếu hàm trên mỗi cạnh được làm linh hoạt hơn để học được nhiều dạng hàm hơn? Đây chính là bước dẫn tới KAN đầy đủ.
B-spline là hàm đa thức từng khúc được định nghĩa trên một tập các nút (knot). Bậc của đa thức cùng số lượng và khoảng cách các nút quyết định độ linh hoạt của biểu diễn. Với tập nút đủ dày, cơ sở B-spline có thể xấp xỉ một hàm liên tục tới độ chính xác tùy ý — đặc tính khiến spline trở thành lựa chọn phù hợp trong đề xuất KAN ban đầu.
Với B-spline, hàm cạnh trở thành tổng có trọng số của các hàm cơ sở:
φ = Σ aⱼᵢᵣ · Bᵣ(xᵢ)
Các hệ số aⱼᵢᵣ được học trong quá trình huấn luyện. Tăng số hàm cơ sở sẽ tăng độ linh hoạt, nhưng cũng làm tăng số tham số cần học.
Tuy nhiên, khi thử thu gọn mạng thành một đa thức duy nhất, ta gặp vấn đề mới: vì các hàm cạnh được xây từ đa thức từng khúc, biểu diễn đại số chính xác của chúng cũng là từng khúc. Số lượng đầu vào, nút và lớp càng tăng thì biểu diễn ký hiệu càng trở nên phức tạp. Phương pháp trích xuất biểu diễn ký hiệu trong bài báo KAN gốc thường phải "khớp" hàm học được về một dạng ký hiệu ứng viên, nghĩa là đó là xấp xỉ rút gọn chứ không hẳn là hàm chính xác mạng đã học.
Đa thức Chebyshev: hướng tiếp cận khác
Để có thể học một hàm toàn cục và chuyển thẳng thành biểu thức ký hiệu, ta có thể dùng một họ hàm khác: đa thức Chebyshev. Đây là dãy đa thức trực giao, định nghĩa đệ quy, có khả năng cực tiểu hóa sai số lớn nhất giữa đa thức và hàm mục tiêu trên một khoảng cho trước.
Vài đa thức Chebyshev đầu tiên:
- T₀(x) = 1
- T₁(x) = x
- T₂(x) = 2x² − 1
- T₃(x) = 4x³ − 3x
 Đồ thị các đa thức Chebyshev
Chebyshev chỉ "ngoan" trên khoảng [−1, 1]; ngoài khoảng này độ lớn của chúng có thể tăng rất nhanh, đặc biệt với bậc cao. Vì vậy đầu vào thường được chuẩn hóa về [−1, 1] trước khi đưa vào cơ sở Chebyshev.
Hàm cạnh bậc n được viết thành tổng tuyến tính của các đa thức Chebyshev:
φ(x) = Σ cₖ · Tₖ(x)
Với bài toán tổng hợp ban đầu, mạng ChebyKAN cho kết quả rất ấn tượng: các số hạng bậc ba bị triệt tiêu và hàm học được gần như trùng khớp với hàm mục tiêu, đúng dạng phương trình mà mạng cần học.
Có thể phục hồi một hệ vật lý?
Được khích lệ, tác giả thử nghiệm với phương trình chuyển động quen thuộc: s = ut + ½at², với giá trị u và a cố định, tạo ra hàm 2x + 1,5x² trên miền x ∈ [0, 5]. Vì đây là bài toán một vào một ra nên rất đơn giản.
Sau huấn luyện, mạng thu gọn cho:
y ≈ 2,88×10⁻⁹x³ + 1,500x² + 2,000x + 1,02×10⁻⁸
Các số hạng bậc ba và hằng số thực tế bằng 0, còn lại ŷ ≈ 1,5x² + 2x — phục hồi gần như chính xác phương trình sinh dữ liệu.
Thử sức với phương trình Lorenz
Tự tin hơn, tác giả thử phục hồi phương trình Lorenz — hệ phương trình mô tả đối lưu khí quyển, ví dụ kinh điển về hành vi hỗn loạn. Với các tham số chuẩn σ = 10, ρ = 28, β = 8/3:
- ẋ = 10y − 10x
- ẏ = 28x − xz − y
- ż = xy − (8/3)z
Kết quả với kiến trúc KAN một lớp: phương trình đầu tiên (thuần cộng) được phục hồi khá tốt với các hệ số 9,991y và −9,996x. Nhưng phương trình thứ hai và thứ ba thì hoàn toàn không phục hồi được.
Lý do nằm ở hạn chế của kiến trúc một lớp: mỗi đầu vào được biến đổi độc lập rồi cộng lại, tạo ra mô hình dạng f(x, y, z) = φₓ(x) + φ_y(y) + φ_z(z). Kiểu kiến trúc này biểu diễn được quan hệ cộng, nhưng không trực tiếp tạo được số hạng tương tác như xz hay xy — vốn là cốt lõi của hai phương trình sau.
Khi thêm một lớp để tạo số hạng tương tác, kết quả ban đầu trông rất hứa hẹn, nhưng hóa ra mạng chủ yếu học các quan hệ đủ để tái tạo quỹ đạo Lorenz đã lấy mẫu. Vì các biến trên quỹ đạo Lorenz có tương quan mạnh và chỉ chiếm một vùng hẹp của không gian trạng thái, nhiều biểu thức đa thức khác nhau có thể cho dự phóng tương tự — khiến việc phục hồi phương trình gốc bị ràng buộc yếu.
Khi thử lại với các điểm lấy mẫu độc lập trên toàn không gian trạng thái và chạy 100 lần, bức tranh thay đổi rõ rệt. Một số lần chạy phục hồi cả bảy hệ số vật lý quan trọng với sai số chỉ vài phần trăm.
 Phân bố hệ số phục hồi qua 100 lần chạy
Dự phóng tốt không đồng nghĩa phục hồi đúng phương trình
Bài học quan trọng nhất rút ra: khi xấp xỉ các hệ vật lý thực, có thể tồn tại nhiều quan hệ toán học tái tạo dữ liệu quan sát khá tốt. Một hàm mất mát dự phóng chỉ đo mức khớp với đầu ra được cung cấp — nó không cho biết mô hình đã phục hồi đúng quan hệ sinh ra dữ liệu hay chưa.
Cách lấy mẫu dữ liệu cũng rất quan trọng. Nếu đầu vào chỉ chiếm một vùng hẹp của không gian trạng thái, mạng có thể học cấu trúc của dữ liệu lấy mẫu thay vì quy luật chi phối thực sự.
Khi vẽ mất mát dự phóng cuối cùng của mỗi lần chạy đối chiếu với độ chính xác phục hồi hệ số, tác giả nhận thấy các mô hình có mất mát thấp thường phục hồi hệ số tốt hơn, nhưng quan hệ này không hề chặt chẽ. Một số mô hình đạt mất mát rất thấp lại phục hồi hệ số kém, trong khi có mô hình mất mát cao hơn lại tái tạo hệ số chính xác hơn.
Hiệu năng dự phóng tốt không suy ra quan hệ chi phối đúng.
Điều này đặc biệt quan trọng khi mạng nơ-ron được dùng làm mô hình khoa học. Có thể bổ sung ràng buộc để hướng mạng tới nghiệm có ý nghĩa vật lý — ví dụ Physics-Informed Neural Networks (PINNs) đưa các quan hệ vật lý đã biết vào quá trình tối ưu. Nhưng câu hỏi đặt ra ở đây là mạng có thể đi được bao xa mà không bị ép buộc hướng tới phương trình đúng.
Góc nhìn cho cộng đồng AI Việt Nam
Với các nhóm nghiên cứu và kỹ sư AI tại Việt Nam đang làm việc trong lĩnh vực mô hình hóa khoa học, KAN gợi ý một hướng đi đáng chú ý: thay vì chỉ dùng mạng như "hộp đen", ta có thể thiết kế kiến trúc sao cho hàm học được có thể chuyển thẳng thành biểu thức ký hiệu. Điều này đặc biệt hữu ích trong các bài toán như dự báo môi trường, mô phỏng vật liệu hay phân tích dữ liệu cảm biến — nơi việc hiểu cơ chế quan trọng không kém gì độ chính xác dự phóng.
Tuy nhiên, cần lưu ý một cảnh báo lớn: cho tới nay các thử nghiệm thành công đều dựa trên lượng lớn kiến thức tiên nghiệm. Tác giả biết trước dạng phương trình Lorenz, biết mình đang tìm hệ số nào và thiết kế mạng cùng thử nghiệm xoay quanh chúng. Việc phục hồi một định luật vật lý chưa biết hoàn toàn từ dữ liệu vẫn là bài toán khó hơn nhiều — và đó chính là biên giới mà các nhà nghiên cứu KAN cần tiếp tục vượt qua.