Kỷ nguyên của Kỹ sư Trí tuệ Dữ liệu
Jordan Tigani, CEO MotherDuck, cho rằng AI đã thay đổi căn bản công việc của đội ngũ dữ liệu: agent viết SQL, dựng dashboard và pipeline thay con người, khiến vai trò truyền thống dần mai một. Ông đề xuất một chức danh mới — Kỹ sư Trí tuệ Dữ liệu — người chịu trách nhiệm về mô hình dữ liệu, ngữ cảnh, kiểm thử eval và giám sát agent.
Trong một bài viết trên blog MotherDuck, Jordan Tigani kể lại câu trả lời của Nick Ursa — kỹ sư dữ liệu trưởng kiêm đồng sáng lập công ty — khi được hỏi AI đã thay đổi công việc của anh thế nào: "Đây là lần đầu tiên trong sự nghiệp tôi không còn backlog." Nhưng thay vì rảnh rỗi, anh lại bận hơn bao giờ hết, vì giờ đây nhiệm vụ là đảm bảo những con số do LLM hay agent đưa ra phải đúng.
Từ quan sát đó, Tigani đề xuất một chức danh mới cho vai trò đang hình thành trong các đội dữ liệu được AI hỗ trợ: Kỹ sư Trí tuệ Dữ liệu (Data Intelligence Engineer). Ông trình bày ý tưởng này tại sự kiện Data Outpost ngày 4/11.
Vấn đề cũ: câu hỏi đi qua quá nhiều tay
Mục tiêu duy nhất của một đội dữ liệu là giúp doanh nghiệp ra quyết định tốt. Nhưng con đường từ câu hỏi đến câu trả lời vốn là một chuỗi chuyển tiếp: lãnh đạo marketing thấy tỷ lệ rời bỏ (churn) tăng đột biến, mở ticket cho đội dữ liệu; chuyên viên phân tích phát hiện thiếu dữ liệu từ một nguồn, lại mở ticket cho kỹ sư dữ liệu; kỹ sư sửa pipeline, kiểm thử, chạy backfill, kiểm thử lại — rồi trả bóng về cho chuyên viên phân tích dựng dashboard.
Khi dashboard xong thì người đặt câu hỏi đã quên mất lý do ban đầu, và tỷ lệ churn có khi đã tự hồi phục. Không ai làm sai, nhưng mỗi lần chuyển giao đều tốn thời gian, mất ngữ cảnh, và giá trị của câu trả lời giảm dần theo thời gian.
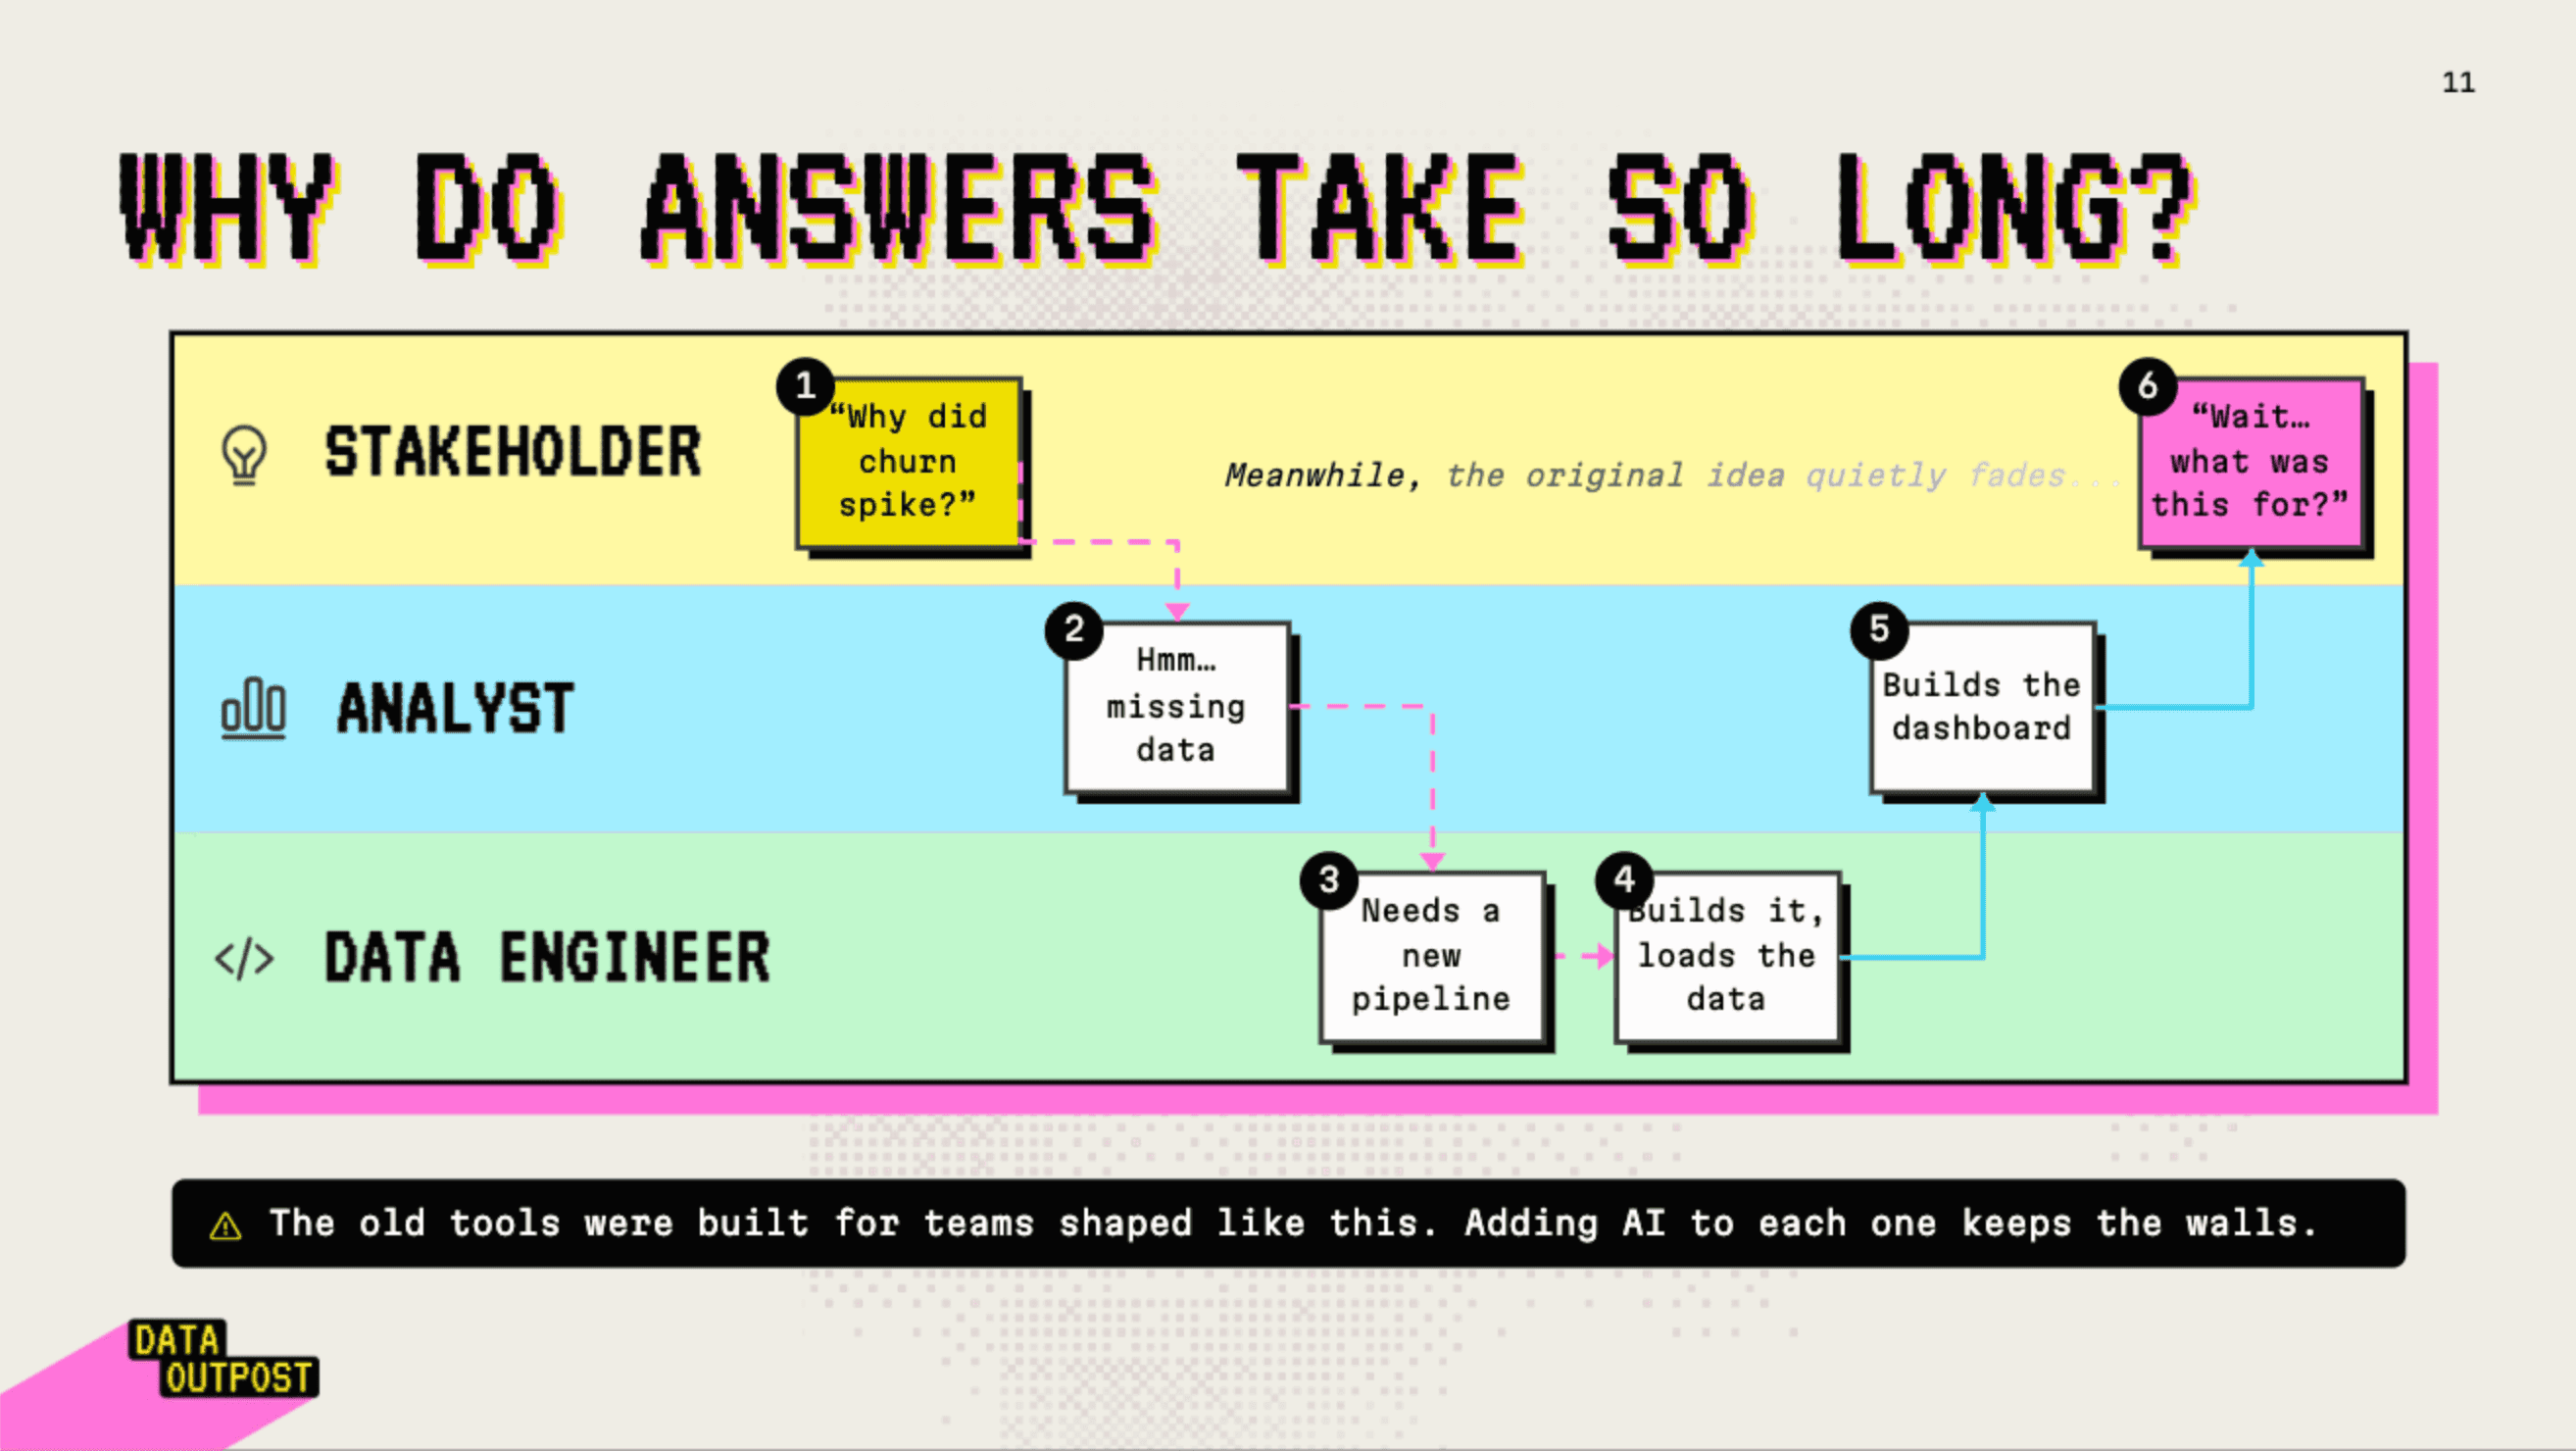 Vì sao câu trả lời mất quá lâu
Thế hệ công cụ AI kiểu co-pilot trước đây chỉ tăng tốc từng chặng, nhưng không giải quyết được gốc rễ: vẫn quá nhiều điểm chuyển giao để có thể hành động kịp thời.
Điều gì đã khác lần này
Trước tháng 12/2025, rất dễ phản bác việc dùng AI cho phân tích: LLM viết SQL kém, logic nghiệp vụ không thể nắm bắt. Tigani từng nói các đội dữ liệu gần như miễn nhiễm với làn sóng gián đoạn đang diễn ra ở các mảng phần mềm khác.
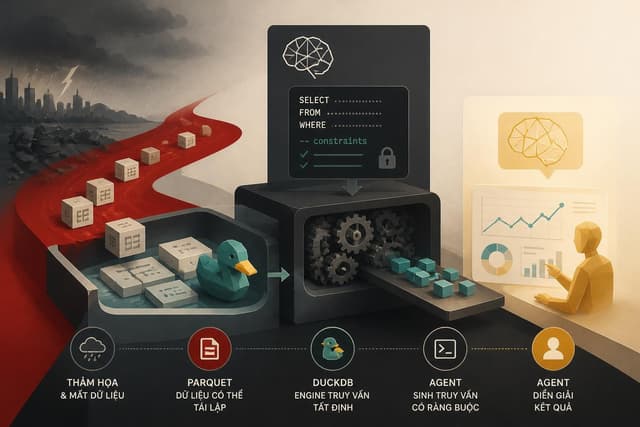
Rồi mọi thứ thay đổi: các mô hình mới viết SQL tốt hơn, agent có thể suy ra logic nghiệp vụ khi được cung cấp ngữ cảnh phù hợp, và quan trọng nhất là agent chuyển sang đa lượt (multi-turn) — không cần đúng ngay lần đầu, mà có thể thử một truy vấn, xem kết quả rồi thử lại, giống hệt một chuyên viên phân tích con người.
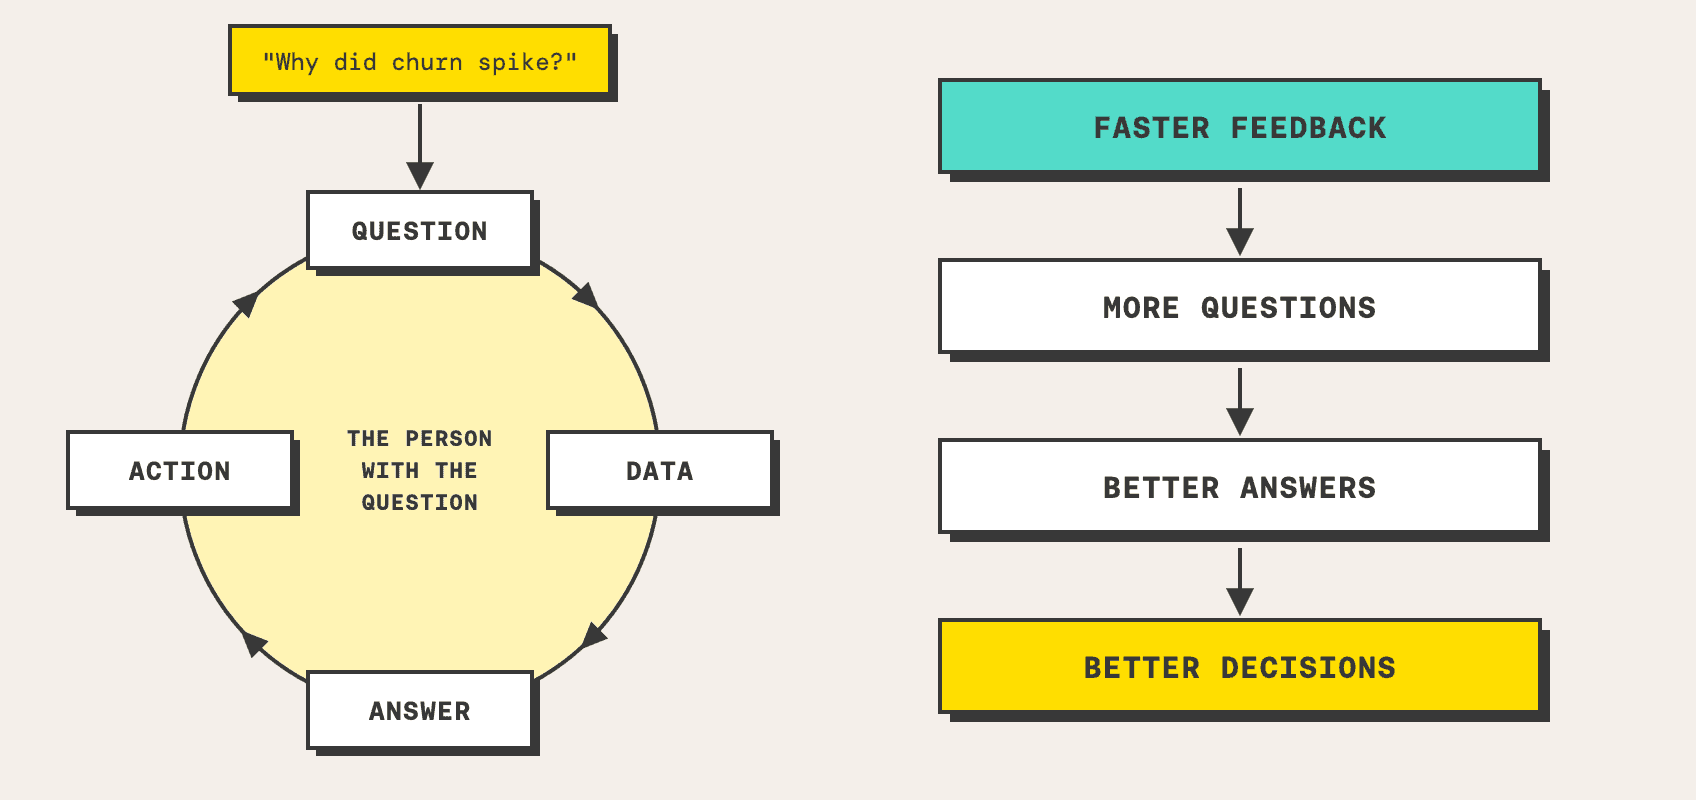 Vòng lặp phản hồi của agent
Để chứng minh, Tigani cho biết bài thuyết trình tại Data Outpost không phải file PowerPoint hay Google Slides mà là một ứng dụng do chính ông dựng bằng MotherDuck và Claude, dùng dữ liệu trực tiếp từ bốn nguồn khác nhau với nhiều biểu đồ tương tác — và ông không đọc một dòng code hay SQL nào. Ông nhấn mạnh: nếu dựng được dashboard bằng câu lệnh, người dùng nghiệp vụ cũng có thể tiến xa hơn và dựng cả ứng dụng hoàn chỉnh.
Lợi ích lớn hơn việc rút ngắn backlog là người ra quyết định có thể tự đặt câu hỏi, hỏi tiếp khi ngữ cảnh còn nóng, và quyết định tự tin hơn, nhanh hơn.
Việc gì có thể "biến thành prompt"?
Tigani đặt câu hỏi có phần khiêu khích: công việc nào của đội dữ liệu có thể thay bằng một prompt? Câu trả lời khá thẳng thắn: khá nhiều. Viết truy vấn SQL, tạo dashboard, dựng pipeline dbt — trong tương lai không xa sẽ không còn là việc đòi hỏi kiến thức chuyên biệt. Agent có lẽ đã giỏi hơn con người ở những việc này. Nick Ursa đã nâng cấp Airflow từ phiên bản này sang phiên bản khác trong một cuối tuần với rất ít giám sát — việc trước đây mất cả tuần.
Nhưng viết code, SQL hay dựng dashboard chưa bao giờ là toàn bộ công việc. Nhu cầu về dữ liệu chính xác và khả năng hiểu nó không biến mất. Và phải có người chịu trách nhiệm, ký duyệt và nói "đúng rồi". Như Nick nói: "Kỹ thuật dữ liệu, bất kể công cụ hay ai làm, là một chức năng chịu trách nhiệm."
Điều gì vẫn cần con người
Khi agent đã viết code, phần việc của con người vẫn còn rất nhiều. Họ phải đảm bảo các bên liên quan không có chữ "dữ liệu" trong chức danh vẫn giải quyết được vấn đề bằng dữ liệu. Điều đó đòi hỏi một mô hình dữ liệu sạch với ngữ cảnh và chú thích phù hợp, một bộ khái niệm (ontology) rõ ràng để các thuật ngữ được dùng nhất quán, và đảm bảo hệ thống tiếp tục hoạt động.
Mô hình AI biết SQL, nhưng nó không biết công ty bạn tính doanh thu thế nào, hay trong vài bảng trông giống nhau thì bảng nào là thật (ví dụ bảng revenue_cpx_new_revised_v2_use_this_one). Nó không biết khi đội sales nói "doanh thu" là doanh thu được hưởng hoa hồng, còn đội tài chính dùng một con số khác.
Ngữ cảnh giống như cuốn hướng dẫn sử dụng dành cho agent — hữu ích nhưng khó duy trì. Tigani ví với thiết kế phần mềm: nếu người dùng phải đọc hướng dẫn thì đó là lỗi trải nghiệm người dùng; một mô hình dữ liệu đơn giản và rõ ràng sẽ giúp agent tiết kiệm rất nhiều thời gian, công sức và token.
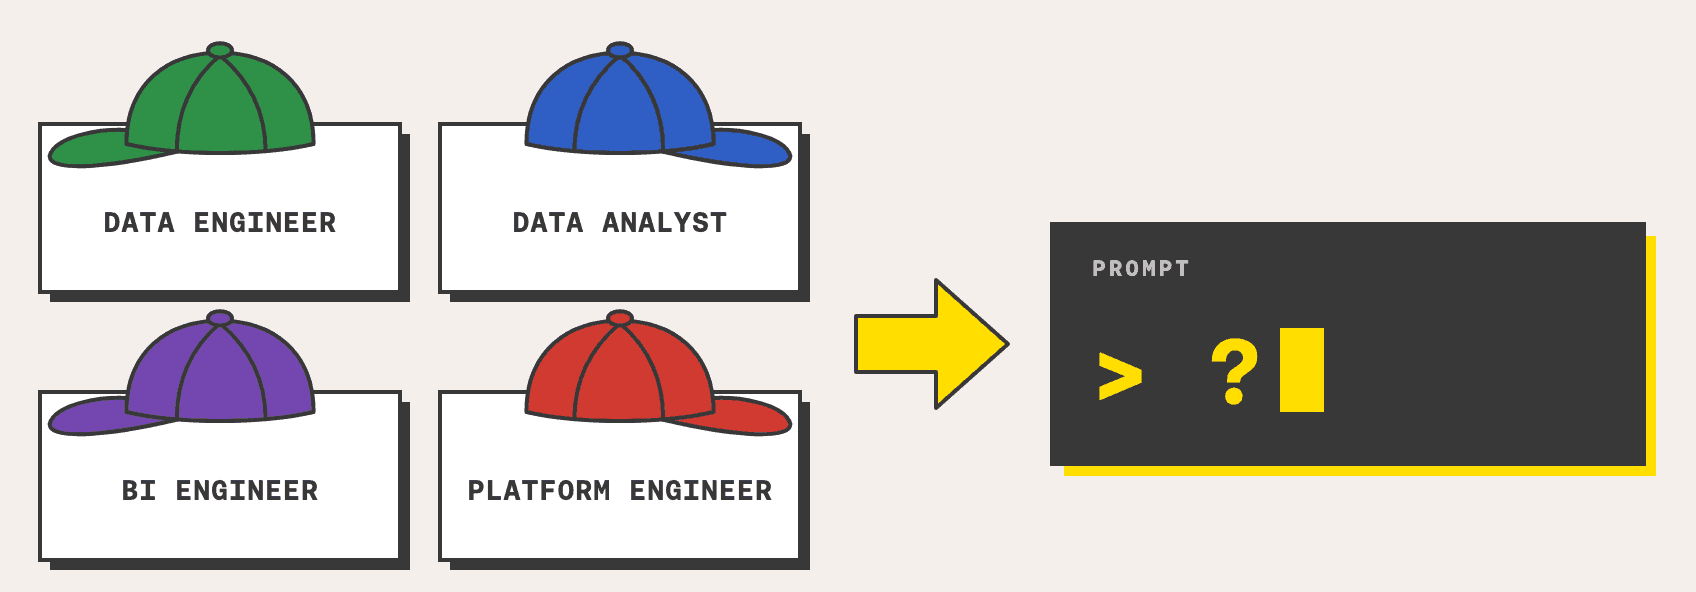 Những gì có thể trở thành prompt
Kỹ sư Trí tuệ Dữ liệu làm gì?
Kỹ sư Trí tuệ Dữ liệu tự động hóa công việc của kỹ sư dữ liệu (nạp dữ liệu) và kỹ sư phân tích (biến đổi và mô hình hóa) bằng cách tạo và điều phối các agent phần mềm. Họ mã hóa kiến thức về hệ thống vào ngữ cảnh dùng chung để các agent khác trả lời câu hỏi về tổ chức — từ trường nào có thể join với trường nào, đến "ARR" nghĩa là gì trong công ty.
Một phần trách nhiệm lớn là eval — các bài kiểm thử hệ thống xác minh rằng khi đặt câu hỏi có đáp án đã biết, agent trả lời đúng. Một bộ eval tốt mang lại sự tin cậy rằng các loại câu hỏi người dùng thường hỏi sẽ được trả lời chính xác, đồng thời phát hiện khi có thứ gì đó hỏng.
Mục tiêu cuối cùng là cho phép tự phục vụ (self-service): bất kỳ ai trong tổ chức đều có thể mở Claude, ChatGPT hay một agent khác, đặt câu hỏi đúng về doanh nghiệp, dựng ứng dụng và biểu đồ, rồi ra quyết định chất lượng cao. Khi làm tốt, mọi người dùng đều có cảm giác như đang làm việc với chuyên viên phân tích giỏi nhất công ty.
Hàng ngày, họ xây framework, xây mô hình dữ liệu, tuyển chọn ngữ cảnh, ngăn hỏng hóc, sửa khi hỏng, chạy eval và chịu trách nhiệm cho những bề mặt mà doanh nghiệp phụ thuộc vào. Đây là vai trò mà kỹ sư dữ liệu, kỹ sư phân tích hay chuyên viên phân tích đều sẽ nhận ra một phần ở chính mình — dù chức danh ghi gì đi nữa.
Liệu có loạn không?
Đó là câu hỏi hợp lý: nhiều người cùng dựng nghĩa là nhiều cơ hội sai hơn, ít giám sát hơn, thậm chí có thể ra quyết định dựa trên dữ liệu sai. Có hai yếu tố giúp giảm rủi ro.
Thứ nhất, càng gần vấn đề càng dễ phát hiện lỗi: người sống với con số churn sẽ nhận ra ngay khi nó bất thường. Kinh nghiệm cho thấy kết quả thực tế còn tốt hơn, vì chủ nghiệp vụ có cảm giác trực tiếp về lĩnh vực của mình.
Thứ hai, không cần giám sát mọi thứ với cùng mức độ. Nick Ursa nói: "Agent cần mức giám sát tỷ lệ với bán kính ảnh hưởng (blast radius) của nó." Thứ dùng cho báo cáo quan trọng thì phải chú ý nhiều; còn việc đặt bao nhiêu bánh sandwich cho bữa trưa thì không cần.
Tigani hình dung ba vòng giám sát:
- Vòng ngoài — Wild West: ai cũng có thể dựng, miễn dựa trên nền tảng hợp lý, đội dữ liệu không can thiệp.
- Vòng giữa — Curated: các dashboard, biểu đồ, ứng dụng và chỉ số quan trọng với doanh nghiệp; đội dữ liệu cố gắng hết sức sửa khi hỏng.
- Vòng trong — Core: các chỉ số then chốt của tổ chức, phải luôn chất lượng cao và ổn định. "Con số dành cho hội đồng quản trị" nằm ở đây.
Liên quan gì đến MotherDuck?
MotherDuck giới thiệu một số cơ chế cho đội dữ liệu được AI hỗ trợ: Flights là pipeline có thể "vibe-code" để đưa dữ liệu vào kho và chuyển thành mô hình hợp lý; Guides là file markdown mô tả mô hình dữ liệu và nghiệp vụ, khởi đầu ở chế độ riêng tư nhưng quản trị viên có thể nâng lên áp dụng toàn tổ chức để mọi người và agent dùng chung định nghĩa; Dives là biểu đồ dữ liệu do agent tạo; mỗi người và agent có một Duckling — instance DuckDB riêng. Tất cả đều truy cập được bằng SQL, nên một người hay một agent có thể xử lý xuyên suốt từ nạp dữ liệu, biến đổi, ngữ cảnh đến ứng dụng mà không cần chuyển giao qua công cụ khác.
Đội dữ liệu không biến mất. Vẫn phải có người sở hữu mô hình dữ liệu, tuyển chọn ngữ cảnh, giữ hệ thống hoạt động và chịu trách nhiệm về kết quả. Nick "không-còn-backlog" giờ có nhiều việc hơn bao giờ hết, nhưng công việc đang thay đổi và sẽ không quay lại như cũ.
Góc nhìn
Với các kỹ sư dữ liệu và chuyên viên phân tích tại Việt Nam, thông điệp đáng chú ý nhất không phải là "AI sẽ thay bạn", mà là phần giá trị của công việc đang dịch chuyển. Viết SQL, dựng pipeline dbt hay làm dashboard — những kỹ năng từng là lợi thế cạnh tranh — đang dần trở thành hàng hóa mà agent làm được, và làm ngày càng tốt hơn. Phần khó hơn, và khó tự động hóa hơn, là hiểu doanh nghiệp: định nghĩa chỉ số, phân xử bảng dữ liệu nào là "bản thật", duy trì ngữ cảnh dùng chung và chịu trách nhiệm về con số cuối cùng.
Các đội dữ liệu trong doanh nghiệp Việt Nam thường nhỏ và kiêm nhiệm nhiều vai trò, nên việc chuyển sang mô hình này có thể đem lại hiệu quả rõ rệt: thay vì mắc kẹt trong hàng đợi ticket, đội có thể đầu tư vào mô hình dữ liệu sạch và bộ eval — hai thứ mà bài viết nhấn mạnh là nền tảng. Điều cần lưu ý là nguyên tắc giám sát theo bán kính ảnh hưởng: cho agent tự do ở các tác vụ ít rủi ro, nhưng siết chặt kiểm soát ở các chỉ số mà ban lãnh đạo dùng để ra quyết định. Ngữ cảnh dùng chung cũng cần được coi là tài sản của tổ chức, không phải thứ mỗi người tự giữ riêng.
Nguồn: motherduck.com · Quy trình biên tập