Leeroo mã nguồn mở Kapso, động cơ AI học lặp từ dữ liệu doanh nghiệp
Leeroo vừa mã nguồn mở Kapso, động cơ AI tự chạy thử nghiệm, triển khai giải pháp tốt nhất và tích lũy bài học qua từng lần chạy. Dự án đạt vị trí đầu trên các bảng xếp hạng RelBench và MLE-bench của OpenAI, đồng thời giúp rút ngắn một dự án migration dữ liệu doanh nghiệp bị đình trệ hơn một năm xuống còn vài tuần.
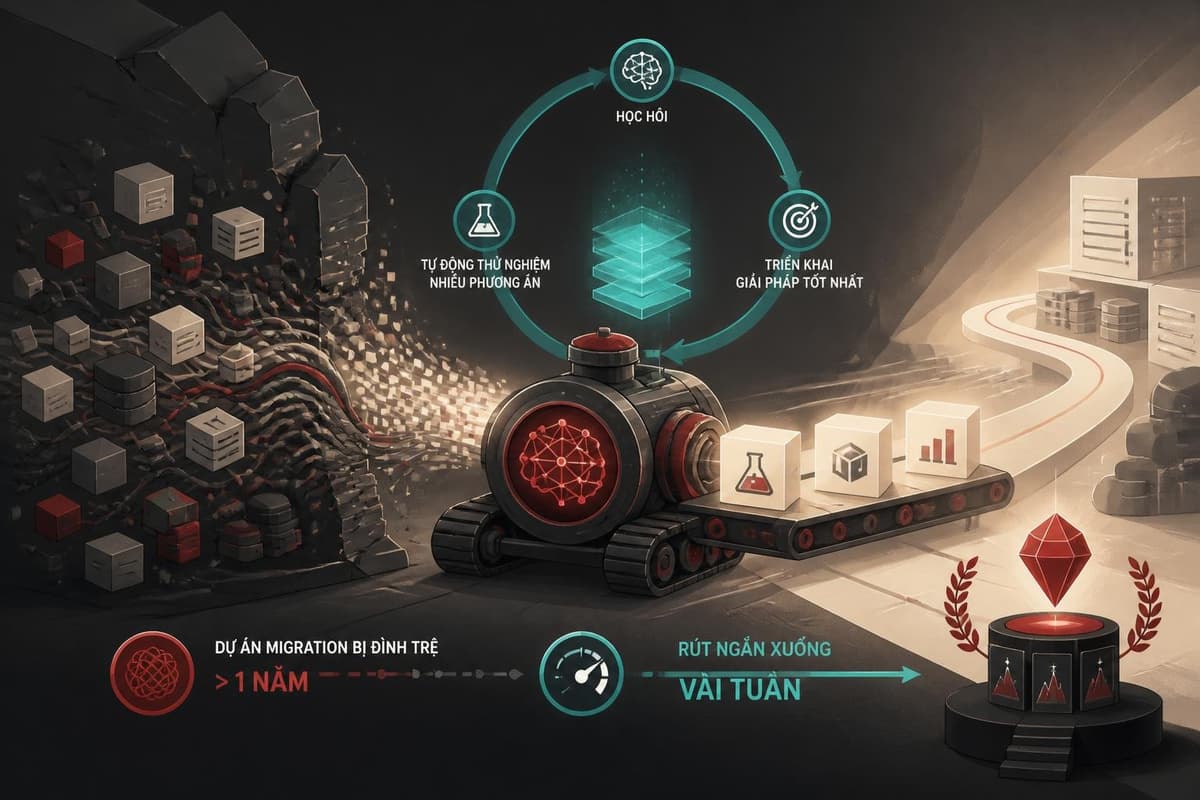
Hai kỹ sư Alireza và Majid, từng xây dựng hệ thống AI cho các sản phẩm có hàng triệu người dùng tại LinkedIn và Meta, vừa công bố mã nguồn mở Kapso — một động cơ AI chuyên xử lý dữ liệu doanh nghiệp theo cách lặp đi lặp lại: chạy thử nghiệm, triển khai giải pháp tốt nhất và rút bài học từ mỗi lần chạy.
Công cụ này hướng tới một vấn đề quen thuộc: dữ liệu doanh nghiệp lớn và lộn xộn không thể hiểu hết bằng cách đọc tài liệu hay họp bàn. Theo nhóm phát triển, cách duy nhất là điều tra, đặt giả thuyết, thử nghiệm rồi cải thiện dựa trên kết quả thu được.
Cách Kapso vận hành
Người dùng đưa vào một mục tiêu và tiêu chí thành công, Kapso sẽ tự tìm đến giải pháp tối ưu có thể triển khai trên hạ tầng sẵn có.
Trung tâm của hệ thống là một ngân hàng bài học (bank of lessons) được suy ra từ các thử nghiệm trước đó. Mỗi bài học đi kèm điểm tin cậy, điều kiện áp dụng và bằng chứng đằng sau.
- Với mỗi thử nghiệm mới, một mô-đun ý tưởng đề xuất các phương án dựa trên bài học cũ, xếp hạng lại theo lợi ích kỳ vọng so với ngân sách sử dụng, rồi chuyển những phương án hàng đầu cho mô-đun triển khai.
- Kết quả mỗi thử nghiệm được một mô-đun kiểm chứng độc lập xác nhận, mà bản thân thử nghiệm không thể truy cập để gian lận.
- Hàm
learn()cập nhật điểm số và phạm vi áp dụng của bài học sau mỗi lần chạy; thay đổi trong ngân hàng bài học cũng có thể được A/B test bằng cách chạy các bản dựng giống hệt nhau với ngân hàng cũ và mới.
Ngân hàng bài học được lưu trên git, cho phép chia sẻ kinh nghiệm, liệt kê và cập nhật qua CLI (kapso experience share/list/update). Hệ thống không phụ thuộc vào một mô hình hay coding agent cụ thể.
Lệnh kapso.deploy(solution, target_stack) chạy một vòng thử nghiệm ngắn hơn để thích ứng giải pháp với hạ tầng đích như Docker, Modal, BentoCloud hay LangGraph. Mỗi lĩnh vực có sẵn một harness (khung chạy thử nghiệm) để bắt đầu, và người dùng có thể tự viết harness riêng qua plugin hoặc CLI.
Kết quả trên các bảng xếp hạng
Nhóm phát triển công bố một số kết quả đáng chú ý:
- Mô hình dự báo trên cơ sở dữ liệu quan hệ: đứng đầu trên RelBench — bảng xếp hạng của Kumo AI (nay thuộc Nvidia) và Stanford — vượt qua mô hình nền tảng dạng bảng tốt nhất. Theo nhóm, điều này cho thấy giữ việc học ở tầng harness có thể đánh bại các mô hình nền tảng, với chi phí cập nhật ngân hàng bài học thấp hơn nhiều so với huấn luyện lại.
- Kỹ thuật ML: đứng đầu trên MLE-bench của OpenAI tại thời điểm nộp, hiện vẫn nằm trong nhóm hệ thống mã nguồn mở hàng đầu.
- Cuộc thi AI: vượt qua agent tốt nhất mà nhóm tác giả ALE-Bench tại Sakana AI từng báo cáo, và tự vận hành tại International Olympiad in AI 2026 trực tiếp, đứng trên cả 471 thí sinh người và lọt top 3 hệ thống AI.
Ngân hàng công khai và dự án thực tế
Leeroo vận hành Leeroopedia, một ngân hàng công khai cho ML và dữ liệu với khoảng 100.000 trang được trích xuất qua thử nghiệm trên các bài báo và repo, đạt khoảng 6 triệu yêu cầu mỗi tháng, trong đó khoảng 28% đến từ các AI agent.
Về ứng dụng thực tế, nhóm kể lại dự án chuyển một doanh nghiệp 30 năm tuổi khỏi hạ tầng dữ liệu cũ sang lakehouse (kiến trúc dữ liệu dạng hồ kết hợp kho dữ liệu) hiện đại. Dự án gồm hơn 30 nhóm hệ thống nguồn, hàng nghìn bảng và phép biến đổi, cùng hàng trăm báo cáo BI. Không cá nhân hay AI agent nào hiểu được toàn bộ cách hạ tầng này liên kết và vận hành — chỉ có thể khám phá dần qua thử nghiệm.
Theo nhóm phát triển, dự án hoàn thành trong vài tuần sau khi đã bị đình trệ hơn một năm. Việc học về hạ tầng và việc xây dựng diễn ra song song, mỗi phát hiện định hình bước tiếp theo. Cuối cùng, những hiểu biết thu được còn giúp xác định các cơ hội cắt giảm chi phí đáng kể trong kiến trúc và cách triển khai.
Góc nhìn
Với các kỹ sư và doanh nghiệp Việt Nam đang phải vật lộn với kho dữ liệu tích tụ nhiều năm từ nhiều hệ thống, hướng tiếp cận của Kapso gợi ý một thay đổi về cách làm: thay vì cố viết tài liệu hay thiết kế lược đồ dữ liệu hoàn chỉnh ngay từ đầu, hãy chấp nhận vòng lặp thử nghiệm có kiểm chứng và lưu lại bài học.
Điểm đáng chú ý về kỹ thuật là kiến trúc mô-đun kiểm chứng độc lập — tách bên đánh giá khỏi bên thực thi để tránh việc agent tự "chấm điểm" cho chính mình. Đây là bài học thiết kế hữu ích cho bất kỳ ai xây dựng hệ thống agent tự động trong môi trường sản xuất.
Dù vậy, những con số về thời gian rút ngắn dự án đến từ chính nhóm phát triển và chưa có đánh giá độc lập. Các đội ngũ nên coi đây là điểm tham khảo, tự đánh giá trên dữ liệu và hạ tầng của mình trước khi áp dụng.
Nguồn: news.ycombinator.com · Quy trình biên tập