
LightGBM và bài học từ mốc dự báo bốn tuần chia sẻ xe đạp
Một thử nghiệm 48 giờ trên dữ liệu Capital Bikeshare so sánh XGBoost, Ridge, SARIMA, Prophet với các mốc dự báo đơn giản. Kết quả cho thấy mốc trung bình bốn tuần khó bị đánh bại hơn tưởng tượng, còn chênh lệch giữa các mô hình phụ thuộc mạnh vào cách đánh giá.
Xây dựng mô hình dự báo chuỗi thời gian giờ đây dễ hơn nhiều nhờ mô hình nền tảng và tác nhân AI. Nhưng tự tay đi qua toàn bộ quy trình vẫn mang lại nhiều giá trị, đặc biệt ở khâu hiểu dữ liệu và đánh giá kết quả.
Một kỹ sư dữ liệu đã dùng dữ liệu lịch sử của Capital Bikeshare (Washington, D.C.) để dự báo số lượt thuê xe đạp theo giờ trong 48 giờ tiếp theo, với mỗi lần dự báo phát đi vào lúc nửa đêm. Câu hỏi trung tâm: mô hình phức tạp có vượt được mốc trung bình bốn tuần không?
Bài viết trình bày mã nguồn đầy đủ trong một kho GitHub kèm sổ ghi chép (notebook) dự báo hoàn chỉnh.
 Minh họa tổng quan phân tích dữ liệu dự báo
Những giờ thiếu hụt thực sự nói lên điều gì
Bộ dữ liệu UCI Bike Sharing của Fanaee-T chứa số lượt thuê theo giờ và theo ngày cho 2011–2012, kèm dữ liệu lịch và thời tiết. Tác giả giữ tháng 11 và tháng 12 năm 2012 cho giai đoạn đánh giá sau, dùng dữ liệu đến ngày 31/10/2012 để phát triển.
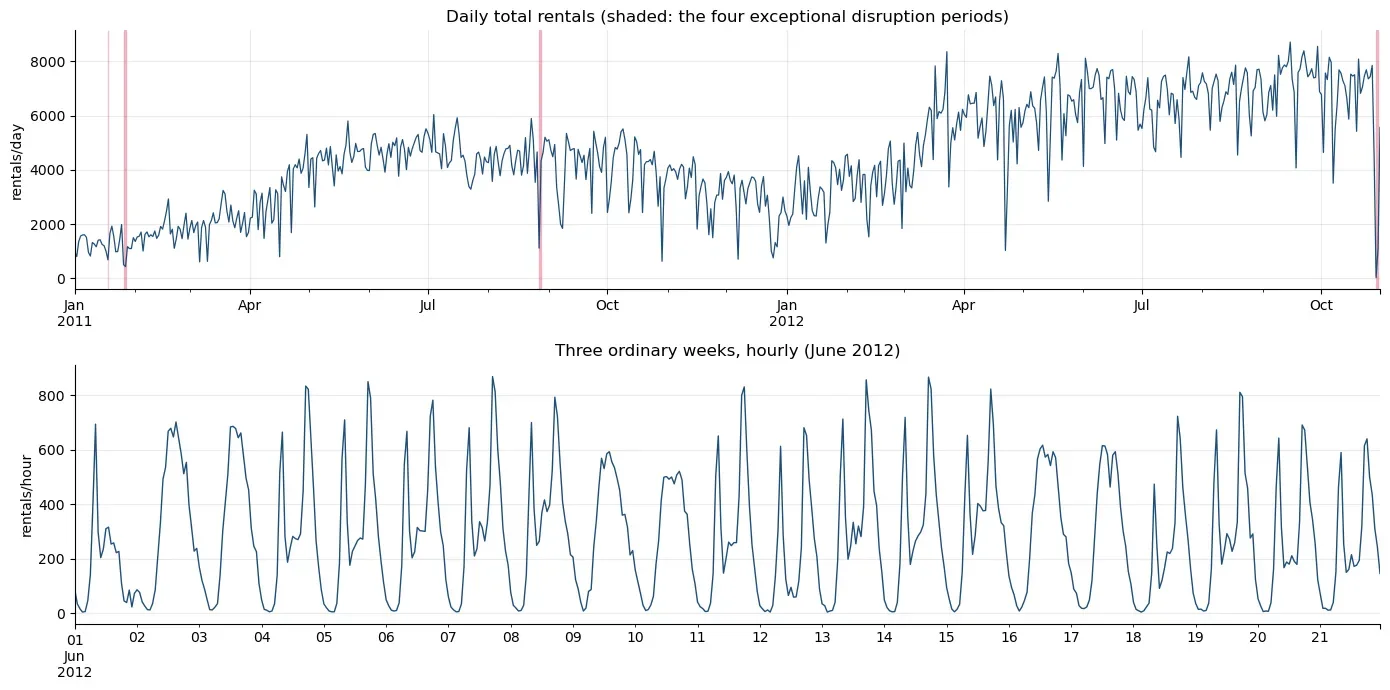
Dữ liệu phát triển có 15.919 dòng theo giờ, trong khi lưới thời gian đầy đủ có 16.080 vị trí. Hai vị trí là giờ không tồn tại do chuyển sang giờ mùa hè. Còn lại 159 giờ thiếu thật.
Tác giả không nội suy ngay. Tổng số lượt thuê theo ngày khớp chính xác với tổng các giờ có sẵn trong cả 670 ngày, kể cả 72 ngày có ít hơn 24 bản ghi theo giờ. Từ đó, 159 giờ thiếu được coi là số 0 suy ra (inferred zero), vì không còn lượt thuê nào để gán cho các giờ đó.
Điểm quan trọng: đây là tái dựng số lượt thuê đã ghi nhận, không phải nhu cầu thực. Dữ liệu không cho biết có bao nhiêu người muốn thuê xe nhưng không tìm được xe.
Có bốn chuỗi giờ thiếu kéo dài, được gắn nhãn là gián đoạn có thể, chiếm 83 trong số các số 0 suy ra. Với các đặc trưng trễ (lag), tác giả dùng chuỗi riêng thay thế bằng quan sát từ tuần trước, để không làm sai số lượt thuê cần dự báo.
Nhịp điệu ngày và tuần thay đổi rõ rệt
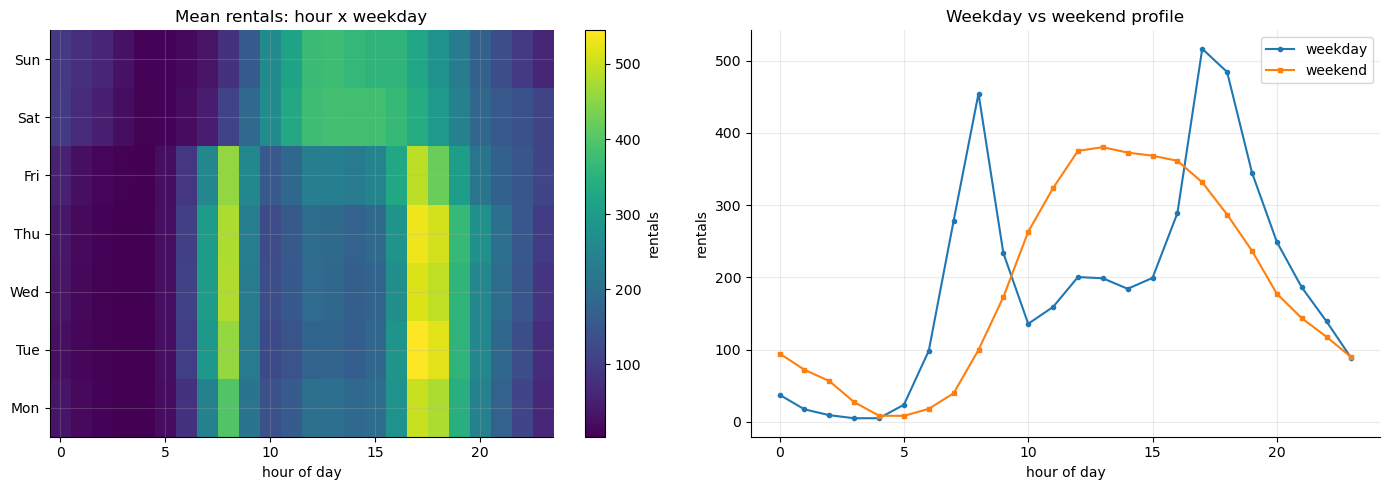
Lúc 8 giờ, số lượt thuê trung bình ngày thường gấp 4,56 lần cuối tuần. Đến trưa, con số này chỉ còn 0,53 lần. Chỉ biết giờ trong ngày là chưa đủ: dự báo 8 giờ sáng thứ Hai là bài toán khác hẳn 8 giờ sáng Chủ nhật.
Tác giả thêm đặc trưng giờ-trong-tuần (hour-of-week), xác định mỗi giờ trong 168 giờ của tuần, để mô hình dạng cây học được tương tác này.
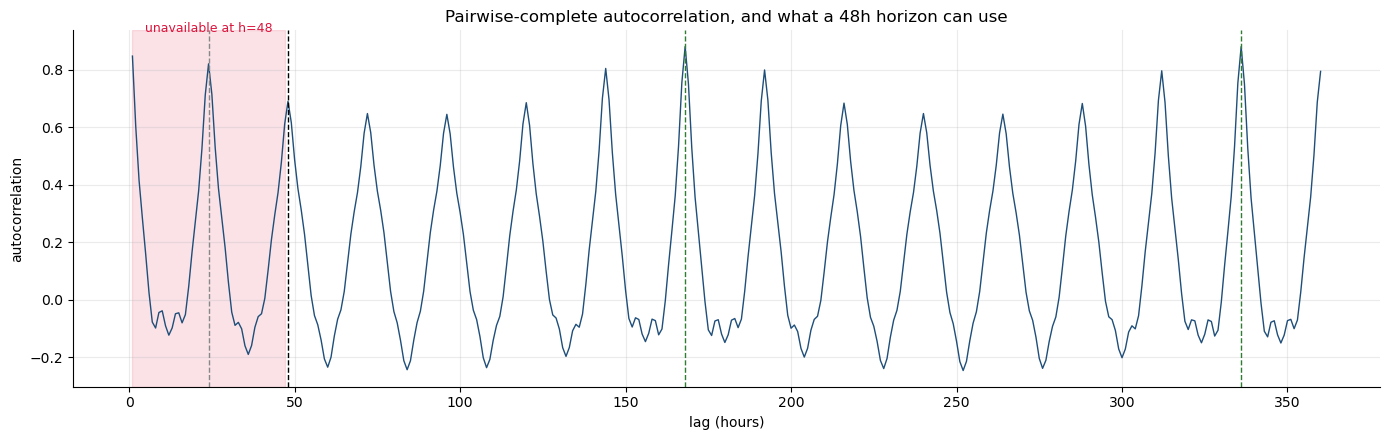
Hệ số tương quan cũng gợi ý: số lượt thuê cùng giờ của tuần trước (trễ 168) đạt 0,8807, so với 0,6900 của trễ 48 giờ. Nhìn về tuần trước mang lại nhiều thông tin hơn nhìn về hai ngày trước.
 Biểu đồ tương quan các độ trễ theo giờ
Quy tắc trễ và cách đánh giá
Vì mọi dự báo được phát đi lúc nửa đêm, tác giả chỉ dùng các độ trễ từ 48 giờ trở lên so với giờ cần dự báo. Nhờ vậy, mọi giá trị lịch sử đều đã có sẵn khi đưa ra dự báo. Tổng cộng có 45 đặc trưng lịch và lịch sử trước khi thêm thời tiết.
Cách đánh giá theo trình tự thời gian: mỗi lần lùi về phía trước, phát một dự báo 48 giờ hoàn chỉnh vào nửa đêm, các khoảng dự báo không chồng lấn. Giai đoạn phát triển chia làm hai: 22 điểm xuất phát để tinh chỉnh mô hình, rồi 92 điểm xuất phát (từ cuối tháng 4 đến tháng 10/2012) để so sánh, cho 4.416 dự báo theo giờ cho mỗi phương pháp.
Chỉ số chính là sai số tuyệt đối trung bình (MAE), dễ hiểu: trung bình mỗi dự báo lệch bao nhiêu lượt thuê. Tác giả cũng xem RMSE (phạt nặng sai số lớn) và MASE (chuẩn hóa theo mốc lịch sử), không dùng sai số phần trăm vì số lượt thuê có chứa số 0.
Mốc bốn tuần khó bị đánh bại
Ba mốc đơn giản được thử: dự báo ngây thơ theo ngày (lặp lại mẫu giờ của ngày gần nhất), ngây thơ theo tuần (giờ tương ứng tuần trước), và trung bình mùa vụ bốn tuần (trung bình cùng giờ, cùng thứ trong bốn tuần trước).
Trên 92 giai đoạn đánh giá phát triển:
- Ngây thơ theo ngày: MAE 105,824 lượt thuê
- Ngây thơ theo tuần: MAE 60,075
- Trung bình bốn tuần: MAE 49,856
Mức khởi đầu mạnh hơn kỳ vọng rất nhiều. Phương pháp ngây thơ theo ngày còn tệ hẳn ở ngày dự báo thứ hai (MAE tăng từ 82,61 lên 129,04), trong khi hai mốc còn lại ổn định hơn.
Bảng xếp hạng chưa đủ để kết luận
Tác giả thử Ridge, XGBoost, LightGBM, SARIMA và Prophet, chưa dùng thời tiết. LightGBM dẫn đầu với MAE 49,025, chỉ thấp hơn mốc bốn tuần 0,831 lượt thuê mỗi giờ. Mốc bốn tuần lại có sai số thấp hơn trên một nửa trong 92 đường dự báo.
Kiểm định thống kê với hiệu chỉnh Holm cho kết quả p-value 0,9553 (giả định các đường độc lập) và 0,9634 (có tính phụ thuộc thời gian). Không đủ bằng chứng để nói sai số trung bình của hai phương pháp khác nhau.
Khi lấy mẫu lại các đường dự báo, LightGBM vẫn đứng đầu 75,6% số lần (mẫu độc lập) và 87,8% số lần (khối 12 điểm gốc). Thứ hạng khá vững, nhưng đó không phải xác suất mô hình thực sự tốt nhất.
Thời tiết giúp ích, nhưng thời điểm mới là vấn đề
Muốn thêm thời tiết thì phải dùng dữ liệu quan trắc từ 48 giờ trước mỗi giờ cần dự báo, vì số liệu tương lai chưa tồn tại lúc nửa đêm. Tác giả đưa vào nhiệt độ, độ ẩm, tốc độ gió, điều kiện thời tiết và bình phương nhiệt độ.
Ở 22 giai đoạn tinh chỉnh, MAE giảm từ 51,005 xuống 49,435 (cải thiện 1,570). Nhưng trên 92 giai đoạn so sánh, MAE chỉ giảm từ 49,025 xuống 48,590 (0,435). Thêm thời tiết có giúp, nhưng ít hơn nhiều so với kỳ vọng ban đầu.
Một thử nghiệm riêng cho LightGBM thấy thời tiết thực tế tại giờ cần dự báo: MAE rơi xuống 38,909, gần 20% thấp hơn bản dùng thời tiết lịch sử. Tất nhiên, đó không phải dự báo có thể tạo ra thật vào nửa đêm.
LightGBM vẫn dựa vào chính ý tưởng bốn tuần
Trong một mô hình LightGBM huấn luyện trên toàn bộ dữ liệu phát triển, chỉ bốn đặc trưng đã chiếm 58,4% tổng mức tăng khi chia cây. Đó là số lượt thuê trung bình cùng giờ trong hai, ba, bốn tuần trước, cộng mức biến động qua bốn tuần đó.
Khi xáo trộn (shuffle) bốn đặc trưng này trên 31 giai đoạn dự báo, MAE nhảy từ 45,265 lên 209,529. Con số này không phải chi phí chính xác của việc bỏ đặc trưng, nhưng cho thấy mức độ phụ thuộc. Thời tiết chỉ chiếm 4,2% mức tăng và xáo trộn nó chỉ làm MAE tăng 0,257.
 Mức độ quan trọng của các đặc trưng trong mô hình
Nơi dự báo sai nhiều nhất
Lúc 17 giờ, trung bình khoảng 689 lượt thuê, MAE là 113,6. Lúc 4 giờ, MAE chỉ 4,0 nhưng trung bình chỉ có 9,1 lượt thuê. Giờ cao điểm tạo sai số tuyệt đối lớn nhất; ban đêm, sai số nhỏ vẫn lớn so với mức thông thường.
Dự báo tệ nhất trong giai đoạn phát triển bắt đầu ngày 29/10/2012, giữa bão Sandy. Số lượt thuê giảm mạnh nhưng mô hình vẫn dự báo hoạt động đáng kể. Riêng dự báo 48 giờ đó có MAE 259,6 lượt thuê.
Tháng 11 và 12 kể câu chuyện khác
Trên 30 dự báo 48 giờ không chồng lấn (1/11 đến 30/12/2012, tổng 1.440 dự báo theo giờ), LightGBM có MAE thấp hơn mốc bốn tuần 12,652 lượt thuê mỗi giờ, tức giảm 19,6%.
Số lượt thuê trung bình mỗi giờ được chấm giảm từ 279,5 xuống 190,0 (khoảng 32%). Mốc bốn tuần lại hoạt động kém hơn trong giai đoạn này, còn ngây thơ theo ngày tốt lên. Tác giả chưa tách được yếu tố nào giải thích rõ chênh lệch lớn hơn, và chưa chạy kiểm định ý nghĩa riêng cho giai đoạn cuối.
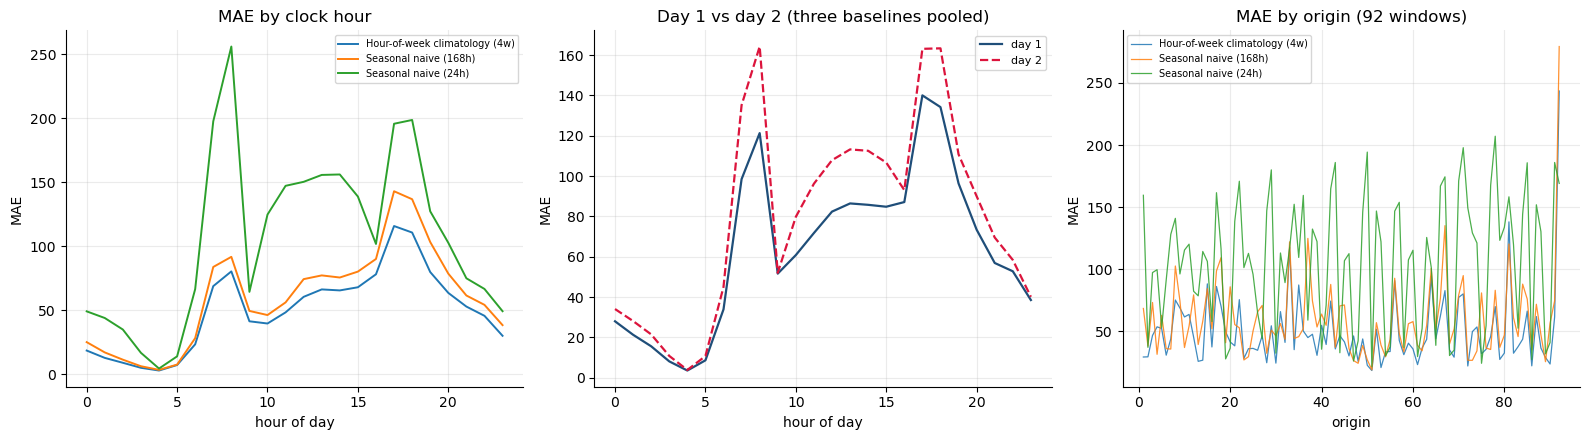 So sánh sai số của các phương pháp dự báo
Khoảng dự báo vẫn cần cải thiện
Tác giả dùng dự báo tuân thủ (conformal prediction) để tạo khoảng dự báo danh nghĩa 80% cho từng giờ, dựa trên sai số lịch sử, chặn dưới ở 0. Hai phiên bản: độ rộng riêng cho mỗi bước trong 48 bước, và một độ rộng chung.
Kiểm tra trong giai đoạn phát triển cho độ phủ 81,9% và 81,6%. Ở giai đoạn cuối, cả hai đều chưa đạt 80%; bản theo từng bước sát hơn nhưng khoảng rộng hơn một chút.
Đây là khoảng thực nghiệm từ sai số lịch sử, không đảm bảo độ phủ 80% ở mọi giai đoạn tương lai. Khoảng này mô tả độ bất định quanh từng dự báo theo giờ, không đảm bảo cả dự báo 48 giờ nằm trong khoảng.
Góc nhìn
Kết quả này nhắc kỹ sư dữ liệu Việt Nam một điều thực dụng: trước khi huấn luyện mô hình phức tạp, hãy dựng mốc đơn giản và đánh giá công bằng. Với dữ liệu có nhịp tuần rõ như lượt thuê xe, lưu lượng truy cập hay đơn hàng, trung bình cùng giờ vài tuần trước có thể đã đủ tốt để làm chuẩn.
Quy tắc trễ 48 giờ và việc kiểm tra dữ liệu có sẵn lúc dự báo là bài học về rò rỉ dữ liệu (data leakage). Đội ngũ triển khai mô hình dự báo trong hệ thống thật nên xác định rõ thời điểm phát dự báo, rồi chỉ dùng những gì đã biết tại thời điểm đó, kể cả thời tiết hay lưu lượng.
Cuối cùng, chênh lệch lớn giữa hai giai đoạn cho thấy một lần đánh giá chưa đủ. Nên kiểm tra mô hình trên nhiều khoảng thời gian, gồm cả giai đoạn bất thường, và xem cả khoảng dự báo chứ không chỉ sai số trung bình.
Nguồn: towardsdatascience.com (bài gốc ngày 20 tháng 11, 2026) · Quy trình biên tập
Bài viết liên quan
Phần mềm
Những vấn đề bất ngờ khi sử dụng Lịch tùy chỉnh trong Power BI và Fabric
10 tháng 4, 2026
AI & ML
Timestral: Mistral ra mắt dòng mô hình nền tảng chuỗi thời gian đầu tiên
19 tháng 10, 2026
Công nghệ
Huấn luyện mô hình chấm điểm trong kỷ nguyên AI: Phương pháp luận lựa chọn mô hình tối ưu
10 tháng 6, 2026