Mất bao nhiêu lần đoán để bẻ khóa con số "ngẫu nhiên" của AI?
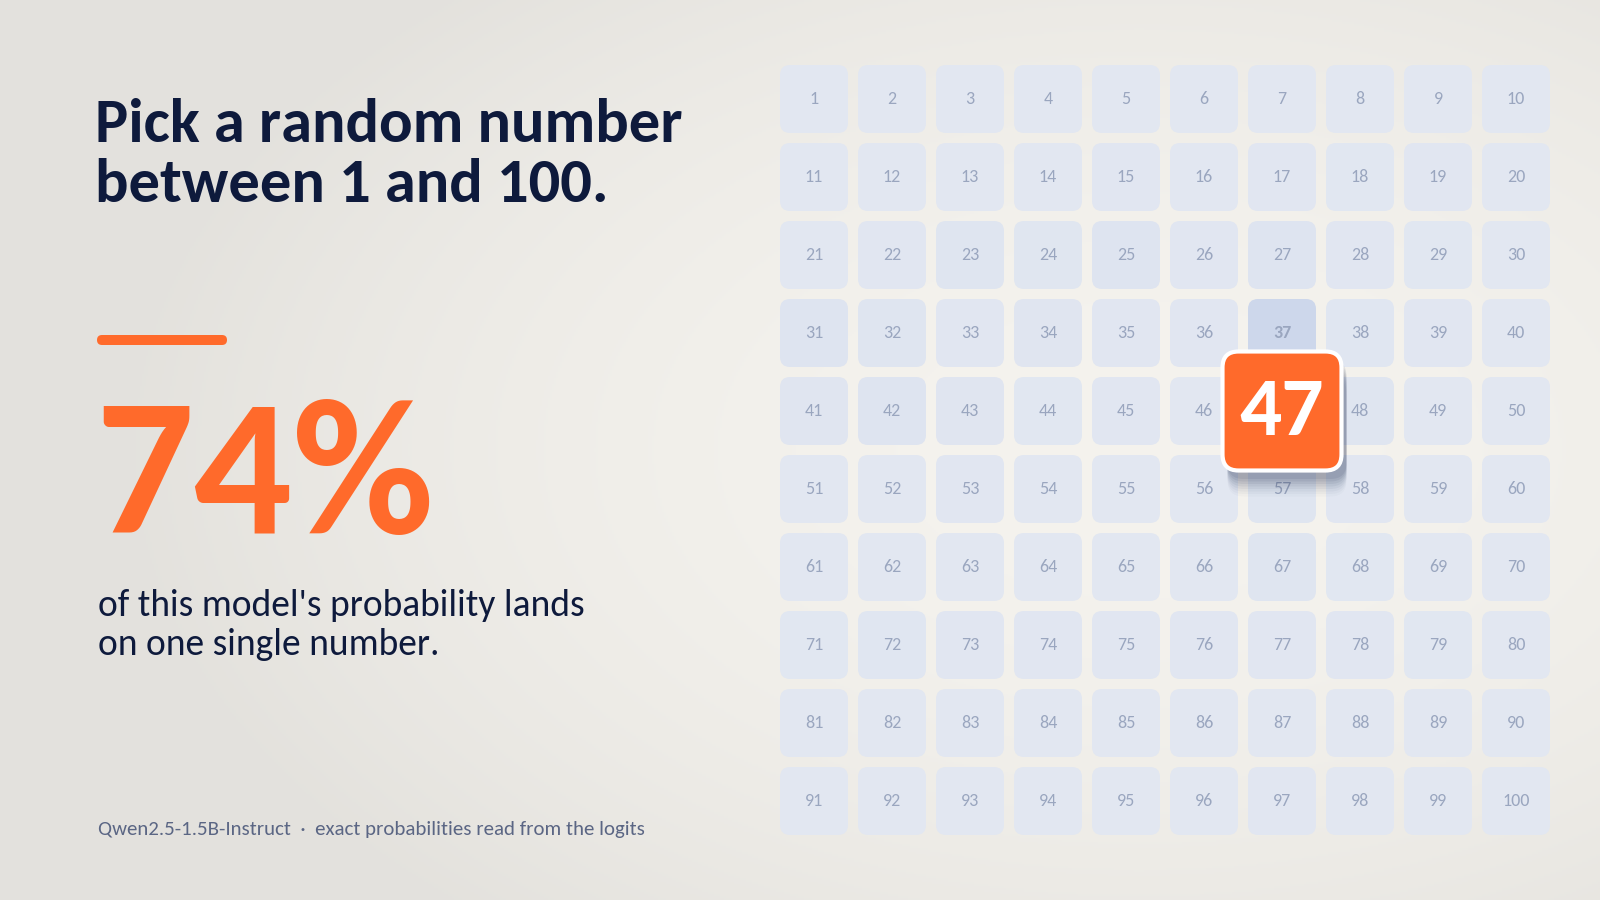
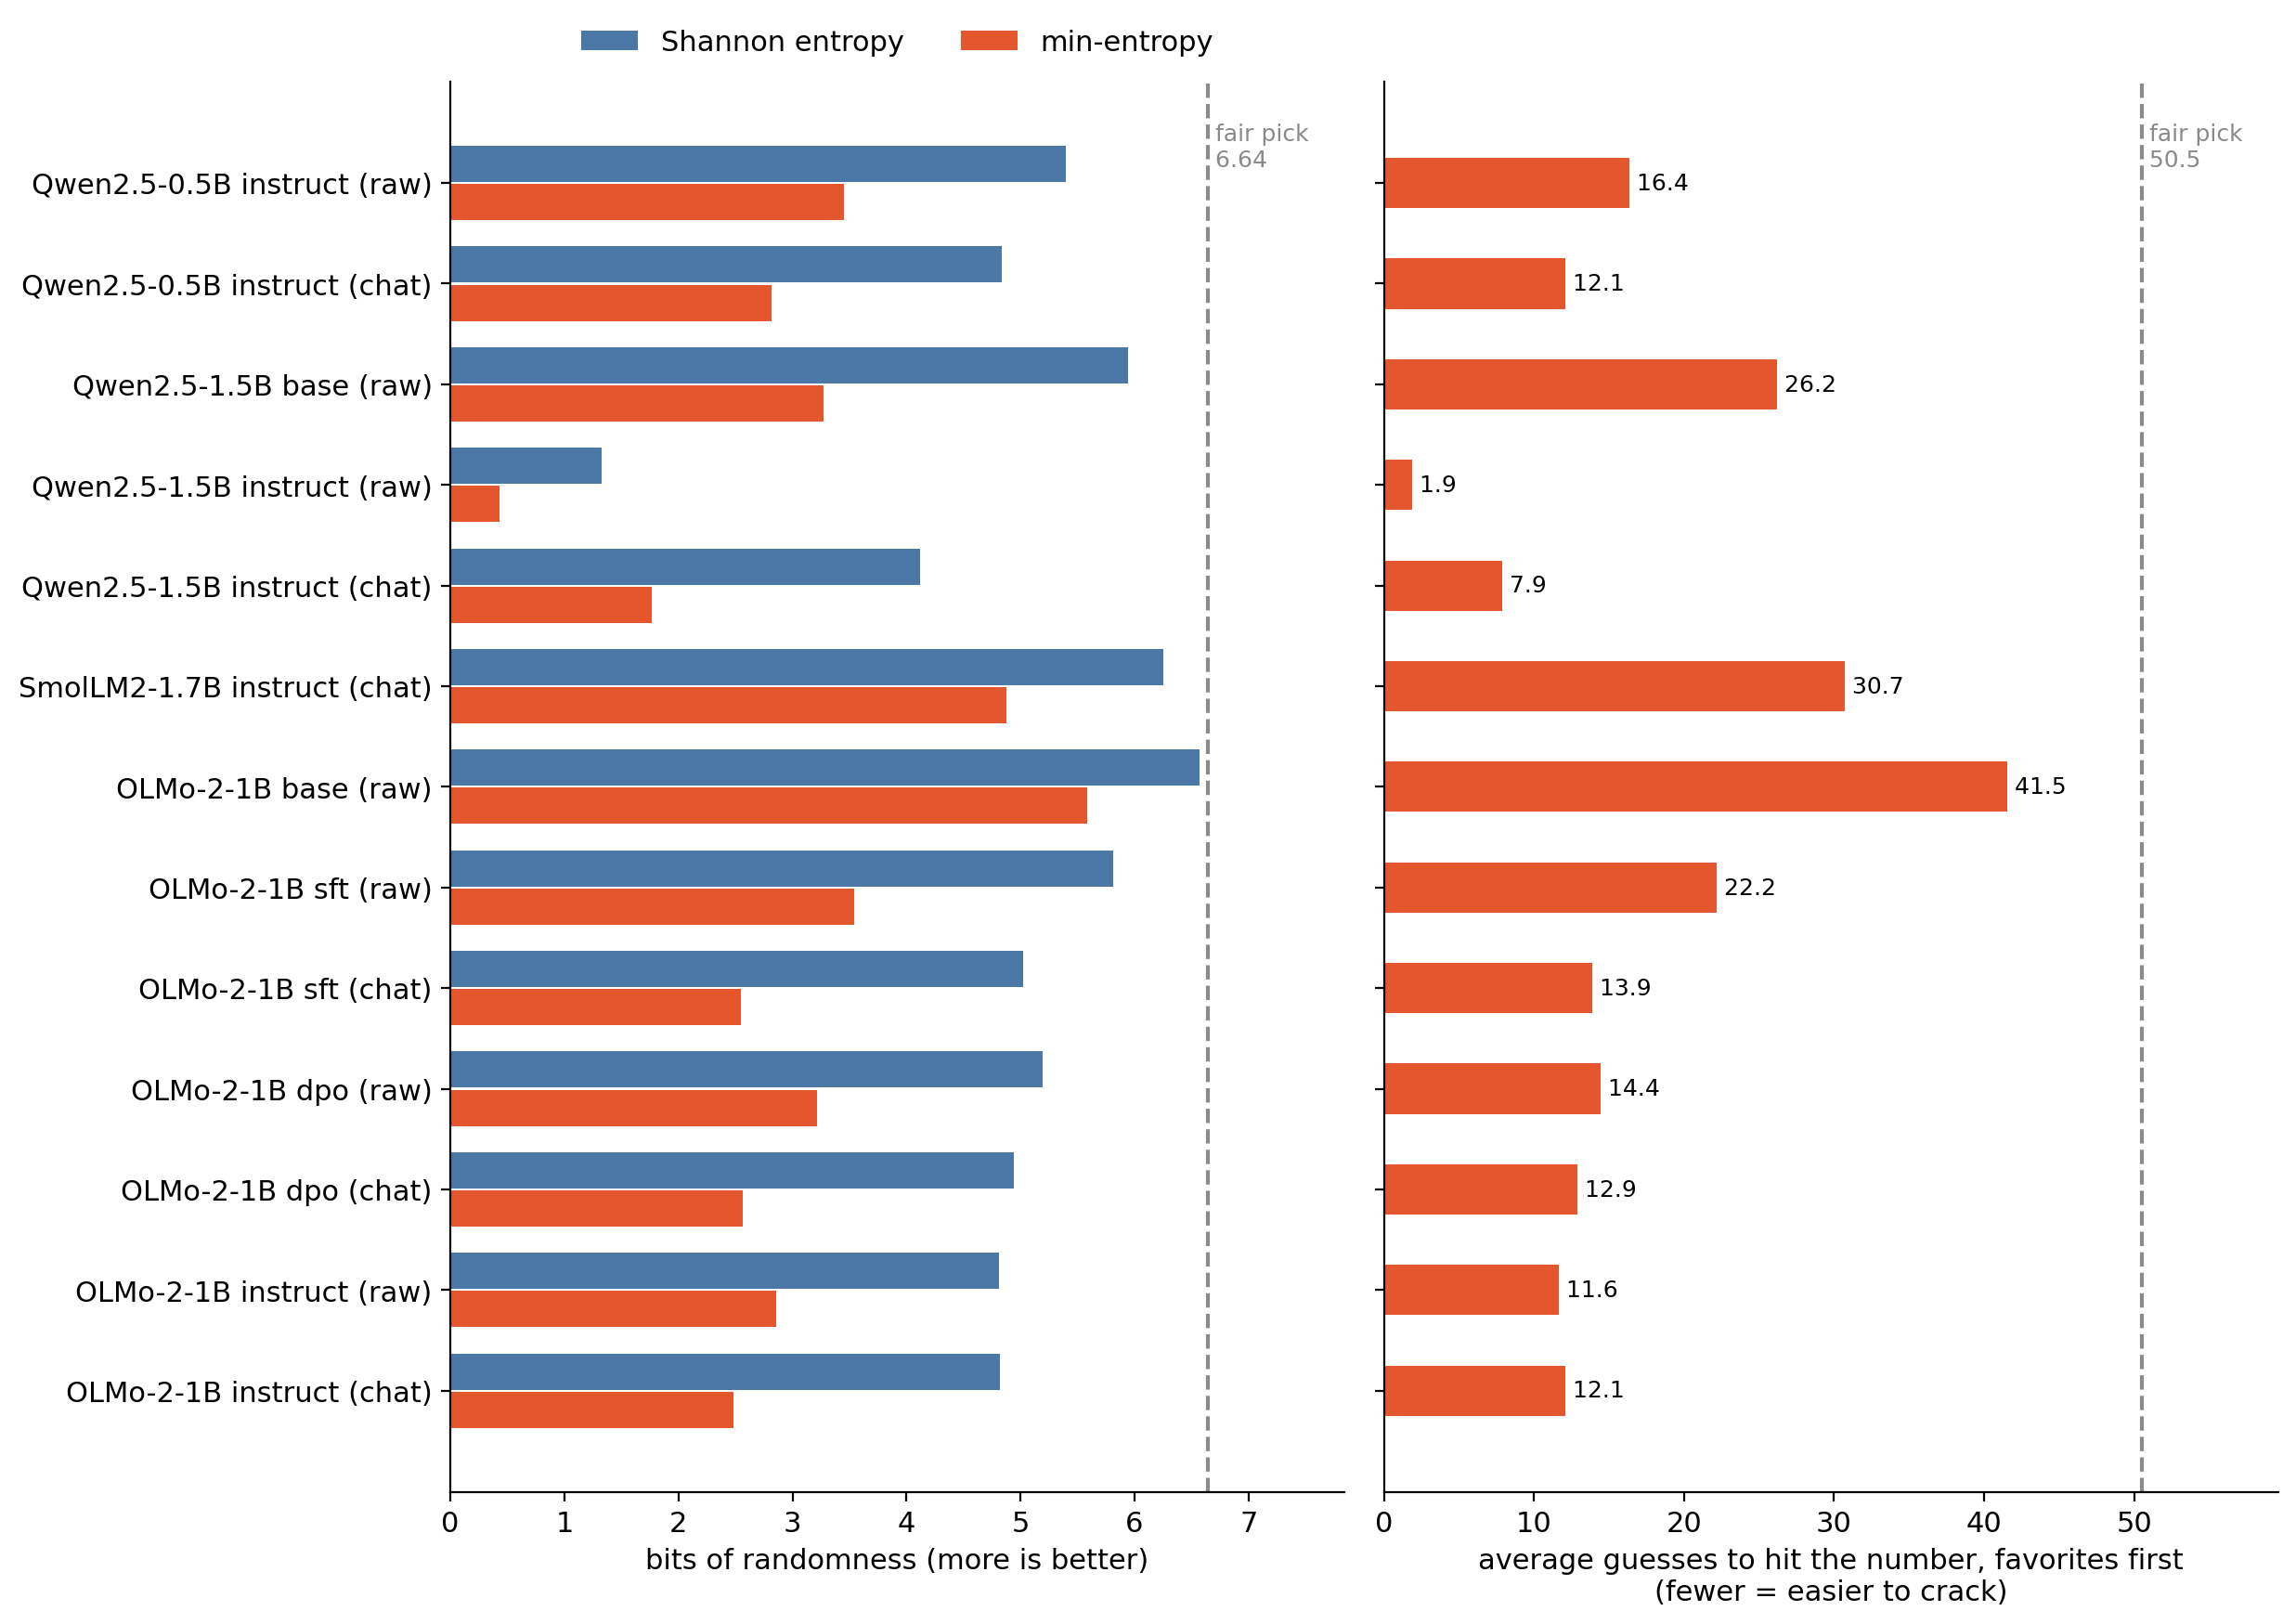
Nghiên cứu đọc trực tiếp phân phối xác suất từ logits của các mô hình ngôn ngữ mở cho thấy chúng không hề ngẫu nhiên khi được yêu cầu chọn số. Một mô hình 1,5 tỷ tham số trả lời số 47 tới 74% số lần, khiến kẻ tấn công chỉ cần trung bình 1,9 lần đoán để đoán trúng.
Mở một chatbot, yêu cầu nó chọn một số ngẫu nhiên từ 1 đến 100, rồi ghi lại kết quả. Làm vài lần nữa trong các cuộc trò chuyện mới. Một bộ sinh số công bằng sẽ cho mỗi con số xuất hiện khoảng một lần trong một trăm lần thử. Các mô hình ngôn ngữ thì không như vậy, và điều này đã được nhiều người chứng minh.
Nhưng những bài viết trước đây chủ yếu đếm tần suất xuất hiện của từng con số. Câu hỏi đáng quan tâm hơn dưới góc độ bảo mật là: nếu mô hình chọn con số dùng để bảo vệ một thứ gì đó, kẻ tấn công cần bao nhiêu lần đoán?
 Minh họa phân phối xác suất của mô hình ngôn ngữ
Đọc thẳng câu trả lời từ logits
Lấy mẫu một mô hình nhiều lần chỉ cho ra ước lượng về phân phối câu trả lời. Mô hình ngôn ngữ trao cho ta phân phối đó một cách trực tiếp, bởi ở mỗi bước nó tạo ra xác suất cho từng token tiếp theo. Xác suất của cả một câu trả lời là tích xác suất của các token cấu thành.
Với câu trả lời 73, mô hình phải sinh ra token cho số 7 và số 3 (hoặc một token duy nhất cho 73, tùy tokenizer), rồi dừng lại. Việc dừng lại rất quan trọng: nếu bỏ qua nó, xác suất của số 7 sẽ vô tình tính luôn mọi câu trả lời bắt đầu bằng 7.
Nghiên cứu đã chấm điểm cả 100 ứng viên và chuẩn hóa chúng để tổng bằng 1. Tổng trước khi chuẩn hóa, gọi là độ phủ (coverage), cho biết mô hình trả lời bằng một con số trần trụi thường xuyên đến mức nào.
Có ba cách đo mức độ ngẫu nhiên của lựa chọn, và chúng có thể mâu thuẫn nhau:
- Entropy Shannon: mức độ bất ngờ trung bình của câu trả lời, tính bằng bit. Một lựa chọn công bằng từ 1 đến 100 cho 6,64 bit.
- Min-entropy: chỉ nhìn vào con số được ưa thích nhất, đo khả năng phòng thủ trước kẻ tấn công chỉ có một lần đoán.
- Entropy đoán (guessing entropy): số lần đoán kỳ vọng khi kẻ tấn công thử từ số khả dĩ nhất đến ít khả dĩ nhất. Lựa chọn công bằng cho 50,5 lần đoán.
Một ví dụ nhỏ cho thấy vì sao một chỉ số là không đủ. Giả sử mô hình trả lời 73 trong một nửa số lần, còn lại chọn đều trong 99 số khác. Entropy Shannon là 4,31 bit — nghe khá ổn. Nhưng min-entropy chỉ đúng 1 bit, vì một lần đoán số 73 thành công một nửa số lần. Entropy đoán là 26,0 lần, chỉ bằng khoảng một nửa mức công bằng.
Kết quả đo đạc thực tế
Nghiên cứu chạy trên năm họ mô hình mở, mỗi họ gồm bản gốc (base) và bản tinh chỉnh theo chỉ dẫn (instruction-tuned): Qwen2.5 ở mức 0,5B và 1,5B tham số, SmolLM2 ở mức 360M và 1,7B, và OLMo 2 ở mức 1B.
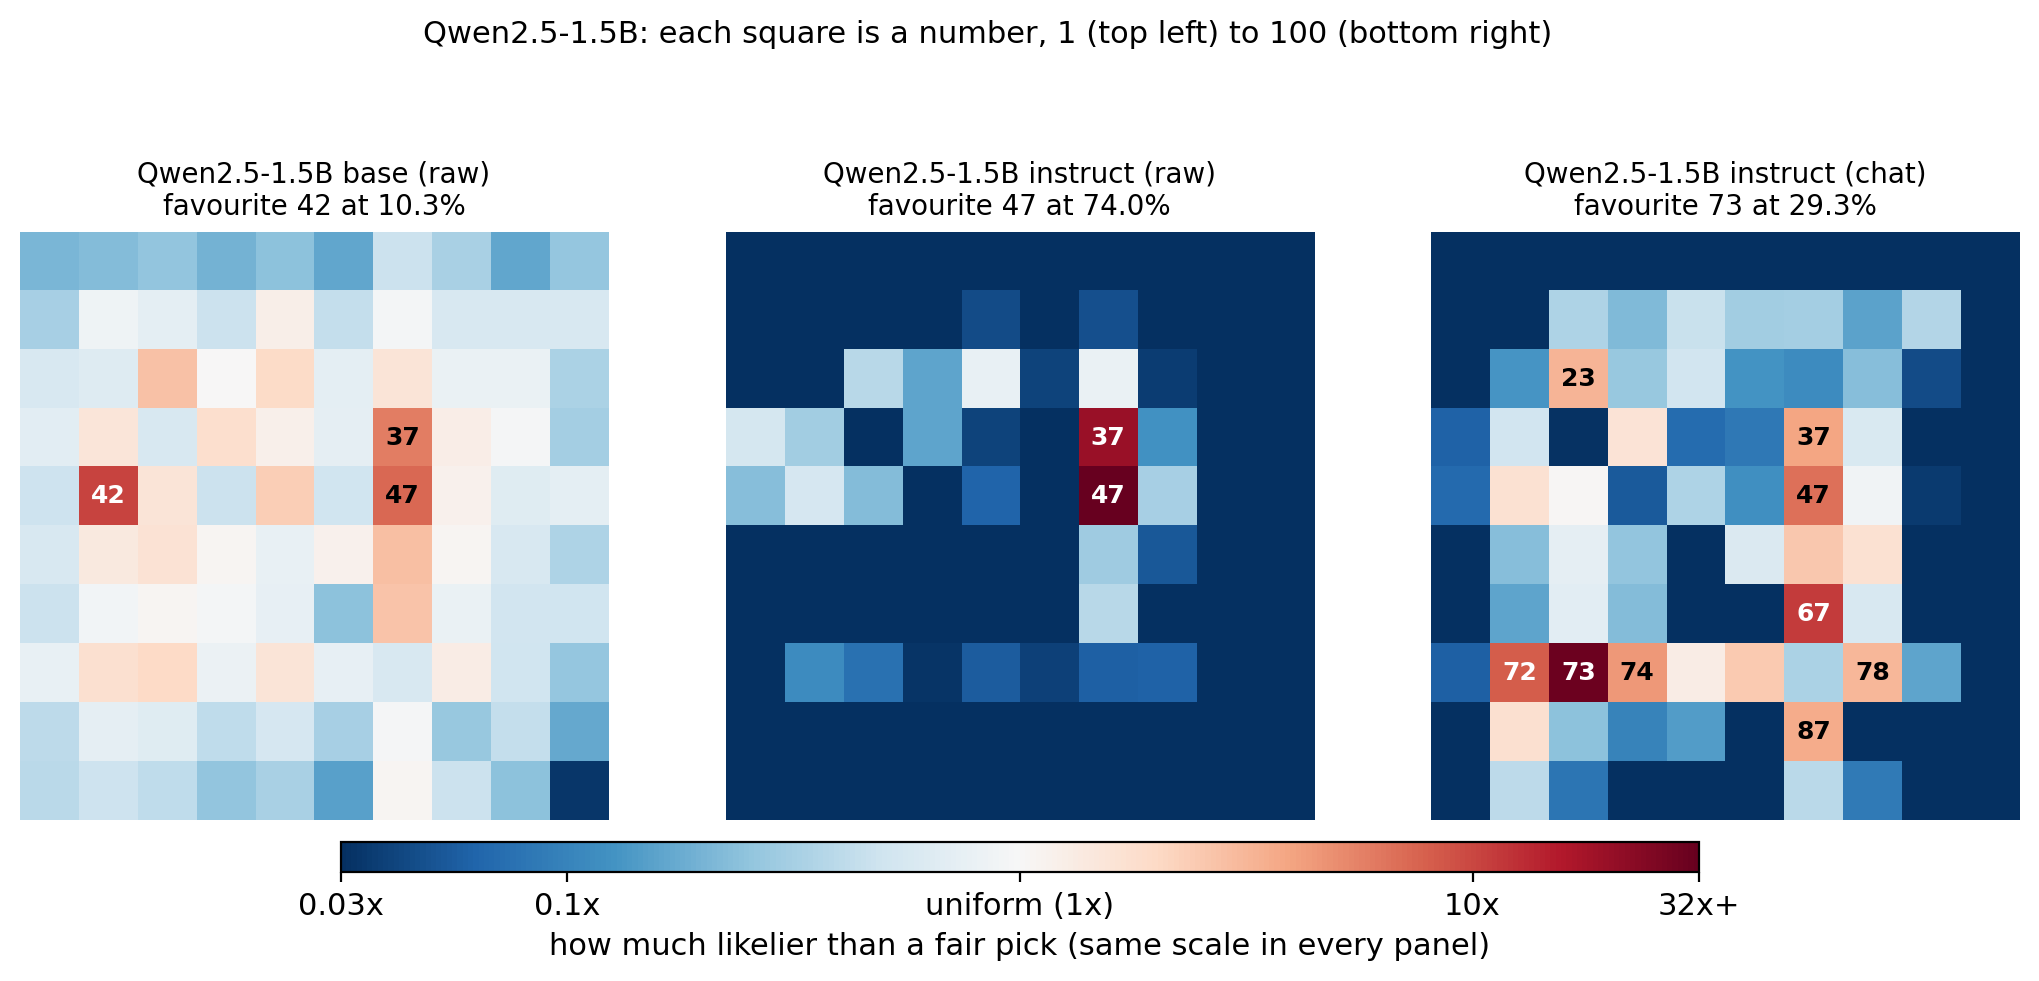
Kết quả nổi bật nhất là Qwen2.5-1.5B-Instruct với prompt văn bản thuần: nó dồn 74% xác suất vào số 47 và 94% vào ba con số hàng đầu. Kẻ tấn công đoán 47 trước sẽ đúng ba lần trong bốn, và chỉ cần trung bình 1,9 lần đoán, so với 50,5 lần của một lựa chọn công bằng.
Các dòng tinh chỉnh khác nhẹ hơn nhưng cùng xu hướng. OLMo 2 1B Instruct đạt 4,82 bit và cần 11,6 đến 12,1 lần đoán. Ngoại lệ là SmolLM2-1.7B-Instruct qua chat template, đạt 6,26 bit và 30,7 lần đoán — gần với các bản gốc và không có con số ưa thích nào vượt 3,4%.
Trên 13 dòng có độ phủ tốt, số 42 là lựa chọn hàng đầu trong 6 trường hợp, số 50 và 73 xuất hiện hai lần mỗi số, còn 25, 47 và 99 mỗi số một lần.
 Xác suất từng câu trả lời so với lựa chọn công bằng
Quá trình thu hẹp diễn ra ở đâu
Các mô hình gốc vốn đã không công bằng. Qwen2.5-1.5B bản gốc đã chỉ cần 26,2 lần đoán và dồn 10% vào số 42. Nhưng quá trình tinh chỉnh theo chỉ dẫn còn thu hẹp lựa chọn hơn nữa ở mọi họ mô hình: Qwen2.5-1.5B rơi từ 5,94 xuống 1,33 bit, OLMo 2 rơi từ 6,57 xuống 4,82 bit.
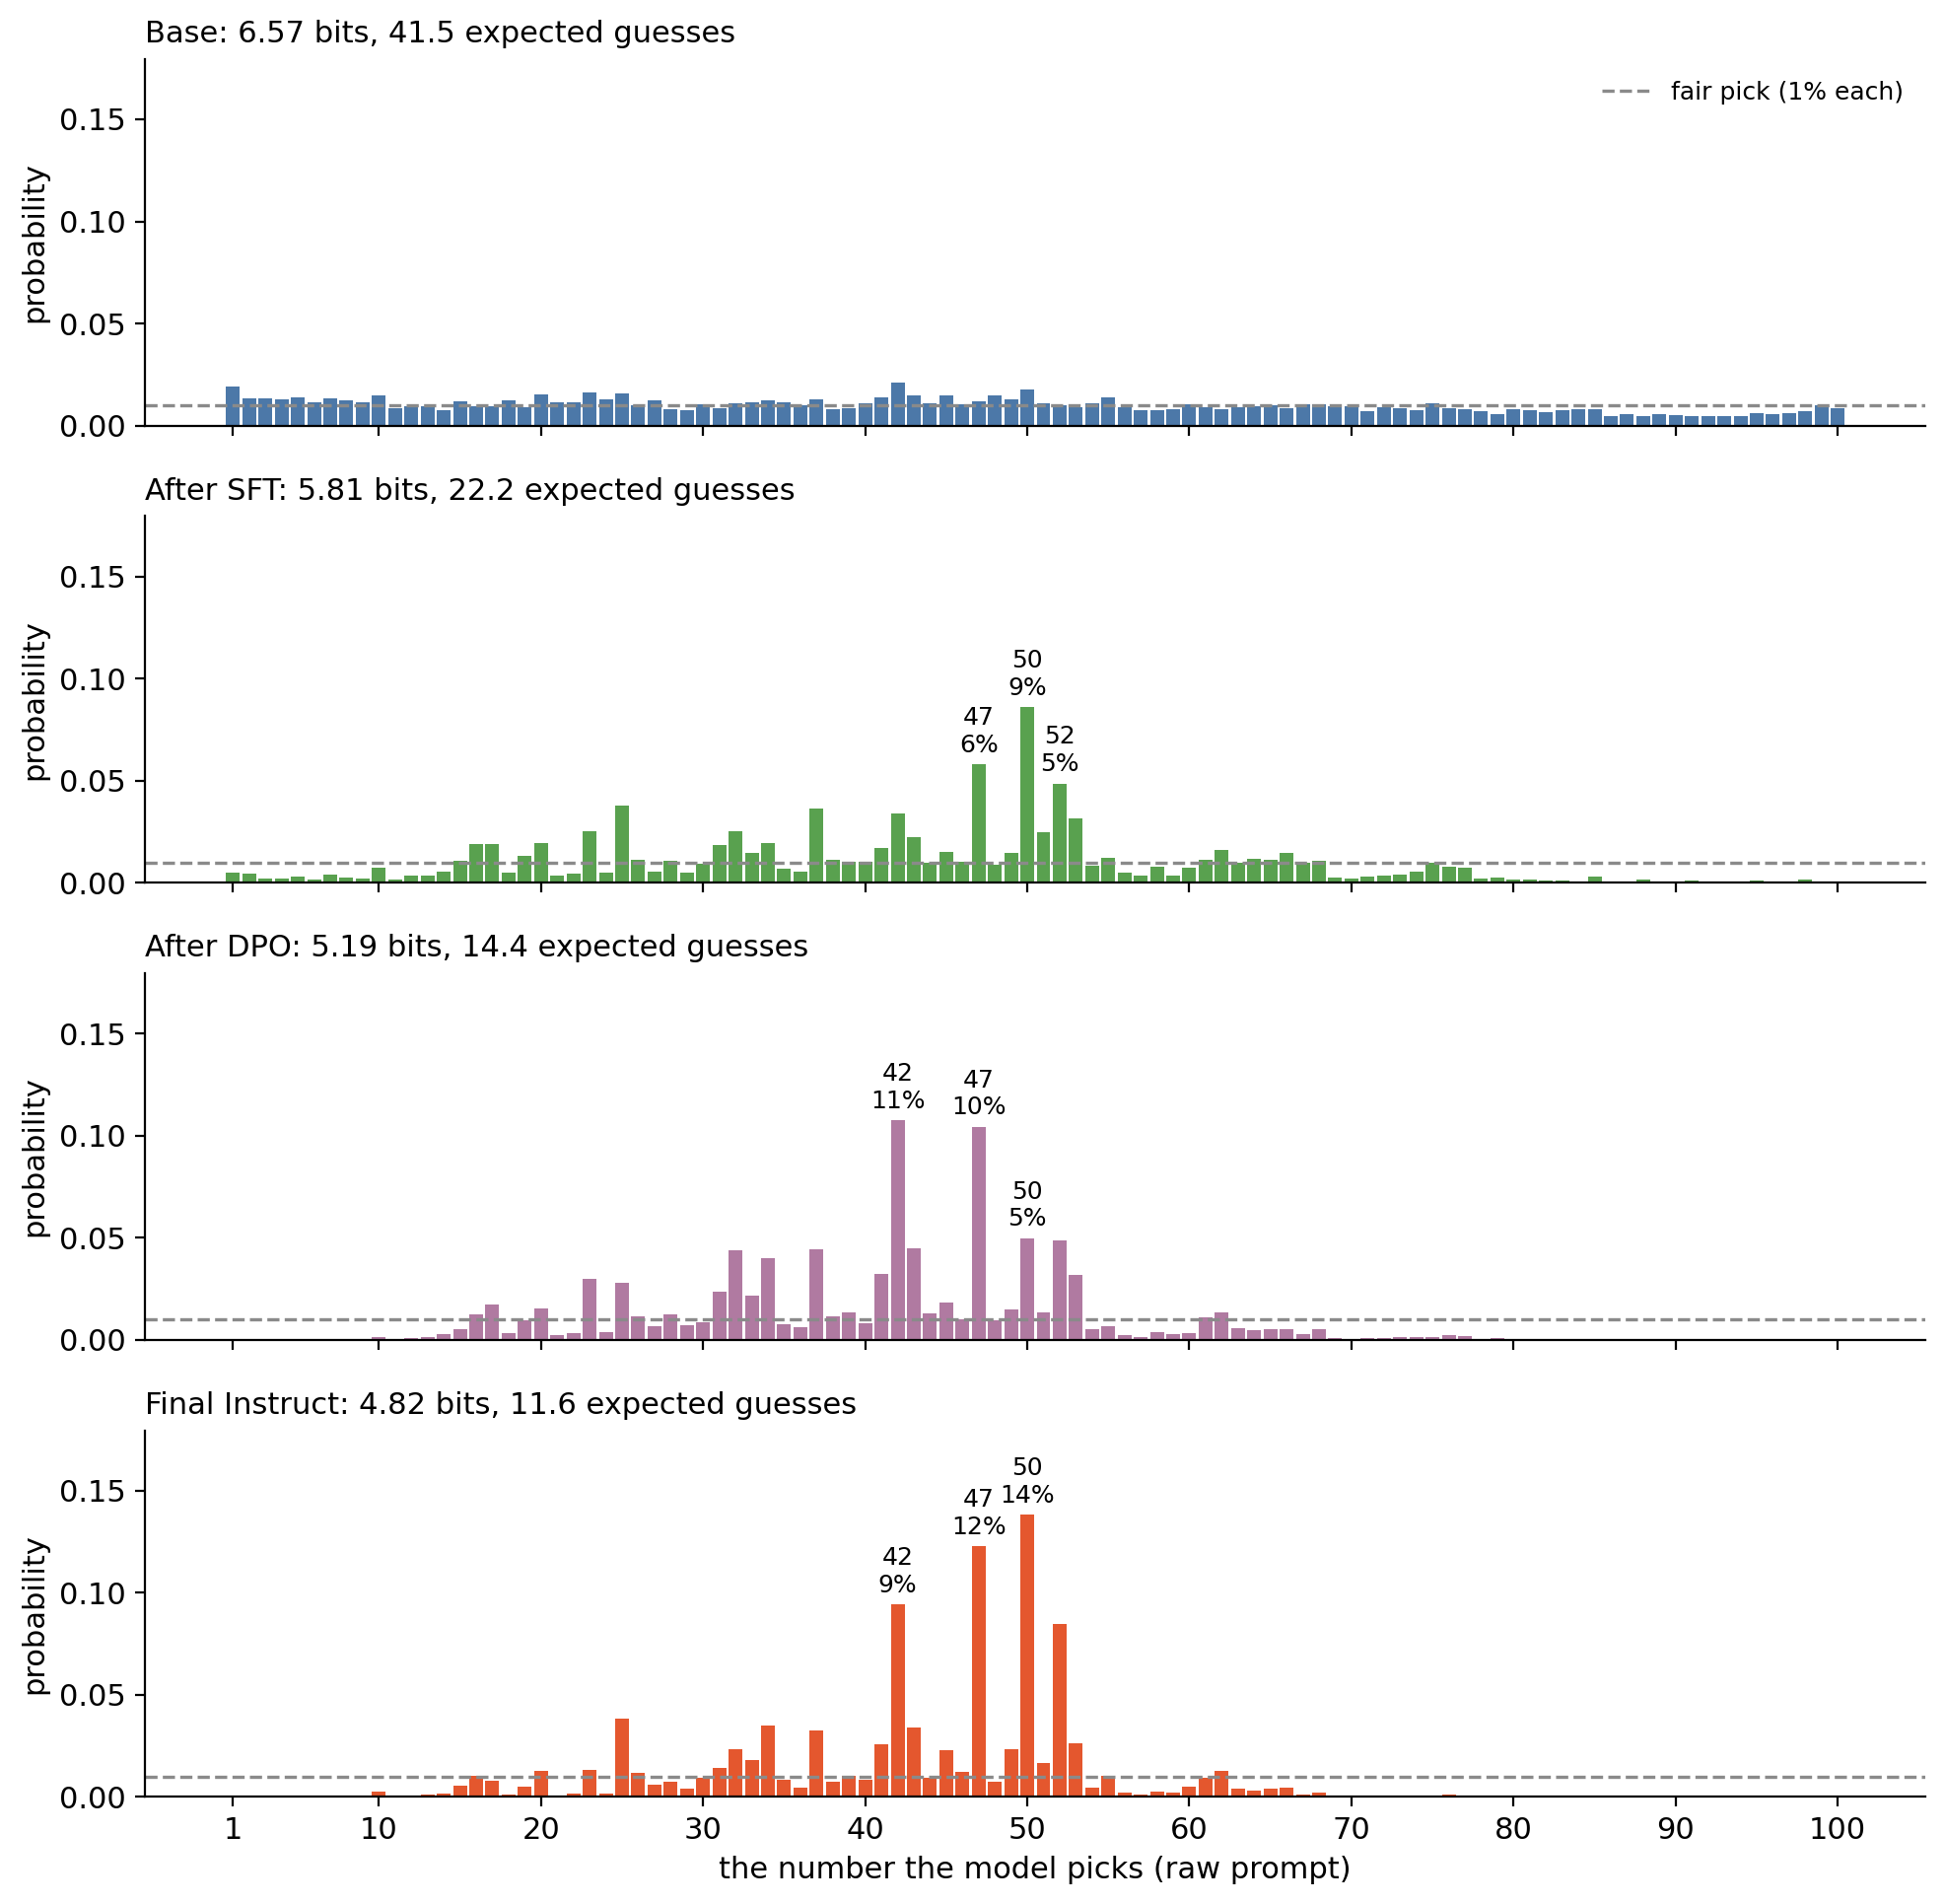
OLMo 2 1B cho phép truy vết từng giai đoạn vì mọi bước hậu huấn luyện đều được công bố riêng. Với prompt thô, entropy giảm 0,76 bit ở bước SFT, 0,62 bit ở DPO và 0,37 bit ở giai đoạn cuối. Số lần đoán kỳ vọng giảm từ 41,5 xuống 22,2, rồi 14,4, rồi 11,6. Chỉ riêng SFT đã chiếm hơn 40% mức giảm tổng cộng về bit.
 Xác suất câu trả lời của OLMo 2 1B qua từng giai đoạn hậu huấn luyện
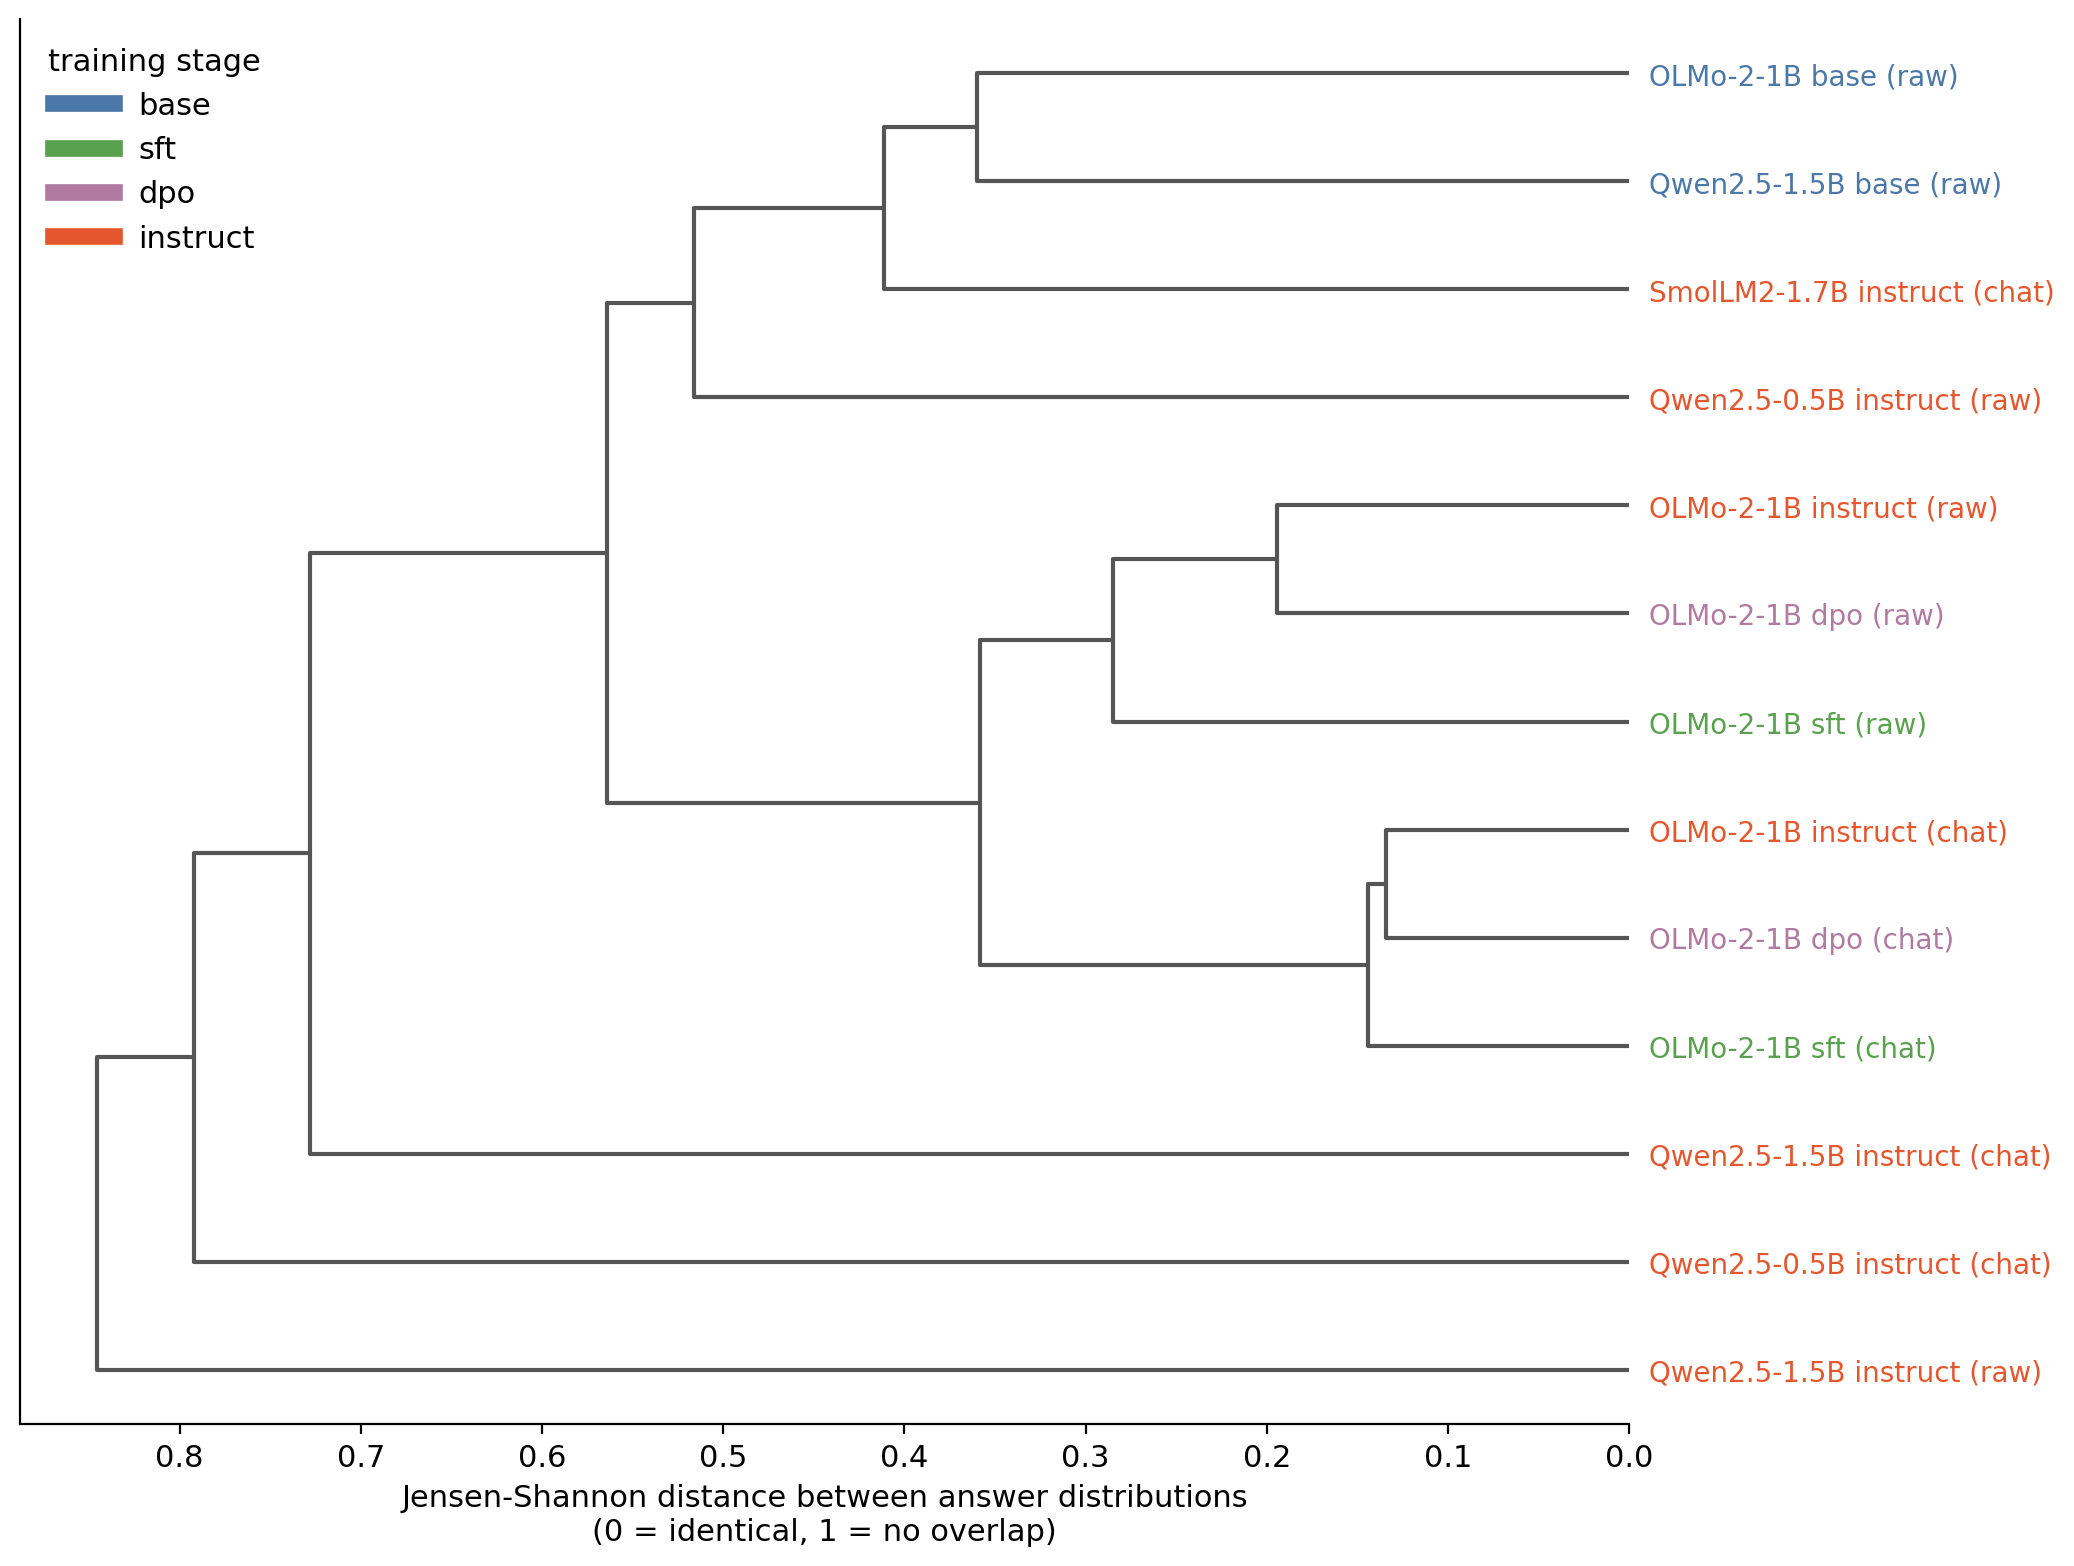
Định dạng prompt cũng quan trọng, nhưng không theo một hướng nhất quán. Chuyển các mô hình tinh chỉnh từ prompt thô sang chat template làm entropy tăng 2,79 bit với Qwen2.5-1.5B, giảm 0,56 bit với Qwen2.5-0.5B, và giữ nguyên OLMo 2 ở mức 4,82 bit.
Cách khắc phục
Nhiệt độ (temperature) không phải là giải pháp đáng tin cậy. Trong nghiên cứu lấy mẫu trước đó, tăng nhiệt độ giúp ích cho một số mô hình nhưng không thay đổi gì với những mô hình khác. Đổi cách diễn đạt prompt cũng vậy: trong kiểm tra của nghiên cứu này, nó làm entropy dịch chuyển trung bình 1,06 bit và tối đa 2,13 bit, theo cả hai hướng, đồng thời thay đổi luôn con số ưa thích.
Giải pháp là ngừng yêu cầu mô hình trở thành nguồn ngẫu nhiên. Hãy để một bộ sinh số chuyên dụng thực hiện việc rút số — ví dụ module secrets của Python khi con số dùng để bảo vệ thứ gì đó — và để mô hình viết mã hoặc gọi công cụ đó. Mô hình ngôn ngữ giỏi ở việc quyết định rằng cần một số ngẫu nhiên và đặt nó ở đâu. Việc tạo ra con số là phần chúng nên chuyển giao.
Những điều nghiên cứu này chưa chứng minh
Các mô hình được thử nghiệm đều nhỏ, chạy được trong một notebook, nên nhỏ hơn nhiều so với các sản phẩm chatbot mà đa số người dùng đang sử dụng. Nghiên cứu chỉ thử với mô hình mở và không đưa ra tuyên bố nào về các trợ lý được lưu trữ trên máy chủ.
Các con số đều có điều kiện là mô hình trả lời bằng một con số. Độ phủ cho biết điều đó xảy ra thường xuyên đến mức nào, và 6 trong 19 dòng rơi xuống dưới mức một nửa. Cách diễn đạt và định dạng prompt ảnh hưởng rất lớn: những con số tiêu đề chỉ đến từ một câu duy nhất. Nghiên cứu cũng chưa thử các khoảng số khác hay ngôn ngữ khác — những yếu tố cũng làm thay đổi con số ưa thích.
 Phân cụm phân phối câu trả lời theo giai đoạn huấn luyện
Một điểm đáng chú ý về bảo mật: các con số về số lần đoán giả định kẻ tấn công biết chính xác phân phối của mô hình và đoán theo thứ tự tối ưu. Kẻ tấn công thực tế thường được thông tin kém hơn, nhưng bất kỳ ai cũng có thể tải cùng mô hình mở đó về và đọc ra cùng phân phối xác suất.
Bài học dành cho các nhà phát triển ứng dụng có yếu tố bảo mật: đừng bao giờ dùng mô hình ngôn ngữ làm nguồn sinh số ngẫu nhiên, dù là mã PIN, khóa thử nghiệm, số xổ số hay mẫu rút ra cho một kiểm định thống kê. Khoảng cách giữa 7,9 lần đoán của mô hình và 50,5 lần của một lựa chọn công bằng chính là rủi ro cần loại bỏ.