
Một tháng lập trình với GLM 5.3 Flash: Bài học từ thử nghiệm thực tế
Một lập trình viên đã thử dành trọn tháng 9 chỉ dùng một mô hình AI mở là GLM 5.3 Flash để viết code, nhưng kết quả chỉ đạt 50% mục tiêu khi tiêu tốn tới 2 tỷ token. Bài viết chia sẻ những khó khăn bất ngờ về chi phí, hạ tầng và bài học về cách chọn mô hình AI hiệu quả cho công việc phát triển phần mềm.
Một tháng lập trình với GLM 5.3 Flash: Khi thử nghiệm AI không diễn ra như kế hoạch
Việc đặt ra thách thức dành trọn tháng 9 chỉ để sử dụng một mô hình AI mở hiệu quả duy nhất nghe có vẻ là một ý tưởng tuyệt vời vào thời điểm đó. Nhưng sau 2 tỷ token tiêu tốn, kết quả thực tế lại không như mong đợi.
Token đã đi đâu trong tháng này?
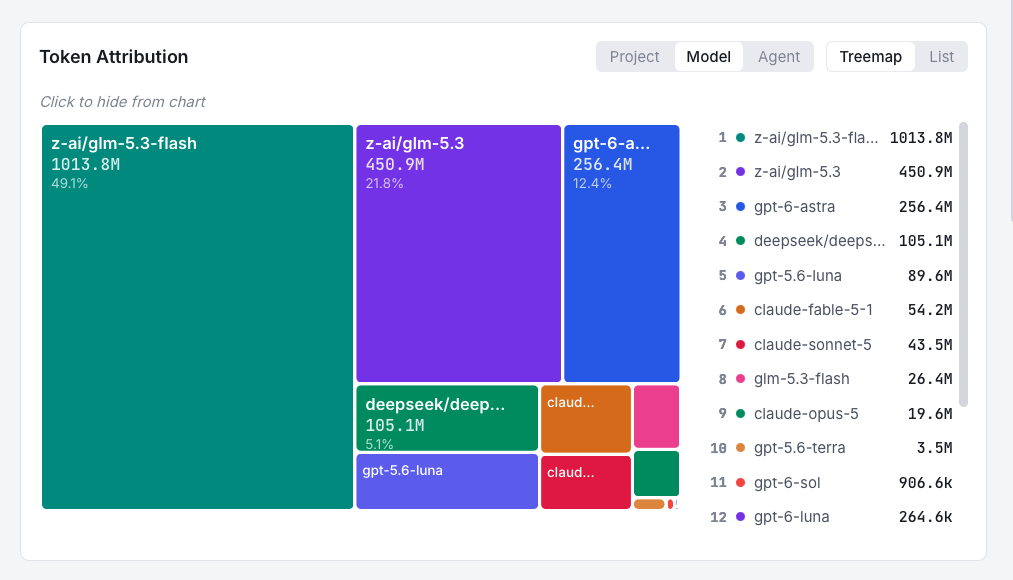
Theo thống kê từ AgentsView — một trong những công cụ theo dõi mức sử dụng AI được khuyến nghị cho các kỹ sư agentic — phân bổ token trong tháng cho thấy một bức tranh khá thú vị.
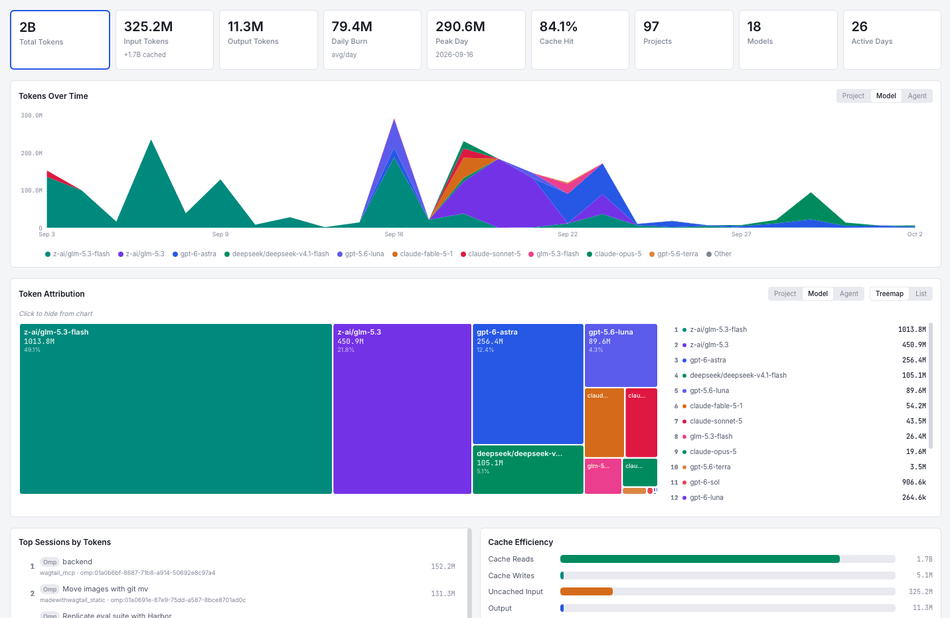 Phân bổ token theo tháng trên AgentsView
Khi tập trung vào sự phân chia giữa các mô hình, mục tiêu ban đầu là dành trọn tháng cho GLM 5.3 Flash (được biểu thị bằng màu xanh mòng két trong biểu đồ).
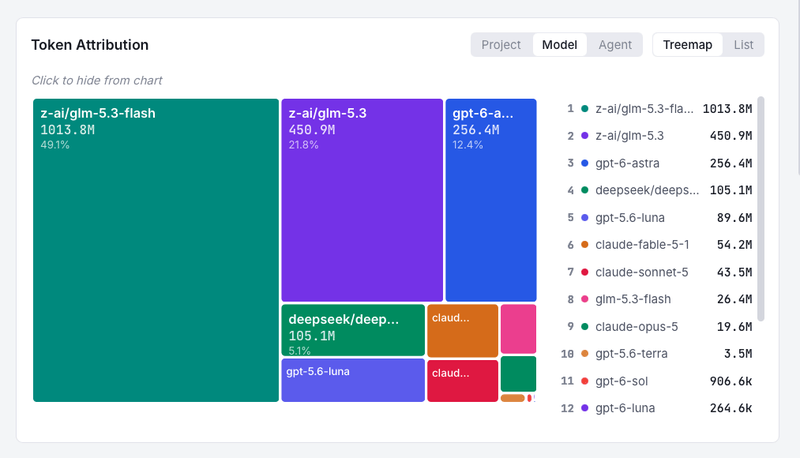 So sánh mức sử dụng giữa các mô hình
Những gì đã diễn ra suôn sẻ:
- Thành công dành trọn nửa đầu tháng chỉ với mô hình đó
- Mức sử dụng mô hình này nằm trong ngân sách đặt ra (khoảng 68 USD, tương đương 4 kWh năng lượng và 365 gram khí thải carbon)
Tuy nhiên, nửa sau của tháng lại không thuận lợi như vậy, khi có tới 1 tỷ token được dành cho các mô hình khác.
Những trở ngại bất ngờ
Cái giá của "vibe coding"
Nhóm phát triển thừa nhận rằng máy chủ Wagtail MCP thử nghiệm của họ là một nguyên mẫu được tạo theo phong cách "vibe coding". Cách làm này không phải là điều họ thường hướng tới, nhưng với một nguyên mẫu thì lại rất phù hợp. Đáng tiếc là vẫn có những hệ quả đi kèm.
Việc chọn "sai" mô hình cho nguyên mẫu đã khiến họ tiêu tốn tới 450 triệu token, tương đương 150 USD và 5 kWh năng lượng gần như chỉ trong một đêm. Bản thân máy chủ MCP vẫn hoạt động tốt và hiện đã có một bản demo tuyệt vời về các khả năng của nó, nên công sức bỏ ra không hoàn toàn vô ích.
Đây là lời nhắc nhở cần cẩn trọng trong việc lựa chọn mô hình và các mẫu tác tử (agentic patterns). Lẽ ra có thể đạt được kết quả tương tự với chi phí thấp hơn khoảng 5 lần mà không cần nỗ lực nhiều hơn là bao.
Vấn đề hạ tầng
Một trở ngại bất ngờ khác là vấn đề về khả năng sẵn có của hạ tầng. Các nhà cung cấp dịch vụ suy luận (inference provider) được chọn lựa hoạt động rất tốt trong hầu hết trường hợp, nhưng hóa ra họ lại vô cùng phổ biến và không có cùng năng lực như các phòng thí nghiệm lớn — những nơi đang "tích trữ" phần lớn GPU trên thị trường.
Nhóm nghiên cứu ghi nhận sự suy giảm hiệu suất của GLM 5.3 Flash nói riêng, có thể vì mô hình này đứng ở vị trí cao trên đường biên Pareto của các mô hình phù hợp với công việc của họ.
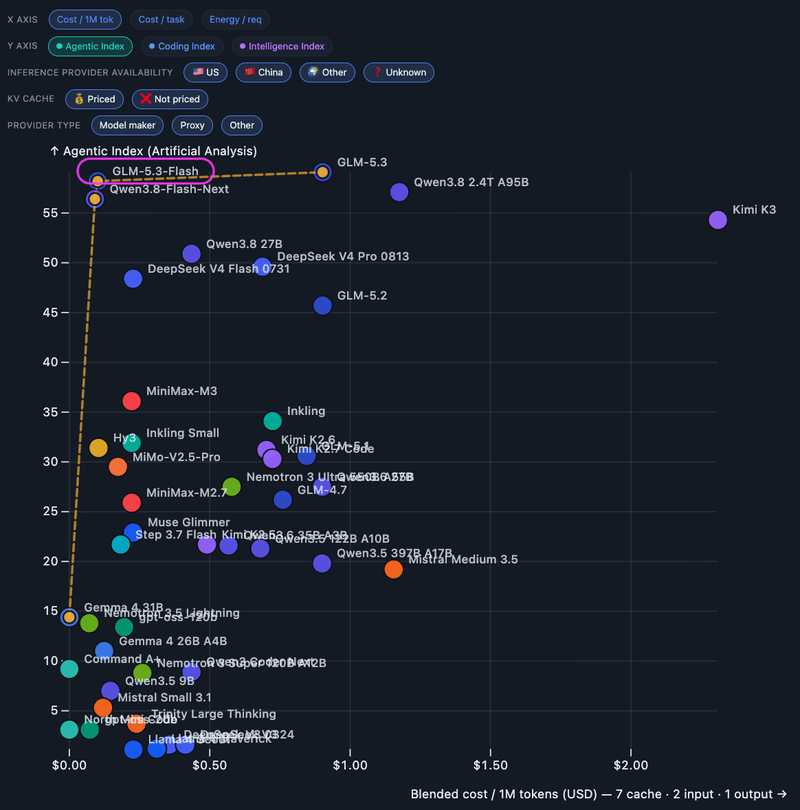 Đường biên Pareto của các mô hình tháng 9/2026
Điều này buộc họ phải chuyển sang các mô hình tương tự khác như DeepSeek V4.1 Flash và Qwen 3.8 Flash. Việc chuyển đổi rất đơn giản, nhưng vẫn là một tình huống không lường trước được.
Chi phí cho thử nghiệm và R&D
Ngoài việc dùng một mô hình cho công việc kỹ thuật hàng ngày, việc liên tục thử nghiệm với nhiều mô hình khác nhau và cập nhật những gì các nhà cung cấp đang phát hành là điều thiết yếu. Điều này đặc biệt quan trọng khi nhóm bắt đầu đo lường hiệu suất của các mô hình trên các tác vụ Wagtail, nơi họ cần dữ liệu từ nhiều mô hình khác nhau.
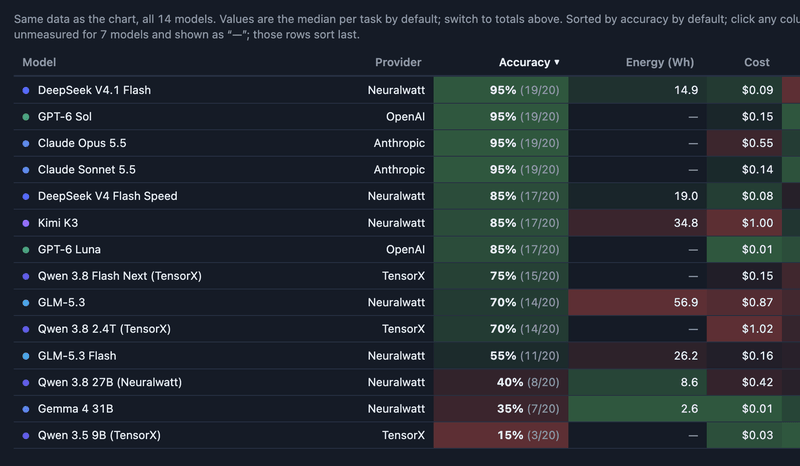 Biểu đồ so sánh mức tiêu thụ năng lượng của các mô hình
Với dữ liệu cụ thể như vậy, việc hướng dẫn mọi người lựa chọn các phương án tiết kiệm hơn trở nên dễ dàng hơn nhiều. Đồng thời, nhóm cũng có thể làm cho các phương án đó khả thi hơn nhờ các kỹ năng tác tử (agent skills) hoặc nguyên mẫu CLI mới được thiết kế để hoạt động tốt với các tác tử AI.
Bài học và hướng đi tiếp theo
Về mặt kỹ thuật, thách thức này được coi là thất bại: chỉ đạt 50% mức sử dụng mô hình mục tiêu (1 tỷ trên tổng 2 tỷ token), và tiêu thụ khoảng 35 kWh năng lượng thay vì 10 kWh như kỳ vọng. Nhưng nhóm đã học được rất nhiều điều quan trọng trong bối cảnh hiện tại.
Nhìn lại để chuẩn bị cho tháng 10, đây là những gì sẽ giúp mọi việc hiệu quả hơn:
- Đo lường và báo cáo cục bộ liên tục: Không chỉ nhìn vào token mà còn cả năng lượng tiêu thụ và chi phí, và lý tưởng nhất là mức độ dẫn đến các kết quả tích cực cụ thể.
- Lập ngân sách cho thử nghiệm, không chỉ cho công việc hàng ngày: Đưa ra quyết định có tính toán hơn về việc nguyên mẫu nào đáng để xây dựng và như thế nào.
- Cải thiện việc chọn prompt và kỹ thuật đa tác tử: Phân biệt rõ vai trò điều phối, trinh sát, triển khai và đánh giá. Đặt mục tiêu có giới hạn rõ ràng.
- Tiếp tục thúc đẩy các kỹ thuật và mô hình hiệu quả hơn: Các mô hình khuếch tán quyết định kiểu Jev trông rất hứa hẹn nếu có thể chạy hiệu quả như vậy.
Đối với công việc phát triển hàng ngày, việc tập trung vào một hoặc hai mô hình rẻ thuộc phân khúc "flash" là hoàn toàn khả thi. Mục tiêu hợp lý có lẽ là phần lớn công việc suy luận AI nên được thực hiện bằng những mô hình hiệu quả như vậy, đo bằng chi phí hoặc năng lượng thay vì số lượng token vô nghĩa.
Đó là mục tiêu cho tháng 10! Bạn cũng nên thử, bạn sẽ học được rất nhiều trong quá trình này.
Ý nghĩa với cộng đồng phát triển tại Việt Nam
Câu chuyện này mang lại bài học thiết thực cho các lập trình viên và nhóm phát triển phần mềm Việt Nam đang ngày càng sử dụng nhiều công cụ AI để hỗ trợ viết code:
- Kiểm soát chi phí là yếu tố then chốt: Chi phí API cho các mô hình AI có thể tăng vọt rất nhanh nếu không được theo dõi chặt chẽ, đặc biệt với các dự án thử nghiệm.
- Không phụ thuộc vào một nhà cung cấp duy nhất: Việc có sẵn phương án dự phòng khi hạ tầng gặp vấn đề là điều cần thiết.
- Đo lường bằng kết quả, không phải token: Số lượng token tiêu thụ không phản ánh giá trị thực sự mà AI mang lại cho dự án.
Với các nhóm nhỏ và startup tại Việt Nam có ngân sách hạn chế, việc lựa chọn mô hình AI ở phân khúc "flash" giá rẻ cho hầu hết công việc hàng ngày, và chỉ dùng các mô hình mạnh hơn cho những tác vụ thực sự phức tạp, là một chiến lược đáng cân nhắc.